

Idag på vårt projekt fungerar, förutom monolitiskt kod, dussintals mikrotjänster. Varje mikrotjänst kräver övervakning. Att hantera detta i sådan skala av DevOps-ingenjörer är problematiskt. Vi har utvecklat ett övervakningssystem som fungerar som en tjänst för utvecklarna. De kan själva skriva mätvärden i övervakningssystemet, använda dem, bygga dashboards baserat på dem och koppla dem till larm som triggas vid uppnådda tröskelvärden. Från DevOps-ingenjörerna behövs endast infrastruktur och dokumentation.
Detta inlägg är en transkribering av mitt tal från vår på RIT++. Många har bett oss att göra skriftliga versioner av presentationerna därifrån. Om du var på konferensen eller tittade på videon, hittade du inget nytt. Och för alla andra - välkomna under kat. Jag kommer att berätta hur vi kom fram till detta system, hur det fungerar och hur vi planerar att uppdatera det.
Det förflutna: scheman och planer
Hur kom vi fram till det befintliga övervakningssystemet? För att svara på denna fråga behöver vi gå tillbaka till 2015. Så här såg det ut då:
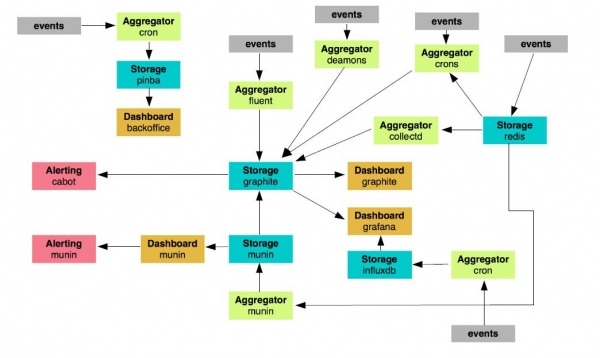
Vi hade cirka 24 noder som ansvarade för övervakningen. Här fanns en hel hög med olika cron-jobb, skript och demoner som på något sätt övervakade saker, skickade meddelanden och utförde funktioner. Vi tänkte att ju längre bort vi kom, desto mindre livskraftig skulle ett sådant system vara. Det fanns ingen mening att utveckla det: det var för otympligt.
Vi bestämde oss för att välja ut vilka övervakningselement vi skulle behålla och vidareutveckla, och vilka vi skulle överge. Det blev 19 stycken. Endast Grafite, aggregerare och Grafana som dashboard blev kvar. Men hur skulle det nya systemet se ut? Så här:
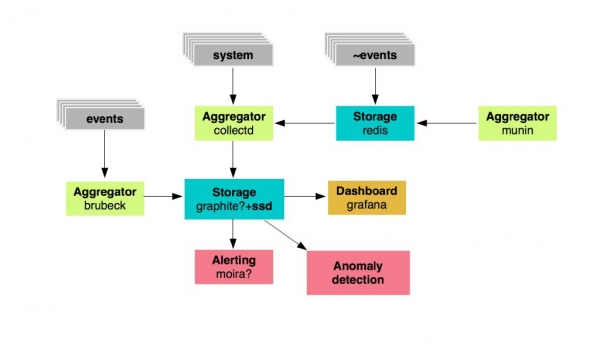
Vi har ett mätvärdesförråd: det är Grafiter som kommer att baseras på snabba SSD-diskar, och det finns vissa aggregerare för mätvärden. Vidare - Grafana för att visa dashboards och Moira för larm. Dessutom ville vi utveckla ett system för att upptäcka anomalier.
Standard: Övervakning 2.0
Så här såg planerna ut 2015. Men vi behövde förbereda inte bara infrastrukturen och själva tjänsten, utan också dokumentationen för den. Vi utvecklade en företagsstandard som vi kallade övervakning 2.0. Vilka krav ställdes på systemet?
- konstant tillgänglighet;
- intervall för mätvärdeslagring = 10 sekunder;
- strukturerad lagring av mätningar och instrumentpaneler;
- SLA > 99,99%
- insamling av händelsebaserade mätningar via UDP (!).
Vi behövde UDP, eftersom vi har en stor trafikmängd och händelser som genererar mätningar. Om vi skriver alla på en gång till Graphite, så kommer lagringen att krascha. Vi valde även förnamn för alla mätningar.
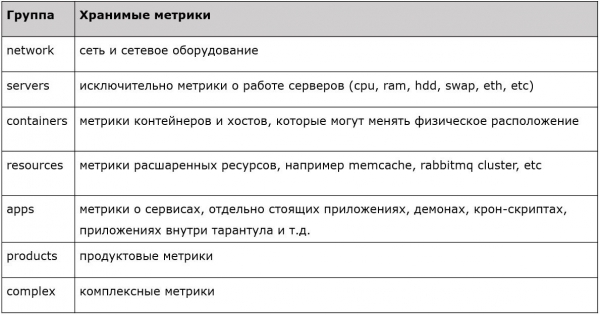
Varje förnamn representerar en viss egenskap. Det finns mätningar för servrar, nätverk, containrar, resurser, applikationer osv. Vi har implementerat en tydlig, strikt, typiserad filtrering där vi accepterar mätningar av första nivå, medan resten helt enkelt släpps. Så här planerade vi detta system 2015. Vad är läget idag?
Nutid: interaktionsschema för övervakningskomponenter
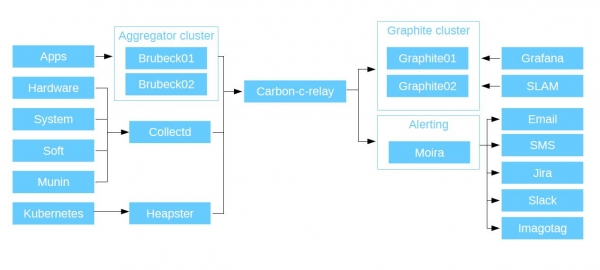
Först och främst övervakar vi applikationer: vår PHP-kod, applikationer och mikrotjänster - kort sagt, allt som våra utvecklare skriver. Alla applikationer skickar mätningar via UDP till aggregatorkomponenten Brubeck (statsd, omkodad i C). Det visade sig vara den snabbaste utifrån syntetiska tester. Den skickar redan aggregerade mätningar till Graphite via TCP.
Den har en typ av mätning som kallas timers. Det är en mycket praktisk funktion. Till exempel, för varje användaranslutning till tjänsten skickar du en mätning till Brubeck med svarstid. En miljon svar kom in, men aggregatoren gav endast 10 mätningar. Du har antalet inkommande kunder, maximal, minimal och genomsnittlig svarstid, medianen och 4 percentiler. Sedan överförs data till Graphite och vi ser dem alla i realtid.
Vi har också aggregering för mätningar av hårdvara, programvara, systemmetrik och vårt gamla övervakningssystem Munin (som användes fram till 2015). Allt detta samlar vi in via C-demonen CollectD (den har en rad olika plugins inbyggda, den kan fråga alla resurser på värdsystemet där den är installerad; ange bara i konfigurationen vart data ska skrivas) och skriver data till Graphite genom den. Den stödjer även Python- och shellskriptplugins, så att du kan skriva egna anpassade lösningar: CollectD kommer att samla dessa data från en lokal eller avlägsen värd (låt oss säga, finns Curl) och skicka dem till Graphite.
Sedan skickar vi alla insamlade mätvärden till Carbon-c-relay. Det här är en Carbon Relay-lösning från Graphite som är modifierad på C. Det är en router som samlar alla mätvärden vi skickar från våra aggregat och dirigerar dem till noderna. Under dirigeringssteget kontrollerar den också giltigheten hos mätvärdena. För det första måste de motsvara det schema med prefix som jag visade tidigare, och för det andra måste de vara giltiga för Graphite. Annars kommer de att släppas.
Sedan skickar Carbon-c-relay mätvärdena till Graphite-klustret. Vi använder Carbon-cache, omskriven i Go, som vår primära lagringslösning för mätvärden. Go-carbon överträffar Carbon-cache avsevärt i prestanda på grund av sin flertrådade arkitektur. Den tar emot data och skriver dem till diskar med hjälp av whisper-paketet (standard, skrivet i Python). För att läsa data från våra lagringar använder vi Graphite API. Det fungerar mycket snabbare än standard Graphite WEB. Vad händer med data efter det?
De går till Grafana. För den primära datakällan använder vi våra Graphite-kluster, och vi har också Grafana som webbgränssnitt för att visa mätvärden och bygga dashboards. Utvecklarna skapar sina egna dashboards för varje tjänst. Sedan bygger de grafer baserat på mätvärdena de registrerar från sina applikationer. Förutom Grafana har vi också SLAM. Detta är en Python-demon som beräknar SLA baserat på data från Graphite. Som jag nämnde tidigare har vi flera dussin mikrotjänster, var och en med sina egna krav. Med SLAM går vi igenom dokumentationen och jämför den med det som finns i Graphite och utvärderar hur väl kraven motsvarar tillgängligheten av våra tjänster.
Vidare till alerting. Det organiseras med hjälp av ett kraftfullt system — Moira. Den är oberoende eftersom den har sin egen Graphite under huven. Den utvecklades av teamet bakom SKB 'Kontur', skriven i Python och Go, och är helt öppen källkod. Moira får samma datastream som går till Graphite. Om din lagring dör av någon anledning kommer din alerting att fortsätta fungera.
Moira har vi distribuerat i Kubernetes, och den använder en kluster av Redis-servrar som sin primära databas. Resultatet är ett felbeständigt system. Den jämför strömmen av mätdata med en lista av triggers: om det inte finns några omnämnanden, släpper den mätningen. På så sätt kan den bearbeta gigabyte av mätdata per minut.
Vi har också kopplat företagets LDAP till den, vilket gör att varje användare i det företagsamma systemet kan skapa notifikationer för befintliga (eller nyss skapade) triggers. Eftersom Moira innehåller Graphite, stödjer den alla dess funktioner. Så först tar du en rad och kopierar den till Grafana. Titta på hur data visas i graferna. Sedan tar du samma rad och kopierar den till Moira. Du sätter på den limiter och får alerting som resultat. För att göra allt detta behöver du inga speciella kunskaper. Moira kan alertas via sms, e-post, i Jira, Slack... Den stöder också att köra anpassade skript. När den får en trigger, och den är prenumererad på ett anpassat skript eller binär, kör den det och skickar JSON till stdin för den binära filen. Ditt program måste därför kunna parsa det. Vad du gör med denna JSON, avgör du själv. Vill du skicka det till Telegram, vill du öppna uppgifter i Jira, gör vad som helst.
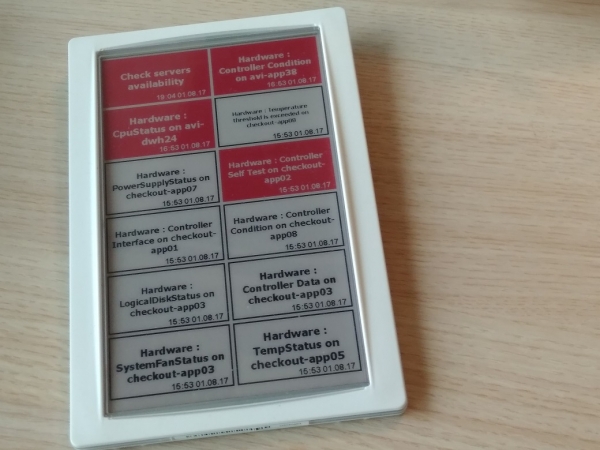
Vi använder också vår egen utveckling för alerting — Imagotag. Vi har anpassat en panel, som vanligtvis används för elektroniska prislappar i butiker, för våra ändamål. Vi har lagt till triggers från Moira på den. Där anges i vilket tillstånd de är och när de inträffade. En del av utvecklarna har övergett notifikationer i Slack och e-post till förmån för den här panelen.
Eftersom vi är ett progressivt företag, har vi också övervakat Kubernetes i detta system. Vi inkluderade det i systemet via Heapster, som vi installerade i klustret, det samlar in data och skickar dem till Graphite. Så här ser schemat ut:
Övervakningskomponenter
Här är en lista med länkar till de komponenter vi använde för denna uppgift. Alla är open source.
Graphite:
- go-carbon:
- whisper:
- graphite-api:
Carbon-c-relay:
Brubeck:
Collectd:
Moira:
Grafana:
Heapster:
Statistik
Här är lite siffror om hur vårt system fungerar.
Aggregator (brubeck)
Antal metoder: ~ 300 000 / sek
Intervall för att skicka metoder till Graphite: 30 sek
Användning av serverresurser: ~ 6% CPU (gäller fullfjädrade servrar); ~ 1Gb RAM; ~ 3 Mbps LAN
Graphite (go-carbon)
Antal metoder: ~ 1 600 000 / min
Uppdateringsintervall för metoder: 30 sek
Metodlagringsschema: 30sek 35d, 5min 90d, 10min 365d (ger insikt i vad som händer med tjänsten över en längre tidsperiod)
Användning av serverresurser: ~ 10% CPU; ~ 20Gb RAM; ~ 30 Mbps LAN
Flexibilitet
Vi på Avito värderar flexibiliteten i vår övervakningstjänst. Varför blev det så? För det första är dess komponenter utbytbara: både själva komponenterna och deras versioner. För det andra - underhållbarheten. Eftersom hela projektet är byggt på öppen källkod kan du själv ändra koden, göra ändringar och implementera funktioner som inte är tillgängliga från början. Det används ganska vanliga stackar, främst Go och Python, så detta görs ganska enkelt.
Här är ett exempel på ett verkligt uppkommet problem. En metod i Graphite är en fil. Den har ett namn. Filnamnet = metodens namn. Och det finns en väg till den. Filnamn i Linux är begränsade till 255 tecken. Och vi har (som 'interna beställare') killar från databavdelningen. De säger till oss: 'Vi vill övervaka våra SQL-frågor. Och de är inte 255 tecken, utan 8 MB vardera. Vi vill visa dem i Grafana, se parametrarna för den här frågan, och ännu bättre, vi vill se topplistan över sådana frågor. Det skulle vara bra om det kunde visas i realtid. Och riktigt coolt skulle vara om vi kunde trycka dem in i varningssystemet.'
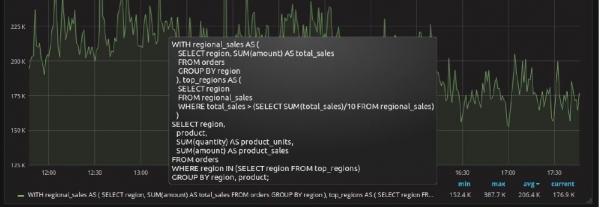
Exempel på SQL-frågan hämtas som exempel från
Vi sätter upp Redis-servern och våra Collectd-plugins, som går in i Postgres och hämtar all data, skickar mätvärden till Graphite. Men vi ersätter mätvärdets namn med hashvärden. Denna hash skickar vi samtidigt till Redis som nyckel, och hela SQL-frågan som värde. Vi måste få Grafana att kunna ansluta till Redis och hämta denna information. Vi öppnar Graphite API, eftersom detta är det huvudsakliga gränssnittet för interaktion mellan alla övervakningskomponenter och Graphite, och skriver in en ny funktion som kallas aliasByHash() — från Grafana får vi mätvärdets namn och använder det i begäran till Redis som nyckel, och som svar får vi värdet för nyckeln, vilket är vår “SQL-fråga”. På så sätt presenterar vi i Grafana SQL-frågan som egentligen inte gick att visa där, tillsammans med statistik över den (anrop, rader, total tid, …).
Sammanfattning
Tillgänglighet. Vår övervakningstjänst är tillgänglig dygnet runt från vilken applikation eller kod som helst. Om du har tillgång till lagren kan du skriva data till tjänsten. Språket spelar ingen roll, lösningar är oviktiga. Du behöver bara veta hur man öppnar en socket, skickar mätvärdet dit och stänger socketen.
Tillförlitlighet. Alla komponenter är felfria och klarar våra belastningar bra.
Lågt inträdesbarriär. För att använda detta system behöver du inte lära dig programmeringsspråk eller frågor i Grafana. Du öppnar bara din applikation, skriver in en socket som ska skicka mätvärden till Graphite, stänger den, öppnar Grafana, skapar dashboards där och observerar dina mätvärden, och får notifieringar via Moira.
Självständighet. Allt detta går att göra själv, utan hjälp av DevOps-ingenjörer. Och detta är överflödigt, eftersom du kan övervaka ditt projekt just nu, utan att behöva be någon — varken för att börja arbeta eller för ändringar.
Vad strävar vi efter?
Allt som nämns nedan är inte bara abstrakta tankar, utan det är saker som vi redan har tagit åtminstone de första stegen emot.
- Anomalidetektor. Vi vill utveckla en tjänst som går in i våra Graphite-lager och kontrollerar varje mätvärde enligt olika algoritmer. Vi har redan algoritmer som vi vill granska, vi har data, och vi vet hur vi ska arbeta med dem.
- Metadata. Vi har många tjänster som förändras över tid, precis som de personer som arbetar med dem. Att ständigt hantera dokumentationen manuellt är ingen hållbar lösning. Därför integreras metadata i våra mikrotjänster. Det specificeras vem som utvecklade den, vilka språk den interagerar med, SLA-krav, samt vart och till vem notifikationer ska skickas. Vid distribution av tjänsten skapas alla datainstanser automatiskt. Resultatet blir två länkar - en till triggers och en till dashboards i Grafana.
- Övervakning i varje hem. Vi anser att alla utvecklare bör använda ett sådant system. Då förstår du alltid var din trafik befinner sig, vad som händer med den, var den faller och var den har svaga punkter. Om något inträffar som påverkar din tjänst, får du veta det genom en alert snarare än ett telefonsamtal från en chef, och kan direkt öppna färska loggar för att se vad som hände.
- Hög prestanda. Vårt projekt växer ständigt och idag bearbetar det omkring 2 000 000 datapunkter per minut. För ett år sedan var detta nummer 500 000. Och tillväxten fortsätter, vilket innebär att Graphite (whisper) snart kommer att belasta vårt diskystem mycket hårt. Som jag nämnde tidigare är detta övervakningssystem ganska mångsidigt tack vare komponenternas utbytbarhet. Vissa underhåller och expanderar sin infrastruktur speciellt för Graphite, men vi har valt en annan väg: att använda som lagringslösning för våra mätvärden. Denna övergång är nästan klar, och snart kommer jag att berätta mer detaljerat om hur det gick till: vilka svårigheter vi stötte på och hur vi övervann dem, hur migrationsprocessen gick till, samt beskriva de komponenter vi valde som omgivning och deras konfigurationer.
Tack för uppmärksamheten! Ställ gärna dina frågor om ämnet, så ska jag försöka svara här eller i kommande inlägg. Kanske har någon erfarenhet av att bygga ett liknande övervakningssystem eller att migrera till Clickhouse i en liknande situation – dela gärna med er i kommentarerna.
Källa: habr.com
