

Låt oss titta på konceptet för Kubernetes-övervakning, bekanta oss med verktyget Prometheus, och diskutera alertsystem.
Ämnet övervakning är omfattande och kan inte behandlas i en enda artikel. Syftet med denna text är att ge en översiktlig presentation av verktyg, koncept och tillvägagångssätt.
Innehållet i artikeln är en sammanfattning från . Om du vill gå en fullständig utbildning, anmäl dig till kursen om .
Vad övervakas i en Kubernetes-kluster
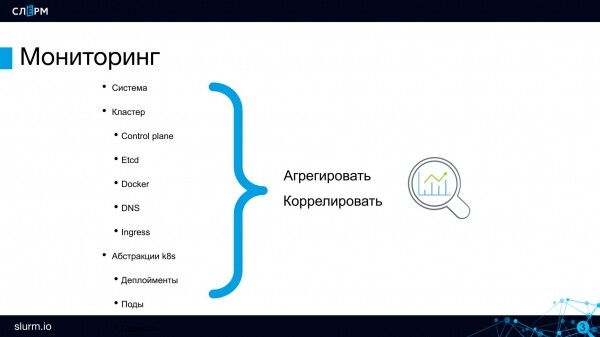
Fysiska servrar. Om Kubernetes-klustret är distribuerat på egna servrar måste man övervaka deras hälsa. Zabbix klarar detta; om du arbetar med det behöver du inte överge det, det kommer inte att uppstå några konflikter. Det är Zabbix som övervakar våra servars tillstånd.
Låt oss gå vidare till övervakning på klusternivå.
Control Plane-komponenter: API, Scheduler och andra. I alla fall måste man övervaka så att antalet API-servrar eller etcd är mer än 0. Etcd kan ge många mätvärden: om diskarna den körs på, om hälsotillståndet för sitt kluster och andra.
Docker har funnits länge och dess problem är välkända: många containrar orsakar hängningar och andra problem. Därför bör även Docker som system övervakas, åtminstone för tillgänglighet.
DNS. Om DNS i klustret faller bort kommer hela service-discovery att fallera, och anrop från pods till pods kommer att sluta fungera. I min erfarenhet har sådana problem inte uppstått, men det betyder inte att man inte behöver övervaka DNS-tillståndet. Fördröjningar i förfrågningar och vissa andra mätvärden kan övervakas på CoreDNS.
Ingress. Det är viktigt att övervaka tillgängligheten av ingresser (inklusive Ingress Controller) som ingångspunkter till projektet.
Vi har gått igenom de grundläggande komponenterna i klustret — nu ska vi sjunka ner på en lägre abstraktionsnivå.
Det verkar som att applikationer körs i pods, vilket innebär att de behöver övervakas, men så är faktiskt inte fallet. Pods är flyktiga: idag körs de på en server, imorgon på en annan; idag finns det 10, imorgon 2. Därför övervakas inga enskilda pods. Inom mikrotjänstarkitekturen är det viktigare att övervaka tillgängligheten av applikationen som helhet. Specifikt att kontrollera tillgängligheten av tjänstens slutpunkter: fungerar något överhuvudtaget? Om applikationen är tillgänglig, vad händer då bakom den, hur många repliker finns det just nu — det är frågor av andra ordningen. Det är inte nödvändigt att övervaka enskilda instanser.
På den sista nivån behöver man kontrollera applikationens funktion, samla affärsmetrik: antal beställningar, användarbeteende och så vidare.
Prometheus
Det bästa systemet för övervakning av kluster är . Jag känner inte till något verktyg som kan mäta sig med Prometheus när det gäller kvalitet och användarvänlighet. Det passar utmärkt för flexibel infrastruktur, så när man talar om "Kubernetes-övervakning" syftar man ofta just på Prometheus.
Det finns ett par alternativ för att börja arbeta med Prometheus: med hjälp av Helm kan man installera antingen vanlig Prometheus eller Prometheus Operator.
- Vanlig Prometheus. Det fungerar bra, men man måste konfigurera ConfigMap — i praktiken skriva textkonfigurationsfiler som vi gjorde tidigare, innan mikrotjänstarkitekturen.
- Prometheus Operator är lite mer komplex, men är enklare att arbeta med: där finns separata objekt, abstraktioner läggs till klustret, vilket gör det mycket lättare att kontrollera och konfigurera.
För att förstå produkten rekommenderar jag att du först installerar vanlig Prometheus. Du kommer att behöva konfigurera allt via filen, men detta kommer att vara till nytta: du kommer att förstå vad som hör till vad och hur det konfigureras. Med Prometheus Operator går du direkt upp en nivå av abstraktion, även om du givetvis kan gräva djupare om du vill.
Prometheus är väl integrerat med Kubernetes: det kan tillgå API-servern och interagera med den.
Prometheus är populärt, därför stöder det ett stort antal applikationer och programmeringsspråk. Stöd behövs eftersom Prometheus har sitt eget format för metrik, och antingen en inbyggd bibliotek i applikationen eller en färdig exportör krävs för att överföra den. Det finns ganska många sådana exportörer. Till exempel finns det PostgreSQL Exporter: den hämtar data från PostgreSQL och konverterar dem till Prometheus-format, så att Prometheus kan arbeta med dem.
Prometheus Arkitektur
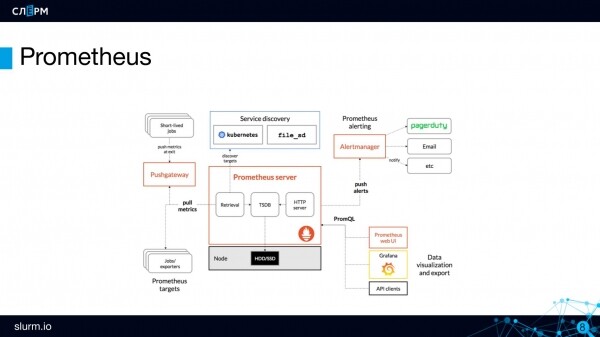
Prometheus Server — är serverdelen, hjärnan av Prometheus. Här lagras och bearbetas metrik.
Metrik lagras i en tidsserie-databas (TSDB). TSDB är inte en separat databas utan ett paket i Go-språket, som är inbyggt i Prometheus. Grovt sagt, allt finns i en och samma binärfil.
Lagra inte data i TSDB länge
Prometheus infrastruktur är inte lämplig för långvarig lagring av metrik. Standardlagringstiden är 15 dagar. Denna begränsning kan överskridas, men det är bra att veta: ju mer data du lagrar i TSDB och ju längre du gör det, desto fler resurser kommer det att använda. Att lagra historisk data i Prometheus betraktas som en dålig praxis.
Om du har enorm trafik och antalet metrik uppgår till hundratusentals per sekund, är det bättre att begränsa deras lagring baserat på diskens utrymme eller lagringstid. Vanligtvis lagras "heta data" i TSDB, metrik som bara är några timmar gammal. För längre lagring används externa lagringslösningar i databaser som verkligen är avsedda för det, till exempel InfluxDB, ClickHouse och så vidare. Jag har sett fler positiva omdömen om ClickHouse.
Prometheus Server fungerar enligt modellen pull: den hämtar själv metrik från de slutpunkter som vi har angivit. Vi sa: "gå till API Server", och den går dit var n:te sekunder och hämtar metrik.
För objekt med kort livslängd (jobb eller cron-jobb), som kan dyka upp mellan skrapningsintervall, finns det en komponent som kallas Pushgateway. Metrik från kortvariga objekt trycks dit: jobbet startade, genomförde en åtgärd, skickade metrik till Pushgateway och avslutades. Efter en tid kommer Prometheus att gå och hämta dessa metrik från Pushgateway.
För att konfigurera notifieringar i Prometheus finns det en separat komponent — Alertmanager. Och reglerna för larm — alerting rules. Till exempel, man behöver skapa ett larm om API-servrarna är 0. När händelsen utlöses, vidarebefordras larmet till alert manager för vidare utskick. I alert manager finns det tillräckligt flexibla inställningar för routing: en grupp larm kan skickas till en Telegram-chatt för administratörer, en annan till utvecklarnas chatt, och en tredje till infrastrukturtjänstemännens chatt. Meddelanden kan komma till Slack, Telegram, via e-post och i andra kanaler.
Och till sist ska jag berätta om killer-funktionen i Prometheus — Upptäckte. När man arbetar med Prometheus behöver man inte ange specifika adresser för objekten som ska övervakas, det räcker med att ange deras typ. Det vill säga, man behöver inte skriva "här är IP-adressen, här är porten — övervaka", istället behöver man definiera på vilka principer dessa objekt ska hittas (targets — mål). Prometheus plockar själv, beroende på vilka objekt som för närvarande är aktiva, de som behövs och lägger till dem för övervakning.
Denna metod passar bra med strukturen i Kubernetes, där allt också förändras: idag 10 servrar, imorgon 3. För att inte behöva ange serverns IP-adress varje gång, skriver man en gång hur man ska hitta den — och Upptäckte kommer att göra det.
Språket i Prometheus kallas PromQL. Med hjälp av detta språk kan man hämta värden för specifika metrik och sedan omvandla dem, bygga analytiska rapporter utifrån dem.
https://prometheus.io/docs/prometheus/latest/querying/basics/

En enkel fråga

    container_memory_usage_bytes

Matematiska operationer

    container_memory_usage_bytes / 1024 / 1024

Inbyggda funktioner

    sum(container_memory_usage_bytes) / 1024 / 1024

Avgränsning av fråga

    100 - avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[5m]) * 100)
Prometheus webbgränssnitt
Prometheus har ett eget, ganska minimalistiskt webbgränssnitt. Det är mest användbart för debug eller demonstration.
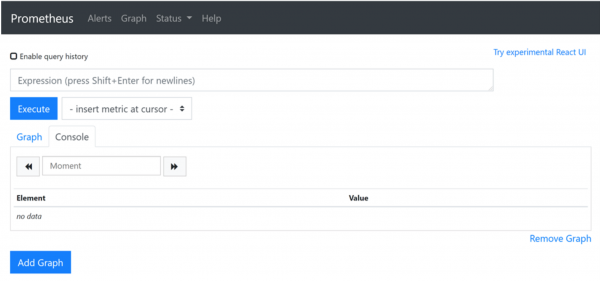
I rutan för Expression kan man skriva frågor i PromQL.
I fliken Alerts finns larmregler — alerting rules, och de har tre statusar:
- inactive — om larmet för tillfället inte är aktivt, det vill säga om allt är bra med det, och det inte har utlösts;
- pending — detta är fallet om larmet har utlösts, men utskicket har ännu inte genomförts. Fördröjningen sätts för att kompensera för nätverksflimmer: om den angivna tjänsten har startat inom en minut, så ska larmet inte utlösas än;
- firing — detta är den tredje statusen, när larmet tänds och skickar meddelanden.
I menyn Status hittar du tillgång till information om vad Prometheus är. Där finns också en länk till målen (targets) som vi talade om tidigare.
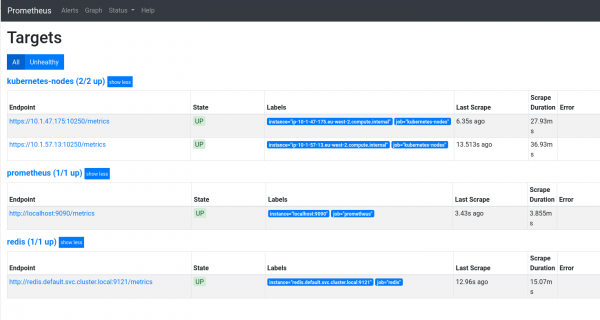
En mer detaljerad översikt av Prometheus-gränssnittet finns i .
Integrering med Grafana
I webbgränssnittet för Prometheus hittar du inte vackra och tydliga grafer som kan indikera klustrets tillstånd. För att skapa dessa bygger man en integrering mellan Prometheus och Grafana. Resultatet blir sådana här dashboards.
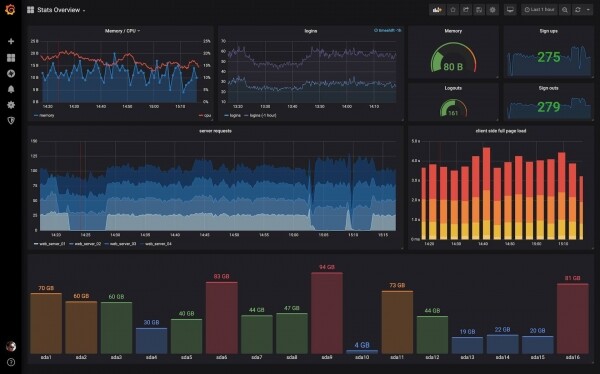
Att konfigurera integreringen mellan Prometheus och Grafana är ganska enkelt, instruktioner finns i dokumentationen: , men jag slutar här.
I kommande artiklar kommer vi att fortsätta diskussionen om övervakning: vi kommer att prata om insamling och analys av loggar med hjälp av Grafana Loki och alternativa verktyg.
Författare: Marcel Ibraev, certifierad Kubernetes-administratör, praktiserande ingenjör på företaget , talare och kursutvecklare på Slörm.
Källa: habr.com
