

Hej alla! Jag heter Nikolai Golov. Tidigare arbetade jag på Avito och ledde Data Platform i sex år, vilket innebar att jag hanterade alla databaser: analytiska (Vertica, ClickHouse), strömmande och OLTP (Redis, Tarantool, VoltDB, MongoDB, PostgreSQL). Under denna tid har jag kommit i kontakt med en stor mängd databaser — av olika och ovanliga slag, och med icke-standardiserade användningsfall.
Just nu arbetar jag på ManyChat. Det är i grunden en startup — ny, ambitiös och snabbt växande. Och när jag precis började på företaget, uppstod den klassiska frågan: "Vad bör en ung startup välja från marknaden för DBMS och databaser just nu?".
I den här artikeln, baserad på mitt föredrag på , svarar jag på den frågan. Videoversionen av föredraget finns tillgänglig på .
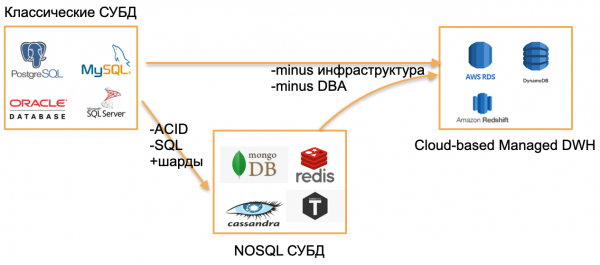
Välkända databaser 2020
Det är år 2020, jag såg mig omkring och såg tre typer av databaser.
Den första typen — klassiska OLTP-databaser: PostgreSQL, SQL Server, Oracle, MySQL. De skapades för länge sedan, men är fortfarande aktuella eftersom de är välkända för utvecklarsamhället.
Den andra typen — databaser från "nollorna".De försökte avvika från klassiska mönster genom att avstå från SQL, traditionella strukturer och ACID, genom att lägga till inbyggd sharding och andra attraktiva funktioner. Exempel på detta är Cassandra, MongoDB, Redis eller Tarantool. Alla dessa lösningar ville erbjuda marknaden något helt nytt och fann sin nisch, eftersom de visade sig vara extremt bekväma för vissa uppgifter. Jag kommer att beteckna dessa databaser med den övergripande termen NOSQL.
"Nollorna" är över, människor har vant sig vid NOSQL-databaser, och världen, enligt min uppfattning, har gjort ett nästa steg — mot managed databaser.Dessa databaser har samma kärna som klassiska OLTP-databaser eller nya NoSQL. Men de har inget behov av DBA och DevOps och de körs på hanterad hårdvara i molnet. För utvecklaren är det "bara en databas" som fungerar någonstans, och hur den är installerad på servern, vem som har konfigurerat servern och vem som uppdaterar den, berör ingen.
Exempel på sådana databaser:
- AWS RDS — en hanterad wrapper över PostgreSQL/MySQL.
- DynamoDB — AWS:s dokumentbaserade databas, liknande Redis och MongoDB.
- Amazon Redshift — en hanterad analytisk databas.
I grunden handlar det om gamla databaser, men i en hanterad miljö, utan behov av att arbeta med hårdvara.
Obs. Exemplen är tagna för AWS-miljön, men deras motsvarigheter finns också i Microsoft Azure, Google Cloud, eller Yandex.Cloud.
Vad är nytt med detta? År 2020 är inget av detta nytt.
Serverless-konceptet
Något helt nytt på marknaden 2020 var serverless eller serverfria lösningar.
Låt mig förklara vad det innebär med ett exempel på en vanlig tjänst eller backend-applikation.
För att lansera en vanlig backend-applikation köper eller hyr vi en server, kopierar koden dit, publicerar en extern endpoint och betalar regelbundet för hyra, elektricitet och datacenter-tjänster. Det här är standardproceduren.
Finns det något annat sätt? Med serverfria tjänster finns det.
Vad är knäckfrågan med detta tillvägagångssätt: det finns ingen server, inte ens en hyra av en virtuell instans i molnet. För att lansera tjänsten kopierar vi koden (funktionerna) till ett repository och publicerar en extern endpoint. Sedan betalar vi bara för varje anrop av denna funktion, helt ovetande om den hårdvara där den körs.
Jag ska försöka illustrera detta tillvägagångssätt med bilder.
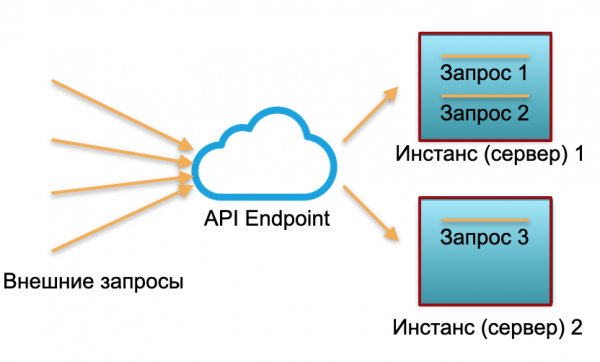
Klassisk deploy. Vi har en tjänst med viss belastning. Vi startar två instanser: fysiska servrar eller instanser i AWS. Externa förfrågningar riktas till dessa instanser, som hanterar dem.
Som man kan se på bilden är servrarna utnyttjade på olika sätt. En är utnyttjad till 100%, där finns två förfrågningar, medan en annan bara är utnyttjad till 50% — den står delvis stilla. Om tre förfrågningar kommer in istället för trettio, så klarar inte systemet av belastningen och börjar sega.
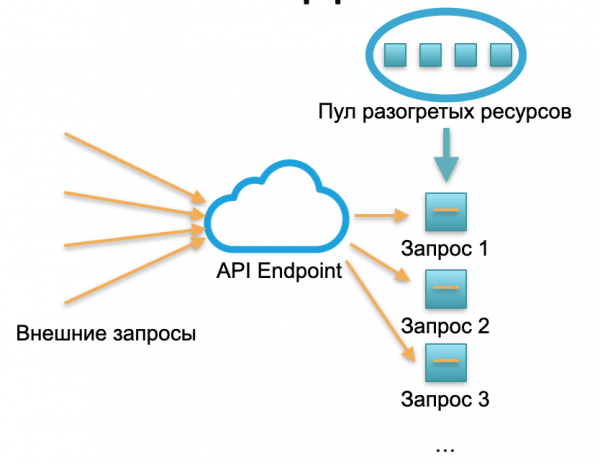
Serverlös deploy. I en serverlös miljö finns det inga instanser och servrar för en sådan tjänst. Det finns en viss pool av uppvärmda resurser — små förberedda Docker-containrar med den distribuerade funktionskoden. Systemet tar emot externa förfrågningar och för varje av dem startar det serverlösa ramverket en liten container med koden: hanterar just den förfrågan och dödar containern.
En förfrågan — en startad container, 1000 förfrågningar — 1000 containrar. Och utplaceringen av hårdvaruservrar är redan cloud-providerns jobb. Det döljs helt av det serverlösa ramverket. I detta koncept betalar vi för varje anrop. Till exempel, om en förfrågan kommer in per dag — vi betalar för ett anrop, kommer en miljon per minut — vi betalar för en miljon. Eller per sekund, det händer också.
Konceptet av publicering av serverlös funktion passar för en stateless tjänst. Men om du behöver en stateful tjänst, lägger vi till en databas till tjänsten. I detta fall, när det kommer till att arbeta med state, skriver och läser varje stateful funktion bara från databasen. Dessutom från en databas av vilket som helst av de tre typerna som beskrivits i början av artikeln.
Vad är den gemensamma begränsningen för alla dessa databaser? Det handlar om kostnader för den ständigt använda moln- eller hårdvaruservern (eller flera servrar). Oavsett om vi använder en klassisk databas eller en managed, med DevOps och admin eller inte, betalar vi fortfarande 24/7 för hårdvara, el och datacenterhyra. Om vi har en klassisk databas, betalar vi för master och slave. Om det är en högbelastad, sharded databas — betalar vi för 10, 20 eller 30 servrar, och vi betalar ständigt.
Närvaron av ständigt reserverade servrar i kostnadsstrukturen ansågs tidigare som en oundviklig ondska. Vanliga databaser har också andra svårigheter, såsom begränsningar på antal anslutningar, skalningsbegränsningar och geografisk konsensus — dessa kan lösas i vissa databaser, men inte alla på en gång och inte perfekt.
Serverless databas — teori
Frågan för 2020: kan en databas också göras serverless? Alla har hört talas om serverless backend... men låt oss försöka göra databasen serverless också!
Det låter konstigt, eftersom en databas är en stateful tjänst, vilket inte riktigt passar in i en serverless infrastruktur. Samtidigt har databasen en mycket stor state: gigabyte, terabyte och i analytiska databaser till och med petabyte. Det är inte så lätt att hantera i lätta Docker-containrar.
Å andra sidan handlar praktiskt taget alla moderna databaser om en stor mängd logik och komponenter: transaktioner, integritetsöverensstämmelse, procedurer, relationella beroenden och mycket logik. En ganska stor del av databasens logik kräver en relativt liten state. Gigabyte och terabyte används endast av en liten del av databasens logik som är kopplad till den direkta utföringen av förfrågningar.
Därför är idén: om en del av logiken tillåter stateless exekvering, varför inte dela upp databasen i stateful och stateless delar?
Serverless för OLAP-lösningar
Låt oss se hur uppdelningen av databasen i stateful och stateless delar kan se ut i praktiska exempel.
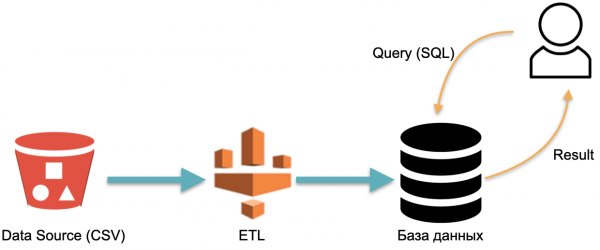
Till exempel har vi en analytisk databas: externa data (röd cylinder till vänster), ETL-processen som laddar data till databasen, och en analytiker som skickar SQL-frågor till databasen. Detta är ett klassiskt mönster för hur ett datalager fungerar.
I detta mönster utförs ETL-funktionen en gång. Därefter måste vi betala för servrarna där databasen med de inlästa data körs, så att vi har något att skicka frågor till.
Låt oss titta på ett alternativt angreppssätt som implementeras i AWS Athena Serverless. Här finns ingen konstant hårdvara som lagrar de inlästa data. Istället:
- Användaren skickar en SQL-fråga till Athena. Athena-optimeraren analyserar SQL-frågan och söker i metadata-lagret specifika data som behövs för att utföra frågan.
- Optimeraren, baserat på insamlade data, hämtar nödvändiga data från externa källor till ett temporärt lagringsutrymme (tillfällig databas).
- I det temporära lagringsutrymmet körs SQL-frågan från användaren, resultaten returneras till användaren.
- Det temporära lagret rensas, resurser frigörs.
I denna arkitektur betalar vi endast för processen att utföra frågan. Inga frågor - inga kostnader.
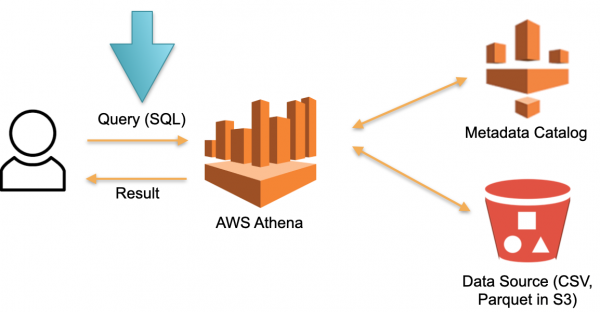
Detta är en fungerande metod och den implementeras inte bara i Athena Serverless, utan också i Redshift Spectrum (i AWS).
Exemplet med Athena visar att Serverless-databaser fungerar med verkliga frågor med tiotals och hundratals terabyte data. För hundratals terabyte behövs hundratals servrar, men vi behöver inte betala för dem - vi betalar för frågorna. Hastigheten för varje fråga är (mycket) låg jämfört med specialiserade analytiska databaser som Vertica, men vi betalar inte för stillastående tid.
En sådan databas är tillämpbar för sällsynta analytiska ad-hoc frågor. Till exempel, när vi spontant beslutar att testa en hypotes på ett enormt datamängd. För dessa fall är Athena perfekt. För regelbundna frågor blir ett sådant system dyrt. I detta fall, cache data i en specialiserad lösning.
Serverless för OLTP-lösningar
I det föregående exemplet diskuterades OLAP-uppgifter (analytiska). Nu ser vi på OLTP-uppgifter.
Låt oss tänka oss en skalbar PostgreSQL eller MySQL. Vi ska starta en vanlig managed instans av PostgreSQL eller MySQL med minimala resurser. När instansen får mer belastning kommer vi att ansluta ytterligare repliker, som vi fördelar en del av läsbelastningen på. Om det inte finns några förfrågningar eller belastning stänger vi av replikerna. Den första instansen är master, medan de övriga är repliker.
Denna idé realiseras i en databas som kallas Aurora Serverless AWS. Principen är enkel: förfrågningar från externa applikationer tas emot av en proxyflotta. När den ser en ökning av belastningen tilldelar den beräkningsresurser från förväg uppvärmda minimala instanser — anslutningen sker så snabbt som möjligt. Avstängning av instanser sker på samma sätt.
Inom Aurora finns begreppet Aurora Capacity Unit, ACU. Detta är (villkorligt) en instans (server). Varje specifik ACU kan vara master eller slave. Varje Capacity Unit har sin egen RAM, processor och minimal disk. Följaktligen är en master och de övriga skrivskyddade repliker.
Antalet aktiva Aurora Capacity Units är en konfigurerbar parameter. Det minimiantal som kan sättas är ett eller noll (i så fall fungerar inte databasen om det inte finns några förfrågningar).
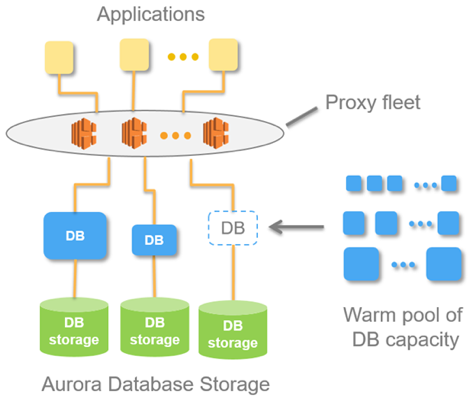
När databasen får förfrågningar startar proxyflottan Aurora Capacity Units och ökar systemets prestandaresurser. Möjligheten att öka och minska resurser gör att systemet kan "jonglera" med resurser: automatiskt ta ut vissa ACU (ersätta dem med nya) och tillämpa alla aktuella uppdateringar på de uttagna resurserna.
Aurora Serverless-databasen kan skala läsbelastningen. Men detta nämns inte uttryckligen i dokumentationen. Det kan bli en känsla av att de kan skapa en multi-master. Det finns dock inget magiskt med det.
Denna databas är väl lämpad för att undvika att spendera stora pengar på system med oförutsägbart tillgång. Till exempel, när vi skapar MVP eller marknadsföringssajter, förväntar vi oss vanligtvis inte en stabil belastning. Därför, vid brist på tillgång, betalar vi inget för instanser. När belastningen plötsligt ökar, till exempel efter en konferens eller marknadsföringskampanj, kommer många människor att besöka sajten och belastningen ökar snabbt; Aurora Serverless anpassar sig automatiskt till denna belastning och kopplar snabbt på de saknade resurserna (ACU). Efter konferensen glömmer alla prototypen, servrarna (ACU) stängs av, och kostnaderna faller till noll - mycket praktiskt.
Denna lösning är inte lämplig för stabil hög belastning, eftersom den inte kan skala den skrivande belastningen. Alla dessa anslutningar och kopplingar av resurser sker vid den så kallade „skala-punkten” — tidpunkten när databasen inte hålls av en transaktion, och inga temporära tabeller hålls. Till exempel, under en vecka kan det hända att ingen skala-punkt inträffar, och databasen arbetar med samma resurser och helt enkelt inte kan varken expandera eller minska.
Det finns inget magiskt — detta är vanlig PostgreSQL. Men processen för att lägga till maskiner och stänga av dem är delvis automatiserad.
Serverless by design
Aurora Serverless är en gammal databas som skrivits om för molnet för att utnyttja de specifika fördelarna med Serverless. Nu kommer jag att prata om en databas som från början är skriven för molnet, under serverless-ansatsen — Serverless-by-design. Den designades utan förutsättningar om att den skulle fungera på fysiska servrar.
Denna databas kallas Snowflake. Den har tre centrala block.
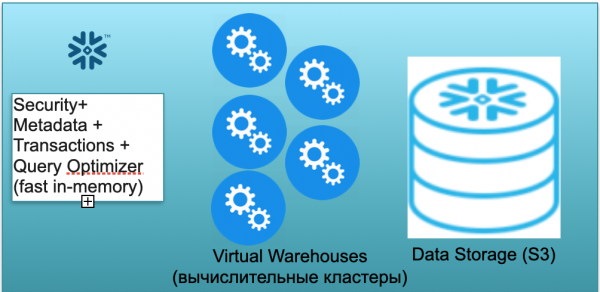
Det första är metadata-blocket. Detta är en snabb in-memory-tjänst som hanterar frågor kring säkerhet, metadata, transaktioner, och query-optimering (i illustrationen till vänster).
Det andra blocket — en mängd virtuella beräkningskluster för beräkningar (i illustrationen — ett set av blå cirklar).
Det tredje blocket — datalagringssystemet baserat på S3. S3 är en dimensionlös objektlagring i AWS, ett slags dimensionlös Dropbox för företag.
Låt oss titta på hur Snowflake fungerar under förutsättning av en kall start. Det vill säga att databasen finns, data är laddad, men inga aktiva förfrågningar görs. Om inga förfrågningar görs mot databasen har vi en snabb in-memory Metadata-tjänst uppe (den första blocket). Vi har också en S3-lagring där tabellernas data ligger uppdelad i så kallade mikropartitioner. Förenklat: om tabellen innehåller affärer, så är mikropartitionerna dagar av affärer. Varje dag är en separat mikropartition, en egen fil. När databasen fungerar i detta läge betalar du endast för det utrymme som data tar. Dessutom är kostnaden för utrymme mycket låg (särskilt med tanke på betydande kompression). Metadata-tjänsten är också ständigt verksam, men för att optimera förfrågningarna krävs inte mycket resurser, och tjänsten kan anses vara i praktiken kostnadsfri.
Nu föreställer vi oss att en användare har skickat en SQL-förfrågan till vår databas. SQL-förfrågan skickas omedelbart för behandling till Metadata-tjänsten. Tjänsten analyserar förfrågan, tillgängliga data, användarens behörigheter, och om allt ser bra ut skapar den en plan för hur förfrågan ska bearbetas.
Därefter initierar tjänsten starten av ett beräkningskluster. Beräkningsklustret är ett kluster av servrar som utför beräkningar. Det vill säga, det kan innehålla 1 server, 2 servrar, 4, 8, 16, 32 – så många ni vill. Du skickar din förfrågan och klustret startas omedelbart för den. Det tar verkligen sekunder.
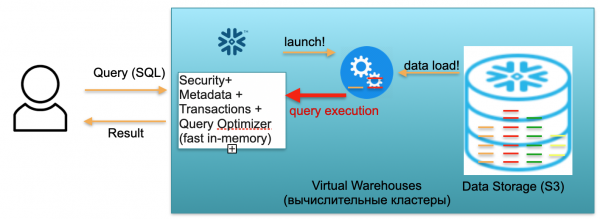
Sedan, efter att klustret har startat, börjar mikropartiklar kopieras från S3 till klustret, vilket är nödvändigt för att bearbeta just din förfrågan. Det vill säga, låt oss föreställa oss att för att utföra en SQL-förfrågan behövs två partitioner från en tabell och en från den andra. I så fall kommer endast de tre nödvändiga partitionerna att kopieras till klustret, och inte hela tabeller. Just därför och på grund av att allt ligger inom ett datacenter och är anslutet med mycket snabba kanaler, sker hela överföringsprocessen mycket snabbt: på sekunder, mycket sällan — på minuter, om det rör sig om några enorma förfrågningar. Följaktligen kopieras mikropartiklarna till det beräkningsklustret, och när det är klart utförs SQL-förfrågan på detta beräkningskluster. Resultatet av denna förfrågan kan vara en rad, flera rader eller en tabell — de skickas ut till användaren så att denne kan hämta dem, visa dem i sitt BI-verktyg, eller använda dem på något annat sätt.
Varje SQL-förfrågan kan inte bara räkna aggregat från tidigare inladdade data, utan också ladda/formera nya data i databasen. Det vill säga, det kan vara en förfrågan som till exempel utför en insättning av nya poster i en annan tabell, vilket resulterar i att en ny partition skapas på det beräkningsklustret, som i sin tur automatiskt sparas i det gemensamma S3-lagringsutrymmet.
Det beskrivna scenariot, från det att användaren kommer in tills klustret startas, dataladdning, utförande av förfrågningar, och mottagande av resultat, faktureras per minut för användningen av det uppstartade virtuella beräkningsklustret, det virtuella lagret. Avgiften varierar beroende på AWS-zon och storlek på klustret, men i genomsnitt handlar det om några dollar i timmen. Klustret med fyra maskiner är dubbelt så dyrt som klustret med två maskiner, och klustret med åtta maskiner är dubbelt så dyrt som det med fyra. Alternativ med 16, 32 maskiner finns tillgängliga beroende på komplexiteten hos förfrågningarna. Men du betalar endast för de minuter som klustret verkligen arbetar, eftersom, när det inte finns några förfrågningar, kan du som det vore lägga ner händerna, och efter 5-10 minuters väntan (anpassningsbar parameter) kommer det automatiskt att stängas av, frigöra resurser och bli gratis.
Det är helt realistiskt att ett scenario där du skickar en begäran, klustret dyker upp, för att säga, på en minut, ytterligare en minut för att räkna, fem minuter för stängning, och du betalar till slut för sju minuters arbete av det klustret, istället för månader och år.
Det första scenariot beskrev användningen av Snowflake i en enskild användare-version. Nu låt oss föreställa oss att det finns många användare, vilket är närmare ett verkligt scenario.
Anta att vi har många analytiker och Tableau-rapporter som ständigt bombarderar vår databas med en stor mängd enkla analytiska SQL-frågor.
Dessutom, låt oss anta att vi har påhittiga Data Scientists som försöker göra monsterartade saker med data, hantera tiotals terabyte, analysera miljarder och triljoner rader data.
För de två typerna av belastning som beskrivits ovan tillåter Snowflake att flera oberoende beräkningskluster av olika kapaciteter upprättas. Dessa beräkningskluster arbetar oberoende men med gemensamma koordinerade data.
För ett stort antal lätta frågor kan man upprätta 2-3 små kluster, som var och en består av, säg, 2 maskiner. Detta beteende kan implementeras, bland annat, med hjälp av automatiska inställningar. Det vill säga, du säger: „Snowflake, upprätta ett litet kluster. Om belastningen på det ökar över en viss parameter, upprätta en liknande andra, tredje. När belastningen börjar avta - stäng av överskottet”. Så att oavsett hur många analytiker som kommer och börjar titta på rapporterna, har alla tillräckligt med resurser.
Om analytikerna sover, och rapporterna inte tittas på - kan klustren helt stängas av, och du slutar betala för dem.
För tunga frågor (från Data Scientists) kan du upprätta ett mycket stort kluster bestående av hypotetiska 32 maskiner. Detta kluster kommer också att debiteras endast för de minuter och timmar när din gigantiska fråga körs där.
Den beskrivna möjligheten ovan gör det möjligt att dela upp kluster inte bara i 2, utan även i fler typer av belastningar (ETL, övervakning, materialisering av rapporter,… ).
Sammanfattningsvis om Snowflake. Databasen kombinerar en vacker idé med en fungerande implementation. På ManyChat använder vi Snowflake för att analysera all tillgänglig data. Vi har inte tre kluster som i exemplet, utan mellan 5 och 9, i olika storlekar. Vi har så kallade 16-maskins och 2-maskins-kluster, samt supersmå 1-maskins-kluster för vissa uppgifter. De fördelar lasten effektivt och hjälper oss att spara pengar.
Databasen skalar framgångsrikt både läs- och skrivbelastning. Detta är en stor skillnad och ett stort genombrott jämfört med "Aurora", som endast hanterade läsbelastning. Snowflake möjliggör att skala skrivbelastningen med dessa beräkningskluster. Så, som jag nämnde, använder vi flera kluster på ManyChat, små och super-små kluster används främst för ETL, för att ladda data. Och analytiker använder de medelstora kluster som absolut inte påverkas av ETL-belastningen, vilket gör att de arbetar mycket snabbt.
Därmed passar databasen bra för OLAP-uppgifter. Tyvärr är den dock ännu inte tillämplig för OLTP-belastningar. För det första är denna databas kolumnbaserad, med alla därav följande konsekvenser. För det andra är tillvägagångssättet att du vid varje begäran vid behov aktiverar ett beräkningskluster och matar in data i det, tyvärr fortfarande inte tillräckligt snabbt för OLTP-belastningar. Sekundära väntetider för OLAP-uppgifter är acceptabla, men för OLTP-uppgifter är det oacceptabelt; det skulle helst vara 100 ms, ännu bättre 10 ms.
Resultat
Serverless databas är möjlig tack vare uppdelningen av databasen i Stateless och Stateful delar. Du har säkert lagt märke till att i alla de givna exemplen, så är Stateful-delen – så att säga – lagringen av mikro-partitioner i S3, medan Stateless är optimeraren, arbetet med metadata, och hanteringen av säkerhetsfrågor som kan lyftas som oberoende lättvikts Stateless-tjänster.
Utförande av SQL-frågor kan också ses som tjänster med ett lätt state, som kan dyka upp i serverless-läge, likt Snowflake beräkningskluster, hämta endast nödvändig data, utföra frågan och "släckas".
Serverless-databaser av produktionsnivå är nu tillgängliga för användning och fungerar. Dessa serverless-databaser är redan redo att hantera OLAP-uppgifter. Tyvärr används de för OLTP-uppgifter... med vissa nyanser, då det finns begränsningar. Å ena sidan är det en nackdel. Men å andra sidan är det en möjlighet. Kanske hittar någon av läsarna ett sätt att göra en OLTP-databas helt serverless, utan begränsningar från Aurora.
Jag hoppas att ni tyckte det var intressant. För serverless framtid 🙂
Källa: habr.com
