

Obs. övers.: att anpassa Kubernetes i GitLab anses vara en av två huvudfaktorer som bidrar till företagets tillväxt. Ändå har infrastrukturen för onlinetjänsten GitLab.com fram till nyligen byggts på virtuella maskiner, och det var först för ett år sedan som migrationen till K8s började, och den pågår fortfarande. Vi är glada att presentera en översättning av en nyligen publicerad artikel av SRE-ingenjören på GitLab om hur detta görs och vilka slutsatser ingenjörerna som deltar i projektet gör.
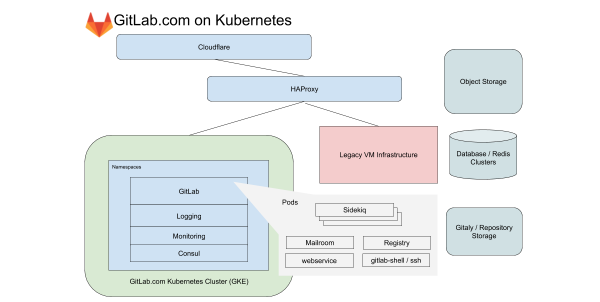
Sedan ungefär ett år tillbaka har vår infrastrukturavdelning arbetat med att migrera alla tjänster som körs på GitLab.com till Kubernetes. Under denna tid har vi stött på problem relaterade inte bara till flytt av tjänster till Kubernetes, utan också med att hantera en hybriddeployment under övergången. Det är värdefulla lärdomar som vi har fått som vi kommer att diskutera i denna artikel.
Från början har GitLab.coms servrar fungerat i molnet på virtuella maskiner. Dessa virtuella maskiner hanteras av Chef, och deras installation sker via vår . i händelse av att applikationen behöver uppdateras, består av en enkel uppdatering av serverparken på ett koordinerat och sekventiellt sätt med hjälp av en CI-pipeline. Denna metod — även om den är långsam och lite (self-managed) GitLab-installationer, som använder våra Linux-paket för detta. Vi använder denna metod eftersom det är av yttersta vikt att uppleva alla sorg och glädje som vanliga medlemmar i samhället upplever när de installerar och konfigurerar sina kopior av GitLab. Denna metod har fungerat bra under en tid, men när antalet projekt på GitLab passerade 10 miljoner insåg vi att den inte längre tillgodose våra behov på skalning och distribution.
De första stegen mot Kubernetes och cloud-native GitLab
År 2017 startades projektet
GitLab Charts för att förbereda GitLab för distribution i molnet, samt för att ge användarna möjlighet att installera GitLab i Kubernetes-kluster. Då visste vi att flytten av GitLab till Kubernetes skulle öka skalbarheten för SaaS-plattformen, förenkla distributioner och förbättra resursanvändningen. Samtidigt var många funktioner i vår applikation beroende av monterade NFS-partitioner, vilket fördröjde övergången från virtuella maskiner.
Strävan efter cloud native och Kubernetes har gjort det möjligt för våra ingenjörer att planera en gradvis övergång, där vi har avbrutit vissa beroenden av applikationen till nätverkslagring, samtidigt som vi fortsatte att utveckla nya funktioner. Sedan vi började planera migreringen sommaren 2019 har många av dessa begränsningar avlägsnats, och processen för att flytta GitLab.com till Kubernetes är nu i full gång!
Funktioner för GitLab.com i Kubernetes
För GitLab.com använder vi en enda regional GKE-kluster som hanterar all trafik till applikationen. För att minimera komplexiteten (som redan är svår) i migreringen, fokuserar vi på tjänster som inte är beroende av lokal lagring eller NFS. GitLab.com använder huvudsakligen en monolitisk kodbas på Rails, och vi dirigerar trafiken beroende av arbetsbelastningens egenskaper till olika slutpunkter som isoleras i sina egna nodpooler.
När det gäller frontenden delas dessa typer upp i förfrågningar till webben, API, Git SSH/HTTPS och Registry. För backend delar vi upp jobben i köer baserat på olika egenskaper beroende på , vilket gör att vi kan sätta mål för servicenivå (Service-Level Objectives, SLOs) för olika belastningar.
Alla dessa tjänster på GitLab.com är konfigurerade med den oförändrade Helm-diagrammet för GitLab. Konfigurationen görs i subdiagram som kan väljas att inkluderas allt eftersom vi gradvis flyttar tjänster till klustret. Trots att det beslutades att inte inkludera vissa av våra stateful-tjänster i migreringen, som Redis, Postgres, GitLab Pages och Gitaly, gör Kubernetes det möjligt att radikalt minska antalet VM som för närvarande hanteras av Chef.
Transparens och hantering av Kubernetes-konfiguration
Alla inställningar hanteras av GitLab själv. Tre konfigurationsprojekt baserade på Terraform och Helm används för detta. Vi försöker använda GitLab så mycket som möjligt för att starta GitLab, men för driftsuppgifter har vi en separat installation av GitLab. Den behövs för att inte vara beroende av tillgängligheten av GitLab.com vid utrullningar och uppdateringar av GitLab.com.
Även om våra pipelines för Kubernetes-klustret körs på en separat installation av GitLab, har kodförvaren speglar som är offentligt tillgängliga på följande adresser:
- — konfigurationsbindning för GitLab.com för Helm-diagrammet GitLab;
- — innehåller konfigurationer för tjänster som inte är direkt relaterade till applikationen GitLab. Dessa inkluderar konfigurationer för logghantering och övervakning av klustret, samt för integrerade verktyg som PlantUML;
- — Terraform-konfiguration för Kubernetes och den äldre (legacy) VM-infrastrukturen. Här konfigureras alla resurser som behövs för att starta klustret, inklusive själva klustret, nodpooler, tjänstekonton och reservering av IP-adresser.

När ändringar görs visas en offentlig med en länk till en detaljerad diff som SRE analyserar innan ändringar införs i klustret.
För SRE leder länken till en detaljerad diff i den installation av GitLab som används för drift och som har begränsad åtkomst. Detta gör att anställda och samhället utan åtkomst till driftsprojektet (som endast är öppet för SRE) kan granska föreslagna ändringar i konfigurationen. Genom att kombinera en offentlig GitLab-instans för kod med en privat instans för CI-pipelines behåller vi en enhetlig arbetsprocess, samtidigt som vi garanterar oberoende från GitLab.com vid konfigurationsuppdateringar.
Vad vi har lärt oss under migreringen
Under flytten har erfarenhet samlats som vi tillämpar på nya migrationer och distributioner i Kubernetes.
1. Ökade kostnader på grund av trafik mellan tillgänglighetszoner
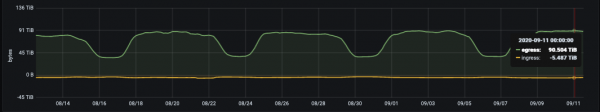
Daglig egress-statistik (byte per dag) för parken av Git-förvar på GitLab.com
Google delar sitt nätverk i regioner. Dessa delas i sin tur upp i tillgänglighetszoner (AZ). Git-hosting är kopplad till stora datamängder, så det är viktigt för oss att kontrollera nätverksutgående trafik. Inom intern trafik är utgående trafik gratis endast om den stannar inom en och samma tillgänglighetszon. Vid tiden för denna artikel överför vi cirka 100 TB data en vanlig arbetsdag (och detta gäller endast för Git-repositorier). Tjänster som i vår gamla VM-baserade topologi låg på samma virtuella maskiner fungerar nu i olika poddar i Kubernetes. Det innebär att en del av trafiken som tidigare var lokal för VM potentiellt kan gå utanför tillgänglighetszonerna.
Regionala GKE-kluster gör det möjligt att täcka flera tillgänglighetszoner för redundans. Vi överväger att för tjänster som genererar stora mängder trafik. Detta skulle minska kostnaderna för utgående trafik samtidigt som redundansen på klusternivå bibehålls.
2. Resursbegränsningar, resursförfrågningar och skalning
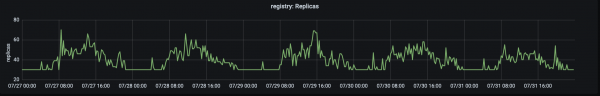
Antalet repliker som hanterar produktionstrafik på registry.gitlab.com. Trafiken når sin topp runt 15:00 UTC.
Vår migrationshistoria började i augusti 2019 när vi flyttade den första tjänsten — GitLab Container Registry — till Kubernetes. Denna kritiskt viktiga tjänst med hög trafik passade bra för den första migreringen eftersom den är en stateless-applikation med få externa beroenden. Det första problemet vi stötte på var ett stort antal borttagna poddar på grund av brist på minne på noderna. Detta tvingade oss att ändra resursförfrågningar och begränsningar.
Det upptäcktes att för applikationer vars minnesanvändning växer över tid, låga värden för resursförfrågningar (som reserverar minne för varje pod) i kombination med en "generös" hård begränsning på användning ledde till mättnad (saturation) av noder och en hög nivå av borttagningar. För att hantera detta problem beslutades det att . Detta minskade trycket på noderna och säkerställde en livscykel för poddar som inte utövade för stort tryck på noden. Nu påbörjar vi migrationer med generösa (och nästan identiska) värden för begärningar och begränsningar, som vi justerar vid behov.
3. Metrik och loggar
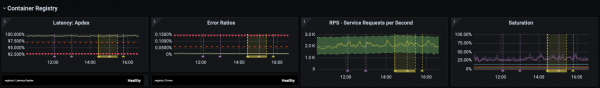
Infrastrukturavdelningen fokuserar på latens, felprocent och mättnad med fastställda (SLO) kopplade till .
Under det gångna året har en av de viktigaste händelserna inom infrastrukturavdelningen varit förbättringar inom övervakning och arbete med SLO. SLO har tillåtit oss att sätta mål för specifika tjänster, som vi noggrant övervakade under migrationen. Men även med sådan förbättrad övervakning är det inte alltid lätt att genast se problem med hjälp av metrik och aviseringar. Till exempel, genom att fokusera på latens och felprocent täcker vi inte fullt ut alla användningssituationer för tjänsten som genomgår migration.
هذا problemet upptäcktes nästan omedelbart efter att en del av arbetsbelastningen flyttades till klustret. Det blev särskilt påtagligt när vi behövde kontrollera funktioner med ett lågt antal förfrågningar, men som har mycket specifika konfigurationsberoenden. En av de viktigaste lärdomarna från migrationen blev att vi inte bara ska ta hänsyn till metrik, utan även loggar och 'långsvansen' (det handlar om på grafen – anm. övers. av fel. Nu inkluderar vi en detaljerad lista över loggförfrågningar (log queries) och planerar tydliga återställningsprocedurer som vid problem kan överföras från ett skift till ett annat.
Parallell drift av samma förfrågningar på den gamla VM-infrastrukturen och den nya, baserad på Kubernetes, utgjorde en unik utmaning. Till skillnad från en lift-and-shift-migration (snabb överföring av applikationer 'som de är' till en ny infrastruktur; mer kan läsas om detta, till exempel, — anm. red.), parallellt arbete på "gamla" VM och Kubernetes kräver att verktygen för övervakning är kompatibla med båda miljöerna och kan kombinera mätvärden i en enhetlig vy. Det är viktigt att vi använder samma dashboards och loggförrfrågningar för att uppnå en konsekvent övervakning under övergångsperioden.
4. Växling av trafik till den nya klustret
För GitLab.com avsätts en del servrar för . Kanariefarkosten betjänar våra interna projekt samt kan . Men i första hand är den avsedd för att testa förändringar som görs i infrastrukturen och applikationen. Den första flyttade tjänsten började med att ta emot en begränsad mängd intern trafik, och vi fortsätter att använda denna metod för att säkerställa att SLO följs innan vi dirigerar all trafik till klustret.
Vid migrering innebär detta att förfrågningar till interna projekt först riktas till Kubernetes, och sedan gradvis växlar vi den andra trafiken till klustret genom att ändra vikten för backend via HAProxy. Under övergången från VM till Kubernetes blev det tydligt att det är mycket fördelaktigt att ha en enkel metod för att omdirigera trafik mellan den gamla och den nya infrastrukturen och därmed hålla den gamla infrastrukturen redo för återgång under de första dagarna efter migreringen.
5. Reservkapacitet för poddar och deras användning
Nästan omedelbart identifierades följande problem: poddar för tjänsten Registry startade snabbt, men uppstarten av poddar för Sidekiq tog upp till . Den långvariga uppstarten av poddar för Sidekiq blev ett problem när vi började migrera arbetsbelastningar för arbetare till Kubernetes, som behöver snabbt bearbeta jobb och snabbt kunna skala.
Lärdomen här var att, även om Horizontal Pod Autoscaler (HPA) i Kubernetes hanterar trafikökningar väl, är det viktigt att ta hänsyn till egenskaperna hos arbetsbelastningar och avsätta reservkapacitet för poddar (särskilt under obalanserad efterfrågan). I vårt fall observerades en plötslig ökning av jobb som krävde snabb skalning, vilket ledde till att CPU-resurserna mättades innan vi kunde skala nodpoolen.
Det finns alltid en frestelse att maximera vad man kan "få ut" av klustret, men vi, som initialt stötte på prestandaproblem, börjar nu med en generös podbudget och minskar den senare, samtidigt som vi noggrant övervakar SLO. Lanseringen av poddar för Sidekiq-tjänsten har betydligt påskyndats och tar nu i genomsnitt cirka 40 sekunder. har både GitLab.com och våra användare av självhanterade installationer, som arbetar med GitLabs officiella Helm-diagram, dragit nytta av detta.
Slutsats
Efter flytten av varje tjänst har vi glädjats åt fördelarna med att använda Kubernetes i produktion: snabbare och säkrare applikationsdeployer, skalbarhet och mer effektiv resursfördelning. Fördelarna med migreringen sträcker sig dessutom bortom GitLab.com-tjänsten. Varje förbättring av det officiella Helm-diagrammet gynnar dess användare.
Jag hoppas att ni gillade berättelsen om våra äventyr med migreringen till Kubernetes. Vi fortsätter att flytta allt fler tjänster till klustret. Mer information kan hämtas från följande publikationer:
- «»;
- «»;
- .
P.S. från översättaren
Läs även i vår blogg:
- «»;
- «»;
- «»;
- «».
Källa: habr.com
