

De dagar då man inte behövde oroa sig för databasens prestanda är förbi. Tiden står inte still. Varje ny teknologientreprenör vill skapa nästa Facebook och samla in all data de kan få tag på. Denna data behövs för att företag ska kunna träna modeller av högre kvalitet som hjälper dem att tjäna pengar. Under dessa förhållanden måste programmerare skapa API:er som gör det möjligt att snabbt och pålitligt arbeta med enorma datamängder.
Om du har arbetat med att designa serverdelar av applikationer eller databaser under en tid har du förmodligen skrivit kod för att utföra paginering i dina frågor. Till exempel så här:
SELECT * FROM table_name LIMIT 10 OFFSET 40
Är det så?
Men om du har utfört paginering på detta sätt så måste jag tyvärr påpeka att du inte har gjort det på det mest effektiva sättet.
Vill du invända mot mig? . , och använder redan de metoder som jag vill berätta om idag.
Nämn en enda backendutvecklare som aldrig har använt OFFSET och LIMIT för att utföra paginerade frågor. I ett MVP (Minimum Viable Product, minimi livskraftig produkt) eller i projekt där små datamängder används är detta tillvägagångssätt fullt tillämpbart. Det 'bara fungerar', så att säga.
Men om man behöver skapa pålitliga och effektiva system från grunden, bör man se till att man i förväg tar hänsyn till effektiviteten i frågor mot databaser som används i sådana system.
Idag ska vi diskutera problem relaterade till de allmänt använda (tyvärr) implementeringarna av pagineringsmekanismer och hur man kan uppnå hög prestanda vid utförandet av sådana frågor.
Vad är fel med OFFSET och LIMIT?
Som tidigare nämnts OFFSET och LIMIT presterar utmärkt i projekt där man inte behöver arbeta med stora datamängder.
Problemet uppstår när databasen växer till en storlek som gör att den inte längre får plats i serverns minne. Men under arbetet med denna databas måste man använda paginerade frågor.
För att detta problem ska framträda krävs det en situation där databashanteraren (DBMS) använder en ineffektiv fullständig tabellskanning (Full Table Scan) för att utföra varje fråga med paginering (under tiden kan det ske operationer för att infoga och ta bort data, och föråldrad data är inte relevant för oss!).
Vad är "fullständig tabellskanning" (eller "sekventiell tabellgenomgång", Sequential Scan)? Det är en operation där DBMS sekventiellt läser varje rad i tabellen, det vill säga de data som finns i den, och kontrollerar dem mot ett specificerat villkor. Det är välkänt att denna typ av tabellgenomgång är den långsammaste. Problemet är att det vid denna operation förekommer många in-/utdataoperationer som belastar serverns diskunderhåll. Situationer förvärras av förseningar kopplade till arbetet med data lagrade på diskar, och det faktum att överföring av data från disk till minne är en resurskrävande operation.
Till exempel, om du har poster om 100000000 användare och du utför en fråga med konstruktionen OFFSET 50000000. Detta betyder att DBMS måste ladda alla dessa poster (och vi behöver dem inte ens!), placera dem i minnet, och först därefter hämta, säg, 20 resultat som anges i LIMIT.
Låt oss säga att det kan se ut så här: «välj rader från 50000 till 50020 av 100000». Det vill säga, för att utföra frågan måste systemet först ladda 50000 rader. Förstår du hur mycket onödigt arbete det måste utföra?
Om du inte tror mig - ta en titt på exemplet som jag skapade med hjälp av .
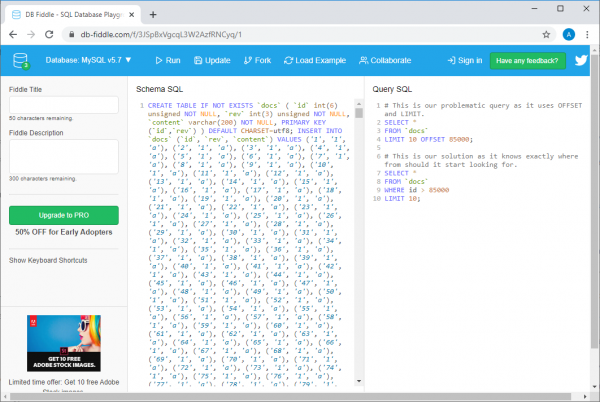
Exempel på db-fiddle.com
Där, till vänster, i fältet Schema SQL, finns det kod som infogar 100000 rader i databasen, och till höger, i fältet Query SQL, visas två frågor. Den första, som är långsam, ser ut så här:
SELECT *
FROM `docs`
LIMIT 10 OFFSET 85000;
Och den andra, som är en effektiv lösning på samma problem, ser ut så här:
SELECT *
FROM `docs`
WHERE id > 85000
LIMIT 10;
För att utföra dessa frågor räcker det att trycka på knappen Run i den övre delen av sidan. Genom att göra detta kan vi jämföra information om svarstider. Det visar sig att det tar minst 30 gånger längre tid att utföra en ineffektiv förfrågan än en andra (från körning till körning varierar denna tid, till exempel kan systemet rapportera att den första förfrågningen tog 37 ms, medan den andra tog 1 ms).
Och om datamängden ökar, kommer allt att se ännu värre ut (för att övertyga dig — kolla på min med 10 miljoner rader).
Det vi just diskuterade bör ge dig en viss förståelse för hur frågor till databaser faktiskt behandlas.
Tänk på att ju högre värde OFFSET — desto längre tid tar det att köra förfrågan.
Vad bör man använda istället för kombinationen OFFSET och LIMIT?
Istället för kombinationen OFFSET och LIMIT bör man använda en konstruktion som är uppbyggd enligt följande schema:
SELECT * FROM table_name WHERE id > 10 LIMIT 20
Detta är en förfrågan med sidindelning, baserad på en kursorn (Cursor based pagination).
Istället för att lokalt lagra aktuella OFFSET och LIMIT och skicka dem med varje förfrågan, bör man lagra den senaste erhållna primära nyckeln (vanligtvis är det ID) och LIMIT, vilket resulterar i förfrågningar som liknar den ovanstående.
Varför? Faktum är att genom att tydligt ange identifieraren för den sista lästa raden, informerar du din DBMS om var den ska börja söka efter de nödvändiga uppgifterna. Dessutom kommer sökningen, tack vare användningen av nyckeln, att ske effektivt, och systemet behöver inte avbryta för att titta på rader utanför det angivna intervallet.
Låt oss titta på följande jämförelse av prestandan för olika förfrågningar. Här är en ineffektiv förfrågan.
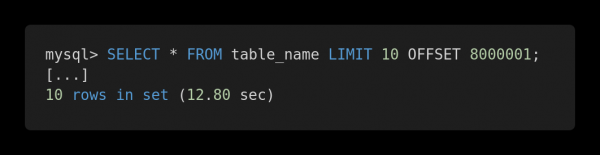
Långsam förfrågan
Och här är en optimerad version av denna förfrågan.
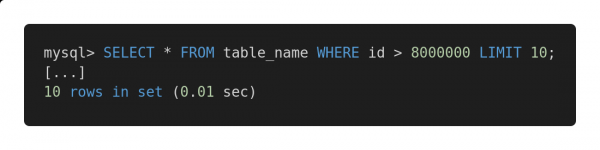
En snabb förfrågan
Båda förfrågningarna returnerar exakt samma mängd data. Men den första tar 12,80 sekunder att köra, medan den andra tar 0,01 sekund. Känner du skillnaden?
Möjliga problem
För att säkerställa att den föreslagna metoden för att utföra förfrågningar fungerar effektivt, måste tabellen innehålla en eller flera kolumner med unika, sekventiellt ordnade index, som en heltalsidentifierare. I vissa specifika fall kan detta avgöra framgången för användningen av sådana förfrågningar för att öka hastigheten på databasanvändningen.
Naturligtvis måste man ta hänsyn till tabellernas arkitektur när man konstruerar förfrågningar och välja de mekanismer som bäst presterar med de aktuella tabellerna. Till exempel, om man behöver arbeta med stora mängder relaterade data i förfrågningar, kan det vara intressant för dig. artikel.
Om vi har problemet med avsaknad av en primärnyckel, till exempel om det finns en tabell med en 'många-till-många'-relation, så är den traditionella metoden som förutsätter användning av OFFSET och LIMIT, vi garanterat kommer att kunna tillämpa. Men dess användning kan leda till att potentiellt långsamma förfrågningar utförs. I sådana fall skulle jag rekommendera att använda en primärnyckel med autoinkrement, även om den endast behövs för att organisera förfrågningar med paginering.
Om du är intresserad av detta ämne — , och — här är några användbara resurser.
Sammanfattning
Det huvudsakliga slutsatsen vi kan dra är att oavsett storleken på databaserna måste förfrågningarnas hastighet alltid analyseras. I vår tid är skalbarhet av lösningar extremt viktigt, och om man redan från början av arbetet med ett system designar allt korrekt, kan detta i framtiden spara utvecklaren från många problem.
Hur analyserar och optimerar du förfrågningar mot databaser?
Källa: habr.com
