

Hej, Habr!
Vi påminner om att vi, efter boken om har släppt ett lika intressant verk om biblioteket .
Just nu utforskar communityn fortfarande gränserna för detta kraftfulla verktyg. Nyligen publicerades en artikel som vi vill introducera er för. Författaren berättar utifrån egen erfarenhet hur man gör ett distribuerat datalager av Kafka Streams. Trevlig läsning!
Biblioteket Apache används världen över i företag för distribuerad strömhantering ovanpå Apache Kafka. En av de mest underskattade aspekterna av detta ramverk är att det möjliggör lagring av lokalt tillstånd baserat på strömhantering.
I denna artikel kommer jag att berätta hur vi på vårt företag framgångsrikt har utnyttjat denna möjlighet vid utveckling av en produkt för säkerheten av molnapplikationer. Med hjälp av Kafka Streams skapade vi mikrotjänster med delat tillstånd, där var och en fungerar som en robust och hög tillgänglig källa till pålitlig information om objektens tillstånd i systemet. För oss är detta ett steg framåt både när det gäller tillförlitlighet och underhåll.
Om du är intresserad av ett alternativt tillvägagångssätt som möjliggör användningen av en enda central databas för att stödja det formella tillståndet för dina objekt – läs vidare, det kommer att vara intressant...
Varför vi ansåg att det var dags att förändra våra metoder för att arbeta med delat tillstånd
Vi behövde upprätthålla tillståndet för olika objekt baserat på agentrapporter (till exempel: utsattes webbplatsen för en attack?). Före övergången till Kafka Streams förlitade vi oss ofta på en enda central databas (+ tjänste-API) för att hantera tillstånd. Denna metod har sina nackdelar: i blir upprätthållande av konsekvens och synkronisering en verklig utmaning. Databasen kan bli en flaskhals, eller hamna i och drabbas av oförutsägbarhet.
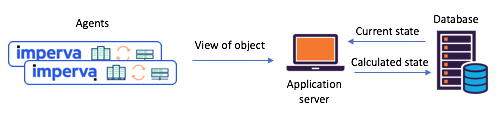
Illustration 1: ett typiskt scenario med delat tillstånd som uppstod före övergången till
Kafka och Kafka Streams: agenter rapporterar sina uppfattningar via API, det uppdaterade tillståndet beräknas genom databasen.
Lär känna Kafka Streams – det har blivit enkelt att skapa mikrotjänster med delat tillstånd.
För ungefär ett år sedan beslutade vi oss för att noggrant se över våra arbetsflöden med delat tillstånd för att hantera vissa problem. Vi bestämde oss raskt för att prova Kafka Streams – det är allmänt känt hur skalbar, högt tillgänglig och fel-tolerant den är, samt vilket rikt strömmande funktionalitet den har (inklusive transformationer med tillståndssparande). Detta var precis vad vi behövde, för att inte nämna hur mogen och pålitlig meddelandesystemet är i Kafka.
Varje mikrotjänst med delat tillstånd som vi har skapat bygger på en instans av Kafka Streams med en ganska enkel topologi. Den bestod av 1) en källa 2) en processor med ett beständigt lagringsutrymme för nycklar och värden 3) en ström:
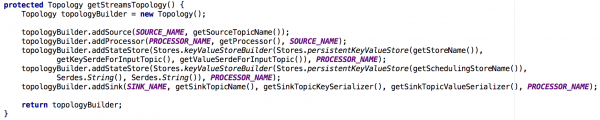
Illustration 2: den förinställda topologin för våra strömmande instanser av mikrotjänster med delat tillstånd. Observera att det också finns ett lager här där metadata om schemaläggningen lagras.
Med detta nya tillvägagångssätt skapar agenter meddelanden som skickas till den ursprungliga topiken, och konsumenter – låt oss säga en tjänst för e-postnotifikationer – tar emot det beräknade delade tillståndet via strömmen (utgångstopiken).
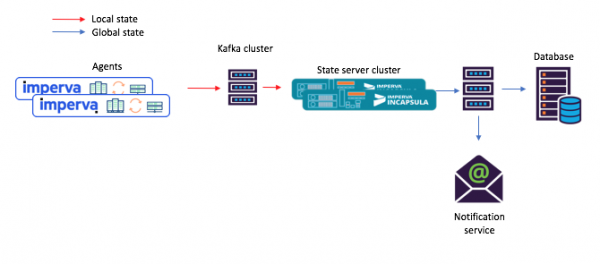
Illustration 3: ett nytt exempel på uppgiftström för scenariot med delade mikrotjänster: 1) agenten genererar ett meddelande som går till Kafka:s ursprungliga topik; 2) mikrotjänsten med delat tillstånd (som använder Kafka Streams) bearbetar det och skriver det beräknade tillståndet till Kafka:s slutliga topik; därefter 3) konsumenterna tar emot det nya tillståndet.
Hej, och detta inbyggda lagringsutrymme för nycklar och värden är verkligen mycket användbart!
Som nämnts tidigare innehåller vår topologi med delat tillstånd ett lagringsutrymme för nycklar och värden. Vi har hittat flera användningsområden för det, och två av dem beskrivs nedan.
Alternativ #1: användning av lagringsutrymmet för nycklar och värden vid beräkningar
Vårt första nyckel-värde-lager innehöll hjälpdata som vi behövde för våra beräkningar. Till exempel, i vissa fall definierades det delade tillståndet enligt principen 'majoritetens röster'. I lagret kunde vi hålla alla de senaste rapporterna från agenter om tillståndet för ett visst objekt. När vi sedan fick en ny rapport från en agent kunde vi spara den, hämta rapporterna från alla andra agenter om samma objekts tillstånd och upprepa beräkningen.
Nedan i illustration 4 visas hur vi öppnade tillgången till nyckel-värde-lagret för processorens bearbetande metod, så att ett nytt meddelande sedan kunde behandlas.
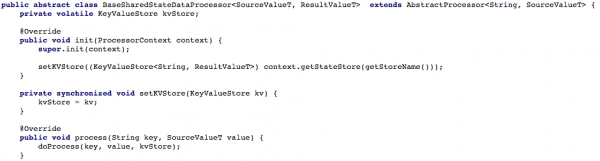
Illustration 4: öppna tillgång till nyckel-värde-lagret för processorens bearbetande metod (efter detta måste varje scenario som arbetar med delat tillstånd implementera metoden doProcess)
Alternativ #2: skapa ett CRUD API ovanpå Kafka Streams
Efter att ha ställt in vår grundläggande uppgiftström började vi försöka skriva ett RESTful CRUD API för våra mikrotjänster med delat tillstånd. Vi ville kunna hämta tillståndet för vissa eller alla objekt, samt ställa in eller ta bort tillståndet för ett objekt (detta är användbart vid stöd för backend).
För att stödja alla API:er för Hämta tillstånd, varje gång vi behövde beräkna tillståndet på nytt under bearbetningen, sparade vi det länge i det inbyggda nyckel-värde-lagret. I sådana fall blir det tillräckligt enkelt att implementera ett sådant API med hjälp av en enda instans av Kafka Streams, som visas i listan nedan:
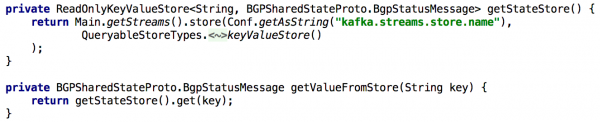
Illustration 5: användning av det inbyggda nyckel-värde-lagret för att hämta det förberäknade tillståndet för ett objekt
Att uppdatera tillståndet för ett objekt via API är också enkelt att implementera. I princip behöver man bara skapa en Kafka-producent och använda den för att göra en skrivning som innehåller det nya tillståndet. Detta garanterar att alla meddelanden som genereras via API kommer att behandlas på samma sätt som de som kommer från andra producenter (t.ex. agenter).
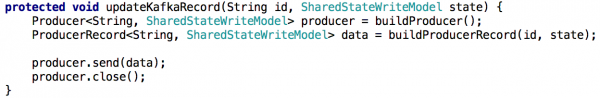
Illustration 6: tillståndet för ett objekt kan anges med en Kafka-producent
En liten komplikation: Kafka har många partitioner
Vi ville därefter fördela den bearbetningsrelaterade belastningen och förbättra tillgängligheten genom att tillhandahålla en kluster av mikrotjänster med delat tillstånd för varje scenari. Inställningen var enkel för oss: efter att vi konfigurerat alla instanser så att de arbetade med samma app-ID (och med samma initiala servrar), gjordes praktiskt taget allt annat automatiskt. Vi bestämde också att varje ursprunglig topic skulle bestå av flera partitioner så att varje instans kunde tilldelas en delmängd av dessa partitioner.
Jag nämner också att det är vanligt här att göra en backup av tillståndslagring, så att denna kopia till exempel kan flyttas till en annan instans vid återställning efter ett fel. För varje tillståndslagring i Kafka Streams skapas en replikerad topic med en förändringslogg (som spårar lokala uppdateringar). På så sätt säkerställer Kafka kontinuerligt tillståndslagringen. Så i händelse av att en viss instans av Kafka Streams misslyckas kan tillståndslagringen snabbt återställas på en annan instans, dit de relevanta partitionerna flyttas. Våra tester visade att detta görs på några sekunder även om lagringen innehåller miljontals poster.
Övergången från en mikrotjänst med delat tillstånd till ett kluster av mikrotjänster gör det inte så triviellt att implementera Get State API. I den nya situationen innehåller tillståndslagringen för varje mikrotjänst endast en del av den övergripande bilden (de objekt vars nycklar avbildades på en specifik partition). Vi var tvungna att avgöra vilken instans som innehöll tillståndet för det objekt vi behövde, och vi gjorde detta baserat på metadata från flöden, som visas nedan:
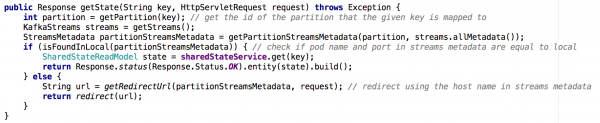
Illustration 7: med hjälp av metadata från flöden bestämmer vi från vilken instans vi ska begära tillståndet för det erforderliga objektet; en liknande ansats användes med GET ALL API
Huvudsakliga slutsatser
Tillståndslagringar i Kafka Streams kan de facto fungera som en distribuerad databas,
- som ständigt replikerats i Kafka
- Ovanpå ett sådant system är det enkelt att bygga ett CRUD API
- Bearbetning av flera partitioner blir lite mer komplicerat
- Det är också möjligt att lägga till en eller flera tillståndslager i strömningstopologin för att lagra hjälpdata. Denna variant kan användas för:
- Långsiktig lagring av data som behövs för beräkningar under strömbehandling
- Långsiktig lagring av data som kan vara användbara vid nästa initiering av en strömmande instans
- mycket annat…
Tack vare dessa och andra fördelar passar Kafka Streams utmärkt för att stödja globalt tillstånd i ett distribuerat system som vårt. Kafka Streams har visat sig vara mycket pålitlig i produktionen (sedan den implementerades har vi praktiskt taget inte tappat några meddelanden), och vi är övertygade om att dess möjligheter inte är begränsade till detta!
Källa: habr.com
