

LINQ introducerades i .NET som ett nytt kraftfullt språk för datamanipulering. LINQ to SQL som en del av det gör det ganska enkelt att kommunicera med databaser via till exempel Entity Framework. Men, när utvecklare använder det ofta, glömmer de att fundera på vilken SQL-fråga som kommer att genereras av queryable provider, i ditt fall – Entity Framework.
Vi kommer att gå igenom två huvudpunkter med ett exempel.
För detta ändamål skapar vi en databas i SQL Server som heter Test, och i den skapar vi två tabeller med följande fråga:
Skapande av tabeller
USE [TEST]
GO

SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

CREATE TABLE [dbo].[Ref](
	[ID] [int] NOT NULL,
	[ID2] [int] NOT NULL,
	[Name] [nvarchar](255) NOT NULL,
	[InsertUTCDate] [datetime] NOT NULL,
 CONSTRAINT [PK_Ref] PRIMARY KEY CLUSTERED
(
	[ID] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON) ON [PRIMARY]
) ON [PRIMARY]
GO

ALTER TABLE [dbo].[Ref] ADD  CONSTRAINT [DF_Ref_InsertUTCDate]  DEFAULT (getutcdate()) FOR [InsertUTCDate]
GO

USE [TEST]
GO

SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

CREATE TABLE [dbo].[Customer](
	[ID] [int] NOT NULL,
	[Name] [nvarchar](255) NOT NULL,
	[Ref_ID] [int] NOT NULL,
	[InsertUTCDate] [datetime] NOT NULL,
	[Ref_ID2] [int] NOT NULL,
 CONSTRAINT [PK_Customer] PRIMARY KEY CLUSTERED
(
	[ID] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON) ON [PRIMARY]
) ON [PRIMARY]
GO

ALTER TABLE [dbo].[Customer] ADD  CONSTRAINT [DF_Customer_Ref_ID]  DEFAULT ((0)) FOR [Ref_ID]
GO

ALTER TABLE [dbo].[Customer] ADD  CONSTRAINT [DF_Customer_InsertUTCDate]  DEFAULT (getutcdate()) FOR [InsertUTCDate]
GO
Nu fyller vi tabellen Ref genom att köra följande skript:
Fyllning av tabellen Ref
USE [TEST]
GO

DECLARE @ind INT=1;

WHILE(@ind<1200000)
BEGIN
	INSERT INTO [dbo].[Ref]
           ([ID]
           ,[ID2]
           ,[Name])
    SELECT
           @ind
           ,@ind
           ,CAST(@ind AS NVARCHAR(255));

	SET @ind=@ind+1;
END
GO
På liknande sätt fyller vi tabellen Customer med hjälp av följande skript:
Fyllning av tabellen Customer
USE [TEST]
GO

DECLARE @ind INT=1;
DECLARE @ind_ref INT=1;

WHILE(@ind<=12000000)
BEGIN
	IF(@ind%3=0) SET @ind_ref=1;
	ELSE IF (@ind%5=0) SET @ind_ref=2;
	ELSE IF (@ind%7=0) SET @ind_ref=3;
	ELSE IF (@ind=0) SET @ind_ref=4;
	ELSE IF (@ind=0) SET @ind_ref=5;
	ELSE IF (@ind=0) SET @ind_ref=6;
	ELSE IF (@ind=0) SET @ind_ref=7;
	ELSE IF (@ind=0) SET @ind_ref=8;
	ELSE IF (@ind=0) SET @ind_ref=9;
	ELSE IF (@ind=0) SET @ind_ref=10;
	ELSE IF (@ind=0) SET @ind_ref=11;
	ELSE SET @ind_ref=@ind90000;

	INSERT INTO [dbo].[Customer]
	 ([ID]
	 ,[Name]
	 ,[Ref_ID]
	 ,[Ref_ID2])
	 SELECT
	 @ind,
	 CAST(@ind AS NVARCHAR(255)),
	 @ind_ref,
	 @ind_ref;


	SET @ind=@ind+1;
END
GO
Således har vi fått två tabeller, där den ena innehåller mer än 1 miljon rader data och den andra mer än 10 miljoner rader data.
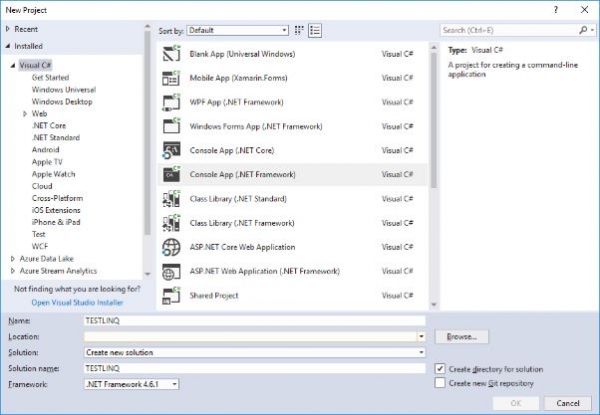
Nu i Visual Studio måste du skapa ett testprojekt Visual C# Console App (.NET Framework):
Sedan måste du lägga till ett bibliotek för Entity Framework för att interagera med databasen.
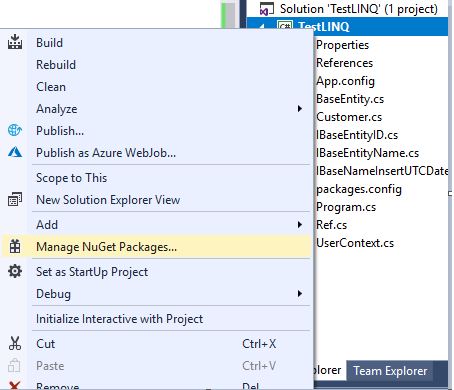
För att lägga till den, högerklicka på projektet och välj "Hantera NuGet-paket" från kontextmenyn:
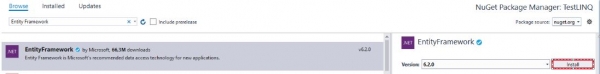
I det följande fönstret för NuGet-pakethanterare skriver vi "Entity Framework" i sökfältet, väljer paketet Entity Framework och installerar det:
Sedan i filen App.config efter slutet av elementet configSections måste vi lägga till följande block:
I connectionString måste vi ange anslutningssträngen.
Nu skapar vi tre gränssnitt i separata filer:
- Implementering av gränssnittet IBaseEntityID
namespace TestLINQ { public interface IBaseEntityID { int ID { get; set; } } } - Implementering av gränssnittet IBaseEntityName
namespace TestLINQ { public interface IBaseEntityName { string Name { get; set; } } } - Implementering av gränssnittet IBaseNameInsertUTCDate
namespace TestLINQ
{
    public interface IBaseNameInsertUTCDate
    {
        DateTime InsertUTCDate { get; set; }
    }
}
Och i en separat fil skapar vi basklass BaseEntity för våra två entiteter, som kommer att innehålla gemensamma fält:
Implementering av basklass BaseEntity
namespace TestLINQ
{
    public class BaseEntity : IBaseEntityID, IBaseEntityName, IBaseNameInsertUTCDate
    {
        public int ID { get; set; }
        public string Name { get; set; }
        public DateTime InsertUTCDate { get; set; }
    }
}
Sedan i separata filer skapar vi våra två entiteter:
- Implementering av klassen Ref
using System.ComponentModel.DataAnnotations.Schema; namespace TestLINQ { [Table("Ref")] public class Ref : BaseEntity { public int ID2 { get; set; } } } - Implementering av klassen Customer
using System.ComponentModel.DataAnnotations.Schema;

namespace TestLINQ
{
    [Table("Customer")]
    public class Customer: BaseEntity
    {
        public int Ref_ID { get; set; }
        public int Ref_ID2 { get; set; }
    }
}
Nu skapar vi kontexten UserContext i en separat fil:
Implementering av klassen UserContext
using System.Data.Entity;

namespace TestLINQ
{
    public class UserContext : DbContext
    {
        public UserContext()
            : base("DbConnection")
        {
            Database.SetInitializer(null);
        }

        public DbSet Customer { get; set; }
        public DbSet Ref { get; set; }
    }
}
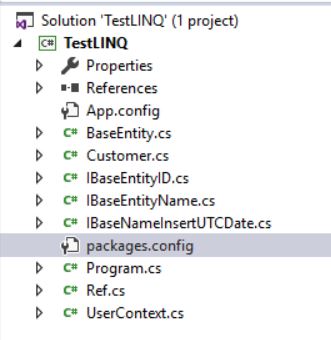
Vi har fått en färdig lösning för att genomföra tester för optimering med LINQ to SQL via EF för MS SQL Server:
Nu skriver vi följande kod i filen Program.cs:
Fil Program.cs
using System;
using System.Collections.Generic;
using System.Linq;

namespace TestLINQ
{
    class Program
    {
        static void Main(string[] args)
        {
            using (UserContext db = new UserContext())
            {
                var dblog = new List();
                db.Database.Log = dblog.Add;

                var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                 && (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };

                var result = query.Take(1000).ToList();

                Console.WriteLine(dblog[1]);

                Console.ReadKey();
            }
        }
    }
}
Låt oss nu köra vårt projekt.
I slutet av körningen kommer följande att skrivas ut i konsolen:
Genererad SQL-fråga
SELECT TOP (1000)
    [Extent1].[Ref_ID] AS [Ref_ID],
    [Extent1].[Name] AS [Name],
    [Extent2].[Name] AS [Name1]
    FROM  [dbo].[Customer] AS [Extent1]
    INNER JOIN [dbo].[Ref] AS [Extent2] ON ([Extent1].[Ref_ID] = [Extent2].[ID]) AND ([Extent1].[Ref_ID2] = [Extent2].[ID2])
Det vill säga, genererade SQL-frågan från LINQ är i allmänhet ganska bra för MS SQL Server.
Nu ska vi ändra villkoret från OCH till ELLER i LINQ-frågan:
LINQ-frågan
var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                || (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };
Och vi kör vårt program igen.
Exekveringen kommer att krascha med ett fel relaterat till överskridande av körningstiden för kommandot på 30 sekunder:
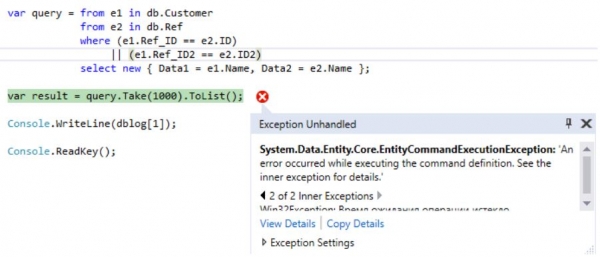
Om vi ser vilken fråga som genererades av LINQ:
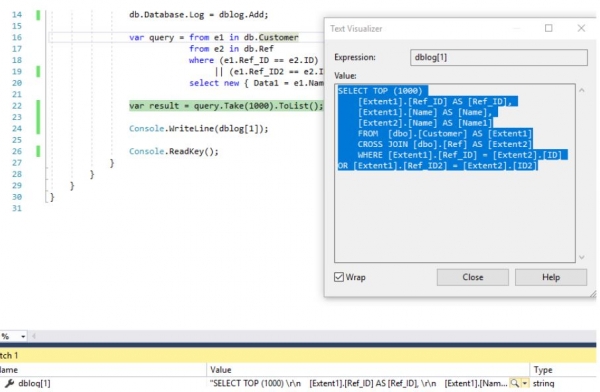
, kan vi konstatera att urvalet görs genom kartesiskt produkt av två mängder (tabeller):
Genererad SQL-fråga
SELECT TOP (1000)
    [Extent1].[Ref_ID] AS [Ref_ID],
    [Extent1].[Name] AS [Name],
    [Extent2].[Name] AS [Name1]
    FROM  [dbo].[Customer] AS [Extent1]
    CROSS JOIN [dbo].[Ref] AS [Extent2]
    WHERE [Extent1].[Ref_ID] = [Extent2].[ID] OR [Extent1].[Ref_ID2] = [Extent2].[ID2]
Låt oss skriva om LINQ-frågan på följande sätt:
Optimerad LINQ-fråga
var query = (from e1 in db.Customer
                   join e2 in db.Ref
                   on e1.Ref_ID equals e2.ID
                   select new { Data1 = e1.Name, Data2 = e2.Name }).Union(
                        from e1 in db.Customer
                        join e2 in db.Ref
                        on e1.Ref_ID2 equals e2.ID2
                        select new { Data1 = e1.Name, Data2 = e2.Name });
Då får vi följande SQL-fråga:
SQL-fråga
SELECT
    [Limit1].[C1] AS [C1],
    [Limit1].[C2] AS [C2],
    [Limit1].[C3] AS [C3]
    FROM ( SELECT DISTINCT TOP (1000)
        [UnionAll1].[C1] AS [C1],
        [UnionAll1].[Name] AS [C2],
        [UnionAll1].[Name1] AS [C3]
        FROM  (SELECT
            1 AS [C1],
            [Extent1].[Name] AS [Name],
            [Extent2].[Name] AS [Name1]
            FROM  [dbo].[Customer] AS [Extent1]
            INNER JOIN [dbo].[Ref] AS [Extent2] ON [Extent1].[Ref_ID] = [Extent2].[ID]
        UNION ALL
            SELECT
            1 AS [C1],
            [Extent3].[Name] AS [Name],
            [Extent4].[Name] AS [Name1]
            FROM  [dbo].[Customer] AS [Extent3]
            INNER JOIN [dbo].[Ref] AS [Extent4] ON [Extent3].[Ref_ID2] = [Extent4].[ID2]) AS [UnionAll1]
    )  AS [Limit1]
Tyvärr kan det i LINQ-frågor bara finnas en anslutningsvillkor, så här kan en ekvivalent fråga göras genom två frågor för varje villkor, och sedan förenas de med Union för att ta bort dubbletter bland rader.
Ja, frågorna blir i allmänhet inte ekvivalenta med hänsyn till att fullständiga dubbletter av rader kan returneras. Men i verkliga livet behövs inte fullständiga dublicerade rader och man försöker bli av med dem.
Låt oss nu jämföra exekveringsplanerna för dessa två frågor:
- för CROSS JOIN är den genomsnittliga exekveringstiden 195 sek:

- för INNER JOIN-UNION är den genomsnittliga exekveringstiden mindre än 24 sek:

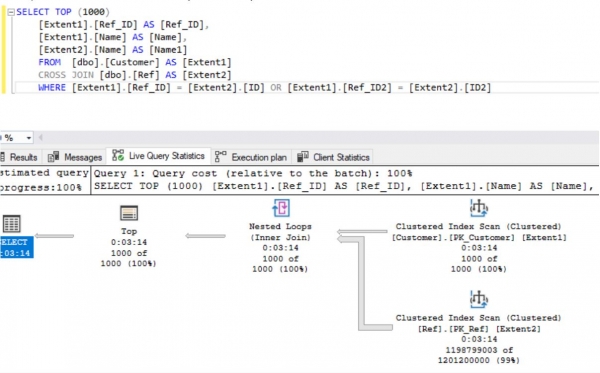
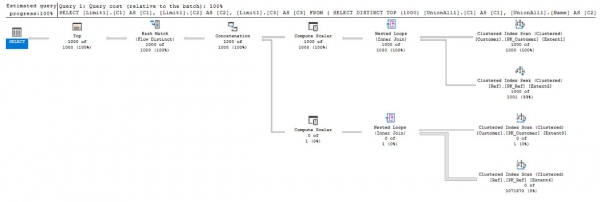
Som vi kan se från resultaten, så fungerar den optimerade LINQ-frågan för två tabeller med miljoner poster ett flertal gånger snabbare än den icke optimerade.
För alternativet med OCH i villkoren för LINQ-frågan av typen:
LINQ-frågan
var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                 && (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };
kommer nästan alltid att en korrekt SQL-fråga att genereras, vilket i genomsnitt kommer att köras på ungefär 1 sek:
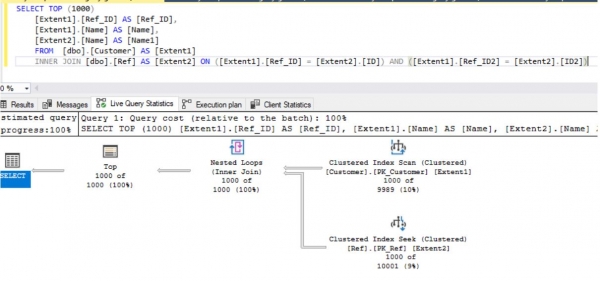
Även för manipulationer av LINQ till objekt istället för en fråga av typen:
LINQ-fråga (första alternativet)
var query = from e1 in seq1
                            from e2 in seq2
                            where (e1.Key1==e2.Key1)
                               && (e1.Key2==e2.Key2)
                            select new { Data1 = e1.Data, Data2 = e2.Data };
kan en fråga av typen användas:
LINQ-fråga (andra alternativet)
var query = from e1 in seq1
                            join e2 in seq2
                            on new { e1.Key1, e1.Key2 } equals new { e2.Key1, e2.Key2 }
                            select new { Data1 = e1.Data, Data2 = e2.Data };
där:
Definition av två arrayer
Para[] seq1 = new[] { new Para { Key1 = 1, Key2 = 2, Data = "777" }, new Para { Key1 = 2, Key2 = 3, Data = "888" }, new Para { Key1 = 3, Key2 = 4, Data = "999" } };
Para[] seq2 = new[] { new Para { Key1 = 1, Key2 = 2, Data = "777" }, new Para { Key1 = 2, Key2 = 3, Data = "888" }, new Para { Key1 = 3, Key2 = 5, Data = "999" } };
, och typen Para definieras som följer:
Definition av typen Para
class Para
{
        public int Key1, Key2;
        public string Data;
}
Således har vi behandlat några aspekter av optimeringen av LINQ-frågor mot MS SQL Server.
Tyvärr glömmer till och med erfarna och ledande .NET-utvecklare att de måste förstå vad som händer bakom kulisserna av de instruktioner de använder. Annars blir de endast konfiguratörer och kan lägga en tidsinställd bomb för framtiden både vid skalning av programlösningen och vid mindre förändringar i miljöns externa förhållanden.
En liten översikt gjordes också .
Källkoden för testet — själva projektet, skapandet av tabeller i databasen TEST, samt ifyllandet av dessa tabeller finns .
I detta arkiv finns även en mapp som heter Plans där planerna för att utföra förfrågningar med OCH-villkor finns.
Källa: habr.com
