

Vid övergången från en monolitisk applikation till en mikrotjänstarkitektur stöter vi på nya problem.
I en monolitisk applikation är det vanligtvis tillräckligt att helt enkelt fastställa var felet inträffade i systemet. Troligen ligger problemet i monolitens kod eller i databasen. Men när vi börjar söka efter problemet i mikrotjänstarkitekturen är det inte längre så uppenbart. Vi måste hitta hela vägen som en begäran har tagit från början till slut och särskilja den från hundratals mikrotjänster. Många av dem har dessutom egna datalagringslösningar där det också kan uppstå både logiska fel och problem med prestanda och tillförlitlighet.
Jag har länge letat efter ett verktyg som skulle hjälpa till att hantera sådana problem (jag skrev om detta på Habré: , ), men i slutändan gjorde jag en egen öppen källkods-lösning. I artikeln berättar jag om fördelarna med service mesh-ansatsen och delar med mig av ett nytt verktyg för dess implementering.
Distribuerad spårning är en vanlig lösning på problemet med att hitta fel i distribuerade system. Men vad händer om ett sådant tillvägagångssätt för att samla in information om nätverksinteraktioner ännu inte har implementerats i systemet, eller, ännu värre, om det fungerar bra i en del av systemet men inte i en annan, eftersom det inte har lagts till i de äldre tjänsterna? För att bestämma den exakta grundorsaken till problemet måste vi ha en fullständig bild av vad som händer i systemet. Det är särskilt viktigt att förstå vilka mikrotjänster som är involverade i de mest kritiska affärsvägarna.
Här kan service mesh-ansatsen hjälpa oss, som tar hand om hela maskineriet för att samla in nätverksinformation på en nivå under där själva tjänsterna arbetar. Denna ansats gör att vi kan avlyssna all trafik och analysera den i realtid. Dessutom behöver själva applikationerna inte ens veta något om det.
Service mesh-ansatsen
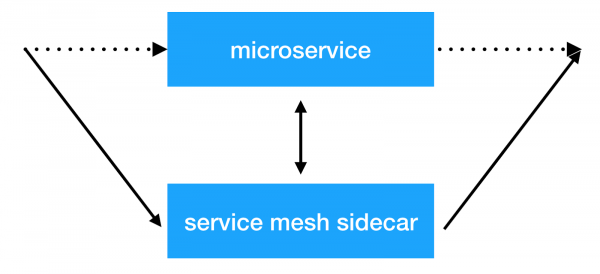
Huvudidén med service mesh-ansatsen är att lägga till ännu ett infrastrukturlager ovanför nätverket, vilket gör att vi kan hantera interaktionen mellan mikrotjänster. De flesta implementationer fungerar på följande sätt: varje mikrotjänst får en extra sidecar-container med en transparent proxy, genom vilken all inkommande och utgående trafik från tjänsten passerar. Och det är just här vi kan utföra klientsidebalansering, tillämpa säkerhetspolicyer, införa begränsningar på antalet förfrågningar och samla in viktig information om hur tjänster interagerar i produktion.
Lösningar
Det finns redan flera implementationer av detta tillvägagångssätt: och . De erbjuder många funktioner direkt ur boxen. Men samtidigt kommer det med en stor overhead av resurser. Ju större klustret där ett sådant system körs, desto mer resurser krävs för att upprätthålla den nya infrastrukturen. På Avito använder vi Kubernetes-kluster där tusentals tjänsteexemplar finns (och antalet fortsätter att växa snabbt). I den nuvarande implementationen använder Istio cirka 300 Mb RAM per tjänsteexemplar. På grund av det stora antalet funktioner påverkar den transparenta balanseringen också den totala svarstiden för tjänsterna (upp till 10 ms).
Till slut tittade vi på vilka specifika funktioner vi behöver just nu och beslutade att en av de viktigaste anledningarna till att vi började implementera sådana lösningar var möjligheten att transparent samla in spårningsinformation från hela systemet. Vi ville också ha kontroll över tjänsternas interaktioner och kunna göra olika manipulationer med de rubriker som skickas mellan tjänster.
Som ett resultat kom vi fram till vår lösning: .
Netramesh
— en lättviktig service mesh-lösning med möjlighet till oändlig skalbarhet oavsett antal tjänster i systemet.
Målen med den nya lösningen var att ha låg resursöverhead och hög prestanda. Vi ville omedelbart ha möjligheten att transparent skicka spårningsspaningar till vårt Jaeger-system.
Idag implementeras de flesta molnlösningarna i Golang. Och det finns självklart skäl till detta. Att skriva nätverksapplikationer i Golang som arbetar asynkront med in- och utmatning och som kan skalas upp efter behov är både bekvämt och ganska enkelt. Dessutom är prestandan tillräcklig för att lösa denna uppgift. Därför valde vi också Golang.
Performance
Vi har fokuserat våra ansträngningar på att uppnå maximal prestanda. För en lösning som implementeras nära varje tjänsteinstans krävs en liten mängd minne och processortid. Självklart bör även svarstiden vara så kort som möjligt.
Låt oss se vilka resultat vi har fått.
RAM
Netramesh använder ~10Mb utan trafik och 50Mb maximalt under belastning upp till 10000 RPS på en instans.
Istio envoy proxy använder alltid ~300Mb i våra kluster med tusentals instanser. Detta förhindrar att det kan skalas över hela klustret.
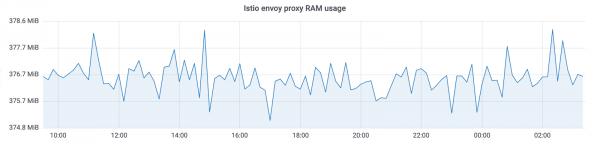
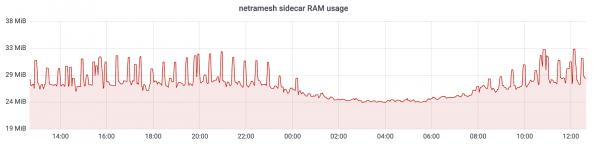
Med Netramesh har vi fått en minskning av minnesanvändningen på ~10 gånger.
CPU
CPU-användningen förblir relativt konstant under belastning. Den beror på antalet förfrågningar per tidsenhet till sidecar. Värden vid 3000 förfrågningar per sekund i topparna:
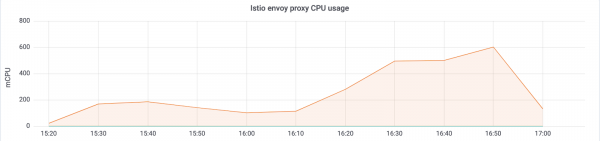
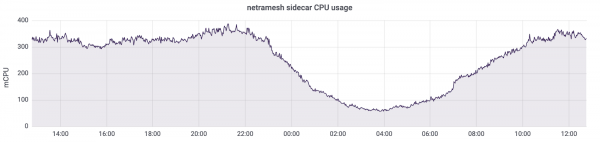
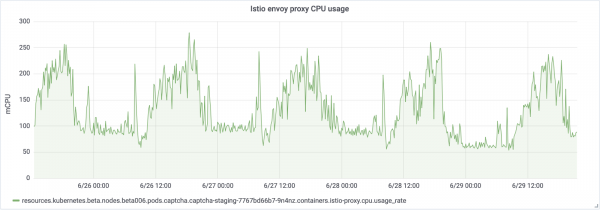
Det finns en annan viktig punkt: Netramesh är en lösning utan control plane och utan belastning använder den ingen processortid. Med Istio uppdaterar sidecars alltid tjänsternas endpoints. Resultatet är att vi kan se följande situation utan belastning:
Vi använder HTTP/1 för interaktion mellan tjänster. Ökningen av svarstiden hos Istio vid proxying genom envoy var upp till 5-10ms, vilket är ganska mycket för tjänster som är beredda att svara inom en millisekund. Med Netramesh minskade denna tid till 0,5-2ms.
Skalbarhet
Den lilla mängd resurser som varje proxy använder gör det möjligt att placera den nära varje tjänst. Netramesh skapades medvetet utan en control plane-komponent för att enkelt upprätthålla lättvikten av varje sidecar. Ofta i service mesh-lösningar sprider control plane service discovery-information till varje sidecar. Med den kommer också information om timeouter och balansinställningar. Allt detta gör det möjligt att utföra många användbara saker, men tyvärr ökar det storleken på sidecars.
Tjänstupptäckning

Netramesh lägger inte till några extra mekanismer för service discovery. All trafik proxyas transparent genom netra sidecar.
Netramesh stödjer HTTP/1 applikationsprotokollet. För att definiera det används en konfigurerbar lista över portar. Vanligtvis finns det flera portar i systemet som används för HTTP-interaktion. Till exempel använder vi 80, 8890, 8080 för interaktion mellan tjänster och externa förfrågningar. I så fall kan de anges med hjälp av en miljövariabel. NETRA_HTTP_PORTS.
Om du använder Kubernetes som orkestrator och dess Service-mekanismer för interna klusterinteraktioner mellan tjänster, förblir mekanismen densamma. Först får mikrotjänsten service IP-adressen via kube-dns och öppnar en ny anslutning till den. Denna anslutning etableras först med den lokala netra-sidecaren och alla TCP-paket kommer först till netra. Därefter etablerar netra-sidecaren anslutningen till den ursprungliga destinationen. NAT på pod IP på noden förblir densamma som utan netra.
Distribuerad spårning och vidarebefordran av kontext
Netramesh tillhandahåller funktionalitet som behövs för att skicka spårningsspann om HTTP-interaktion. Netra-sidecaren parsar HTTP-protokollet, mäter fördröjningar på förfrågningar och hämtar nödvändig information från HTTP-headers. I slutändan får vi alla spår i ett enhetligt Jaeger-system. För detaljerad konfiguration kan miljövariablerna som tillhandahålls av det officiella biblioteket också användas. .
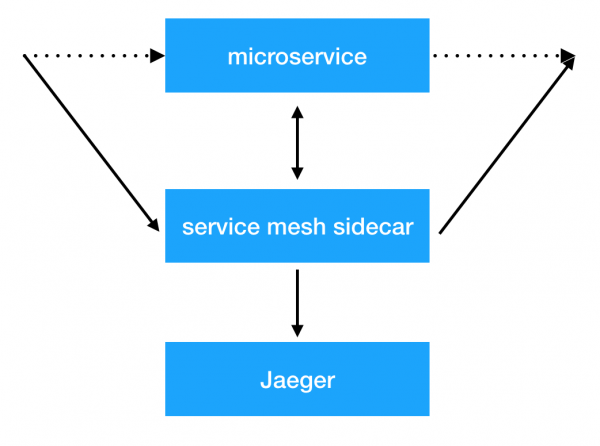
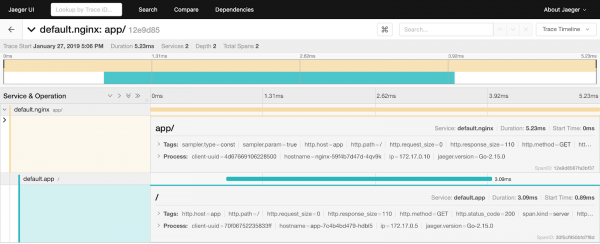
Men det finns ett problem. Så länge tjänsterna inte genererar och vidarebefordrar en särskild uber-header, kommer vi inte att se de sammanlänkade spårningsspann i systemet. Och det är vad vi behöver för att snabbt identifiera problemens orsaker. Här har Netramesh återigen en lösning. Proxy läser HTTP-headers och, om de inte innehåller uber trace id, genererar den. Netramesh lagrar också information om inkommande och utgående förfrågningar i sidecaren och matchar dem genom att berika dem med nödvändiga headers för utgående förfrågningar. Allt som behövs i tjänsterna är att vidarebefordra en enda header. X-Request-Id, som kan konfigureras med hjälp av en miljövariabel. NETRA_HTTP_REQUEST_ID_HEADER_NAME. För att hantera storleken på kontexten i Netramesh kan följande miljövariabler ställas in: NETRA_TRACING_CONTEXT_EXPIRATION_MILLISECONDS (tiden under vilken kontexten kommer att lagras) och NETRA_TRACING_CONTEXT_CLEANUP_INTERVAL (frekvensen för städning av kontext).
Det är också möjligt att kombinera flera vägar i ditt system genom att märka dem med en speciell sessionsmarkör. Netra tillåter att ställa in HTTP_HEADER_TAG_MAP för att omvandla HTTP-rubriker till motsvarande tracing span-taggar. Detta kan vara särskilt användbart för testning. Efter att ha genomfört ett funktionellt test kan du se vilken del av systemet som påverkades genom att filtrera med hjälp av den aktuella sessionsnyckeln.
Identifiering av förfrågningskälla
För att avgöra varifrån förfrågan kom kan funktionaliteten för automatisk tilläggning av rubrik med källa användas. Med hjälp av miljövariabeln NETRA_HTTP_X_SOURCE_HEADER_NAME kan du ange namnet på rubriken som automatiskt kommer att ställas in. Med NETRA_HTTP_X_SOURCE_VALUE kan du ställa in värdet som X-Source-rubriken ska ha för alla utgående förfrågningar.
Detta gör det möjligt att enhetligt sprida denna användbara rubrik över hela nätverket. Du kan sedan använda den i tjänster och lägga till den i loggar och metrik.
Ruttning av trafik och intern funktionalitet i Netramesh
Netramesh består av två huvudkomponenter. Den första, netra-init, ställer in nätverksregler för att fånga trafik. Den använder för att fånga all eller delar av trafiken till sidecar, som är den andra huvudkomponenten i Netramesh. Du kan konfigurera vilka portar som ska fångas för inkommande och utgående TCP-sessioner: INBOUND_INTERCEPT_PORTS, OUTBOUND_INTERCEPT_PORTS.
Verktyget har också en intressant funktion – sannolikhetsbaserad ruttning. Om du använder Netramesh enbart för att samla tracing spans kan du spara resurser i produktionsmiljön och aktivera sannolikhetsbaserad ruttning med hjälp av variablerna NETRA_INBOUND_PROBABILITY och NETRA_OUTBOUND_PROBABILITY (från 0 till 1). Standardvärdet är 1 (all trafik fångas).
Efter en lyckad fångst tar netra sidecar emot en ny anslutning och använder SO_ORIGINAL_DST socket-alternativet för att få den ursprungliga destinationspunkten. Sedan öppnar Netra en ny anslutning till den ursprungliga IP-adressen och upprättar en tvåvägs TCP-kommunikation mellan parterna, och lyssnar på all passerande trafik. Om porten är definierad som HTTP, försöker Netra att parsa den och spåra. Om HTTP-parsing inte är framgångsrik, faller Netra tillbaka på TCP och transparent proxyar byte.
Byggande av beroendegraf
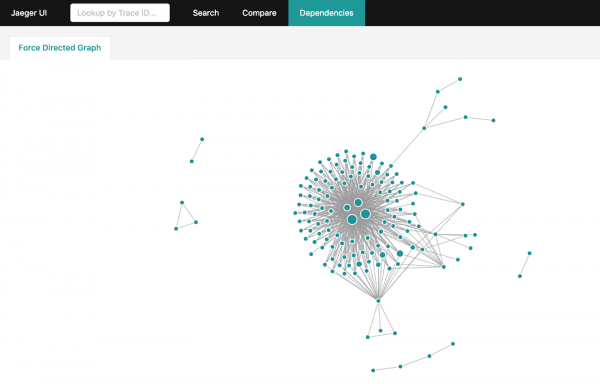
Efter att ha fått en stor mängd tracinginformation i Jaeger vill man gärna få en fullständig graf över interaktionerna i systemet. Men om ditt system är tillräckligt belastat och det samlas miljarder tracing spans under en dag, blir det inte så enkelt att aggreggera dem. Det finns ett officiellt sätt att göra detta: . Det kommer dock att ta timmar att bygga en fullständig graf och tvinga dig att ladda ner hela datasetet från Jaeger för de senaste 24 timmarna.
Om du använder Elasticsearch för att lagra tracing spans kan du använda en , som bygger en liknande graf på några minuter, genom att använda funktionerna och möjligheterna i Elasticsearch.
Hur man använder Netramesh
Netra kan enkelt läggas till i vilken tjänst som helst som körs under någon orkestratör. Du kan se ett exempel .
För tillfället har Netra ingen möjlighet till automatisk implementering av sidecar i tjänster, men det finns planer på att genomföra detta.
Framtiden för Netramesh
Huvudmålet är att uppnå minimala resurskostnader och hög prestanda, samtidigt som man erbjuder grundläggande funktioner för observabilitet och kontroll över mellanserviceinteraktioner.
I framtiden kommer Netramesh att få stöd för andra applikationsprotokoll utöver HTTP. Snart kommer möjligheten för L7-routing att finnas.
Använd Netramesh om du stöter på liknande problem, och skicka oss dina frågor och förslag.
Källa: habr.com
