

Hur man uppdaterar nätverksutrustningen på ett stort företag utan att stoppa produktionen? Om ett storskaligt projekt i "öppen hjärtoperation" berättar projektledaren för Linxdatacenter, Oleg Fedorov.
Under de senaste åren har vi märkt en ökad efterfrågan från kunderna på tjänster relaterade till nätverkskomponenten i IT-infrastrukturen. Behovet av att koppla samman IT-system, tjänster, applikationer och att övervaka samt operativt hantera affärsverksamhet nästan i alla sektorer tvingar idag företag att ge nätverken ökad uppmärksamhet.
Omfattningen av förfrågningar sträcker sig från att säkerställa nätverksmotståndskraft till att skapa och hantera kundens autonoma system genom att anskaffa en enhet, IP-adresserkonfigurera routningsprotokoll och hantera trafiken enligt organisationernas policyer.
Efterfrågan på omfattande lösningar för att bygga och underhålla nätverksinfrastruktur ökar också, framför allt från kunder vars nätverksinfrastruktur byggs från grunden eller som har blivit omoralisk och kräver seriös modifiering.
Denna trend sammanföll tidsmässigt med utvecklingen och komplexiteten i Linxdatacenters egen nätverksinfrastruktur. Vi har utökat vårt geografiska närvaro i Europa genom att koppla upp oss till avlägsna platser, vilket i sin tur krävde att nätverksinfrastrukturen förbättrades.
Företaget har lanserat en ny tjänst för kunder, Network-as-a-Service: lösningen för alla kunders nätverksbehov tar vi på oss så att de kan fokusera på sin kärnverksamhet.
Sommaren 2020 avslutades det första stora projektet inom detta område, som vi gärna vill berätta om.
I början
Ett stort industrikomplex vände sig till oss för att modernisera nätverksdelen av infrastrukturen på ett av sina företag. Det krävdes att gammal utrustning skulle bytas ut mot ny, inklusive nätverkskärnan.
Den senaste uppgraderingen av utrustningen på företaget gjordes för cirka 10 år sedan. Det nya ledarskapet på företaget beslöt att förbättra kopplingen genom att börja med att uppdatera infrastrukturen på den mest grundläggande, fysiska nivån.
Projektet delades in i två delar: uppgradering av serverparken och nätverksutrustningen. Vi ansvarade för den andra delen.
De grundläggande kraven för arbetet innefattade att minimera stilleståndet för företagets produktionslinjer under arbetets gång (och i vissa områden helt utesluta stillestånd). Varje stopp innebär direkta ekonomiska förluster för kunden, vilket inte fick ske under några omständigheter. Med tanke på anläggningens drift 24x7x365 och den totala avsaknaden av planerad stilleståndstid i företagets praxis, ställdes vi inför uppgiften att i princip utföra en operation på ett öppet hjärta. Detta blev projektets huvudsakliga kännetecken.
Låt oss göra det
Arbetet planerades enligt principen att röra sig från noder i nätverket som ligger långt från kärnan till de som ligger närmare, samt från noder som påverkar produktionen mindre till de som påverkar den direkt.
Till exempel, om vi tar en nod i nätverket inom försäljningsavdelningen, så kommer en kommunikationsstörning till följd av arbetet där inte att påverka produktionen. Samtidigt kommer en sådan incident att hjälpa oss som entreprenör att verifiera korrektheten av den valda arbetsmetoden för dessa noder och, efter att ha justerat åtgärderna, arbeta vidare på de följande stegen av projektet.
Det är nödvändigt att inte bara byta noder och kablar i nätverket, utan också korrekt konfigurera alla komponenter för att garantera att lösningen fungerar korrekt. Just konfigurationerna kontrollerades på detta sätt: genom att börja arbetet i avlägsna områden från kärnan, gav vi oss själva en "rätt till misstag", utan att utsätta kritiskt viktiga delar av företagets verksamhet för risk.
Vi identifierade områden som inte påverkar produktionsprocessen samt kritiska områden – verkstäder, last- och lossningsblock, lager etc. För nyckelområdena godkände vi tillsammans med kunden den tillåtna stilleståndstiden för varje nod i nätverket individuellt: från 1 till 15 minuter. Det var omöjligt att helt undvika att stänga av vissa noder i nätverket, eftersom kabeln måste fysiskt kopplas om från gammal utrustning till ny, och under omkopplingen måste vi också reda ut "buntarna" av kablar som bildats under flera års drift utan ordentligt underhåll (ett av följderna av outsourcing av kabelinstallationer).
Arbetet delades upp i flera steg.
Steg 1 – Revision. Förberedelse och överenskommelse om tillvägagångssätt för arbetsplanering och bedömning av beredskapen hos teamen: kunden, entreprenören som utför installationen, och vårt team.
Steg 2 – Utveckling av formatet för genomförande av arbeten, med djupgående analys och planering. Vi valde ett format med en checklista med exakt angivning av ordning och sekvens av åtgärder, ända ner till sekvensen för att byta patchkablar mellan portarna.
Steg 3 – Utförande av arbeten i skåp som inte påverkar produktionen. Bedömning och justering av stilleståndstiden för de följande arbetsstegen.
Steg 4 – Utförande av arbeten i skåp som direkt påverkar produktionen. Bedömning och justering av stilleståndstiden för det sista arbetssteget.
Steg 5 – Utförande av arbeten i serverrummet för att koppla om det återstående utrustningen. Start av routing på den nya kärnan.
Steg 6 – Successiv omkoppling av systemets kärna från gamla nätverkskonfigurationer till nya för en smidig övergång av hela systemkomplexet (VLAN, routing osv.). Vid detta steg kopplade vi in alla användare och överförde alla tjänster till den nya utrustningen, kontrollerade korrektheten i anslutningen, försäkrade oss om att inga företags tjänster stannade, och garanterade att eventuella problem var direkt kopplade till kärnan, vilket underlättade felsökning och slutgiltig justering.
Kabelslingor
Projektet visade sig vara svårt också på grund av de komplicerade ursprungliga förhållandena.
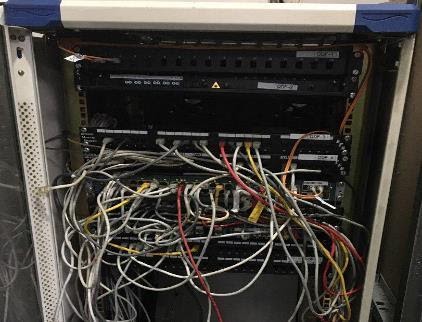
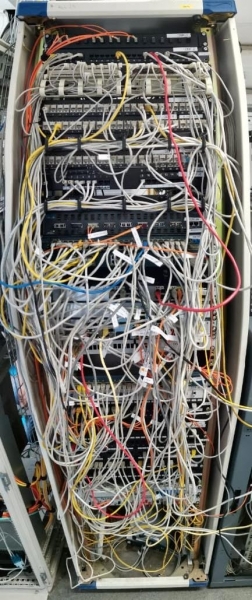
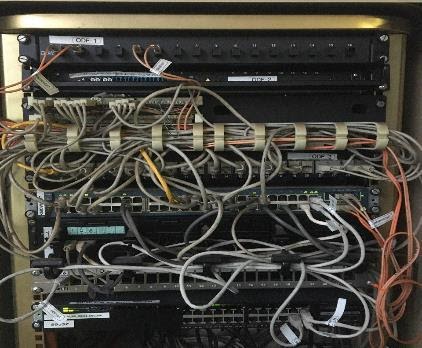
För det första, det enorma antalet noder och nätverksdelar, med en förvirrad topologi och klassificering av kablar efter deras ändamål. Sådana "kabelslingor" behövde plockas ut ur skåpen och noggrant "kamma" igenom, för att ta reda på vilken kabel som kom därifrån och gick vart.
Det såg ungefär ut så här:
så här:
eller så här:
För det andra var det nödvändigt att för varje sådan uppgift förbereda en fil med en processbeskrivning. "Ta kabel X från port 1 på den gamla utrustningen och plugga in den i port 18 på den nya utrustningen." Det låter enkelt, men när du har 48 helt upptagna portar i dina ingångsdata, och ingen möjlighet till stillestånd (vi minns 24x7x365), är den enda utvägen att arbeta i block. Ju fler kablar du kan ta bort från den gamla utrustningen på en gång, desto snabbare kan du sortera dem och koppla in dem i den nya nätverksutrustningen, utan att orsaka störningar eller stillestånd i nätverksarbetet.
Därför genomförde vi under förberedelsestadiet en uppdelning av nätverket i block – varje block hörde till en viss VLAN. Varje port (eller dess delmängd) på den gamla utrustningen är en av VLAN:erna i den nya nätverks-topologin. Vi grupperade dem så här: de första portarna på switchen fick användarnätverk, i mitten – produktionsnätverk, och i de sista – accesspunkter och uplinks.
Denna metod gjorde det möjligt att ta bort och sortera inte bara 1 kabel från den gamla utrustningen åt gången, utan 10-15. Detta accelererade arbetsprocessen flera gånger.
Förresten, så här ser kablarna ut i skåpen efter sortering:
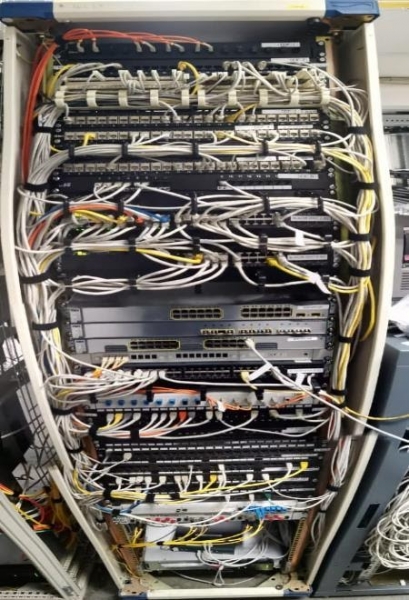
eller, till exempel, så här:
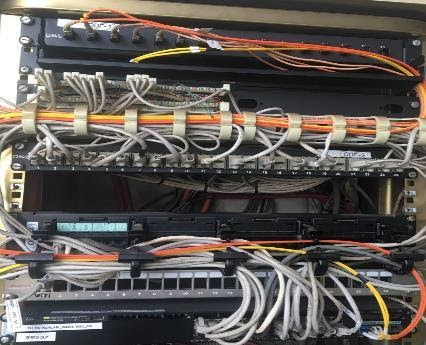
Efter att andra etappen var avslutad tog vi en paus för att analysera fel och projektets dynamik. Till exempel uppstod små brister omedelbart på grund av felaktigheter i de nätverksscheman vi fick (fel connector på schemat – fel inköpt patch-kabel och behovet av att byta ut den).
Pausen var nödvändig eftersom ett litet fel i processen var oacceptabelt vid arbete med servrar. Om målet är att säkerställa stilleståndstiden i nätverksavsnittet till högst 5 minuter, fick den inte överskridas. Eventuella avvikelser från schemat skulle behöva godkännas av kunden.
Men noggrant förberedande planering och uppdelning av projektet i block gjorde det möjligt att hålla sig inom den planerade stilleståndstiden i alla avsnitt, och i de flesta fall helt undvika det.
Utmaningen av tiden – projektet under COVID-19
Utan ytterligare komplikationer var det emellertid inte. Självklart utgjorde coronavirus ett av hindren.
Arbetet försvårades av att pandemin bröt ut, vilket gjorde det omöjligt för alla specialister involverade i processen att vara närvarande på platsen. Endast personal från installationsföretaget tilläts på plats, och kontrollen genomfördes via ett rum i Zoom – där befann sig nätverksingenjören från Linxdatacenter, jag som projektledare, nätverksingenjören från klienten som var ansvarig för arbetets genomförande, samt teamet som utförde installationsarbetet.
Under arbetets gång uppstod oförutsedda problem och det var nödvändigt att göra justeringar i realtid. På så sätt kunde vi snabbt förhindra påverkan av mänskliga faktorer (fel i schemat, misstag i identifieringen av gränssnittets aktivitetsstatus, etc.).
Även om den distansbaserade arbetsformatet kändes ovant i början av projektet, anpassade vi oss ganska snabbt till de nya förhållandena och nådde den sista etappen av arbetet.
Vi satte upp en tillfällig konfiguration av nätverksinställningarna för parallell drift av två nätverkskärnor – den gamla och den nya – för att möjliggöra en smidig övergång. Men det visade sig att en överflödig rad i konfigurationsfilen för den nya kärnan inte hade tagits bort, vilket innebar att övergången inte genomfördes. Detta tvingade oss att lägga tid på att identifiera problemet.
Det visade sig att huvudsaklig trafik överfördes korrekt, medan styrtrafiken inte nådde noden genom den nya kärnan. Tack vare den tydliga uppdelningen av projektet i etapper lyckades vi ganska snabbt identifiera det nätverkssegment där problem uppstod, upptäcka problemet och åtgärda det.
Och som ett resultat
Tekniska slutsatser av projektet
Först och främst skapades en ny kärna för företagets nya nätverk, för vilket vi byggde fysiska/logiska ringar. Detta gjordes så att varje switch i nätverket fick en "andra axel". I det gamla nätverket kopplades många switchar till kärnan via en ledning, med ett axel (uplink). Om det brast blev switchen helt otillgänglig. Och om flera switchar var anslutna via en uplink så innebar en störning att hela avdelningen eller produktionslinjen på företaget gick ned.
I det nya nätverket kan inte ens en mycket allvarlig nätverksincident, oavsett scenario, "fälla" hela nätverket eller en betydande del av det.
90 % av all nätverksutrustning har uppdaterats, mediakonverterare (signalöverföringsomvandlare) har tagits ur drift och behovet av dedikerade strömlinjer för utrustningens drift har eliminierats genom anslutning till PoE-switchar, där strömleverans sker över Ethernet-kablar.
Dessutom har alla optiska anslutningar i serverrummet och i skåpen på platserna markerats – på alla nyckelkommunikationsnoder. Detta har gjort det möjligt att förbereda ett topologiskt schema för utrustning och anslutningar i nätverket, som återspeglar dess faktiska tillstånd idag.
Nätverksdiagram
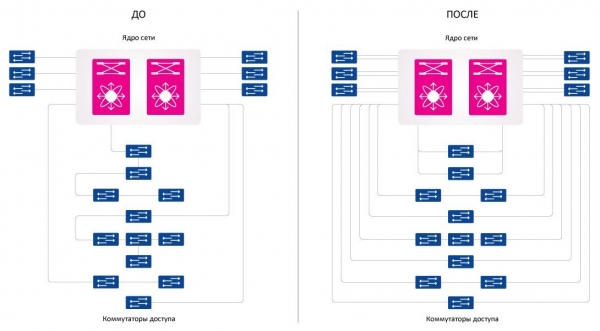
Den viktigaste slutsatsen tekniskt sett: tillräckligt omfattande infrastrukturarbete genomfördes snabbt, utan att skapa några störningar i verksamheten och knappt märkbar för personalen.
Affärsmässiga resultat av projektet
Enligt min mening är detta projekt intressant i första hand från en organisatorisk synvinkel, snarare än en teknisk. Svårigheten låg främst i planeringen och utformningen av stegen för att genomföra projektuppgifterna.
Projektets framgång gör att vi kan säga att vår initiativ till att utveckla nätverksinriktningen inom Linxdatacenters tjänsteportfölj är ett riktigt val av utvecklingsriktning för företaget. Ett ansvarsfullt förhållande till projektledning, en genomtänkt strategi och tydlig planering har gjort det möjligt för oss att utföra arbetet på en hög nivå.
Kvalitetsbekräftelse – en begäran från kunden om fortsatt tjänst för nätverksmodernisering på deras övriga platser i Ryssland.
Källa: habr.com
