

Tills nyligen fanns det i Odnoklassniki cirka 50 TB data som bearbetades i realtid och lagrades i SQL Server. För en sådan mängd är det praktiskt taget omöjligt att säkerställa snabb, pålitlig och även felresistent åtkomst till datacentret med hjälp av SQL-databaser. Vanligtvis används en av NoSQL-lagringslösningarna i sådana fall, men allt kan inte överföras till NoSQL: vissa enheter kräver ACID-transaktionsgarantier.
Detta ledde oss till att använda ett NewSQL-lagringssystem, det vill säga en databas som erbjuder felresistens, skalbarhet och snabbhet av NoSQL-system, men samtidigt behåller de bekanta ACID-garantierna från klassiska system. Det finns få fungerande industrisystem av denna nya typ, så vi utvecklade ett sådant system själva och tog det i kommersiell drift.
Hur det fungerar och vad vi åstadkom — läs vidare nedan.
Idag har "Odnoklassniki" över 70 miljoner unika besökare varje månad. Vi sociala nätverken i världen och är bland de tjugo webbplatser där användare tillbringar mest tid. Infrastruktur för "OK" hanterar mycket höga belastningar: fler än en miljon HTTP-förfrågningar per sekund mot fronten. Delar av serverparken, som består av mer än 8000 servrar, är placerade nära varandra — i fyra datacenter i Moskva, vilket möjliggör en nätverksfördröjning på mindre än 1 ms mellan dem.
Vi har använt Cassandra sedan 2010, från version 0.6. Idag används flera tiotals kluster. Det snabbaste klustret hanterar mer än 4 miljoner operationer per sekund, och det största lagrar 260 TB.
Men allt detta är vanliga NoSQL-kluster som används för lagring av data. Vi ville dock ersätta det primära konsistenta lagringssystemet, Microsoft SQL Server, som har använts sedan "Odnoklassniki" grundades. Lagringssystemet bestod av mer än 300 maskiner med SQL Server Standard Edition, som innehöll 50 TB data — affärsobjekt. Dessa data modifieras inom ramen för ACID-transaktioner och kräver .
För att fördela data över noderna i SQL Server använde vi både vertikal och horisontell (sharding). Historiskt har vi använt ett enkelt datashardningsschema: varje entitet tilldelades en token – en funktion av entitetens ID. Entiteter med samma token placerades på en SQL-server. Relationstypen master-detail realiserades så att token för huvudentiteten och den härledda posten alltid matchade och fanns på samma server. I sociala nätverk genereras nästan alla inlägg av användaren – vilket innebär att all användardata inom ett funktionellt delsystem lagras på en och samma server. Det betyder att i affärstransaktioner deltog nästan alltid tabeller från en och samma SQL-server, vilket gjorde det möjligt att säkerställa datakonsistens genom lokala ACID-transaktioner utan behov av att använda distribuerade ACID-transaktioner.
Genom sharding och för att öka hastigheten på SQL:
- Använder inte Foreign key constraints, eftersom ID för entiteten vid sharding kan finnas på en annan server.
- Använder inte lagrade procedurer och triggers på grund av ytterligare belastning på DBMS CPU.
- Använder inte JOINs på grund av allt ovanstående och många slumpmässiga läsningar från disk.
- Utanför transaktionen använder vi isoleringsnivån Read Uncommitted för att minska deadlocks.
- Genomför endast korta transaktioner (i genomsnitt kortare än 100 ms).
- Använder inte flera rader UPDATE och DELETE på grund av det stora antalet deadlocks – vi uppdaterar endast en post i taget.
- Frågor utförs alltid endast efter index – en fråga med en fullständig tabellgenomsökningsplan innebär överbelastning av databasen och dess avbrott.
Dessa steg har gjort det möjligt att maximera prestandan på SQL-servrarna. Men problemen blev allt fler. Låt oss titta på dem.
Problem med SQL
- Eftersom vi använde egenutvecklad sharding utfördes tillägget av nya shards manuellt av administratörerna. Under hela denna tid skulle de skalbara datakopiorna inte hantera förfrågningar.
- När antalet poster i tabellen ökade minskade hastigheten för insättning och modifiering, och när index lades till i den befintliga tabellen minskade hastigheten mångfalt; skapande och återskapande av index skedde med driftstopp.
- Närvaron av en begränsad mängd Windows för SQL Server i produktion komplicerar hanteringen av infrastrukturen.
Men det största problemet är —
Fel-tolerans
Den klassiska SQL-servern har dålig redundans. Anta att du har en enda databasserver och den går sönder var tredje år. Under den tiden fungerar inte webbplatsen i 20 minuter, vilket är acceptabelt. Om du har 64 servrar, fungerar inte webbplatsen en gång var tredje vecka. Och om du har 200 servrar, fungerar inte webbplatsen varje vecka. Det är ett problem.
Vad kan göras för att öka redundansen hos SQL-servern? Wikipedia föreslår att vi bygger : där det finns en duplicering i händelse av ett fel på någon av komponenterna.
Detta kräver en park av dyr utrustning: omfattande duplicering, fiberoptik, lagring av gemensam data, och dessutom fungerar aktivering av reservsystem ofta osäkert: cirka 10% av aktiveringar slutar med att reservnoden som kopplas samman med huvudnoden går ner.
Men den största nackdelen med ett sådant hög tillgängligt kluster är att det är helt otillgängligt vid en datacenterstörning där det är placerat. "VKontakte" har fyra datacenter, och vi måste säkerställa drift även vid en fullständig katastrof i något av dem.
För detta skulle vi kunna använda replikation, inbyggd i SQL Server. Denna lösning är mycket dyrare på grund av mjukvarukostnaden och lider av välkända problem med replikation - oförutsägbara transaktionsfördröjningar vid synkron replikation och förseningar vid tillämpning av replikationer (och som en konsekvens, förlorade modifieringar) vid asynkron. Dessutom gör detta alternativ helt oanvändbart för oss.
Alla dessa problem krävde en grundläggande lösning och vi började en detaljerad analys av dem. Här behöver vi bekanta oss med vad SQL Server i huvudsak gör - transaktioner.
En enkel transaktion
Låt oss titta på den enklaste transaktionen, sett från en tillämpad SQL-programmerares perspektiv: att lägga till ett foto i ett album. Album och foton lagras i olika tabeller. Ett album har en räknare för offentliga foton. Då delas en sådan transaktion upp i följande steg:
- Lås albumet genom nyckel.
- Skapa en post i fototabellen.
- Om fotot har offentlig status, ökar vi räknaren för offentliga foton i albumet, uppdaterar posten och åtar transaktionen.
Eller i form av pseudokod:
TX.start("Albums", id);
Album album = albums.lock(id);
Photo photo = photos.create(…);

if (photo.status == PUBLIC ) {
    album.incPublicPhotosCount();
}
album.update();

TX.commit();
Vi ser att det vanligaste scenariot för affärstransaktioner är att läsa data från databasen till serverns minne, göra någon förändring och spara de nya värdena tillbaka i databasen. Vanligtvis uppdaterar vi flera entiteter och flera tabeller i sådan transaktion.
Vid utförandet av en transaktion kan konkurrerande modifieringar av samma data från ett annat system inträffa. Till exempel kan Antispam besluta att en användare är misstänkt och att därför alla bilder som användaren har inte längre ska vara offentliga, de måste skickas för granskning, vilket innebär att photo.status måste ändras till ett annat värde och motsvarande räkning måste justeras. Det är uppenbart att om denna operation sker utan garantier för atomär tillämpning och isolering av konkurrerande modifieringar, som i , så kommer resultatet inte att vara som nödvändigt — antingen kommer bildräknaren att visa ett felaktigt värde eller så kommer inte alla bilder att skickas för granskning.
Likaså finns det mycket kod som manipulera med olika affärsentiteter inom en och samma transaktion, skrivet under hela Odnoklassniki's existens. Från våra erfarenheter av migrationer till NoSQL med , vet vi att de största svårigheterna (och tidskostnaderna) orsakas av behovet av att utveckla kod för att upprätthålla dataöverensstämmelse. Därför ansåg vi att det viktigaste kravet på det nya lagringssystemet var att säkerställa verkliga ACID-transaktioner för affärslogik.
Andra, minst lika viktiga, krav var:
- Vid en datacenterfel måste både läsning och skrivning till det nya lagringssystemet vara möjligt.
- Att bevara den nuvarande utvecklingshastigheten. Det vill säga, när man arbetar med det nya lagringssystemet bör mängden kod vara ungefär densamma, det ska inte behövas skriva något ytterligare i lagringssystemet, eller utveckla algoritmer för konfliktlösning, upprätthållande av sekundära index etc.
- Hastigheten på det nya lagringssystemet måste vara tillräckligt hög, både vid dataläsning och vid transaktionsbearbetning, vilket effektivt innebar att akademiskt strikta, universella men långsamma lösningar, som till exempel, .
- Automatisk skalering i realtid.
- Användning av vanliga billiga servrar, utan behov av att köpa exotisk hårdvara.
- Möjlighet att utveckla lagring med hjälp av företagets utvecklare. Med andra ord prioriterades egna eller öppna lösningar, helst på Java.
Lösningar, lösningar
Efter att ha analyserat möjliga lösningar kom vi fram till två möjliga val av arkitektur:
Det första — att ta vilken SQL-server som helst och implementera nödvändig redundans, skalningsmekanism, redundanta kluster, konflikthantering och distribuerade, pålitliga och snabba ACID-transaktioner. Vi bedömde detta alternativ som ganska komplext och arbetskrävande.
Det andra alternativet — att ta en färdig NoSQL-lagring med implementerad skalning, redundanta kluster, konflikthantering och själva implementera transaktioner och SQL. Vid första anblicken verkar även uppgiften att implementera SQL, för att inte tala om ACID-transaktioner, vara en uppgift för åratal. Men sedan insåg vi att uppsättningen av SQL-möjligheter som vi använder i praktiken ligger långt ifrån ANSI SQL på samma sätt som är långt ifrån ANSI SQL. När vi tittade närmare på CQL insåg vi att det är tillräckligt nära det vi behöver.
Cassandra och CQL
Så, vad är intressant med Cassandra, vilka möjligheter har den?
För det första kan man skapa tabeller med stöd för olika datatyper, man kan göra SELECT eller UPDATE baserat på primärnyckeln.
CREATE TABLE photos (id bigint KEY, owner bigint,…);
SELECT * FROM photos WHERE id=?;
UPDATE photos SET … WHERE id=?;
För att säkerställa datakonsistens mellan repliker, använder Cassandra . I det enklaste fallet innebär detta att när man placerar tre repliker av samma rad på olika noder i klustret, anses upptagningen vara framgångsrik om majoriteten av noderna (dvs. två av tre) har bekräftat att denna skrivoperation var lyckad. Data i raden anses vara konsistenta om majoriteten av noderna har tillfrågats och bekräftat detta vid avläsning. Således garanteras fullständig och omedelbar datakonsistens vid avbrott av en nod när det finns tre repliker. Denna metod har gjort det möjligt för oss att implementera en ännu mer pålitlig strategi: alltid skicka förfrågningar till alla tre repliker och vänta på svar från de två snabbaste. Det försenade svaret från den tredje repliken avvisas i sådana fall. Den försenade noden kan ha allvarliga problem – fördröjningar, skräpsamling i JVM, direkt minnesåtervinning i linux-kärnan, hårdvarufel, nätverksavbrott. Men detta påverkar inte klientoperationen eller datan alls.
Metoden där vi riktar oss till tre noder men får svar från två kallas : begäran om extra repliker skickas innan den "det faller av".
En annan fördel med Cassandra är Batchlog – en mekanism som garanterar antingen fullständig tillämpning eller fullständig avslag av paketet med de ändringar du gör. Detta gör att vi kan lösa A i ACID – atomäritet direkt.
Det närmaste vi kommer transaktioner i Cassandra är så kallade. Men de är långt ifrån "verkliga" ACID-transaktioner: i själva verket är detta möjligheten att göra på data för endast en post, med användning av konsensus via det tunga protokollet Paxos. Därför är hastigheten på sådana transaktioner låg.
Vad vi saknade i Cassandra
Så, vi behövde implementera riktiga ACID-transaktioner i Cassandra. Med hjälp av vilka vi enkelt skulle kunna uppnå två andra bekväma funktioner från klassiska DBMS: konsistenta snabba index, vilket skulle låta oss hämta data inte bara efter primärnyckel och en vanlig generator av monoton autoinkrementella ID.
C*One
Så föddes en ny databas C*One, bestående av tre typer servernoder:
- Lagringsenheter – (nästan) standard Cassandra-servrar som ansvarar för att lagra data på lokala diskar. Allteftersom belastningen och datavolymerna växer kan deras antal enkelt skalas upp till tiotals och hundratals.
- Transaktionskoordinatorer - säkerställer utförandet av transaktioner.
- Kunder - applikationsservrar som genomför affärsprocesser och initierar transaktioner. Det kan finnas tusentals sådana kunder.
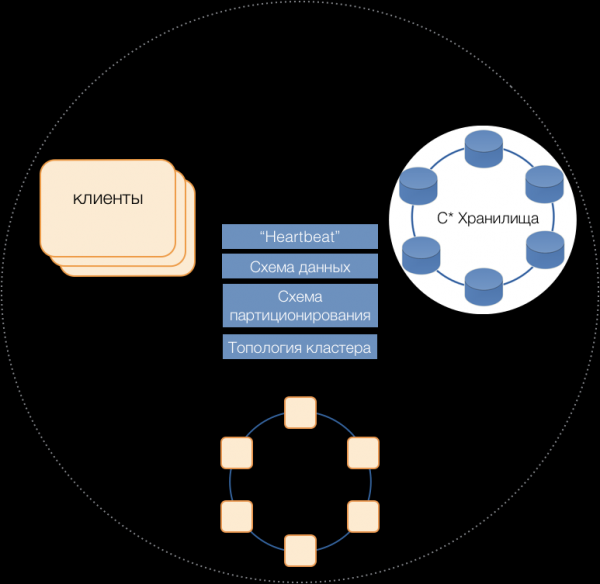
Servrar av alla typer ingår i en gemensam kluster, använder det interna meddelandeprotokollet Cassandra för att kommunicera med varandra och för att utbyta klusterinformation. Med hjälp av Heartbeat får servrarna kännedom om ömsesidiga fel, upprätthåller en gemensam dataskema - tabeller, deras struktur och replikering; partitionschema, kluster topologi, osv.
Kunder
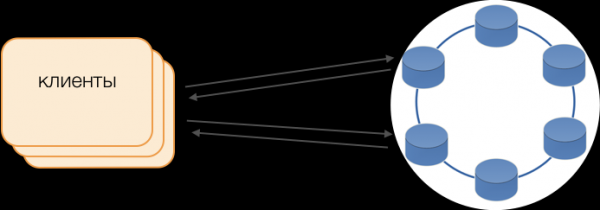
Istället för standarddrivrutiner används läget Fat Client. En sådan nod lagrar inte data men kan agera som koordinator för frågeutförande, det vill säga kunden själv utför funktionen att koordinera sina frågor: frågar lagringskopior och löser konflikter. Detta är inte bara mer pålitligt och snabbare än standarddrivrutinen som kräver kommunikation med en fjärrkoordinator, utan tillåter också hantering av frågor. Utanför en öppen kundtransaktion dirigeras frågor till lagringssystemen. Om kunden har öppnat en transaktion dirigeras alla frågor inom transaktionen till transaktionskoordinatore.
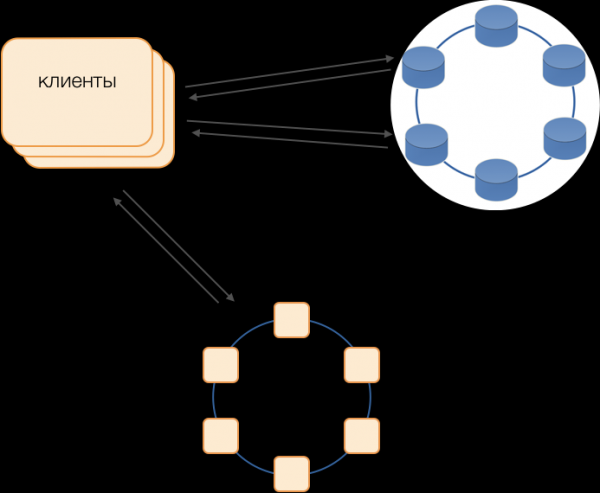
Transaktionskoordinator C*One
Koordinatorn är det vi har implementerat för C*One från grunden. Den ansvarar för hantering av transaktioner, lås och ordning för tillämpning av transaktioner.
För varje behandlad transaktion genererar koordinatorn en tidsstämpel: varje efterföljande är större än den föregående transaktionen. Eftersom Cassandra-systemets konfliktlösning är baserad på tidsstämplar (av två konfliktande poster anses den med den senaste tidsstämpeln som aktuell), kommer konflikten alltid att lösas till förmån för den efterföljande transaktionen. På så sätt har vi implementerat - en kostnadseffektiv metod för konfliktlösning i ett distribuerat system.
Lås
För att säkerställa isolering beslutade vi att använda den enklaste metoden - pessimistiska lås baserade på den primära nyckeln av posten. Med andra ord, i en transaktion måste posten först låsas, därefter läsas, modifieras och sparas. Endast efter en framgångsrik committ kan posten låsas upp så att konkurrerande transaktioner kan använda den.
Implementeringen av sådan låsning är enkel i en icke-distribuerad miljö. I ett distribuerat system finns det två huvudsakliga vägar: antingen implementera en distribuerad låsning på klustret, eller fördela transaktioner så att transaktioner som involverar en och samma post alltid hanteras av samma koordinator.
Eftersom våra data redan är distribuerade i grupper av lokala transaktioner i SQL, beslutades det att koppla koordinatorer till grupper av lokala transaktioner: en koordinator utför alla transaktioner med en token från 0 till 9, den andra med en token från 10 till 19, och så vidare. Som ett resultat blir varje instans av koordinatorn mästare över gruppen av transaktioner.
Då kan låsningar implementeras som en enkel HashMap i minnet av koordinatorn.
Koordinatorers fel
Eftersom en koordinator exklusivt hanterar en grupp av transaktioner är det mycket viktigt att snabbt kunna fastställa om den har slutat fungera, så att ett försök att verkställa transaktionen görs inom timeout. För att detta ska vara snabbt och pålitligt tillämpade vi en fullt sammanlänkad kvorum heartbeat-protokoll:
I varje datacenter finns det minst två noder av koordinatorn. Regelbundet skickar varje koordinator ett heartbeat-meddelande till de andra koordinatorerna och informerar dem om sin funktion, samt om vilket heartbeat-meddelande från vilka koordinatorer i klustret han fått senast.
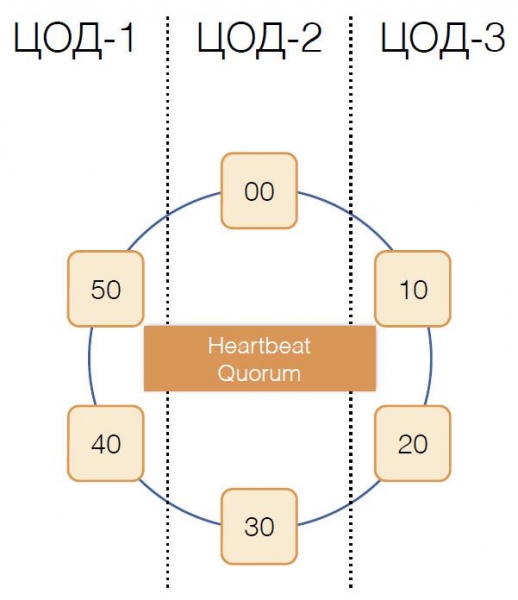
Genom att ta emot liknande information från de andra i sina heartbeat-meddelanden avgör varje koordinator för sig själv vilka noder i klustret som fungerar, och vilka som inte gör det, utifrån kvorumprincipen: om nod X har fått information om normal mottagning av meddelanden från nod Y från majoriteten av noderna i klustret, betyder det att Y fungerar. Och vice versa, så snart majoriteten meddelar om att de inte mottar meddelanden från nod Y, betyder det att Y har slutat fungera. Det är intressant att om kvorumet meddelar nod X att den inte längre får några meddelanden från den, kommer själva nod X att betrakta sig som felaktig.
Heartbeat-meddelanden skickas med hög frekvens, ungefär 20 gånger per sekund, med en period på 50 ms. I Java är det svårt att garantera appens svar inom 50 ms på grund av jämförbar längd på pauser orsakade av skräpsamlaren. Vi lyckades uppnå sådan svarstid med hjälp av G1-skräpsamlaren, som gör det möjligt att ställa in mål för längden av GC-pausar. Men ibland, ganska sällan, överskrider skräpsamlarens pauser 50 ms, vilket kan leda till falska felregistreringar. För att undvika detta rapporterar koordinatorsystemet inte om en fjärrnods fel om den första heartbeat-meddelandet försvinner, utan bara om flera försvinner i rad. På så sätt lyckades vi upptäcka fel för koordinatorsystemet inom 200 ms.
Men det är inte tillräckligt att snabbt förstå vilken nod som har slutat fungera. Något måste göras åt detta.
Reservkraft
Den klassiska schemat föreslår att vid en masters fel, starta valet av en ny med hjälp av en av algoritmerna. Men sådana algoritmer har välkända problem med konvergens över tid och längden av själva valprocessen. Dessa ytterligare fördröjningar lyckades vi undvika genom att använda en schema för att ersätta koordinatorer i ett fullständigt anslutet nätverk:
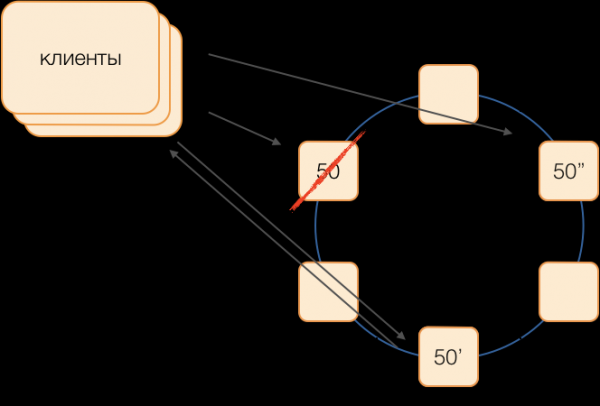
Anta att vi vill utföra en transaktion i grupp 50. Låt oss i förväg definiera ersättningsschemat, det vill säga vilka noder som kommer att utföra transaktioner för grupp 50 i händelse av att huvudkoordinatorn misslyckas. Vårt mål är att bevara systemets funktionalitet vid ett datacenters fel. Vi definierar att den första reservnoden kommer att vara en nod från ett annat datacenter, och den andra reservnoden kommer att vara en från det tredje. Detta schema väljs en gång och ändras inte förrän klusterets topologi ändras, det vill säga tills nya noder ansluts (vilket inträffar mycket sällan). Ordningen för att välja en ny aktiv master vid det gamla felet kommer alltid att vara: den aktiva mastern blir den första reservnoden, och om den också har slutat fungera - blir den andra reservnoden aktiv.
Ett sådant schema är mer pålitligt än en universell algoritm, eftersom det för att aktivera en ny master bara kräver att man fastställer faktumet av den gamla masters fel.
Men hur förstår kunderna vilken av mästarna som arbetar just nu? Det är omöjligt att skicka information till tusentals kunder på 50 ms. Det kan hända att kunden skickar en begäran om att öppna en transaktion, utan att veta att denne mästare redan har slutat fungera, och begäran kommer att hänga på en timeout. För att förhindra detta skickar kunderna spekulativt en begäran om att öppna en transaktion direkt till gruppens mästare och båda hans reserver, men bara den som är den aktiva mästaren just nu kommer att svara på denna begäran. All efterföljande kommunikation inom transaktionen kommer kunden endast att ha med den aktiva mästaren.
Reservmästarna som får begärningar på transaktioner som inte tillhör dem själva placerar dessa i kön för ej skapade transaktioner, där de lagras under en viss tid. Om den aktiva mästaren dör, tar den nya mästaren hand om begärningarna om att öppna transaktioner från sin kö och svarar kunden. Om kunden redan har lyckats öppna en transaktion med den gamla mästaren, ignoreras det andra svaret (och uppenbarligen kommer en sådan transaktion inte att slutföras och kommer att upprepas av kunden).
Hur en transaktion fungerar
Antag att kunden har skickat en begäran till koordinatorn om att öppna en transaktion för en viss entitet med en viss primärnyckel. Koordinatorn låser denna entitet och placerar den i låstables i minnet. Om det behövs, läser koordinatorn in denna entitet från lagringssystemet och sparar de erhållna data i transaktionens tillstånd i minnet hos koordinatorn.
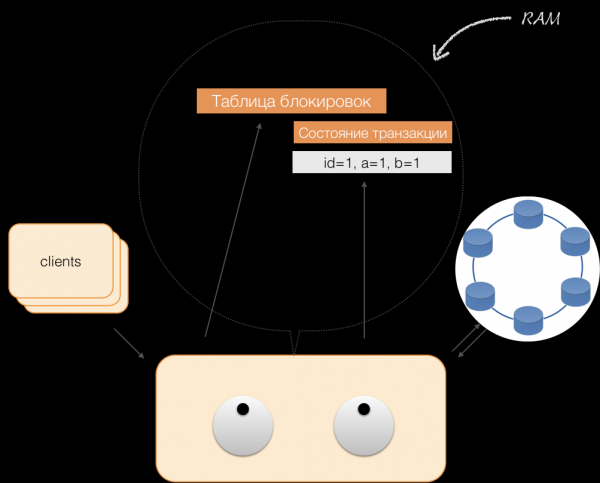
När kunden vill ändra data i transaktionen skickar hen en begäran om att modifiera entiteten till koordinatorn, som då placerar de nya uppgifterna i transaktionens tillståndstabell i minnet. Här slutförs skrivningen — ingen skrivning till lagringssystemet görs.
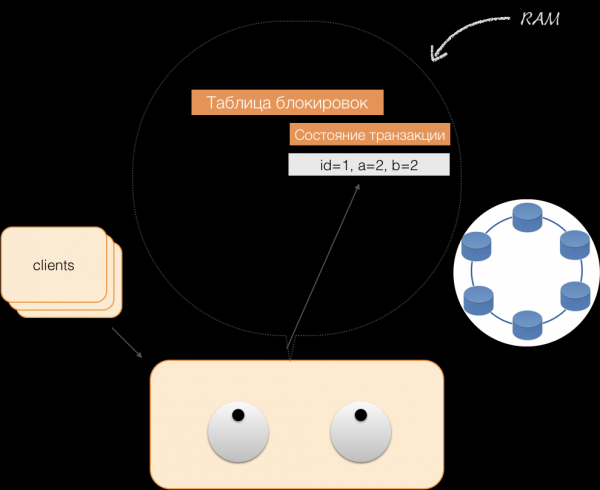
När kunden begär sina ändrade data inom en aktiv transaktion, agerar koordinatorn så här:
- om ID redan finns i transaktionen, tas data från minnet;
- om ID inte finns i minnet, läses de saknade uppgifterna in från nodlagringssystemen, kombineras med de redan befintliga i minnet, och resultatet ges till kunden.
På så sätt kan kunden läsa sina egna ändringar, medan andra kunder inte ser dessa förändringar, eftersom de endast lagras i koordinatorns minne och ännu inte finns i Cassandra-noderna.
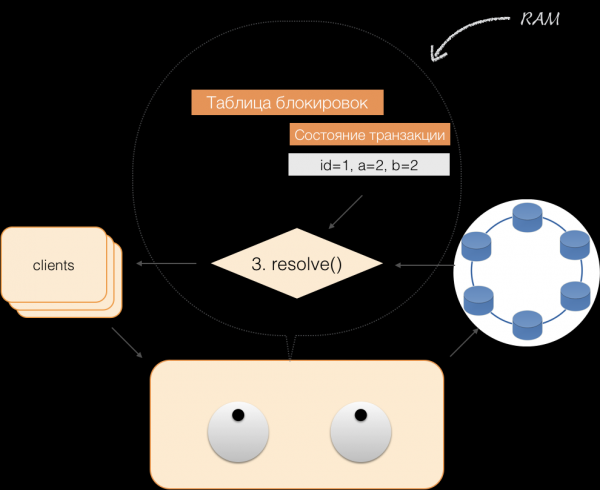
När en klient skickar en commit, sparas det tillstånd som fanns i tjänstens minne av koordinatören i den registrerade batchen, och i form av registrerad batch skickas det till Cassandra-lagringarna. Lagringarna gör allt som krävs för att denna batch ska tillämpas atomärt (fullständigt) och returnerar svaret till koordinatören, som sedan frigör låsningarna och bekräftar transaktionens framgång för klienten.
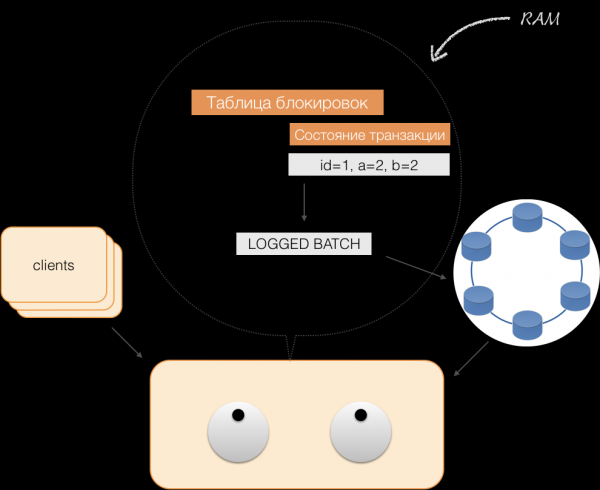
För att ångra behöver koordinatören bara frigöra minnet som upptas av transaktionens tillstånd.
Som ett resultat av ovanstående förbättringar har vi implementerat ACID-principerna:
- Atomärt. Detta är en garanti för att ingen transaktion kommer att registreras i systemet delvis; antingen kommer alla underoperationer att utföras eller ingen av dem. Denna princip upprätthålls av den registrerade batchen i Cassandra.
- Konsistens. Varje framgångsrik transaktion registrerar per definition endast giltiga resultat. Om det efter att ha öppnat transaktionen och utfört en del operationer upptäcks att resultatet är ogiltigt, utförs en ångring.
- Isolering. Vid utförande av en transaktion får parallella transaktioner inte påverka dess resultat. Konkurrerande transaktioner isoleras med hjälp av pessimistiska lås på koordinatören. För läsningar utanför transaktionen följs isoleringsprincipen på nivån Read Committed.
- Beständighet. Oavsett problem på lägre nivåer — strömavbrott, maskinvarufel — ska ändringar som gjorts av en framgångsrikt avslutad transaktion förbli kvar efter att verksamheten återupptagit.
Läsning via index
Låt oss ta en enkel tabell:
CREATE TABLE photos (
id bigint primary key,
e ägare bigint,
ändrad timestamp,
…)
Den har ett ID (primärnyckel), ägare och datum för ändring. Vi behöver göra en mycket enkel fråga — hämta data per ägare med ändringsdatum "de senaste 24 timmarna".
SELECT *
WHERE owner=?
AND modified>?
För att en sådan fråga ska fungera snabbt, måste en klassisk SQL-databas skapa ett index på kolumnerna (owner, modified). Detta kan vi göra ganska enkelt, eftersom vi nu har garantier för ACID!
Index i C*One
Det finns en ursprunglig tabell med foton, där postens ID är primärnyckeln.
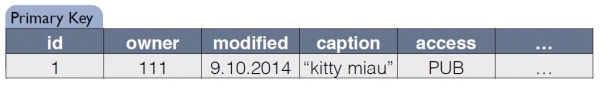
För C*One skapar en ny tabell som är en kopia av den ursprungliga. Nyckeln överensstämmer med det indexuttryck som dessutom inkluderar den primära nyckeln för posten från den ursprungliga tabellen:
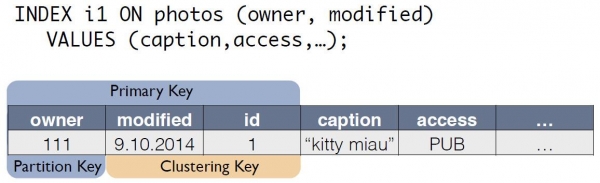
Nu kan frågan om "ägaren under de senaste 24 timmarna" skrivas om som en select från en annan tabell:
SELECT * FROM i1_test
WHERE owner=?
AND modified>?
Konsistensen mellan den ursprungliga tabellen photos och indexet i1 upprätthålls automatiskt av koordinatorn. Utifrån bara datamodellen, vid ändringar, genererar koordinatorn och sparar förändringar inte bara för huvudtabellen utan även för kopiorna. Inga ytterligare åtgärder görs med indextabellen, loggar läses inte, och lås används inte. Det betyder att tillägg av index i stort sett inte förbrukar resurser och i praktiken inte påverkar hastigheten på tillämpningen av modifieringar.
Med hjälp av ACID har vi lyckats implementera index "som i SQL". De har konsistens, kan skalas, fungerar snabbt, kan vara sammansatta och integreras i CQL-frågespråket. Inga ändringar behöver göras i applikationskoden för att stödja index. Allt är enkelt, som i SQL. Och kanske viktigast av allt, index påverkar inte hastigheten på exekveringen av modifieringar i den ursprungliga transaktionstabellen.
Vad som blev resultatet
Vi utvecklade C*One för tre år sedan och lanserade det i produktionsdrift.
Vad har vi fått som resultat? Låt oss bedöma detta baserat på delsystemet för hantering och lagring av foton, en av de mest kritiska datatyperna i sociala nätverk. Det handlar inte om själva fotona, utan om all möjlig metadata. Just nu finns det cirka 20 miljarder sådana poster i "Odnoklassniki", systemet hanterar 80 000 läsförfrågningar per sekund, och upp till 8 000 ACID-transaktioner per sekund relaterade till datamodifiering.
När vi använde SQL med replication factor = 1 (men i RAID 10), lagrades metadata för foton i en högtillgänglig kluster av 32 maskiner med Microsoft SQL Server (plus 11 reservmaskiner). Dessutom avsattes 10 servrar för lagring av säkerhetskopior. Totalt 50 kostsamma maskiner. Systemet fungerade under nominell belastning, utan marginal.
Efter migreringen till det nya systemet har vi fått en replikationsfaktor = 3 – en kopia i varje datacenter. Systemet består av 63 noder i Cassandra-lagring och 6 koordinatormaskiner, totalt 69 servrar. Dessa maskiner är dock betydligt billigare, deras totala kostnad uppgår till cirka 30 % av kostnaden för systemet på SQL. Samtidigt hålls belastningen på en nivå av 30 %.
Med implementeringen av C*One har också latensen minskat: i SQL tog en skrivoperation cirka 4,5 ms. I C*One – cirka 1,6 ms. Transaktionstiden är i genomsnitt mindre än 40 ms, commit utförs på 2 ms, och läs- och skrivtiden ligger i genomsnitt på 2 ms. 99:e percentilen ligger på endast 3-3,1 ms, antalet timeouts har minskat med 100 gånger – allt tack vare det omfattande användningen av spekulationer.
Vid denna tidpunkt har en stor del av SQL Server-noderna tagits ur drift, nya produkter utvecklas endast med hjälp av C*One. Vi har anpassat C*One för att fungera i vårt moln. , vilket har gjort det möjligt att påskynda distributionsprocessen av nya kluster, förenkla konfigurationen och automatisera driften. Utan källkoden skulle detta varit betydligt svårare och mer klumpigt.
Just nu arbetar vi med att migrera våra andra lagringslösningar till molnet – men det är en helt annan historia.
Källa: habr.com
