

Den klassiska frågan som en utvecklare ställer till sin DBA eller affärsinnehavare - till en PostgreSQL-konsult - låter nästan alltid likadan: "Varför tar frågorna så lång tid att köra på databasen?"
Ett traditionellt set av orsaker:
- ineffektiv algoritm
när du bestämde dig för att göra JOIN av flera CTE med ett par tiotusentals poster - ointressant statistik
om den faktiska datadistributionen i tabellen skiljer sig mycket från vad som samlades in av ANALYZE senaste gången - "flaskhals" på resurser
och det finns inte tillräckligt med tilldelade CPU-resurser, minnet pumpas hela tiden eller disken hänger inte med alla databasens "önskemål" - låser från konkurrerande processer
Och om låsningar är svåra att fånga och analysera, räcker det med att frågeplanen, som kan erhållas med hjälp av (bäst är förstås att direkt använda EXPLAIN (ANALYZE, BUFFERS) …) eller .
Men som sagt i samma dokumentation,
"Att förstå planen är en konst, och för att behärska den krävs viss erfarenhet, ..."
Men man kan klara sig utan den, om man använder ett lämpligt verktyg!
Hur ser en frågeplan ut? Så här:
Index Scan using pg_class_relname_nsp_index on pg_class (actual time=0.049..0.050 rows=1 loops=1)
  Index Cond: (relname = $1)
  Filter: (oid = $0)
  Buffers: shared hit=4
  InitPlan 1 (returns $0,$1)
    ->  Limit (actual time=0.019..0.020 rows=1 loops=1)
          Buffers: shared hit=1
          ->  Seq Scan on pg_class pg_class_1 (actual time=0.015..0.015 rows=1 loops=1)
                Filter: (relkind = 'r'::"char")
                Rows Removed by Filter: 5
                Buffers: shared hit=1
eller så här:
"Append  (cost=868.60..878.95 rows=2 width=233) (actual time=0.024..0.144 rows=2 loops=1)"
"  Buffers: shared hit=3"
"  CTE cl"
"    ->  Seq Scan on pg_class  (cost=0.00..868.60 rows=9972 width=537) (actual time=0.016..0.042 rows=101 loops=1)"
"          Buffers: shared hit=3"
"  ->  Limit  (cost=0.00..0.10 rows=1 width=233) (actual time=0.023..0.024 rows=1 loops=1)"
"        Buffers: shared hit=1"
"        ->  CTE Scan on cl  (cost=0.00..997.20 rows=9972 width=233) (actual time=0.021..0.021 rows=1 loops=1)"
"              Buffers: shared hit=1"
"  ->  Limit  (cost=10.00..10.10 rows=1 width=233) (actual time=0.117..0.118 rows=1 loops=1)"
"        Buffers: shared hit=2"
"        ->  CTE Scan on cl cl_1  (cost=0.00..997.20 rows=9972 width=233) (actual time=0.001..0.104 rows=101 loops=1)"
"              Buffers: shared hit=2"
"Planning Time: 0.634 ms"
"Execution Time: 0.248 ms"
Men att läsa planen i textform "från papperet" är mycket svårt och oöverskådligt:
- i noden visas summan av resurser för underträdet
För att förstå hur mycket tid som gick åt för att utföra en specifik nod eller hur mycket denna läsning från tabellen hämtade data från disken - måste man på något sätt dra det ena från det andra. - Nodens tid är nödvändig. Att multiplicera med loops.
Ja, subtraktion är inte den svåraste operationen att göra "i huvudet" - eftersom den utförda tiden anges som genomsnittlig för en nods exekvering, och det kan finnas hundratals. - Och allt detta tillsammans gör det svårt att besvara den viktigaste frågan - så vem är det? "Den svagaste länken".?
När vi försökte förklara allt detta för flera hundra av våra utvecklare insåg vi att det ser ut ungefär så här från sidan:
Alltså, vi behöver...
Verktyget
I den har vi försökt samla alla nyckelmekanismer som hjälper till med planen och frågan om "vem som är skyldig och vad man ska göra". Och även dela med oss av vår erfarenhet med samhället.
Möt och använd -
Överskådlighet av planer.
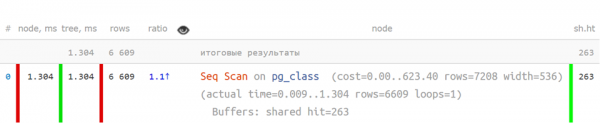
Är det lätt att förstå planen när den ser ut så här?
Seq Scan on pg_class (actual time=0.009..1.304 rows=6609 loops=1)
  Buffers: shared hit=263
Planning Time: 0.108 ms
Execution Time: 1.800 ms
Inte så mycket.
Men så här, i förkortad form,, när de nyckeltal är separerade - är det redan mycket tydligare:
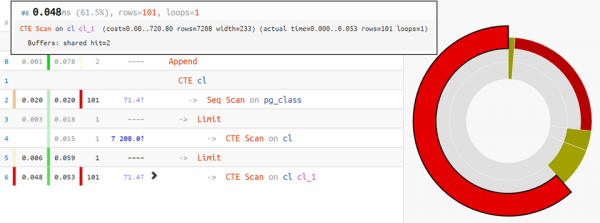
Men om planen är mer komplex - kommer piechart av tidens fördelning för noder:
Och för de mest komplexa alternativen kommer exekveringsdiagrammet:
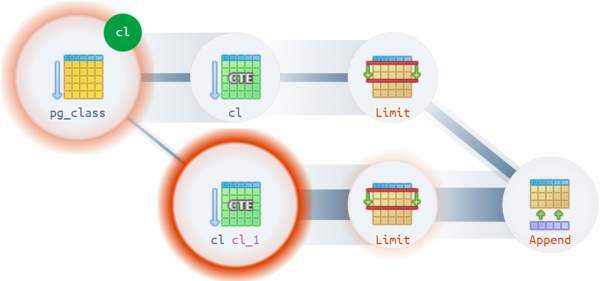
Till exempel kan det förekomma tillräckligt otypiska situationer där planen kan ha mer än en faktisk rot:
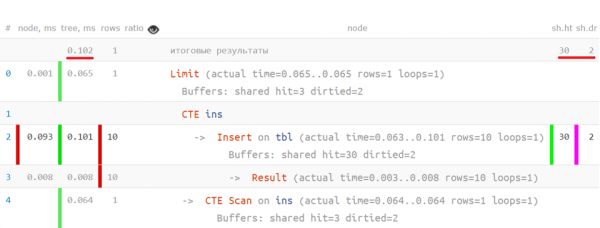
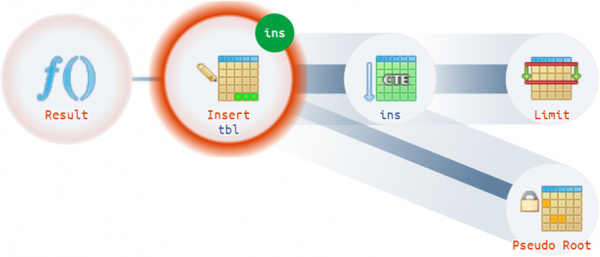
Strukturella tips.
Men om hela planens struktur och dess svaga punkter redan är utlagda och synliga - varför inte markera dem för utvecklaren och förklara "på ett lättbegripligt språk"?
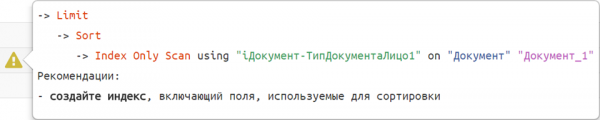 Vi har redan samlat ett par dussin sådana rekommendationsmallar.
Radprofilering av frågor.
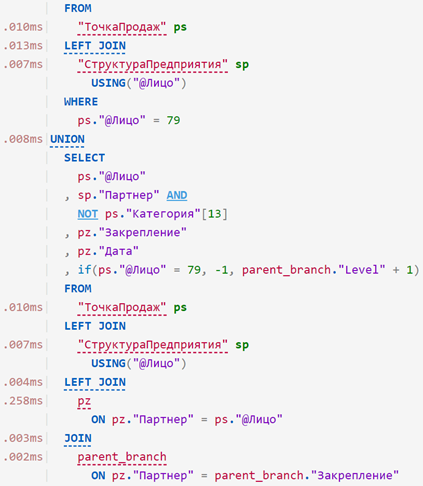
Nu, om vi lägger den ursprungliga frågan ovanpå den analyserade planen, kan vi se hur mycket tid som gick åt för varje enskild operator - ungefär så här:
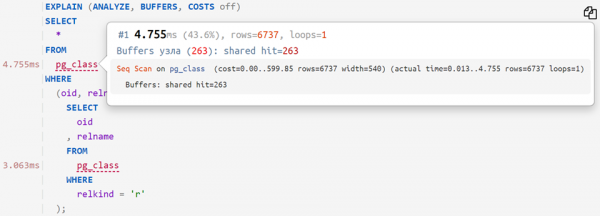
… eller till och med så här:
Parametrisering av frågan.
Om du "fästde" inte bara frågan till planen utan också dess parametrar från DETAIL-raden i loggen, kan du kopiera den på ytterligare ett sätt:
- med parametrisering av värden i frågan.
för att utföra den direkt på din databas och vidare profilera.SELECT 'const', 'param'::text; - med parametrisering av värden genom PREPARE/EXECUTE.
för att simulera schemaläggarens arbete när den parametriska delen kan ignoreras — till exempel vid arbete med partitionerade tabellerDEALLOCATE ALL; PREPARE q(text) AS SELECT 'const', $1::text; EXECUTE q('param'::text);
Planarkiv
Klistra in, analysera, dela med kollegor! Planerna kommer att förbli i arkivet och du kan återkomma till dem senare:
Men om du inte vill att andra ska se din plan, kom ihåg att kryssa i rutan "publicera inte i arkivet".
I kommande artiklar kommer jag att berätta om de svårigheter och lösningar som uppstår vid analys av planen.
Källa: habr.com
