

När man arbetar med en produkt som har utvecklats i mer än ett decennium är det inte förvånande att man stöter på föråldrad teknik. Men vad händer om ni om sex månader måste hantera en belastning som är tio gånger högre, och kostnaden för driftstopp ökar hundra gånger? I så fall behöver ni en duktig Highload Engineer. Men i avsaknad av en sådan, fick jag ta på mig ansvaret för att lösa problemet. I den första delen av artikeln kommer jag att berätta om vår övergång från Redis till Redis-cluster, och i den andra delen kommer jag att ge tips om hur man börjar använda klustret och vad man ska tänka på vid drift.
Val av teknik
Är det så dåligt separat Redis (standalone redis) med en konfiguration av 1 master och N slavar? Varför kallar jag det för föråldrad teknik?
Nej, Redis är inte så dåligt... Men det finns vissa brister som inte kan ignoreras.
För det första stödjer inte Redis mekanismer för katastrofåterställning efter att master har fallit. För att lösa detta problem använde vi en konfiguration med automatisk omdirigering av VIP till den nya mastern, förändring av rollen av en av slavarna och omkoppling av de andra. Denna mekanism fungerade, men man kan inte kalla den ett pålitligt lösning. För det första skedde falska larm, och för det andra var den engångslösning, och efter utlöst incident krävdes manuella åtgärder för att återställa systemet.
För det andra orsakade det att det bara fanns en master problem med sharding. Man var tvungen att skapa flera oberoende kluster "1 master och N slavar", sedan manuellt fördela databaserna över dessa maskiner och hoppas att ingen databas nästa dag skulle växa så mycket att den måste flyttas till en separat instans.
Vilka alternativ finns?
- Det dyraste och mest omfattande alternativet är Redis-Enterprise. Detta är en färdig lösning med full teknisk support. Trots att det verkar perfekt ur tekniskt perspektiv passade det oss inte av ideologiska skäl.
- Redis-cluster. Det finns inbyggt stöd för katastrofåterkoppling av master och sharding. Gränssnittet skiljer sig nästan inte från den vanliga versionen. Det ser lovande ut, vi kommer att diskutera fallgroparna senare.
- Tarantool, Memcache, Aerospike och andra. Alla dessa verktyg gör ungefär samma sak. Men var och en har sina brister. Vi har valt att inte lägga alla ägg i en korg. Memcache och Tarantool använder vi för andra uppgifter, och för att förutse, har vi haft fler problem med dem i vår praktik.
Användningsspecifika
Låt oss titta på vilka uppgifter vi historiskt har löst med Redis och vilken funktionalitet vi har använt:
- Cache inför förfrågningar till externa tjänster som 2GIS | Golang
GET SET MGET MSET "VÄLJ DB"
- Cache inför MYSQL | PHP
GET SET MGET MSET SCAN "NYCKEL EFTER MÖNSTER" "VÄLJ DB"
- Huvudlagring för tjänsten som arbetar med sessioner och koordinatorer för förare | Golang
GET SET MGET MSET "VÄLJ DB" "LÄGG TILL GEO NYCKEL" "HÄMTA GEO NYCKEL" SCAN
Som ni ser, ingen avancerad matematik. Vad är då svårigheten? Låt oss gå igenom varje metod separat.
Metod
Beskrivning
Egenskaper för Redis-kluster
Lösning
GET SET
Skriva/läsa en nyckel
MGET MSET
Skriva/läsa flera nycklar
Nycklarna kommer att ligga på olika noder. Färdiga bibliotek kan göra multi-operationer endast inom en nods gränser.
Ersätt MGET med pipeline av N GET operationer
VÄLJ DB
Välja databasen som vi ska arbeta med
Stöder inte flera databaser
Lägg allt i en databas. Lägg till prefix till nycklarna.
SCAN
Gå igenom alla nycklar i databasen
Eftersom vi har en databas, är det för kostsamt att gå igenom alla nycklar i klustret.
Upprätthålla invariant inom en nyckel och göra HSCAN på denna nyckel. Eller helt avstå.
GEO
Operationer med geo-nyckeln
Geo-nyckeln kan inte shardas
NYCKEL EFTER MÖNSTER
Söka efter nyckel efter mönster
Eftersom vi har en databas, kommer vi att söka bland alla nycklar i klustret. För kostsamt.
Avstå eller upprätthålla invariant, som i fallet med SCAN.
Redis vs Redis-kluster
Vad förlorar vi och vad får vi genom att gå över till kluster?
- Nackdelar: vi förlorar funktionaliteten hos flera databaser.
- Om vi vill lagra logiskt orelaterade data i ett kluster, måste vi göra lösningar i form av prefix.
- Vi förlorar alla operationer «per databas», som SCAN, DBSIZE, CLEAR DB, etc.
- Multi-operationer har blivit betydligt svårare att genomföra, eftersom det kan krävas att man kontaktar flera noder.
- Fördelar:
- Hög tillgänglighet i form av nödfunktionering av master.
- Sharding på Redis-sidan.
- Överföring av data mellan noder atomärt och utan driftstopp.
- Tillfoga och omfördela resurser och belastningar utan driftstopp.
Jag skulle dra slutsatsen att om du inte behöver säkerställa en hög nivå av driftsäkerhet så är det inte värt att flytta till ett kluster, eftersom det kan vara en icke-trivial uppgift. Men om man från början väljer mellan en separat version och ett kluster, så bör man välja kluster, eftersom det inte är sämre och dessutom avlastar en del av huvudvärken.
Förberedelse för flytt
Låt oss börja med kraven för flytten:
- Den bör vara sömlös. En total stopp av servicen i 5 minuter är oacceptabelt för oss.
- Den bör vara så säker och gradvis som möjligt. Vi vill ha viss kontroll över situationen. Att bara köra allt på en gång och be en bön till återställningsknappen är inte något vi önskar.
- Minimala datarförluster vid flytt. Vi förstår att det blir mycket svårt att flytta atomärt, så vi accepterar viss desynkronisering mellan data i vanlig och kluster Redis.
Underhåll av klustret
Innan själva flytten bör vi tänka på om vi kan underhålla klustret:
- Diagram. Vi använder Prometheus och Grafana för att visa belastningen på processorer, använda minne, antal kunder, antal operationer GET, SET, AUTH, etc.
- Expertis. Föreställ dig att det stora klustret kommer att vara ditt ansvar i morgon. Om det går sönder kan ingen, förutom du, laga det. Om det börjar lagga kommer alla att komma till dig. Om resurser måste läggas till eller belastningen omfördelas — återigen till dig. För att inte bli gråhårig vid 25 bör man förutse dessa scenarier och testa i förväg hur teknologin kommer att bete sig vid olika åtgärder. Vi kommer att prata mer om detta i avsnittet "Expertis".
- Övervakning och notifieringar. När klustret går sönder vill man veta det först. Här har vi nöjt oss med att notifiera att alla noder returnerar samma information om klustrets tillstånd (ja, det kan vara annorlunda). Andra problem märks snabbare genom notifieringar från Redis-klienttjänster.
Flytt
Hur vi ska flytta:
- Först måste vi förbereda biblioteket för att arbeta med klustret. Som grund för Gо-versionen använde vi go-redis och gjorde några justeringar. Vi implementerade Multi-metoder genom pipelines och justerade även reglerna för begärningsåterupprepning. Med PHP-versionen stötte vi på fler problem, men i slutändan valde vi php-redis. Nyligen introducerade de klusterstöd, vilket vi anser ser bra ut.
- Därefter måste vi distribuera själva klustret. Detta görs bokstavligen med två kommandon baserat på konfigurationsfilen. Vi kommer att diskutera inställningen mer nedan.
- För en gradvis övergång använder vi dry-mode. Eftersom vi har två versioner av biblioteket med identiskt gränssnitt (en för den vanliga versionen och en för klustret), är det enkelt att skapa en wrapper som arbetar med den separata versionen och samtidigt duplicera alla begärningar till klustret, jämföra svaren och logga avvikelserna (i vårt fall i NewRelic). På så sätt, även om kluster-versionen skulle gå sönder vid utrullningen, påverkas vår produktion inte.
- Genom att rulla ut klustret i dry-läge kan vi lugnt titta på diagrammet över svarens avvikelser. Om andelen fel långsamt men säkert rör sig mot någon liten konstant, då är allt bra. Varför finns det avvikelser ändå? För att inläsning i den separata versionen sker något tidigare än i klustret, och på grund av mikrolag kan data skilja sig åt. Det återstår bara att kolla loggarna över avvikelserna, och om de alla är förklarliga genom icke-atomär inläsning, kan vi gå vidare.
- Nu kan vi växla dry-mode tillbaka. Vi kommer att läsa och skriva från klustret, och duplicera i den separata versionen. Varför? Under den kommande veckan vill vi observera klustrets arbete. Om det visar sig att det finns problem vid hög belastning, eller om vi missade något, har vi alltid en nödkoppling till den gamla koden och aktuella data tack vare dry-mode.
- Det återstår att stänga av dry-mode och demontera den separata versionen.
Expertis
Först en kort översikt av klusterets uppbyggnad.
Först och främst är Redis en key-value-lagring. Valfria strängar används som nycklar. Värdena kan vara nummer, strängar och hela datastrukturer. Det finns många av de senare, men för att förstå den allmänna uppbyggnaden är detta inte viktigt.
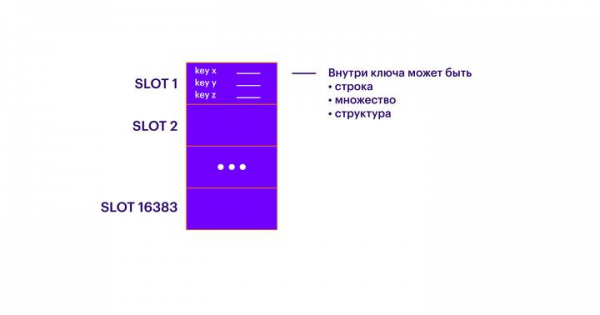
Den nästa abstraheringsnivån efter nycklarna är slots (SLOTS). Varje nyckel tillhör en av 16 383 slots. Inom varje slot kan det finnas hur många nycklar som helst. Således delas alla nycklar in i 16 383 icke-överlappande mängder.
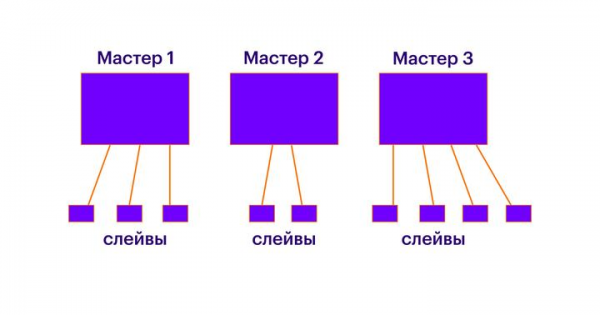
Vidare måste det finnas N master-noder i klustret. Varje nod kan representeras som en separat Redis-instans som vet allt om de andra noderna inom klustret. Varje master-nod innehåller ett visst antal slots. Varje slot tillhör endast en master-nod. Alla slots måste fördelas mellan noderna. Om några slots inte fördelas, kommer nycklarna som lagras i dem att vara otillgängliga. Det är meningsfullt att köra varje master-nod på en separat logisk eller fysisk maskin. Det är också värt att komma ihåg att varje nod arbetar endast på en kärna, och om du vill köra flera instanser av Redis på en logisk maskin, se till att de körs på olika kärnor (vi har inte provat detta, men i teorin ska allt fungera). I grund och botten säkerställer master-noder vanlig sharding, och fler master-noder gör det möjligt att skala skriv- och läsfrågor.
Efter att alla nycklar har fördelats över slots och slots har spridits över master-noder, kan ett godtyckligt antal slave-noder läggas till varje master-nod. Inom varje sådan "master-slave"-koppling kommer normal replikering att ske. Slavar behövs för att skala läsförfrågningar och för failover i händelse av att master-noden går ner.
Nu ska vi prata om operationer som vi bör kunna utföra.
Vi kommer att interagera med systemet via Redis-CLI. Eftersom Redis inte har en enda ingångspunkt kan följande operationer utföras på vilken nod som helst. I varje punkt påpekar jag särskilt möjligheten att utföra operationen under belastning.
- Det första och viktigaste vi behöver är operationen cluster nodes. Den returnerar status för klustret, visar listan över noder, deras roller, fördelning av slots etc. Ytterligare information kan erhållas med cluster info och cluster slots.
- Det vore bra att kunna lägga till och ta bort noder. För detta finns operationerna cluster meet och cluster forget. Observera att cluster forget måste tillämpas på VARJE nod, både på master- och replika-noder. Cluster meet behöver däremot endast anropas på en nod. Denna skillnad kan vara förvirrande, så det är bäst att lära sig om den innan man sätter klustret i drift. Att lägga till en nod görs säkert under drift och påverkar inte klustrets funktion (vilket är logiskt). Om du planerar att ta bort en nod från klustret, se till att det inte finns några slots kvar (annars riskerar du att förlora åtkomsten till alla nycklar på den noden). Ta heller inte bort en master som har slavar, eftersom det annars kommer utföras onödig röstning för en ny master. Om det redan inte finns några slots på noderna är det ett litet problem, men varför ha onödiga val när man först kan ta bort slavarna.
- Om det är nödvändigt att tvångsmässigt byta plats på master och slav, då är kommandot cluster failover lämpligt. När du anropar det under drift, måste man förstå att under operationens utförande kommer mastern att vara otillgänglig. Vanligtvis sker bytet på mindre än en sekund, men det är inte atomärt. Du kan räkna med att vissa förfrågningar till mastern kommer att sluta med fel under den tiden.
- Innan du tar bort en nod från klustret får det inte finnas några slots kvar på den. Det är bättre att omfördela dem med hjälp av kommandot cluster reshard. Slots kommer att flyttas från en master till en annan. Hela operationen kan ta flera minuter, beroende på mängden data som flyttas, men överföringsprocessen är säker och påverkar inte klustrets funktion. På så sätt kan alla data flyttas från en nod till en annan under belastning utan att oroa sig för deras tillgänglighet. Men det finns vissa nyanser. För det första är datatransfer kopplad till viss belastning på både mottagnings- och avsändarnoden. Om mottagningsnoden redan är kraftigt belastad på processorn, bör du inte belasta den med nya data också. För det andra, så snart det inte finns några slots kvar på avsändarmastern, kommer alla dess slavar omedelbart att övergå till den master dit dessa slots har flyttats. Problemet är att alla dessa slavar samtidigt kommer att vilja synkronisera data. Och du får tur om detta blir delvis, snarare än fullständig synkronisering. Tänk på detta och kombinera operationerna för att flytta slots och stänga/överföra slavar. Eller hoppas att du har tillräckligt med marginal.
- Vad ska man göra om du vid överföringen upptäcker att du förlorat några slots? Jag hoppas att detta problem inte drabbar dig, men om det skulle hända finns operationen cluster fix. Den kommer mer eller mindre att slumpmässigt fördela slots mellan noderna. Jag rekommenderar att du kontrollerar dess funktion efter att ha tagit bort en nod med fördelade slots från klustret. Eftersom data i de odistribuerade slots redan är otillgängliga är det för sent att oroa sig för tillgängligheten av dessa slots. Samtidigt kommer operationen inte att påverka de distribuerade slots.
- En annan användbar operation är monitor. Den låter dig se en lista över alla förfrågningar som görs till noden i realtid. Dessutom kan du göra en grep på den och ta reda på om det finns önskad trafik.
Det är också värt att nämna proceduren för failover av master-noden. Kort sagt, den finns, och i min mening fungerar den utmärkt. Men man ska inte tro att om man drar ut kontakten ur väggen på en maskin med master-nod, så kommer Redis omedelbart att byta och klienterna inte kommer att märka någon nedtid. Utifrån min erfarenhet tar det några sekunder för bytet att ske. Under denna tid kommer en del data att vara otillgänglig: otillgängligheten hos master upptäckts, noderna röstar på en ny, slavar byts, data synkroniseras. Det bästa sättet att själv säkerställa att systemet fungerar är att genomföra en lokal övning. Sätt upp en kluster på din laptop, ge en minimal belastning, simulera ett fall (till exempel genom att blockera portar), och bedöm bytestiden. Enligt min åsikt, bara genom att leka med detta i ett par dagar kan man vara säker på att teknologin fungerar. Alternativt kan man hoppas att mjukvaran som används av hälften av internet säkert fungerar.
Konfiguration
Vanligtvis är konfigurationen det första som behövs för att börja arbeta med verktyget. När allt fungerar vill man inte gärna röra konfigurationen. Det krävs en del ansträngningar för att tvinga sig själv att gå tillbaka till inställningarna och noggrant gå igenom dem. Enligt min minne har vi haft minst två allvarliga misstag på grund av bristande uppmärksamhet kring konfigurationen. Var särskilt uppmärksam på följande punkter:
- timeout 0
Tiden efter vilken inaktiva anslutningar stängs (i sekunder). 0 - ingen stängs.
Inte varje bibliotek vi använder kunde stänga anslutningar korrekt. Genom att stänga av den här inställningen riskerar vi att nå gränsen för antalet klienter. Å andra sidan, om det finns ett sådant problem, så döljer den automatiska nedkopplingen av förlorade anslutningar det, och vi kanske inte lägger märke till det. Dessutom bör denna inställning inte aktiveras vid användning av persistenta anslutningar. - Save x y & appendonly yes
Spara RDB-snapshot.
Vi kommer att diskutera RDB/AOF-problemen mer ingående nedan. - stop-writes-on-bgsave-error no & slave-serve-stale-data yes
Om det är aktiverat, kommer master att sluta ta emot begärningar på förändringar vid ett fel på RDB-snapshotet. Om anslutningen till master förloras kan slav fortsätta att svara på begärningar (yes). Eller sluta svara (no).
Vi är inte nöjda med att Redis förvandlas till en pumpa. - repl-ping-slave-period 5
Efter denna tidsperiod kommer vi att börja oroa oss för att mästaren har gått sönder och att det är dags att genomföra en failover.
Vi måste manuellt hitta balansen mellan falska larm och failover. I vår erfarenhet är detta 5 sekunder. - repl-backlog-size 1024mb & epl-backlog-ttl 0
Så mycket data kan vi lagra i bufferten för en misslyckad replik. Om bufferten tar slut, måste vi synkronisera helt.
Erfarenheten visar att det är bättre att sätta ett högre värde. Det finns många anledningar till varför en replik kan börja halka efter. Om den halkar efter, så är det sannolikt att din mästare redan har svårt att hantera, och fullständig synkronisering blir den sista droppen. - maxclients 10000
Det maximala antalet samtidiga klienter.
Enligt vår erfarenhet är det bättre att sätta ett högre värde. Redis klarar sig utmärkt med 10 000 anslutningar. Se bara till att det finns tillräckligt med sockets i systemet. - maxmemory-policy volatile-ttl
Regeln för hur nycklar tas bort när minnesgränsen nås.
Det viktiga här är inte själva regeln, utan förståelsen för hur detta kommer att ske. Redis kan berömmas för sin förmåga att fungera som det ska när minnesgränsen nås.
Problem med RDB och AOF
Även om Redis själv lagrar all information i RAM, finns det även mekanismer för att spara data på disk. Specifikt finns det tre mekanismer:
- RDB-snapshot — en komplett avbildning av all data. Ställs in med hjälp av konfigurationen SAVE X Y och läses som "Spara en fullständig snapshot av all data var X sekunder, om minst Y nycklar har ändrats."
- Append-only file — en lista över operationer i den ordning de genomfördes. Lägger till nya inkommande operationer i filen var X sekunder eller efter var Y operationer.
- RDB och AOF — en kombination av de två tidigare.
Alla metoder har sina fördelar och nackdelar, jag kommer inte att lista dem alla, utan endast påpeka de som, enligt mig, inte är så uppenbara.
För det första, att spara en RDB-snapshot kräver att FORK anropas. Om det finns mycket data kan detta frysa hela Redis under en period från några millisekunder till en sekund. Dessutom behöver systemet reservera minne för en sådan snapshot, vilket leder till behovet av att hålla ett dubbelt lager av RAM på den logiska maskinen: om 8 GB tilldelas Redis, måste det finnas 16 GB tillgängligt på virtuella maskinen.
För det andra finns det problem med partiell synkronisering. I AOF-läge kan en fullständig synkronisering ske istället för partiell vid återanslutning av slaven. Jag kunde inte förstå varför detta händer, men det är värt att komma ihåg.
Dessa två punkter får en att fundera på om vi verkligen behöver dessa data på disk, om de redan dupliceras av slavarna. Data kan endast gå förlorade om alla slavar går sönder, vilket är ett problem på nivå "brand i datacentret". Som en kompromiss kan man föreslå att endast spara data på slavarna, men i så fall måste man säkerställa att dessa slavar aldrig blir master vid en katastrofåterställning (för detta finns det inställningar för slavarnas prioritet i deras konfiguration). Vi överväger i varje enskilt fall om det är nödvändigt att spara data på disk, och oftast svarar vi "nej".
Slutsats
Som avslutning hoppas jag att jag har kunnat ge en allmän översikt av hur redis-cluster fungerar till de som aldrig har hört talas om det, och att jag även har uppmärksammat vissa oklara punkter för de som har använt det länge.
Tack för er tid, och som vanligt är kommentarer i ämnet alltid välkomna.
Källa: habr.com
