

En användare vill spara nya data på sin hårddisk, men det finns inte tillräckligt med ledigt utrymme för det. Att radera något känns inte bra, eftersom "allting är väldigt viktigt och nödvändigt". Vad ska vi göra med detta?
Detta problem påverkar fler än bara honom. Våra hårddiskar huserar terabyte av information, och denna mängd tycks inte minska. Men hur unik är den? I slutändan är ju alla filer bara bitar med en viss längd, och den nya skiljer sig förmodligen inte mycket från den som redan lagras.
Det är uppenbart att söka efter redan lagrad information på hårddisken är en uppgift som, om den inte är dömd att misslyckas, i alla fall är minst sagt ineffektiv. Å andra sidan, om skillnaden är liten, kan man kanske justera lite...
TL;DR — en andra försök att berätta om en märklig metod för dataoptimering med hjälp av JPEG-filer, denna gång i en mer begriplig form.
Om bitar och skillnader
Om vi tar två helt slumpmässiga bitar av data, så överensstämmer i genomsnitt hälften av de innehållna bitarna. Och det är sant, bland möjliga kombinationer för varje par (’00, 01, 10, 11′) har exakt hälften samma värden, det är enkelt.
Men förstås, om vi bara tar två filer och justerar en till den andra, så förlorar vi en av dem. Om vi istället sparar ändringarna, så återuppuppfinner vi , som redan existerar utan vår hjälp, även om det vanligtvis inte används på samma sätt. Man kan försöka infoga en mindre sekvens i en större, men även då riskerar vi att förlora kritiska datasegment vid omdömeslöst användande av allt och alla.
Mellan vilka element kan vi då eliminera skillnad? Således, den nya fil som användaren skriver — bara en sekvens av bitar, med vilken vi i sig själva inte kan göra något. Då måste vi helt enkelt hitta sådana bitar på hårddisken att de kan ändras utan att behöva lagra skillnaden, så att vi kan överleva deras förlust utan allvarliga konsekvenser. Dessutom finns det anledning att inte bara ändra själva filen på FS, utan någon mindre känslig information inuti den. Men vilken och hur?
Justeringstekniker
Här kommer filer med förlustkomprimering till hjälp. Alla dessa jpeg, mp3 och andra är visserligen kompression med förlust, men innehåller fortfarande mängder av bitar som kan modifieras på ett säkert sätt. Man kan använda avancerade tekniker som omärkligt modifierar deras komponenter på olika kodningsställen. Vänta. Avancerade tekniker… omärklig modifiering… vissa bitar till andra… det här är nästan som !
Och verkligen, att inkorporera en information i en annan påminner verkligen om dess metoder. Det är också imponerande hur omärkliga förändringar är för det mänskliga sinnet. Där vägarna skiljs – det är vad gäller sekretessen: vår uppgift handlar om att låta användaren lägga till ytterligare information på sin hårddisk, vilket bara skadar honom. Han kommer att glömma det.
Därför, även om vi kan använda dem, behöver vi göra vissa modifieringar. Och senare kommer jag att berätta om och visa dem med ett exempel på en av de befintliga metoderna och ett vanligt filformat.
Om schakal
Om man ska komprimera, så bör man komprimera det mest komprimerade i världen. Det handlar såklart om JPEG-filer. Dessutom finns det en uppsjö av verktyg och befintliga metoder för att inkorporera data i dem, och de är det mest populära grafiska formatet på denna planet.
Trots det, för att inte hålla på med hunduppfödning, måste man begränsa sitt arbetsområde till filer av detta format. Ingen gillar enfärgade fyrkanter som dyker upp på grund av överdriven komprimering, så man bör begränsa sig till att arbeta med filen som redan är komprimerad, och undvika omkodning. Närmare bestämt – med heltalskoefficienter som förblir efter operationerna ansvariga för dataförlust – DCT och kvantisering, vilket tydligt visas i kodningsschemat (tack till Bauman National Library Wiki):
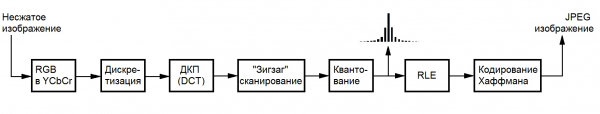
Det finns många möjliga metoder för att optimera jpeg-filer. Det finns förlustlös optimering (jpegtran), det finns optimering ““, som faktiskt ger en hel del, men de angår oss inte. För om användaren är villig att inkorporera en information i en annan för att öka det lediga utrymmet på hårddisken, så har han antingen redan optimerat sina bilder, eller så vill han helt enkelt inte göra det av rädsla för kvalitetsförlust.
F5
Ett helt familj av algoritmer passar in i sådana villkor, som man kan bekanta sig med . Den mest avancerade av dem är algoritmen av Andreas Westfeldt, som arbetar med ljusstyrkekomponentens koefficienter, eftersom det mänskliga ögat är minst känsligt för förändringar i den. Dessutom använder den en inbäddningsteknik baserad på matris-kodning, vilket gör att man kan göra färre förändringar när man bäddar in samma mängd information ju större storlek den använda behållaren har.
Själva förändringarna består i att minska det absoluta värdet på koefficienterna med ett enhet under vissa förhållanden (det vill säga, inte alltid), vilket möjliggör användning av F5 för att optimera datalagring på hårddisken. Det beror på att koefficienten efter en sådan förändring sannolikt kommer att ta upp färre bitar efter att Huffman-kodning har genomförts på grund av det statistiska värdesfördelningen i JPEG, och de nya nollorna kommer att ge fördelar vid kodning med hjälp av RLE.
Nödvändiga modifieringar handlar om att ta bort den del som ansvarar för sekretess (lösenordsswap), vilket sparar resurser och exekveringstid, och att lägga till en mekanism för att hantera flera filer istället för en i taget. Processen av förändringen kommer nog inte att intressera läsaren så mycket, därför går vi vidare till beskrivningen av implementationen.
Högteknologi
För att demonstrera arbetet med en sådan metod har jag implementerat den i ren C och genomfört en rad optimeringar både vad gäller exekveringshastighet och minne (du kan inte föreställa dig hur mycket dessa bilder väger utan komprimering, även till DCT). Plattformoberoende har uppnåtts genom att använda en kombination av bibliotek , och , för vilket jag vill tacka dem. Allt detta byggs med ‘make’, så Windows-användare som vill göra en bedömning bör installera Cygwin, eller på annat sätt ta itu med Visual Studio och biblioteken själva.
Implementation är tillgänglig i form av ett kommandoradsverktyg och ett bibliotek. Mer information om användningen av det sistnämnda kan den intresserade läsa i readme-filen i git-repot, vars länk jag kommer att bifoga i slutet av inlägget.
Hur man använder?
Var försiktig. De bilder som används för packning väljs genom att söka med reguljära uttryck i den angivna rotmappen. Efter avslutat arbete kan filer flyttas, byta namn och kopieras inom dess gränser, samt ändra fil- och operativsystem etc. Dock är det viktigt att vara mycket försiktig och inte ändra det faktiska innehållet. Förlust av värde, även en enda bit, kan leda till att informationen inte går att återställa.
Efter att programmet har körts skapar det en speciell arkivfil som innehåller all nödvändig information för uppackning, inklusive data om de använda bilderna. Själv väger den runt ett par kilobyte och har ingen betydande påverkan på det upptagna diskutrymmet.
Möjlig kapacitet kan analyseras med flaggan ‘-a’: ‘. /f5ar -a [sökmapp] [Perl-kompatibelt reguljärt uttryck]’. Packning görs med kommandot ‘. /f5ar -p [sökmapp] [Perl-kompatibelt reguljärt uttryck] [packad fil] [arkivnamn]’, och uppackning sker med ‘. /f5ar -u [arkivfil] [återställt filnamn]’.
Demonstration av arbetet
För att visa metodens effektivitet har jag laddat upp en samling av 225 helt gratis hundbilder från tjänsten och hittade en stor pdf på 45 meter av den andra volymen i dokumenten Knuth.
Sekvensen är ganska enkel:
$ du -sh knuth.pdf dogs/
44M knuth.pdf
633M dogs/

$ ./f5ar -p dogs/ .*jpg knuth.pdf dogs.f5ar
Läser komprimeringsfil... ok
Initierar arkivet... ok
Analyserar bibliotekskapacitet... klart på 17,0 sekunder
Upptäckte något garanterad kapacitet på 48439359 byte
Upptäckte möjlig kapacitet upp till 102618787 byte
Komprimerar... klart på 39,4 sekunder
Sparar arkivet... ok

$ ./f5ar -u dogs/dogs.f5ar knuth_unpacked.pdf
Initierar arkivet... ok
Läser arkivfilen... ok
Fyller arkivet med filer... klart på 1,4 sekunder
Dekomprimerar... klart på 21,0 sekunder
Skriver den extraherade datan... ok

$ sha1sum knuth.pdf knuth_unpacked.pdf
5bd1f496d2e45e382f33959eae5ab15da12cd666 knuth.pdf
5bd1f496d2e45e382f33959eae5ab15da12cd666 knuth_unpacked.pdf

$ du -sh dogs/
551M dogs/
Skärmdumpar för entusiaster
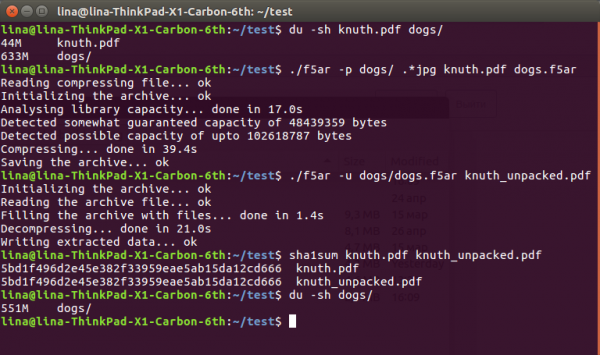
Den uppackade filen går fortfarande att läsa:
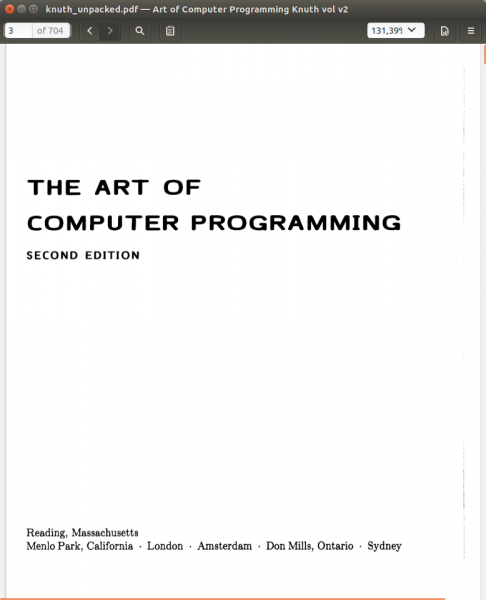
Som syns har vi från de ursprungliga 633 + 36 == 669 megabyte data på hårddisken kommit ner till mer behagliga 551. Denna radikala skillnad förklaras av den minskning av värdena i koefficienterna som påverkar deras efterföljande förlustfria komprimering: en minskning med bara ett enhet kan utan problem ‘skära’ några byte från den slutgiltiga filen. Ändå innebär detta dataförlust, även om den är mycket liten, som vi måste acceptera.
Lyckligtvis är de helt osynliga för ögat. Under spoilern (eftersom habrastorage inte klarar av stora filer) kan läsaren uppskatta skillnaden både visuellt och deras intensitet, erhållen genom att subtrahera värdena för den ändrade komponenten från den ursprungliga: , , (ju svagare färg, desto mindre skillnad i blocket).
Avslutande
Med tanke på alla dessa komplikationer kan det verka mycket enklare att köpa en hårddisk eller ladda upp allt till molnet. Men även om vi nu lever i en fantastisk tid finns det inga garantier för att vi imorgon fortfarande kan gå online och ladda upp alla våra överflödiga data. Eller att vi kan gå till affären och köpa en ny hårddisk på en terabyte. Men man kan alltid använda det som redan ligger hemma.
->
Källa: habr.com
