

Den första prototypen av objektlager såg dagens ljus 1996. Tio år senare lanserade Amazon Web Services Amazon S3, och världen började gradvis få ett nervöst sammanbrott över det platta adressutrymmet. Tack vare arbetet med metadata och sin skalbarhet utan att påverkas av belastning blev objektlager snabbt standard för de flesta molnlagringstjänster och mer därtill. En annan viktig egenskap är dess goda anpassningsförmåga för lagring av arkiv och liknande sällan använda filer. Alla som arbetade med datalagring jublade och bar den nya teknologin i händerna.
Men ryktet sa att objektlager bara handlar om stora moln, och om du inte vill ha lösningar från förbannade kapitalister, så blir det mycket svårt att skapa sitt eget. Mycket har skrivits om att implementera sitt eget moln, men informationen om att skapa så kallade S3-kompatibla lösningar är begränsad.
Så idag ska vi gå igenom vilka alternativ som finns för "Att få det som de vuxna, och inte CEPH och en större filfil", vi kommer att implementera ett av dem, och kontrollera att allt fungerar med Veeam Backup & Replication. Det har deklarerat support för S3-kompatibla lagringssystem, och det uttalandet ska vi granska.
Hur är det med andra?
Jag föreslår att vi börjar med en kort översikt av marknaden och alternativen för objektlagring. Den allmänt erkända ledaren och standarden är Amazon S3. De två närmaste efterföljarna är Microsoft Azure Blob Storage och IBM Cloud Object Storage.
Är det verkligen allt? Finns det inga andra konkurrenter? Självklart finns det konkurrenter, men vissa går sin egen väg, som Google Cloud eller Oracle Cloud Object Storage, med ofullständig S3 API-support. Vissa använder gamla versioner av API, som Baidu Cloud. Och andra, som Hitachi Cloud, kräver speciell logik, vilket med säkerhet kommer att leda till sina egna svårigheter. I vilket fall som helst jämförs alla med Amazon, som man kan betrakta som branschstandard.
Men i on-premise-lösningar finns det många fler alternativ, så låt oss definiera de viktiga kriterierna för oss. I princip räcker det med två: stöd för S3 API och användning av v4-signering. Att vara ärlig, som framtida kund är vi bara intresserade av gränssnitten för interaktion, medan den interna strukturen hos lagringslösningen är mindre intressant för oss.
Många lösningar passar dessa enkla villkor. Till exempel de klassiska företagslösningarna:
- DellEMC ECS
- NetApp S3 StorageGrid
- Nutanix Buckets
- Pure Storage FlashBlade och StorReduce
- Huawei FusionStorage
Det finns en nisch av rena mjukvarulösningar som fungerar direkt ur lådan:
- Red Hat Ceph
- SUSE Enterprise Storage
- Cloudian
Och även de som vill finputsa efter installation har fått med sig:
- CEPH i sin renaste form
- Minio (Linux-versionen, eftersom Windows-versionen har många frågor)
Listan är långt ifrån komplett, och den kan diskuteras i kommentarerna. Men glöm inte att kontrollera systemets prestanda utöver API-kompatibiliteten innan implementeringen. Det sista ni vill ha är förlust av terabyter av data på grund av hängande förfrågningar. Så tveka inte med belastningstester. Överlag har all företagsmjukvara som arbetar med stora datamängder minst kompatibilitetsrapporter. I fallet med Veeam det finns för ömsesidig testning, vilket gör att vi tryggt kan påstå att våra produkter är helt kompatibla med specifik hårdvara. Detta är ett tvåvägsarbete, som inte alltid går snabbt, men vi utökar ständigt testade lösningar.
Låt oss samla vår testbänk
Jag vill prata lite om valet av testobjekt.
För det första ville jag hitta en lösning som direkt skulle fungera ur lådan. Åtminstone med maximal sannolikhet att den skulle fungera utan onödiga insatser. Dansa med trummor och att gräva runt i konsolen på natten är ganska spännande, men ibland vill man att det ska fungera direkt. Dessutom är den övergripande tillförlitligheten hos sådana lösningar vanligtvis högre. Och ja, vi har förlorat vår äventyrslust, vi slutade klättra in i fönster till våra älskade och så vidare.
För det andra, ärligt talat, uppstår behovet av att arbeta med objektlagringslösningar oftast hos ganska stora företag, så det här är en situation där det inte bara är okej att titta på företagslösningar, utan till och med uppmuntras. I alla fall känner jag inte till några exempel där någon har blivit avskedad för att ha köpt sådana lösningar.
Med hänsyn till ovanstående valde jag Dell EMC ECS Community Edition. Det är ett mycket intressant projekt, och jag anser att det är nödvändigt att berätta för er om det.
Det första som kommer att tänka på när man ser tillägget Community Edition är att det bara är en kopia av den fullständiga ECS med vissa begränsningar, som kan tas bort genom att köpa en licens. Men så är inte fallet!
Kom ihåg:
!!!Community Edition är ett separat projekt, skapat för testning, och utan support från Dell!!
Och det går inte att omvandla till en fullständig ECS, även om man verkligen skulle vilja.
Låt oss gå igenom det
Många anser att Dell EMC ECS är det bästa lösningen om du behöver objektlagring. Alla projekt under märket ECS, inklusive kommersiella och företagslösningar, finns på . Det är en god vilja från Dells sida. Förutom mjukvaran som körs på deras märkesservrar, finns det en öppen källkodsversion som kan distribueras i molnet, på en virtuell maskin, i en container eller på sin egen maskin. Jag nämner att det till och med finns en OVA-version, som vi kommer att använda.
Själva DELL ECS Community Edition är ett mini-version av den fullständiga mjukvaran som körs på Dell EMC ECS:s märkesservrar.
Jag har identifierat fyra huvudskillnader:
- Ingen krypteringssupport. Tråkigt, men inte kritiskt.
- Ingen Fabric Layer. Denna komponent ansvarar för att bygga kluster, hantera resurser, uppdateringar, övervakning och lagring av Docker-bilder. Här är det verkligen tråkigt, men man kan förstå Dell.
- Det mest frustrerande resultatet av den föregående punkten: nodens storlek kan inte utökas efter installationen.
- Ingen support. Detta är en testprodukt som kan användas i små installationer, men personligen skulle jag inte våga laddar upp petabyte viktiga data. Men tekniskt sett kan ingen hindra dig från att göra det.
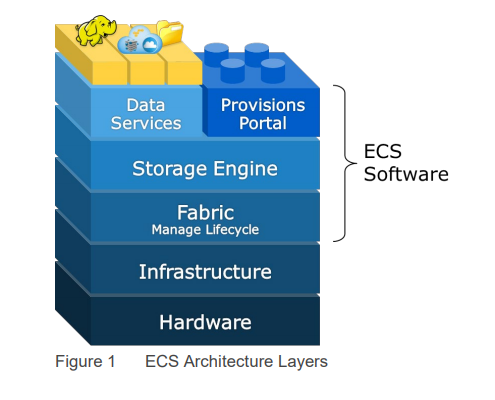
Och vad gäller den stora versionen?
Låt oss snabbt gå igenom hårdvarulösningar för att få en mer komplett förståelse av ekosystemet.
Jag tänker inte bekräfta eller avfärda påståendet att DELL ECS är det bästa on-prem objektslagret, men om du har något att säga om detta ser jag fram emot att läsa i kommentarerna. Hur som helst enligt Dell EMC är tydligt i topp fem på OBS-marknaden. Även om cloud-baserade lösningar inte räknas, men det är en separat diskussion.
Tekniskt sett är ECS en objektlagring som ger åtkomst till data via protokoll för molnlagring. Den stöder AWS S3 och OpenStack Swift. För filaktiverade bucketer stöder ECS NFSv3 för möjlighet till fil-export.
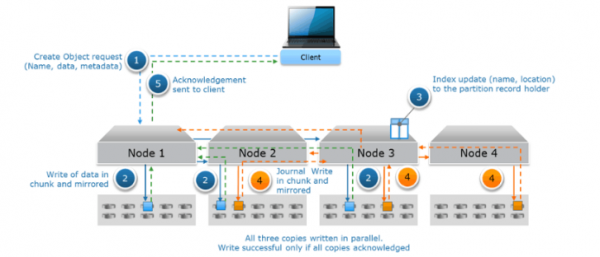
Processen för att skriva information är ganska ovanlig, särskilt jämfört med klassiska blocklagringssystem.
- Vid mottagande av nya data skapas ett nytt objekt som har ett namn, själva data och metadata.
- Objekten delas upp i bitar om 128 MB, och varje bit skrivs omedelbart till tre noder.
- Uppdateringen av indexfilen sker där identifierare och lagringsplatser skrivs.
- Loggfilen uppdateras och skrivs också till tre noder.
- En bekräftelse på framgångsrik skrivning skickas till klienten.
Alla tre kopior av data skrivs parallellt. Skrivningen anses framgångsrik endast om alla tre kopior har skrivits framgångsrikt.
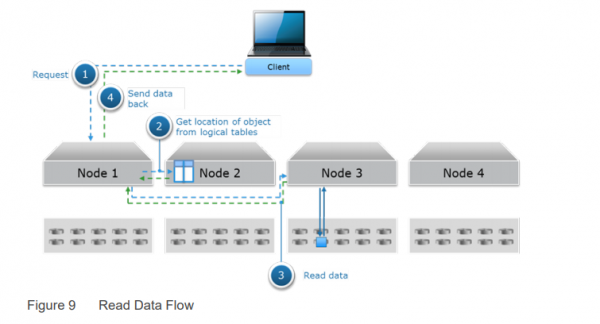
Läsning sker på ett enklare sätt:
- Klienten begär data.
- Indexet söker efter lagringsplatsen för data.
- Data läses från en nod och skickas till klienten.
Det finns ganska många servrar, så vi kommer att titta på den minsta Dell EMC ECS EX300. Den börjar på 60 TB, med möjlighet att växa till 1,5 PB. Och dess äldre bror Dell EMC ECS EX3000 kan lagra så mycket som 8,6 PB per rack.
Utveckla
Tekniskt sett kan Dell ECS CE distribueras i valfri storlek. I varje fall hittade jag inga specifika begränsningar. Men all skalning bör göras genom att klona den första noden, för vilken vi behöver:
- 8 vCPU
- 64 GB RAM
- 16 GB för operativsystemet
- 1 TB direkt för lagring
- Den senaste versionen av CentOS minimal
Detta är ett alternativ för den som vill installera allt själv från början. För oss är detta alternativ inte aktuellt eftersom jag kommer att använda en OVA-avbildning för distribution.
Men i alla fall är kraven ganska tuffa även för en nod, och om man strikt följer reglerna behövs det fyra sådana noder.
Men utvecklarna av ECS CE lever i den verkliga världen, och installationen lyckas till och med med en nod, med minimikraven som följer:
- 4 vCPU
- 16 GB RAM
- 16 GB för operativsystemet
- 104 GB lagring
Dessa resurser behövs för att distribuera OVA-bilden. Mycket mer humant och realistiskt.
Den installationsnod kan hämtas från den officiella . Där finns även detaljerad dokumentation för allt-i-ett-distributionen, men du kan även läsa på den officiella . Därför kommer vi inte att gå djupt in på hur man distribuerar OVA, det är utan finesser. Det viktigaste är att du innan du startar antingen utökar disken till önskad storlek eller kopplar på de nödvändiga.
Starta maskinen, öppna konsolen och använd de bästa standarduppgifterna:
- användarnamn: admin
- lösenord: ChangeMe
Därefter kör vi sudo nmtui och konfigurerar nätverksgränssnittet — IP/mask, DNS och gateway. Tänk på att i CentOS minimal finns det inga net-tools, kontrollera inställningarna med ip addr.
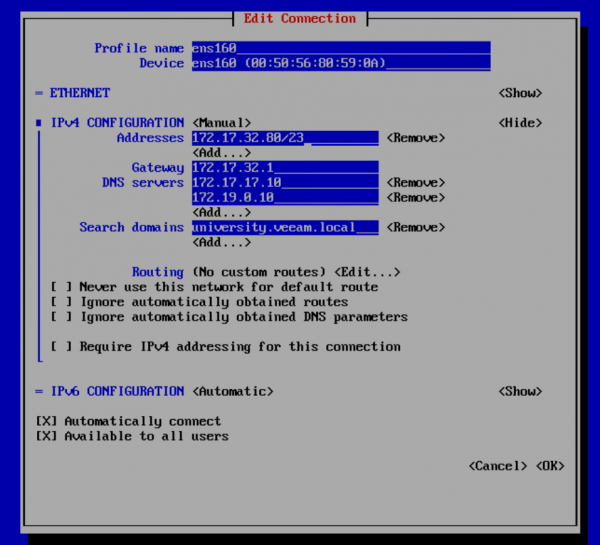
Och eftersom endast de modiga erövrar haven, gör vi en yum update, följt av en reboot. Det är faktiskt ganska säkert, eftersom hela distributionen görs genom playbooks, och alla viktiga Docker-paket är låsta på den aktuella versionen.
Nu är det dags att redigera installationsskriptet. Inga snygga fönster eller pseudosnittar — allt görs genom din favorit textredigerare. Tekniskt sett finns det två vägar: antingen kan du köra varje kommando manuellt eller direkt starta konfiguratorn videploy. Den öppnar helt enkelt konfigurationen i vim och startar kontrollen vid utgång. Men att medvetet göra livet enklare är inte intressant, så vi kommer att göra två kommandon mer. Även om det inte finns något syfte med detta, jag har varnat dig =)
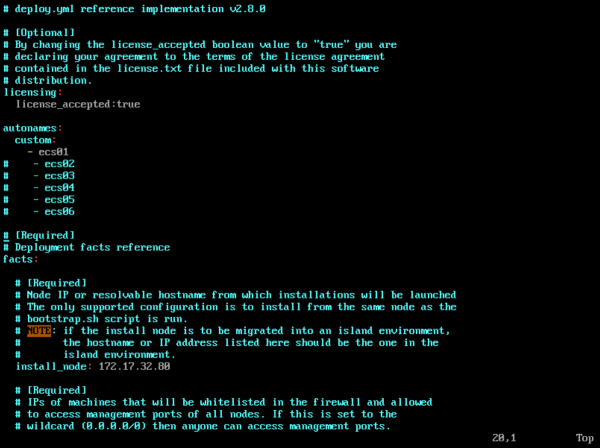
Så, vi gör vim ECS-CommunityEdition/deploy.xml och gör optimalt-minimala ändringar så att ECS slås på och fungerar. Lista över parametrar kan kortas ner, men jag gjorde det så här:
- licensed_accepted: true Du kan låta det stå som det är, då kommer du i klartext att bli ombedd att acceptera det under distributionen och få en söt fras. Kanske är det till och med en påskägg.

- Avkommentera raderna autonames: och custom: Ange minst ett önskat namn för noden — hostname kommer att ersättas med det under installationen.
- install_node: 192.168.1.1 Ange den verkliga IP:n för noden. I vårt fall anger vi samma som i nmtui
- dns_domain: ange din domän.
- dns_servers: ange din dns.
- ntp_servers: Du kan ange valfri server. Jag tog den första som dök upp från poolen 0.pool.ntp.org (den blev 91.216.168.42)
- autonaming: custom Om den inte avkommenteras kommer månen att kallas Luna.
- ecs_block_devices:
/dev/sdb
Av någon okänd anledning kan här dyka upp en icke-existerande blockenhet /dev/vda - storage_pools:
members:
192.168.1.1 Här anger vi återigen den verkliga IP-adressen för noden - ecs_block_devices:
/dev/sdb Повторяем операцию вырезания несуществующих устройств.

Hela filen är faktiskt mycket välbeskriven i , men vem läser det under dessa oroliga tider. Där står det att det minimi- och tillräckliga är att ange IP och mask, men i mitt labb fungerade det här setet dåligt, så jag var tvungen att utöka det till ovan angivet.
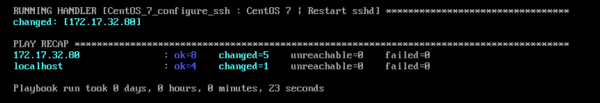
Efter att ha lämnat redigeraren måste du köra update_deploy /home/admin/ECS-CommunityEdition/deploy.yml, och om allt görs korrekt kommer det att meddelas tydligt.
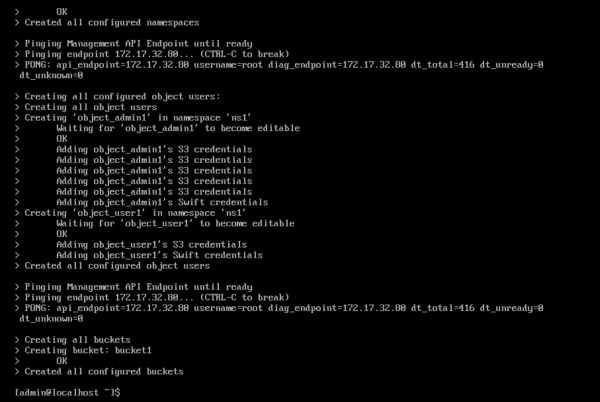
Därefter måste du tills vidare köra videploy, vänta på att miljön ska uppdateras, och du kan starta installationen med kommandot ova-step1, och efter att den har slutförts framgångsrikt köra kommandot ova-step2. Viktigt: stäng inte av skripten manuellt! Vissa steg kan ta betydande tid, utföras inte på första försöket och se ut som om något har gått fel. I vilket fall som helst måste du vänta på att skriptet ska avslutas naturligt. I slutet bör du se ett meddelande som ungefär ser ut så här.
Nu kan vi äntligen öppna WebUI-panelen via den kända IP-adressen. Om du inte ändrade något under konfigurationen blir det standardkonto root/ChangeMe. Du kan till och med börja använda vårt S3-kompatibla lagringsutrymme. Det är tillgängligt på portar 9020 för HTTP och 9021 för HTTPS. Återigen, om inget har ändrats, så är access_key: object_admin1 och secret_key: ChangeMeChangeMeChangeMeChangeMeChangeMe.
Men låt oss inte skynda oss för mycket och börja från början.
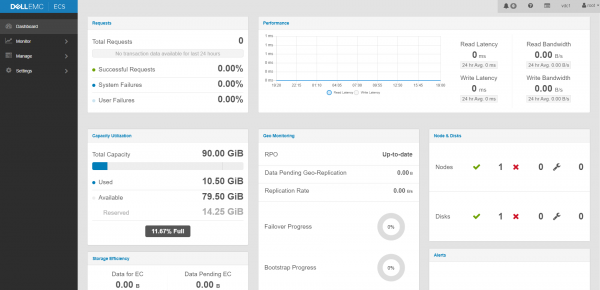
Vid första inloggningen tvingas du att byta lösenord till ett mer rimligt, vilket är helt korrekt. Huvuddashboarden är mycket intuitiv, så låt oss göra något mer intressant än att förklara uppenbara mätvärden. Till exempel, låt oss skapa en användare som vi kommer att använda för åtkomst till lagringsutrymmet. Inom serviceleverantörernas värld kallas sådana för tenant. Detta görs i Manage > Users > New Object User
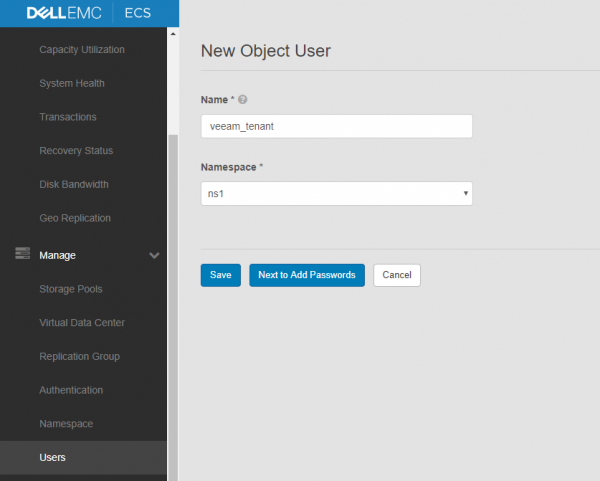
Vid skapandet av användaren ombeds vi att ange ett namespace. Tekniskt sett hindrar inget oss från att skapa så många som det finns användare. Och vice versa. Detta gör det möjligt att hantera resurser oberoende för varje tenant.
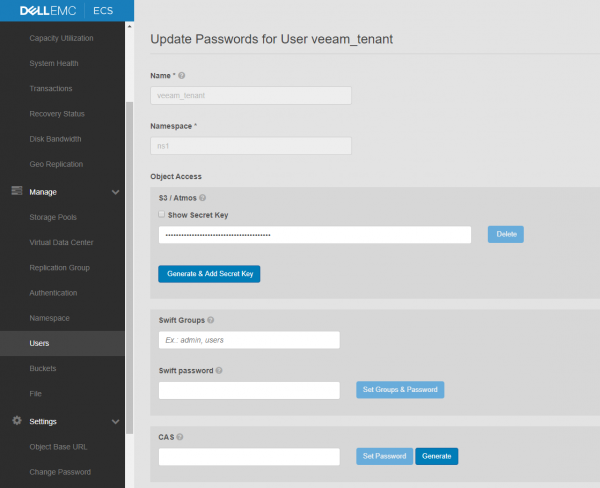
Välj de funktioner vi behöver och generera användarnycklar. S3/Atmos räcker för mig. Glöm inte att spara nyckeln 😉
Användaren är skapad, nu är det dags att ge den en bucket. Gå till Hantera > Bucket och fyll i de nödvändiga fälten. Det här är enkelt.
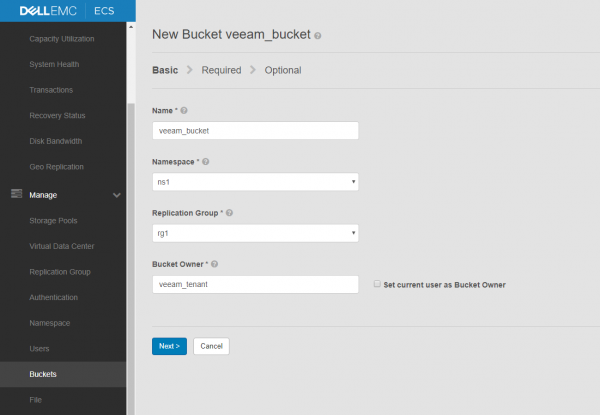
Nu är vi redo för ett fullt fungerande användande av vårt S3-lagring.
Konfigurera Veeam
Som vi minns är en av de viktigaste användningarna av objektlagring långsiktig lagring av information som sällan nås. Ett perfekt exempel är behovet av att lagra backuper på en avlägsen plats. I Veeam Backup & Replication kallas denna funktion för Capacity Tier.
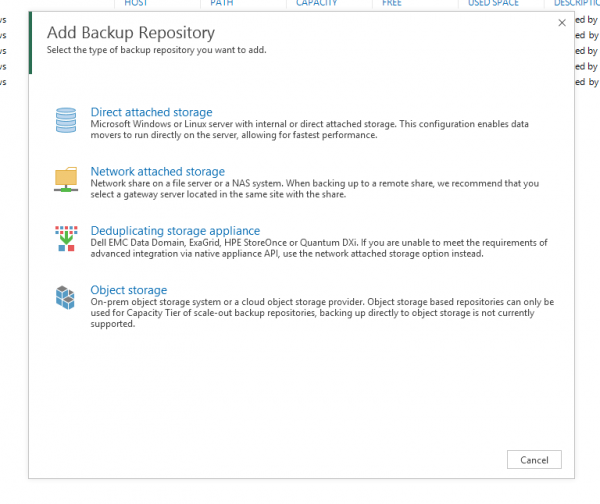
Vi börjar med att lägga till vår Dell ECS CE i Veeam-gränssnittet. Under fliken Backup Infrastructure startar vi guiden för att lägga till ett nytt lager och väljer punkten Objektlagring.
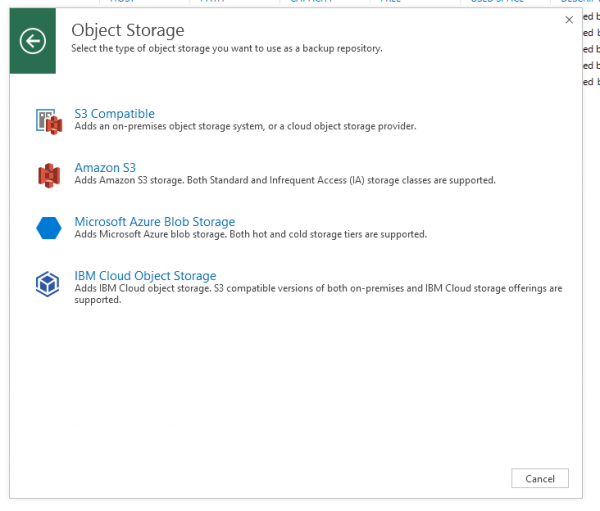
Välj det syfte som hela denna process handlar om — S3-kompatibel.
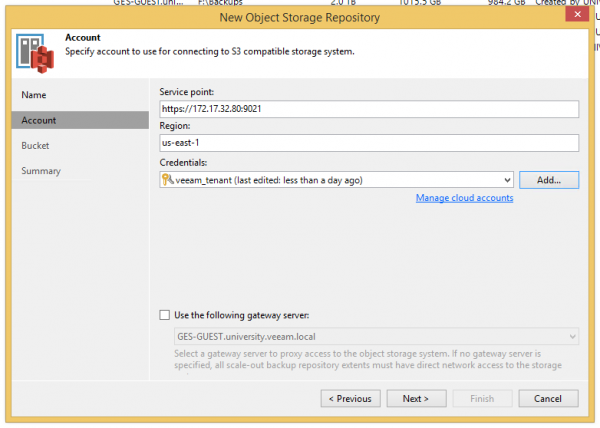
I det nya fönstret skriver vi önskat namn och går vidare till steg Konto. Här måste vi ange Service Point i form av , regionen kan lämnas som den är, och lägg till den skapade användaren. Gateway-servern är nödvändig om ditt lagringsutrymme finns på en avlägsen plats, men det är redan ett ämne för att optimera infrastrukturen och en separat artikel, så här kan vi smidigt hoppa över det.
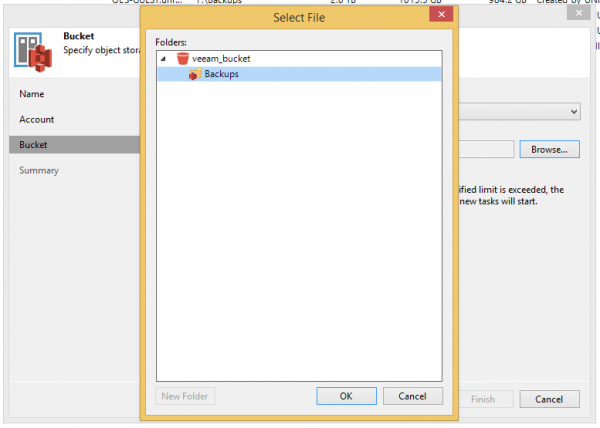
Om allt är korrekt angivet och inställt, kommer en varning om certifikatet att dyka upp och sedan fönstret med bucketen där du kan skapa en mapp för våra filer.
Följ guiden till slutet och njut av resultatet.
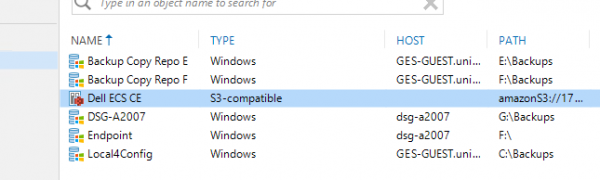
I nästa steg måste vi antingen skapa ett nytt Scale-out Backup Repository, eller lägga till vårt S3 i det befintliga — det kommer att användas som Capacity Tier för arkivlagring. Det finns inte funktionalitet för att använda S3-kompatibla lagringar direkt som ett vanligt repository i den aktuella versionen. Det finns för många ganska oklara problem som måste lösas, men allt kan hända.
Gå in i repository-inställningarna och aktivera Capacity Tier. Där är allt transparent, men det finns en intressant detalj: om du vill att all data ska skickas till objektlagringen på kortast möjliga tid, ställ in 0 dagar.
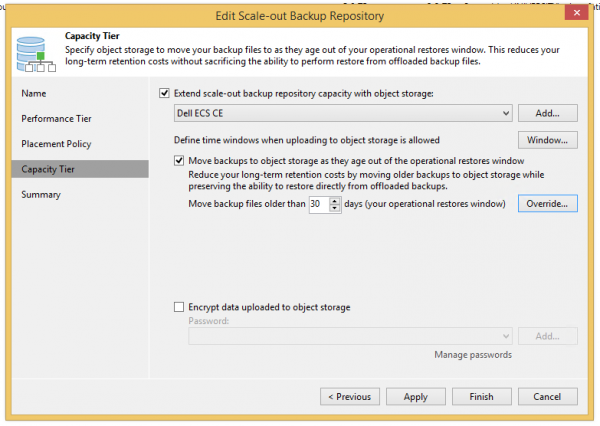
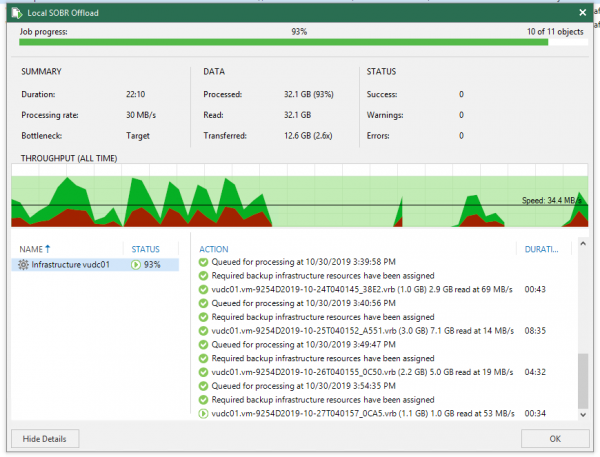
Efter att ha gått igenom guiden, om du inte vill vänta, kan du trycka ctrl+högerklick på lagret, tvinga igång Tiering-jobbet och se hur graferna börjar stiga.
Det är allt för nu. Jag anser att jag har klarat uppgiften att visa att blocklagring inte är så skrämmande som många tror. Ja, det finns en massa lösningar och alternativ, men man kan inte täcka allt i en artikel. Så låt oss dela med oss av våra erfarenheter i kommentarerna.
Källa: habr.com
