

Uppdateringsprocessen för din Kubernetes-kluster
Vid något tillfälle när du använder ett Kubernetes-kluster uppstår behovet av att uppdatera de befintliga noderna. Det kan innefatta paketuppdateringar, kärnuppdateringar eller distribution av nya virtuella maskinbilder. Inom Kubernetes-terminologi kallas detta .
Detta inlägg är en del av en serie på 4 inlägg:
- Detta inlägg.
- Korrekt avstängning av poddar i ett Kubernetes-kluster
- Fördröjd avstängning av en pod vid dess borttagning
- Hur man undviker stillestånd i ett Kubernetes-kluster med hjälp av PodDisruptionBudgets
(not. övers. översättningar av de övriga artiklarna i serien kan förväntas inom kort)
I denna artikel kommer vi att beskriva alla verktyg som Kubernetes tillhandahåller för att uppnå noll stilleståndstid för de noder som körs i ditt kluster.
Problemdefinition
Till att börja med kommer vi att använda en naiv metod för att identifiera problem och utvärdera de potentiella riskerna med denna metod och samla kunskap för att lösa varje problem vi stöter på under hela serien. Resultatet blir en konfiguration som använder lifecycle hooks, readiness probes och Pod disruption budgets för att uppnå vår noll stilleståndstid.
För att börja vår resa, låt oss ta ett konkret exempel. Antag att vi har ett Kubernetes-kluster med två noder där en applikation körs med två poddar som ligger bakom Tjänst:
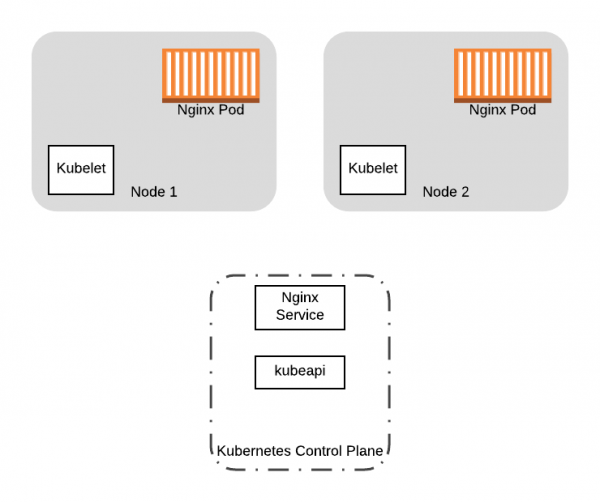
Vi börjar med två poddar med Nginx och en Tjänst som körs på våra två noder i Kubernetes-klustret.
Vi vill uppdatera kärnversionen av de två arbetsnoderna i vårt kluster. Hur gör vi det? En enkel lösning skulle vara att ladda nya noder med den uppdaterade konfigurationen och sedan stänga av de gamla noderna samtidigt som de nya startas. Även om det skulle fungera, finns det flera problem med denna metod:
- När du stänger av de gamla noderna kommer de körda poddarna på dem också att stängas av. Vad händer om poddarna behöver rensas för korrekt avstängning? Den virtualiseringssystem du använder kanske inte väntar på att rensningsprocessen ska avslutas.
- Vad händer om du stänger av alla noder samtidigt? Du kommer att få ett betydande stillestånd medan poddarna flyttar över till de nya noderna.
Vi behöver en metod för korrekt migrering av poddar från gamla noder och samtidigt vara säkra på att inga av våra arbetsflöden körs medan vi gör ändringar för noden. Eller när vi gör en fullständig ersättning av klustret, som i exemplet (det vill säga byter ut VM-bilder), vill vi överföra aktiva applikationer från gamla noder till nya. I båda fallen vill vi förhindra planering av nya poddar på gamla noder och sedan avhysa alla körande poddar från dem. För att uppnå dessa mål kan vi använda kommandot kubectl drain.
Ombalansering av alla poddar från noden
Drain-operationen möjliggör ombalansering av alla poddar från noden. Under utförandet av drain markeras noden som unschedulable (flagga NoSchedule). Detta förhindrar nya poddar från att starta på den. Drain börjar sedan avhysa poddar från noden, avslutar alla behållare som för närvarande körs på noden genom att skicka en signal TERM till behållarna i podden.
Även om kubectl drain Även om det fungerar bra för avhysning av poddar, finns det två faktorer som kan orsaka misslyckande vid utförande av drain-operationen:
- Din applikation måste kunna avslutas korrekt när den får
TERMsignalen. När poddar avhyses skickar Kubernetes en signalTERMtill behållarna och väntar på att de ska stoppa under en angiven tidsperiod, efter vilken, om de inte har stoppat, avslutas de tvingat. I alla fall, om din behållare inte hanterar signalen korrekt, kan du fortfarande stänga ner poddar på ett olämpligt sätt om de för närvarande är aktiva (till exempel om en transaktion pågår i databasen). - Du förlorar alla poddar som innehåller din applikation. Den kan vara otillgänglig vid starten av nya behållare på de nya noderna eller, om dina poddar har distribuerats utan kontroller, kanske de inte startar om överhuvudtaget.
Undvik stillestånd
För att minimera stilleståndstid vid frivilliga störningar, som vid drain-operationer för noder, erbjuder Kubernetes följande alternativ för att hantera fel:
I övriga delar av cykeln kommer vi att använda dessa Kubernetes-funktioner för att mildra konsekvenserna av flytt av poddar. För att lättare följa huvudtankegången kommer vi att använda vårt exempel ovan med följande resurskonfiguration:
---
apiVersion: apps/v1
kind: Deployment
metadata:
 name: nginx-deployment
 labels:
   app: nginx
spec:
 replicas: 2
 selector:
   matchLabels:
     app: nginx
 template:
   metadata:
     labels:
       app: nginx
   spec:
     containers:
     - name: nginx
       image: nginx:1.15
       ports:
       - containerPort: 80
---
kind: Service
apiVersion: v1
metadata:
 name: nginx-service
spec:
 selector:
   app: nginx
 ports:
 - protocol: TCP
   targetPort: 80
   port: 80
Denna konfiguration är ett minimalt exempel Deployment, som hanterar nginx-poddar i klustret. Dessutom beskriver konfigurationen en resurs Tjänst, som kan användas för att få åtkomst till nginx-poddarna i klustret.
Under hela cykeln kommer vi iterativt att utöka denna konfiguration så att den i slutänden omfattar alla funktioner som Kubernetes erbjuder för att minska stilleståndstiden.
För att få en helt implementerad och testad version av Kubernetes-klusteruppdateringar med noll stilleståndstid på AWS och andra resurser, besök .
Läs även andra artiklar i vår blogg:
Källa: habr.com
