

Utvecklingen av lagringslösningar är en lång och seriös process.
Mycket av projektets framgång beror på hur väl den objektorienterade modellen och databasstrukturen är genomtänkta från början.
Den allmänt accepterade metoden har varit och förblir olika varianter av att kombinera stjärnschemat med tredje normalformen. Som regel: källdata — 3NF, datalager — stjärna. Denna metod, som har bevisats över tid och stöds av ett stort antal studier, är det första (och ibland det enda) som kommer i åtanke för en erfaren DWH-specialist när de tänker på hur ett analytiskt datalager bör se ut.
Å andra sidan, är det vanligt att företagsbehov och kundkrav förändras snabbt, och data växer både "djupgående" och "brett". Här uppdagar den största nackdelen med stjärnan — begränsad... flexibilitet.
Och om det plötsligt i ditt lugna och bekväma liv som DWH-utvecklare:
- uppkom en uppgift att "göra något snabbt, och så ser vi senare";
- det dök upp ett snabbt växande projekt med nya datakällor som ändrar affärsmodellen minst en gång i veckan;
- det kom en kund som inte kan föreställa sig hur systemet ska se ut och vilka funktioner det ska utföra, men som är öppen för experiment och successivt klargör önskat resultat i en gradvis närmande process;
- en projektledare kom med den glädjande nyheten: "Och nu har vi Agile!"
Eller om du bara är nyfiken på hur man kan bygga lagringslösningar — välkommen under kat!
Vad betyder "flexibilitet"?
För att börja med, låt oss definiera vilka egenskaper ett system måste ha för att kunna kallas "flexibelt".
Det är värt att notera att de egenskaper som beskrivs bör relatera till system för, snarare än till utvecklingsprocessen. Därför, om du ville läsa om Agile som en utvecklingsmetodik, är det bättre att kolla in andra artiklar. Till exempel finns det på Habré massor av intressanta material (som och , såväl som ).
Det betyder inte att utvecklingsprocessen och strukturen för ett Data Warehouse (DWH) är helt orelaterade. Generellt sett borde det vara betydligt lättare att utveckla ett flexibelt datalager enligt Agile-metoden. Men i praktiken möter vi oftare situationer där utvecklingen följer mer traditionella metoder enligt Kimball eller Data Vault — enligt vattenfallsmodellen, snarare än lyckliga exempel på flexibilitet i båda dess former på ett och samma projekt.
Så, vilka möjligheter bör ett flexibelt datahanteringssystem inneha? Här kan tre punkter sammanfattas:
- Tidigare leverans och snabb vidareutveckling — det betyder att den första affärsresultatet (till exempel de första fungerande rapporterna) idealiskt ska uppnås så tidigt som möjligt, det vill säga innan systemet helt har designats och implementerats. Varje nästa vidareutveckling ska också ta så lite tid som möjligt.
- Iterativ vidareutveckling — detta betyder att varje nästa vidareutveckling i idealet inte ska påverka redan fungerande funktionalitet. Just denna punkt blir ofta den största mardrömmen i stora projekt — förr eller senare börjar enskilda objekt att få så många samband att det blir enklare att helt återskapa logiken i en kopia bredvid, än att lägga till ett fält i en befintlig tabell. Om du undrar varför analysen av påverkan av vidareutvecklingen på befintliga objekt kan ta mer tid än själva vidareutvecklingen — har du sannolikt ännu inte arbetat med stora datalager inom bank eller telekom.
- Kronisk anpassning till förändrade affärskrav — den övergripande objektstrukturen bör designas inte bara med tanke på potentiell utvidgning utan också med beräkning på att riktningen för denna nästa utvidgning kan ha varit så oväntad att du aldrig ens kunde ha drömt om den under designfasen.
Och ja, att uppfylla alla dessa krav i ett system är möjligt (naturligtvis under vissa omständigheter och med vissa förbehåll).
Nedan kommer jag att granska de två mest populära metoderna för flexibel design av datalager — Anchor-modellen och Data Vault. Det finns många fantastiska metoder som EAV, 6NF (i sin rena form) och allt som hör till NoSQL-lösningar — inte för att de skulle vara sämre, och inte ens för att artikeln i så fall skulle riskera att bli lika omfattande som en genomsnittlig avhandling. Det handlar istället om lösningar som tillhör en annan klass — antingen metoder som kan tillämpas i specifika fall oavsett den övergripande arkitekturen av ditt projekt (som EAV), eller helt andra paradigmer för datalagring (som till exempel grafdatabaser och andra NoSQL-alternativ).
Problemen med den "klassiska" metoden och deras lösningar i flexibla metoder
Med den "klassiska" metoden avser jag den gamla goda stjärnan (oavsett den specifika implementeringen av de underliggande lagren, förlåt mig Kimball-, Inmon- och CDM-anhängare).
1. Strikt kardinalitet av relationerna
Denna modell bygger på en tydlig uppdelning av data i dimensioner (Dimension) och fakta (Fact). Och det är, för sjutton, logiskt — eftersom dataanalys i de flesta fall handlar om att analysera specifika kvantitativa indikatorer (fakta) i specifika dimensioner (mätvärden).
Relationerna mellan objekten definieras som relationer mellan tabeller via en främmande nyckel. Detta verkar ganska naturligt, men leder omedelbart till den första begränsningen av flexibiliteten — den strikta definitionen av kardinaliteten av relationerna.
Det betyder att under designfasen av tabeller måste du noggrant definiera för varje par relaterade objekt om de kan relateras som många-till-många eller bara en-till-många, och "i vilken riktning". Detta påverkar direkt vilken tabell som kommer att ha primärnyckeln och vilken som kommer att ha den främmande. En förändring av detta förhållande vid nya krav kommer med stor sannolikhet att leda till en omarbetning av databasen.
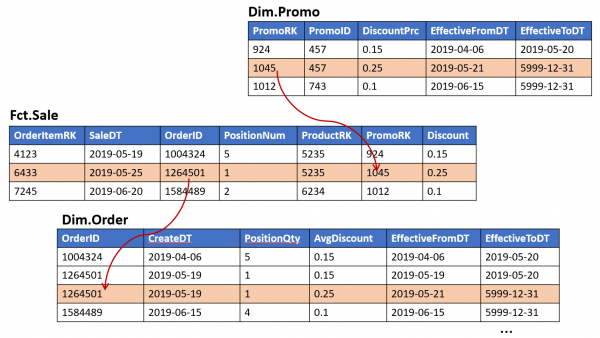
Till exempel, när du designade objektet "kassakvitto" baserat på den fastställda informationen från försäljningsavdelningen, inkluderade du möjligheten för en kampanj att gälla för flera kvitto-poster (men inte omvänt):
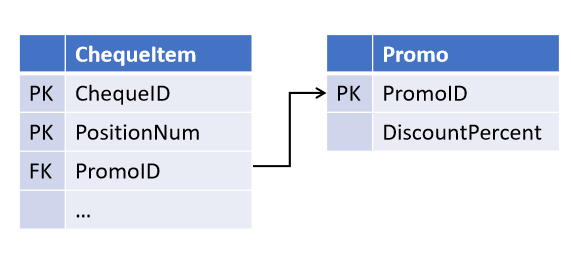
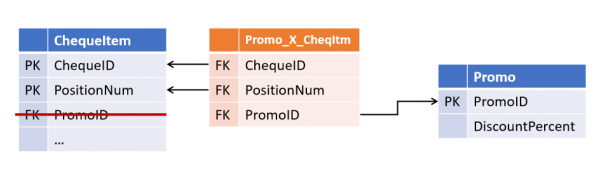
Och efter en tid införde kollegor en ny marknadsföringsstrategi där flera kampanjer kan gälla för samma post samtidigt.. Och nu måste du revidera tabellerna och separera relationen i ett eget objekt.
(Alla härledda objekt där det sker en joint check på promo behöver nu också bearbetas).
Relationer i Data Vault och Anchor Model
Att undvika en sådan situation visade sig vara ganska enkelt: man behöver inte lita på försäljningsavdelningen för detta. alla relationer bör initialt lagras i separata tabeller och behandlas som många-till-många.
Denna metod föreslogs av Dan Linstedt som en del av paradigmet Data Vault och stöddes helt av Lars Rönnbäck på Anchor Model.
Som resultat får vi den första distinkta egenskapen hos flexibla metoder:
Relationer mellan objekt lagras inte i attributen för överordnade entiteter utan representerar en skild typ av objekt.
I Data Vault Dessa relations-tabeller kallas Länk, och i Anchor Model — Tie. Vid första anblicken ser de mycket lika ut, även om deras kvaliteter inte begränsas till namnen (som kommer att diskuteras nedan). I båda arkitekturerna kan relations-tabeller koppla ihop vilket antal entiteter som helst (inte nödvändigtvis 2).
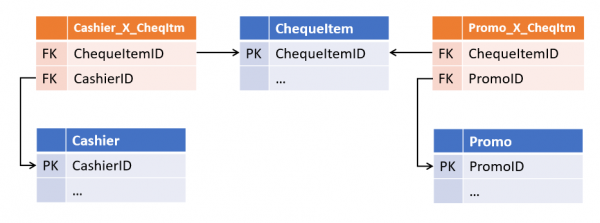
Denna till synes överflödiga struktur ger betydande flexibilitet vid anpassningar. Strukturen blir tolerant inte bara mot förändringar i kardinaliteter hos existerande relationer, utan också för att lägga till nya — om det nu skulle tillkomma en referens till kassören som hanterade kvittot, skulle tillkomsten av en sådan koppling bli en enkel överbyggnad över de befintliga tabellerna utan påverkan på några befintliga objekt och processer.
2. Duplicering av data
Det andra problemet som flexibla arkitekturer löser är mindre uppenbart och är främst karakteristiskt för mått av typ SCD2 (långsamt föränderliga mått av den andra typen), även om det inte bara gäller dem.
I ett klassiskt datalager representerar ett mått vanligtvis en tabell som innehåller en surrogatnyckel (som PK) samt en uppsättning affärsnycklar och attribut i separata kolumner.
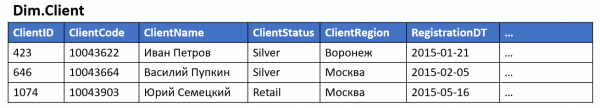
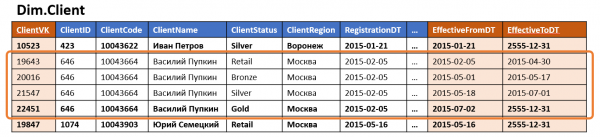
Om ett mått stöder versionshantering, läggs tidsgränser för versions giltighet till standarduppsättningen av fält, och för en rad i källan visas flera versioner i datalagret (en för varje förändring av versionsattributen).
Om en mätning innehåller minst en ofta förändrad versionsattribut kommer antalet versioner av denna mätning att bli betydande (även om övriga attribut inte är versionerade eller aldrig förändras), och om det finns flera sådana attribut kan antalet versioner växa exponentiellt i förhållande till deras antal. En sådan mätning kan ta upp ett betydande utrymme på hårddisken, även om den största delen av de lagrade uppgifterna bara är dubbletter av värden för oförändrade attribut från andra rader.
Detta innebär att det ofta även tillämpas denormalisering — en del av attributen lagras medvetet som värden istället för referenser till en referenstabell eller annan mätning. Denna metod påskyndar åtkomsten till data och minskar antalet join-operationer vid åtkomst till mätningen.
Som regel leder detta till att samma information lagras samtidigt på flera ställen. Till exempel kan information om bostadsregion och kundkategori lagras samtidigt i mätningarna "Kund" samt fakta "Köp", "Leverans" och "Kontaktsamtal", samt i kopplingstabellen "Kund - Kundchef".
Generellt sett gäller det ovanstående även för vanliga (icke-versionerade) mätningar, men det kan ha en annan skala för versionerade: införandet av en ny version av ett objekt (särskilt retroaktivt) leder inte bara till en uppdatering av alla relaterade tabeller, utan till en kaskad av nya versioner av relaterade objekt — när Tabell 1 används för att bygga Tabell 2, och Tabell 2 används för att bygga Tabell 3 etc. Även om inget attribut i Tabell 1 deltar i byggandet av Tabell 3 (utan andra attribut i Tabell 2 som kommer från andra källor), kommer ett versionsuppdatering av denna struktur åtminstone att leda till ytterligare overheadkostnader, och som mest till onödiga versioner i Tabell 3, som här överhuvudtaget inte har något med saken att göra, och så vidare i kedjan.
3. Icke-linjär komplexitet i modifieringar
Samtidigt ökar varje ny vy som byggs på grundval av en annan antalet ställen där datan kan "skiljas" vid ändringar i ETL. Detta leder i sin tur till en ökning av komplexiteten (och varaktigheten) av varje nästa modifiering.
Om det ovanstående gäller system med sällan ändrade ETL-processer kan man leva i en sådan paradigm – det räcker med att se till att nya ändringar korrekt införlivas i alla relaterade objekt. Om ändringar däremot sker ofta ökar risken för att man av misstag "missar" flera kopplingar avsevärt.
Om man dessutom tar hänsyn till att "versions" ETL är betydligt mer komplicerat än "icke-versions", blir det ganska svårt att undvika misstag vid frekvent modifiering av hela detta system.
Lagring av objekt och attribut i Data Vault och Anchor Model
Den föreslagna metoden av författarna till flexibla arkitekturer kan formuleras så här:
Det är nödvändigt att separera det som förändras från det som förblir oförändrat. Det vill säga att lagra nycklar separat från attribut.
Samtidigt ska man inte blanda ihop icke-versionerad attribut med oförändrad: den första lagrar ingen historik över sina förändringar men kan förändras (till exempel vid korrigering av inmatningsfel eller vid mottagande av nya data), den andra förändras aldrig.
Åsikterna om vad som kan anses som oförändrat i Data Vault och Anchor-modellen skiljer sig.
Ur arkitekturens perspektiv Data Vault, kan man betrakta hela uppsättningen av nycklar – naturliga (organisationsnummer, varukod i källsystemet etc.) och surrogatnycklar. Samtidigt kan övriga attribut delas in i grupper efter källa och/eller frekvens av förändringar och för varje grupp upprätta en separat tabell med en oberoende uppsättning versioner.
I Anchor Model-paradigmet anses däremot oförändrad endast surrogatnyckeln för entiteten. Allt annat (inklusive naturliga nycklar) är helt enkelt ett särskilt fall av dess attribut. Dessutom är alla attribut som standard oberoende av varandra , därför bör enseparat tabell skapas Tabeller som innehåller entitetsnycklar kallas.
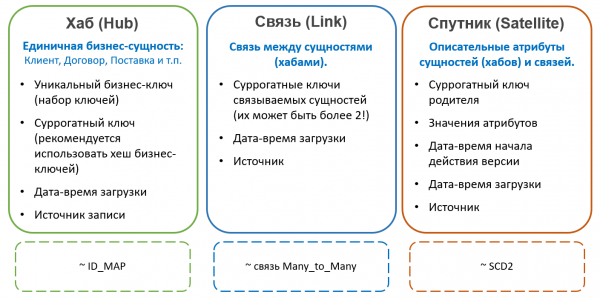
I Data Vault Hubbar (Hub) . Hubbar innehåller alltid ett fast antal fält:Naturliga nycklar för entiteten
- Surrogatnyckel
- Länk till källan
- Tid för inläggning av posten
- Poster i Hubbar
ändras aldrig och har inga versioner. никогда не изменяются и не имеют версий. Externt liknar hubs tabeller av typen ID-map, använd i vissa system för att generera surrogater, men i Data Vault rekommenderas att använda en hash av en uppsättning affärsnycklar istället för heltalsssekvenser som surrogater. Denna metod förenklar inläsning av relationer och attribut från källor (det behövs ingen join på hubben för att få surrogatet, man räcker med att beräkna hash av den naturliga nyckeln), men kan leda till andra problem (kopplade till till exempel kollisioner, stora och små bokstäver och icke-tryckbara tecken i strängnycklar etc.), och är därför inte allmänt accepterad.
Alla andra attribut för entiteter lagras i speciella tabeller, kallade Satelliter (Satellit). En hub kan ha flera satelliter som lagrar olika uppsättningar attribut.
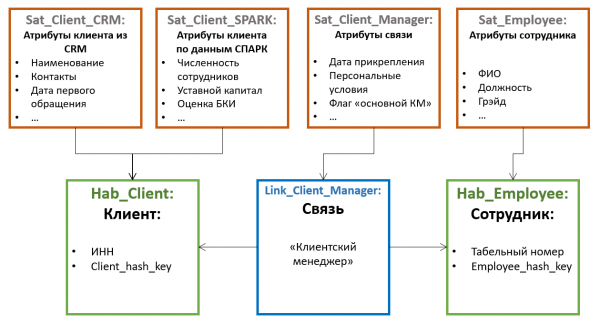
Fördelning av attribut bland satelliter sker enligt principen gemensam förändring — i en satellit kan attribut som inte är versionshanterade (till exempel födelsedatum och personnummer för en fysisk person) lagras, i en annan sällan förändrade versionshanterade (till exempel efternamn och passnummer), och i en tredje ofta förändrade (till exempel leveransadress, kategori, datum för senaste beställning etc.). Versionshantering sker på nivån av individuella satelliter, inte på entiteten som helhet, därför är det rimligt att distribuera attribut så att överlappning av versioner inom en satellit är minimal (vilket minskar det totala antalet lagrade versioner).
Dessutom, för att optimera datainläsningsprocessen, flyttas ofta attribut som erhålls från olika källor till separata satelliter.
Satelliter kopplas till hubben via en utländsk nyckel (vilket motsvarar en kardinalitet 1-till-många). Det innebär att multipla värden av attribut (till exempel flera kontakttelefonnummer för en kund) stöds av denna arkitektur “per standard”.
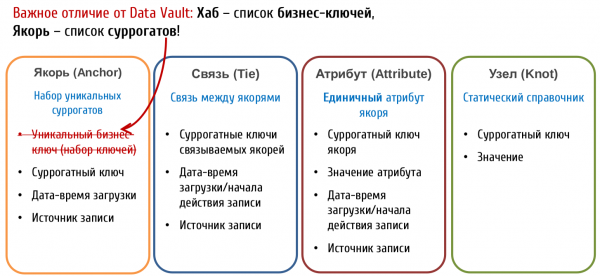
I Ankarmodell (Anchor Model) tabeller som lagrar nycklar kallas Ankarpunkter (Anchor). Och de lagrar:
- Endast surrogatnycklar
- Tid för inläggning av posten
- Poster i Hubbar
Naturliga nycklar betraktas enligt Ankarmodellen som vanliga attribut. Denna variant kan verka mer komplex att förstå, men den ger mycket större utrymme för identifiering av objekt.
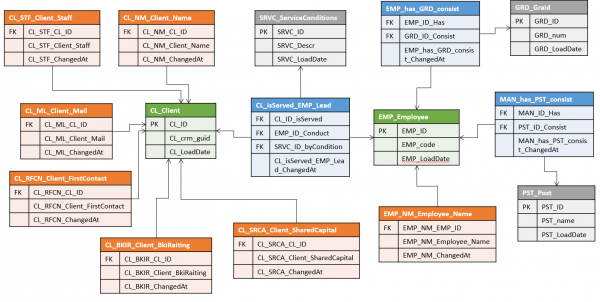
Till exempel, om uppgifter om samma entitet kan komma från olika system, där var och en använder sin egen naturliga nyckel. I Data Vault kan detta leda till ganska komplicerade konstruktioner av flera hubbar (en per källa + en sammanfogande masterversion), medan i Ankarmodellen hamnar den naturliga nyckeln från varje källa i sin egen attribut och kan användas vid inläsning oberoende av alla andra.
Men här finns också en listig detalj: om en entitet samlar attribut från olika system, finns det troligen vissa regler för "sammanfogning", enligt vilka systemet måste förstå att poster från olika källor motsvarar en och samma instans av entiteten.
I Data Vault Dessa regler kommer troligen att bestämma utformningen av en "surrogathubb" för masterentiteten och påverka Hubbarna som lagrar de naturliga nycklarna från källorna och deras ursprungliga attribut. Om reglerna för sammanfogning ändras vid något tillfälle (eller om det kommer en uppdatering av attributen som de baseras på), räcker det att omforma surrogat-hubbarna.
I Ankarmodellen kommer däremot troligen att lagra en sådan entitet i en enda ankar.. Det betyder att alla attribut, oavsett vilken källa de kommer från, kommer att knytas till samma surrogat. Att separera felaktigt sammanfogade poster och övergripande följa aktuell sammanfogning i ett sådant system kan vara betydligt svårare, särskilt om reglerna är ganska komplexa och ofta ändras, och samma attribut kan komma från olika källor (även om det är absolut möjligt, eftersom varje version av attributet behåller en länk till sin källa).
I vilket fall som helst, om din system förutsätter implementering av funktionalitet för deduplicering, sammanfogning av poster och andra element i MDM, bör du särskilt noga bekanta dig med aspekterna av lagring av naturliga nycklar i flexibla metoder. Det är möjligt att den mer komplicerade konstruktionen Data Vault plötsligt visar sig vara säkrare ur perspektivet av sammanfogningens fel.
Ankarmodellen förutsätter också en ytterligare typ av objekt som kallas Knute (Knot) det handlar i grunden om en speciell degenererad typ av ankar., som kan innehålla endast en attribut. Noderna är avsedda att användas för att lagra platta register (till exempel kön, civilstånd, kundkategori osv). Till skillnad från Ankar, har Noden inga relaterade attributtabeller, och dess enda attribut (namn) lagras alltid i en tabell med nyckeln. Noder kopplas till Ankar genom sambands-tabeller (Tie) på samma sätt som ankar kopplas till varandra.
Det finns ingen entydig åsikt om användningen av Noder. Till exempel , som aktivt främjar användningen av Ankar-modellen i Ryssland, anser (inte utan grund) att för något register kan man inte med säkerhet påstå att det alltid kommer att vara statiskt och en nivå, så det är bättre att använda en fullständig Anka från början för alla objekt.
En annan viktig skillnad mellan Data Vault och Ankar-modellen är närvaron av attribut hos relationer:
I Data Vault Relationer är lika fullvärdiga objekt som Huber, och kan ha egna attribut. I Ankarmodellen Relationer används endast för att koppla samman Ankar och kan inte ha egna attribut. Denna skillnad ger väsentligt olika tillvägagångssätt för modellering fakta, vilket kommer att diskuteras vidare.
Lagring av fakta
Tidigare har vi främst pratat om modellering av dimensioner. Faktabitar är något mindre entydiga.
I Data Vault en typisk objekt för att lagra fakta är Relation (Link), vars Satelliter innehåller faktiska mått.
Denna metod verkar intuitivt förståelig. Det ger enkel åtkomst till de analyserade måtten och liknar helt klart en traditionell faktatabell (endast måtten lagras inte i själva tabellen, utan i en "grann" tabell). Men det finns också fallgropar: en av standardjusteringarna av modellen — att utvidga faktanyckeln — medför behovet av att lägga till en ny extern nyckel i Link. Och detta "krossar" i sin tur modulärheten och potentiellt leder till att andra objekt behöver justeras.
I Ankarmodellen Relationen kan inte ha egna attribut, så detta tillvägagångssätt fungerar inte — absolut alla attribut och mått måste ha koppling till en specifik anka. Slutsatsen är enkelt — för varje faktum behövs också en specifik anka.. För en del av det vi är vana att tolka som fakta kan detta verka naturligt — till exempel, köpet översätts väl till objektet “beställning” eller “kvitto”, besöket på en webbplats — till sessioner osv. Men det finns också fakta för vilka det inte är så lätt att hitta ett naturligt “objekt-bärare” — till exempel, lagersaldot vid dagens början.
Därför uppstår det inga problem med modulär design när man utvecklar faktanyckeln i Ankar-modellen (det räcker att helt enkelt lägga till en ny relation till den aktuella ankaren), men designa modellen för att visa fakta är mindre entydig, det kan dyka upp “konstgjorda” ankare som visar affärsmodellens objekt illa.
Hur flexibilitet uppnås
Den resulterande konstruktionen i båda fallen innehåller betydligt fler tabeller, än traditionell mätning. Men de kan ta upp betydligt mindre diskutrymme vid samma uppsättning versionsattribut som traditionell mätning. Ingen magi här, naturligtvis — allt handlar om normalisering. Genom att fördela attributen över Satelliter (i Data Vault) eller separata tabeller (Ankar-modell), minskar vi (eller helt utesluter) duplicering av värden för vissa attribut vid förändring av andra.
För Data Vault vinsten kommer att bero på distributionen av attributen över Satelliter, och för Ankarmodellen — är nästan direkt proportionell mot det genomsnittliga antalet versioner per mätobjekt.
Men vinsten vad gäller upptaget utrymme — är en viktig men inte den främsta fördelen med separat lagring av attribut. Tillsammans med separat lagring av relationer, gör denna metod lager till en modulär konstruktion. Det betyder att tillägg av både separata attribut och helt nya ämnesområden i en sådan modell framstår som ett tillägg till den befintliga uppsättningen objekt utan att förändra dem. Och det är just det som gör de beskrivna metoderna flexibla.
Det påminner också om övergången från styckeproduktion till massproduktion — om det i det traditionella tillvägagångssättet är varje tabell i modellen unik och kräver särskild uppmärksamhet, så i flexibla metoder är det redan en uppsättning standard “detaljer”. Å ena sidan, ökar antalet tabeller, inläsnings- och urvalprocessen måste se mer komplex ut. Å andra sidan — de blir standardiserade. Det betyder att de kan vara automatiserade och hanteras av metadata. Frågan "hur ska vi lägga upp det?" vars svar tidigare kunde ta en betydande del av arbetet med att designa ändringar, står nu helt enkelt inte längre (liksom frågan om hur förändringen av modellen påverkar de pågående processerna).
Det betyder inte att analytiker i ett sådant system är helt onödiga — någon måste fortfarande arbeta igenom en uppsättning objekt med attribut och ta reda på var och hur allt detta ska laddas. Men mängden arbete, liksom sannolikheten och kostnaden för fel, minskar avsevärt. Både i analysfasen och under utvecklingen av ETL, som i stor utsträckning kan reduceras till att redigera metadata.
Den mörka sidan
Det som beskrivits ovan gör båda tillvägagångssätten verkligen flexibla, tekniska och lämpliga för iterativa förändringar. Självklart finns det också en "fat av tjära" som ni säkert redan misstänker.
Data dekomposition, som är grunden för modulära flexibla arkitekturer, leder till en ökning av antalet tabeller och därmed överheadkostnader för join-operationer vid urval. För att helt enkelt få alla attribut av en dimension räcker det med en enkel select i en klassisk datalager, medan en flexibel arkitektur kräver flera joins. Om för rapporterna kan alla dessa joins skrivas i förväg, kommer analytiker som är vana vid att skriva SQL för hand att drabbas dubbelt.
Det finns flera fakta som underlättar en sådan situation:
Vid arbete med stora dimensioner används nästan aldrig alla dess attribut samtidigt. Det betyder att antalet joins kan vara färre än vad som verkar vid första ögonkastet på modellen. I Data Vault kan man också ta hänsyn till den förväntade frekvensen av gemensam användning vid fördelning av attribut över satelliter. Själva Hubbarna eller Ankrarna behövs främst för att generera och mappa surrogat i inläsningsfasen och används sällan i frågor (särskilt gäller detta Ankrarna).
Alla joins — på nyckeln. Dessutom minskar en mer "komprimerad" lagringsmetod overheadkostnaderna för tabellskanning där det är nödvändigt (till exempel vid filtrering efter attributvärde). Detta kan leda till att en fråga från en normaliserad databas med många joins kan vara snabbare än att skanna en tung dimension med många versioner per rad.
Till exempel, denna artikel innehåller ett detaljerat jämförande prestandatest av Anchor-modellen med en fråga från en tabell.
Mycket beror på motorn. Många moderna plattformar har interna mekanismer för att optimera joins. Till exempel kan MS SQL och Oracle "hoppa över" joins på tabeller om deras data inte används någonstans, förutom av andra joins och inte påverkar den slutliga frågan (table/join elimination), medan MPP Vertica, enligt visade sig vara en utmärkt motor för Anchor-modellen med viss manuell planoptimering. Å andra sidan verkar det inte vara en särskilt bra idé att lagra Anchor-modellen på Click House, som har begränsat stöd för joins.
Dessutom finns det särskilda tekniker, som underlättar datåtkomst (både ur perspektivet av förfrågningsprestanda och för slutanvändare). Till exempel, Point-In-Time tabeller i Data Vault eller speciella tabellfunktioner i Anchor-modellen.
Sammanfattningsvis
Huvudpoängen med de flexibla arkitekturer som diskuterats är deras modulära "konstruktioner".
Just denna egenskap gör det möjligt att:
- Efter en viss initial förberedelse, relaterad till distributionsmetadata och skrivning av grundläggande ETL-algoritmer, snabbt tillhandahålla kunden det första resultatet i form av några rapporter som innehåller data från bara några källobjekt. Det är inte nödvändigt att fullständigt tänka igenom (även på övergripande nivå) hela objektmodellen för detta.
- Datamodellen kan börja fungera (och ge fördelar) med bara 2-3 objekt, och sedan gradvis växa (relaterat till Anchor-modellen använde Nikolaj De flesta förbättringar, inklusive utvidgning av ämnesområdet och tillägg av nya källor
- berör inte den befintliga funktionaliteten och innebär ingen risk att något befintligt går sönder. не затрагивает существующий функционал и не вызывает опасность сломать что-то уже работающее.
- Genom att dekomponera i standardkomponenter ser ETL-processer i sådana system likadana ut, deras skrivande kan algoritmiseras och i slutändan, automatiseras.
Priset för denna flexibilitet är prestanda. Det betyder inte att det är omöjligt att uppnå acceptabel prestanda med sådana modeller. Oftast kan det bara krävas mer ansträngning och uppmärksamhet på detaljer för att nå de önskade metrikerna.
Applikationer
Entitetstyper Data Vault
Läs mer om Data Vault:
Entitetstyper oförändrad
Läs mer om Anchor Model:
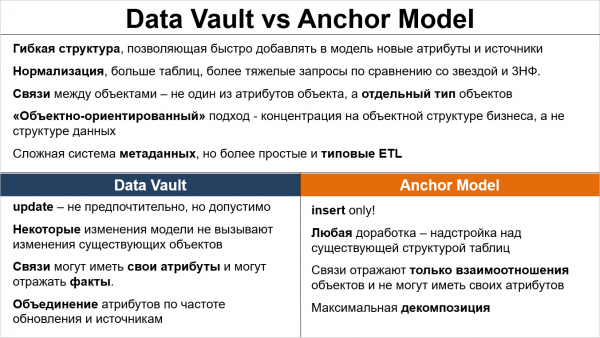
Sammanfattande tabell med gemensamma drag och skillnader mellan de granskade tillvägagångssätten:
Källa: habr.com
