

Aloha, folk! Jag heter Oleg Anastasyev, och jag arbetar i Odnoklassniki i plattformsteamet. Utöver mig finns det massor av hårdvara i Odnoklassniki. Vi har fyra datacenter, och i dem finns det cirka 500 rack med mer än 8000 servrar. Vid en viss tidpunkt insåg vi att implementeringen av ett nytt hanteringssystem skulle låta oss utnyttja tekniken mer effektivt, underlätta åtkomsthantering, automatisera (om)fördelning av beräkningsresurser, påskynda lanseringen av nya tjänster och öka reaktionshastigheten vid stora haverier.
Vad blev resultatet av detta?
Förutom mig och massor av hårdvara finns det också människor som arbetar med dessa maskiner: ingenjörer som är direkt i datacentren; nätverkstekniker som konfigurerar nätverkslösningarna; administratörer eller SRE som ser till att infrastrukturen är fel-tolerant; och team av utvecklare, där varje team ansvarar för en del av portalens funktioner. Programvaran de skapar fungerar ungefär så här:
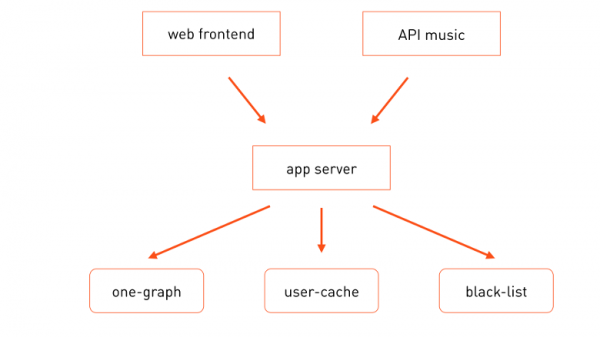
Användarförfrågningar kommer både till fronten av den huvudsakliga portalen , såväl som till andra, till exempel till API:ets musikfronter. För att bearbeta affärslogik anropar de applikationsservern, som vid behandling av förfrågningar anropar nödvändiga specialiserade mikrotjänster — one-graph (graf över sociala relationer), user-cache (cache för användarprofiler) och så vidare.
Varje av dessa tjänster är distribuerade över många maskiner, och var och en har ansvariga utvecklare som ansvarar för driften av modulerna, deras underhåll och teknologisk utveckling. Alla dessa tjänster körs på fysiska servrar, och fram till nyligen körde vi exakt en uppgift på varje server, dvs. den var specialiserad för en specifik uppgift.
Varför så? Denna strategi hade flera fördelar:
- Det underlättar massförvaltning. Anta att en uppgift kräver vissa bibliotek, vissa inställningar. Då kopplas servern just till en viss grupp, och en policy för cfengine beskriver denna grupp (eller så är den redan beskriven), och denna konfiguration distribueras centralt och automatiskt till alla servrar i den gruppen.
- Det förenklar diagnostik. Anta att du tittar på en ökad belastning på centralprocessorn och inser att denna belastning endast kan ha orsakats av den uppgift som körs på den här kraftfulla processorn. Att finna den skyldige går väldigt snabbt.
- Det förenklar övervakning. Om det är något fel med servern meddelar monitorn detta, och du vet exakt vem som är skyldig.
En tjänst som består av flera repliker tilldelas flera servrar – en för varje. Då tilldelas beräkningsresursen för tjänsten väldigt enkelt: så många servrar som tjänsten har, så mycket resurser kan den maximalt konsumera. "Enkelt" här betyder inte att det är lätt att använda, utan att resursfördelningen sker manuellt.
Denna metod tillät oss också att skapa specialiserade hårdvarukonfigurationer för uppgiften som körs på denna server. Om uppgiften lagrar stora datamängder, använder vi en 4U-server med chassi för 38 diskar. Om uppgiften är rent beräkningsmässig kan vi köpa en billigare 1U-server. Detta är effektivt sett till beräkningsresurser. Denna metod tillåter oss också att använda fyra gånger färre maskiner vid en belastning jämförbar med ett av våra vänliga sociala nätverk.
Denna effektivitet i användningen av beräkningsresurser bör också ge ekonomisk effektivitet, om man utgår från antagandet att det dyraste är servrar. Under lång tid var hårdvara det dyraste, och vi har lagt ner mycket energi på att minska kostnaden för hårdvara genom att utveckla algoritmer för att säkerställa redundans och minska kraven på hårdvarans tillförlitlighet. Idag har vi nått en punkt där serverpriserna inte längre är avgörande. Om vi inte räknar med den senaste exoteran, spelar den specifika konfigurationen av servrar i en rack ingen roll. Nu har vi ett annat problem – kostnaden för den plats servern upptar i datacentret, dvs. platsen i rack.
När vi insåg detta beslutade vi att räkna på hur effektivt vi använder racken.
Vi tog priset för den mest kraftfulla servern som är ekonomiskt motiverad, beräknade hur många sådana servrar vi kan placera i rack, vilka uppgifter vi skulle köra på dem baserat på den gamla modellen 'en server = en uppgift' och hur effektivt utrustningen skulle kunna använda sådana uppgifter. Det visade sig att vår rackanvändning är cirka 11 %. Slutsatsen är uppenbar: vi måste öka effektiviteten i datacenteranvändningen. Det skulle tyckas att lösningen är självklart: man bör köra flera uppgifter på en och samma server. Men här börjar svårigheterna.
Masskonfigurationen blir plötsligt mycket mer komplicerad - nu går det inte att tilldela en server till en specifik grupp. Eftersom det nu kan köras flera uppgifter från olika team på en och samma server. Dessutom kan konfigurationen vara konfliktfylld för olika applikationer. Diagnostiken blir också mer komplicerad: om du ser ökad processor- eller diskförbrukning på servern, vet du inte vilken av uppgifterna som orsakar problemen.
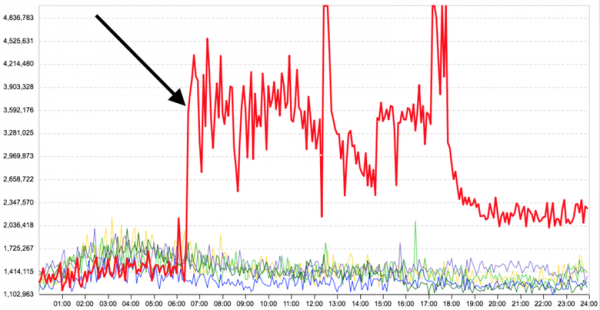
Men det främsta problemet är att det inte finns någon isolering mellan uppgifter som körs på samma maskin. Här är till exempel grafen över genomsnittlig svarstid för en serveruppgift före och efter att ett annat, helt orelaterat beräkningsprogram har körts på samma server - svarstiden för den primära uppgiften ökade kraftigt.
Det är uppenbart att uppgifter antingen måste köras i containrar eller virtuella maskiner. Eftersom nästan alla våra uppgifter körs under en och samma OS (Linux) eller anpassas för den, behöver vi inte stödja många olika operativsystem. Därför behövs inte virtualisering, och på grund av de extra kostnaderna kommer den att vara mindre effektiv än containrar.
Som en implementation av containrar för att köra uppgifter direkt på servrar är Docker en bra kandidat: filsystemavbilder löser bra problem med konfliktande konfigurationer. Det faktum att avbilder kan bestå av flera lager gör att vi kraftigt kan minska mängden data som krävs för att distribuera dem på infrastrukturen, genom att separera gemensamma delar i egna baslager. Då kommer de grundläggande (och mest omfattande) lagren att cachas snabbt på hela infrastrukturen, och för att leverera många olika typer av applikationer och versioner behövs endast små lager av överföring.
Dessutom ger den färdiga registratorn och taggningen av avbilder i Docker oss färdiga primitiva för versionering och leverans av kod till produktion.
Docker, precis som vilken annan liknande teknologi som helst, ger oss en viss nivå av isolering för containrar direkt ur lådan. Till exempel, minnesisolering — varje container får en gräns för hur mycket minne den kan använda, som inte får överskridas. Det går också att isolera containrar baserat på CPU-användning. För oss var dock den standardiserade isoleringen otillräcklig. Men mer om det nedan.
Att direkt köra containrar på servrar är bara en del av problemen. En annan del handlar om att placera containrar på servrar. Vi måste förstå vilken container som kan placeras på vilken server. Det är ingen enkel uppgift, eftersom containrar måste placeras så tätt som möjligt på servrarna utan att sänka hastigheten på deras arbete. Sådan placering kan vara komplex och ur perspektivet av fel tolerans. Ofta vill vi placera repliker av samma tjänst i olika ställ och till och med i olika hallar i datacentret, för att vi inte ska förlora alla repliker av tjänsten vid ett fel.
Att distribuera containrar manuellt är inget alternativ när du har 8000 servrar och 8000–16000 containrar.
Dessutom ville vi ge utvecklarna mer självständighet i resursfördelningen, så att de kan placera sina tjänster i produktion själva, utan administratörens hjälp. Samtidigt ville vi behålla kontrollen, så att ingen sekundär tjänst konsumerar alla resurser i våra datacenter.
Det är uppenbart att vi behöver ett hanteringslager som automatiskt skulle hantera detta.
Här har vi kommit till en enkel och tydlig bild som alla arkitekter älskar: tre rutor.
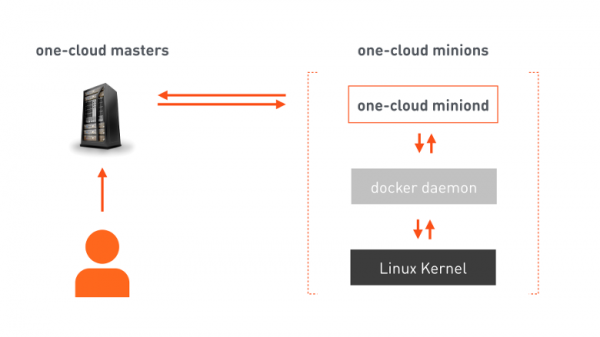
one-cloud-mästare — en redundanskluster som ansvarar för orkestrering av molnet. Utvecklaren skickar en manifest till mästaren, som innehåller all nödvändig information för att placera tjänsten. Mästaren ger order till de valda minionerna (maskiner som är avsedda att köra behållare) baserat på denna information. På minionerna finns vår agent, som tar emot order, ger sina egna order till Docker, och Docker konfigurerar Linux-kärnan för att köra den relevanta behållaren. Förutom att utföra kommandon, rapporterar agenten kontinuerligt till mästaren om statusändringar för både minionmaskinen och de behållare som körs på den.
Resursfördelning
Låt oss nu titta närmare på uppgiften med mer komplex resursfördelning för många minioner.
Beräkningsresurs i one-cloud är:
- Den beräkningskraft som en specifik uppgift använder.
- Mängden minne som är tillgänglig för uppgiften.
- Nätverkstrafik. Varje minion har ett specifikt nätverksgränssnitt med begränsad bandbredd, så uppgifter kan inte fördelas utan att ta hänsyn till den data som överförs via nätverket.
- Diskenheter. Förutom, uppenbarligen, utrymmet för uppgiftens data tilldelar vi även typ av disk: HDD eller SSD. Diskenheter kan hantera ett bestämt antal förfrågningar per sekund — IOPS. Därför, för uppgifter som genererar mer IOPS än vad en disk kan hantera, tilldelar vi även ''spindlar'' — det vill säga disk-enheter som måste reserveras specifikt för uppgiften.
Så för någon tjänst, till exempel user-cache, kan vi skriva de använda resurserna så här: 400 CPU-kärnor, 2,5 TB minne, 50 Gbit/s trafik i båda riktningarna, 6 TB utrymme på HDD, placerad på 100 spindlar. Eller i en mer bekant form enligt nedan:
alloc:
    cpu: 400
    mem: 2500
    lan_in: 50g
    lan_out: 50g
    hdd:100x6T
Resurserna för tjänsten user-cache använder endast en del av alla tillgängliga resurser i produktionsinfrastruktur. Därför vill vi se till att user-cache inte plötsligt förbrukar mer resurser än det tilldelats, varken på grund av en operatörsfel eller av annan anledning. Det vill säga att vi måste begränsa resurserna. Men vad skulle vi kunna knyta kvoten till?
Låt oss återvända till vår starkt förenklade schematiska representation av komponenternas interaktion och rita om med fler detaljer – så här:
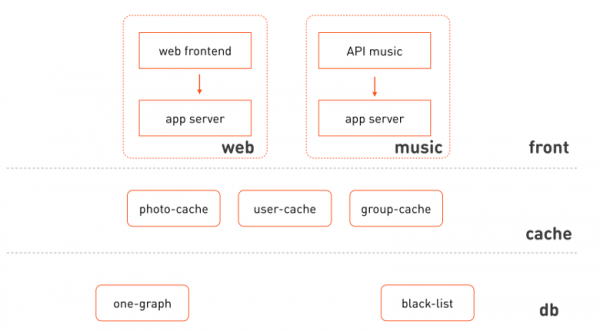
Vad som sticker ut:
- Webbfrontend och musik använder isolerade kluster av samma applikationsserver.
- Det går att särskilja logiska lager, som omfattar dessa kluster: fronter, cacher, lagrings- och datastyrningslager.
- Frontend är heterogen, det är olika funktionella delsystem.
- Cacher kan också fördelas över delsystemet vars data de cachar.
Låt oss rita om bilden igen:
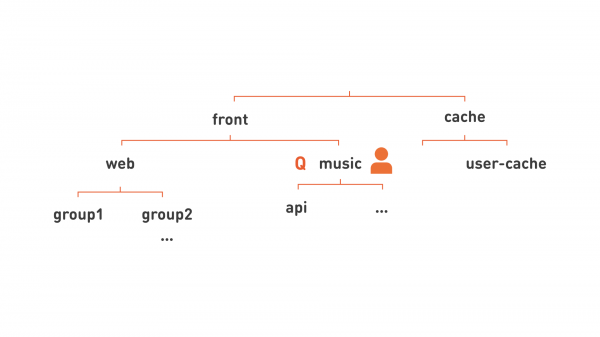
Oj! Vi ser en hierarki! Det betyder att vi kan fördela resurser i större bitar: tillsätta en ansvarig utvecklare på noden i denna hierarki, som motsvarar det funktionella delsystemet (som 'music' i bilden), och knyta en kvot till samma nivå i hierarkin. En sådan hierarki gör det också möjligt att mer flexibelt organisera tjänster för att underlätta hanteringen. Till exempel, alla web, eftersom det är en mycket stor gruppering av servrar, delar vi upp i flera mindre grupper, som visas på bilden som group1, group2.
Genom att ta bort överflödiga linjer kan vi skriva ner varje nod i vår bild mer platt: group1.web.front, api.music.front, user-cache.cache.
Så kommer vi till begreppet 'hierarkisk kö'. Den har ett namn, som 'group1.web.front'. Den tilldelas en kvot på resurser och användarrättigheter. En person från DevOps får rätt att skicka tjänsten till kön, och en sådan medarbetare kan köra något i kön, medan en person från OpsDev får administratörsrättigheter, och nu kan han hantera kön, tilldela personer dit, ge dessa personer rättigheter och så vidare. Tjänster som körs i denna kö kommer att utföras inom kökvoten. Om den beräknade kvoten för kö är otillräcklig för att köra alla tjänster samtidigt, kommer de att köras sekventiellt, och skapar därmed själva kön.
Låt oss titta närmare på tjänsterna. En tjänst har ett helt namn, vilket alltid inkluderar namnet på kön. Då kommer tjänsten webbfronten att ha namnet ok-web.group1.web.front. Och tjänsten för applikationsservern som den kontaktar kommer att kallas ok-app.group1.web.frontVarje tjänst har en manifestfil som innehåller all nödvändig information för distribution på specifika maskiner: hur mycket resurser den här uppgiften förbrukar, vilken konfiguration som krävs, hur många repliker som bör finnas, egenskaper för felhantering av denna tjänst. Efter distributionen av tjänsten på maskinerna skapas dess instanser. De namnges också entydigt — med instansnumret och tjänstens namn: 1.ok-web.group1.web.front, 2.ok-web.group1.web.front, …
Detta är mycket praktiskt: genom att bara titta på namnet på den körda containern kan vi genast ta reda på mycket.
Låt oss nu lära känna vad dessa instanser faktiskt utför: uppgifterna.
Klassificering av uppgifter
Alla uppgifter i OK (och säkerligen på andra ställen) kan delas in i grupper:
- Uppgifter med kort svarstid — prod. För sådana uppgifter och tjänster är svarstid (latens) mycket viktig; hur snabbt varje begäran hanteras av systemet. Exempel på uppgifter: webfrontend, cache, applikationsservrar, OLTP-lagring m.m.
- Beräkningsuppgifter — batch. Här är hastigheten för bearbetning av varje specifik begäran inte så viktig. Det som betyder mest är hur många beräkningar den här uppgiften gör under en viss (lång) tidsperiod (genomströmning). Detta omfattar alla MapReduce-uppgifter, Hadoop, maskininlärning, statistik.
- Bakgrundsuppgifter — idle. För dessa uppgifter är varken latens eller genomströmning särskilt viktig. Här ingår olika tester, migrationer, omberäkningar, konverteringar av data från ett format till ett annat. Å ena sidan liknar de beräkningsuppgifter, å andra sidan är det inte så viktigt hur snabbt de avslutas.
Låt oss titta på hur sådana uppgifter förbrukar resurser, till exempel centrala processorn.
Uppgifter med kort svarstid. Mönstret för CPU-förbrukning för en sådan uppgift ser ut som följande:
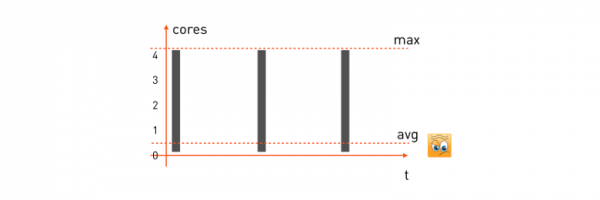
En begäran kommer in från användaren, uppgiften börjar använda alla tillgängliga CPU-kärnor, bearbetar, returnerar svaret, väntar på nästa begäran och står stilla. När nästa begäran kommer in tar vi återigen allt som finns, beräknar, och väntar på nästa.
För att garantera minimi latens för en sådan uppgift måste vi ta maximalt förbrukade resurser och reservera rätt antal kärnor på minionen (maskinen som kommer att utföra uppgiften). Då kommer formeln för reservationen för vår uppgift att bli:
alloc: cpu = 4 (max)Och om vi har en minionmaskin med 16 kärnor kan vi exakt köra fyra sådana uppgifter på den. Det är värt att notera att medelprocessorförbrukningen för sådana uppgifter ofta är mycket låg — vilket är uppenbart eftersom en stor del av tiden uppgiften väntar på förfrågan och inte gör något.
Beräkningsuppgifter. De kommer att ha ett något annat mönster:
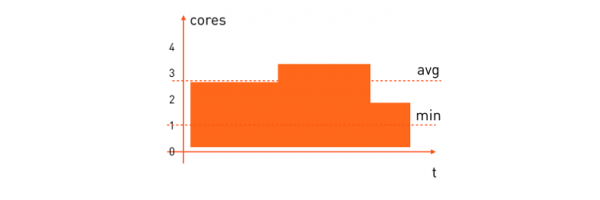
Medelresursförbrukningen för processorn för sådana uppgifter är ganska hög. Ofta vill vi att beräkningsuppgiften ska slutföras inom en viss tid, så vi måste reservera det minimiantal processorer som krävs för att hela beräkningen ska slutföras på en acceptabel tid. Formeln för reservering kommer att se ut så här:
alloc: cpu = [1,* )"Snälla placera detta på minionen där det finns åtminstone en ledig kärna, och sedan får den använda allt som finns."
Här är effektiviteten redan betydligt bättre än med uppgifter med kort försening. Men vinsten blir mycket större om man kombinerar båda typer av uppgifter på samma minionmaskin och distribuerar dess resurser dynamiskt. När en uppgift med kort försening behöver processorn — får den den omedelbart, och när resurserna inte längre behövs — överförs de till beräkningsuppgiften, det vill säga ungefär så här:
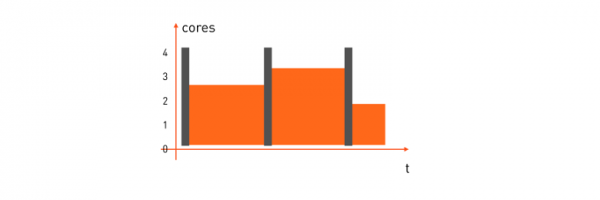
Men hur gör man detta?
Först, låt oss förstå prod och dess alloc: cpu = 4. Vi behöver reservera fyra kärnor. I Docker run kan detta göras på två sätt:
- Genom alternativet
--cpuset=1-4, det vill säga att tilldela uppgiften fyra bestämda kärnor på maskinen. - Använd
--cpuquota=400_000 --cpuperiod=100_000, tilldela en kvot för processor-tid, det vill säga att ange att varje 100 ms verklig tid får uppgiften inte konsumera mer än 400 ms processor-tid. Det blir samma fyra kärnor.
Men vilket av dessa sätt är rätt?
Cpuset ser ganska lockande ut. Om uppgiften har fyra dedikerade kärnor, betyder det att processorcacheminnet kommer att fungera maximalt effektivt. Detta har dock en bakside: vi skulle ta på oss uppgiften att fördela beräkningarna över de avlastade kärnorna istället för operativsystemet, vilket är en ganska icke-trivial uppgift, särskilt om vi försöker placera batchuppgifter på en sådan maskin. Tester har visat att en kvotvariant passar bättre här: då har operativsystemet mer frihet att välja kärna för att utföra uppgiften för stunden och processortiden fördelas mer effektivt.
Låt oss ta reda på hur man gör reservreservation i Docker för det minimiantal kärnor. En kvot för batchuppgifter är redan otillämplig, eftersom det inte är nödvändigt att begränsa ett maximum, det räcker med att garantera ett minimum. Här passar alternativet bra: docker run --cpushares.
Vi har kommit överens om att om en batch kräver garantin för minst ett kärn, anger vi --cpushares=1024, och om det behövs minst två kärnor, anger vi --cpushares=2048. Cpu shares påverkar inte fördelningen av processortid så länge det finns tillräckligt. Således, om prod för närvarande inte använder alla sina fyra kärnor — begränsar inget batchuppgifterna, och de kan använda extra processortid. Men i en situation med brist på CPU, om prod har använt alla sina fyra kärnor och nått sin kvot — kommer den återstående processortiden att delas proportionellt mellan cpushares, det vill säga i en situation med tre lediga kärnor får uppgiften med 1024 cpushares en kärna, medan de andra två får uppgiften med 2048 cpushares.
Men användning av kvota och shares är inte tillräckligt. Vi måste se till att en uppgift med kort fördröjning får prioritet över batchuppgiften vid fördelningen av processortid. Utan sådan prioritering kommer batchuppgiften att ta all processortid i det ögonblick när det behövs av prod. I Docker run finns det inga alternativ för prioritering av containrar, men CPU-schemaläggarpolicyer i Linux kommer till hjälp. Du kan läsa mer om dem , men inom ramen för denna artikel ska vi kort gå igenom dem:
- SCHED_OTHER
Får som standard alla vanliga användarprocesser på en Linux-maskin. - SCHED_BATCH
Avsedd för resurskrävande processer. När en uppgift placeras i processorn införs så kallad aktiveringsstraff: en sådan uppgift har större sannolikhet att mindre få processorns resurser om den för närvarande används av en uppgift med SCHED_OTHER. - SCHED_IDLE
En bakgrundsprocess med mycket låg prioritet, till och med lägre än nice –19. Vi använder vårt öppna källkods-bibliotek. , för att sätta nödvändig policy vid start av containern genom att kalla på
one.nio.os.Proc.sched_setscheduler(pid, Proc.SCHED_IDLE)Men även om du inte programmerar i Java kan samma sak göras med kommandot chrt:
chrt -i 0 $pidLåt oss sammanfatta alla våra isoleringsnivåer i en tabell för tydlighet:
Isoleringsklass
Exempel alloc
Docker run-alternativ
sched_setscheduler chrt*
Prod
cpu = 4
--cpuquota=400000 --cpuperiod=100000
SCHED_OTHER
Batch
Cpu = [1, * )
--cpushares=1024
SCHED_BATCH
Idle
Cpu= [2, *)
--cpushares=2048
SCHED_IDLE
*Om du kör chrt inuti containern kan du behöva capability sys_nice, eftersom Docker som standard tar bort denna capability vid start av containern.
Men uppgifter konsumerar inte bara processor, utan också trafik, vilket påverkar fördröjningen av nätverksuppgiften ännu mer än felaktig fördelning av processorresurser. Därför vill vi naturligtvis få exakt samma bild för trafiken. Det vill säga, när prod-uppgiften skickar paket till nätverket, kvoterar vi den maximala hastigheten (formel alloc: lan=[*,500mbps) ), som prod kan göra detta. För batch garanterar vi endast en minimal överföringskapacitet, men begränsar inte den maximala (formel alloc: lan=[10Mbps,*) ) I detta fall ska trafiken från prod prioriteras över batch-uppgifter.
Här har Docker inga primitiva verktyg som vi kan använda. Men vi får hjälp av . Vi lyckades uppnå önskat resultat med hjälp av disciplinen . Med den delar vi upp trafiken i två klasser: högprioriterad prod och lågt prioriterad batch/idle. Sammanfattningsvis blir konfigurationen för utgående trafik så här:
här 1:0 — "rot qdisc" för disciplinen hsfc; 1:1 — underklass hsfc med en gemensam bandbredd på 8 Gbit/s, under vilken alla underklasser av containrar placeras; 1:2 — underklass hsfc som är gemensam för alla batch- och idle-uppgifter med en "dynamisk" gräns som beskrivs nedan. Övriga underklasser av hsfc är dedikerade klasser för aktuellt körande prod-containrar med gränser som motsvarar deras manifester, — 450 och 400 Mbit/s. Varje hsfc-klass tilldelas en qdisc-kö fq eller fq_codel beroende på versionen av linux-kärnan, för att undvika paketförluster vid trafiktoppar.
Vanligtvis används tc-discipliner för att prioritera endast utgående trafik. Men vi vill även prioritera inkommande trafik — eftersom en batch-uppgift helt kan ta över hela den inkommande kanalen genom att få, till exempel, ett stort paket inkommande data för map&reduce. För detta använder vi modulen , som skapar en virtuell ifbX-gränssnitt för varje nätverksgränssnitt och omdirigerar inkommande trafik från gränssnittet till utgående på ifbX. Därefter fungerar alla de samma disciplinerna för kontroll av utgående trafik för ifbX, för vilken hsfc-konfigurationen kommer att vara mycket lik:
Under experimenten har vi fastställt att hsfc ger de bästa resultaten när klass 1:2 för icke-prioriterad batch/idle-trafik begränsas på minion-maskiner till högst en viss fri bandbredd. Annars påverkar icke-prioriterad trafik latensen för prod-uppgifter för mycket. Den aktuella fri bandbredden bestäms av miniond varje sekund genom att mäta den genomsnittliga trafikförbrukningen för alla prod-uppgifter på den aktuella minionen  och subtrahera den från bandbredden för nätverksgränssnittet
 med en liten marginal, det vill säga.

Bandbredden bestäms för inkommande och utgående trafik oberoende. I enlighet med de nya värdena återkonfigurerar miniond gränsen för den icke-prioriterade klassen 1:2.
Således har vi implementerat alla tre isoleringsklasser: prod, batch och idle. Dessa klasser påverkar kraftigt prestanda för uppgifterna. Därför har vi beslutat att placera denna egenskap högst upp i hierarkin, så att när man tittar på namnet på den hierarkiska kön kan man direkt se vad vi har att göra med:
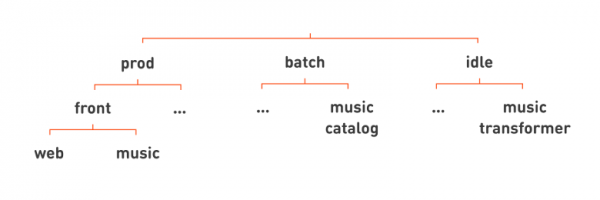
Alla våra bekanta web och music fronter placeras då i hierarkin under prod. För exempel under batch låt oss placera tjänsten music catalog, som periodiskt skapar en katalog över låtar från uppsättningen av mp3-filer som laddats upp till "Odnoklassniki". Ett exempel på en tjänst under idle kan vara music transformer, som normaliserar ljudnivån på musiken.
Genom att återigen ta bort överflödiga linjer kan vi skriva namnen på våra tjänster mer platt, genom att lägga till klass för uppgiftsisolering i slutet av tjänstens fullständiga namn: web.front.prod, catalog.music.batch, transformer.music.idle.
Och nu, när vi ser på tjänstens namn, förstår vi inte bara vilken funktion den utför, utan också dess klass för isolering, vilket betyder dess kritikalitet etc.
Allt är fantastiskt, men det finns en bitter sanning. Det är omöjligt att helt isolera uppgifter som körs på samma maskin.
Vad vi har lyckats åstadkomma: om batch intensivt förbrukar bara CPU-resurser, så fungerar Linux inbyggda CPU-scheduler mycket bra, och påverkan på prod-uppgiften är nästan obefintlig. Men om denna batch-uppgift börjar arbeta aktivt med minnet, så visar ömsesidig påverkan sig. Detta händer eftersom prod-uppgiften "tappar" processorcacheminnet — med resultatet att träffarna i cachen ökar, och processorn bearbetar prod-uppgiften långsammare. En sådan batch-uppgift kan öka latensen för vår typiska prod-container med 10%.
Att isolera trafiken är ännu svårare eftersom moderna nätverkskort har en intern kö för paket. Om ett paket från batch-uppgiften kommer in först, så skickas det först över kabeln, och det kan vi inte ändra på.
Dessutom har vi hittills bara lyckats lösa problemet med prioritering av TCP-trafik: för UDP fungerar inte strategin med hsfc. Även när det kommer till TCP-trafik, om batch-uppgiften genererar mycket trafik, ger det också omkring 10% ökning av latensen för prod-uppgiften.
Fel-tolerans
Ett av målen när vi utvecklade one-cloud var att förbättra motståndskraften hos Odnoklassniki. Därför skulle jag nu vilja titta närmare på möjliga fel- och nödsituationer. Låt oss börja med ett enkelt scenario — med ett containerfel.
En container kan misslyckas på flera sätt. Det kan vara ett experiment, en bugg eller ett fel i manifestet, vilket gör att en produktuppgift börjar konsumera fler resurser än vad som anges i manifestet. Vi hade ett fall där en utvecklare implementerade en komplicerad algoritm, omarbetade den flera gånger och förvirrade sig så mycket att uppgiften slutligen blev ganska komplex och fastnade i en loop. Eftersom produktuppgiften har högre prioritet än alla andra på samma noder, började den att konsumera alla tillgängliga processorresurser. I denna situation räddade isolering, specifikt en kvot på processoranvändningen. Om uppgiften har en kvot, kommer den inte att konsumera mer. Därför märkte batch- och andra produktuppgifter som kördes på samma maskin ingenting.
Den andra möjliga problemet är att containern kraschar. Här räddas vi av restart-policyer, som alla känner till, Docker hanterar detta utmärkt. Nästan alla produktuppgifter har en restart-policy "always". Ibland använder vi "on_failure" för batchuppgifter eller för att felsöka produktcontainrar.
Vad kan man göra när en hel nod är otillgänglig?
Självklart kan vi starta containern på en annan maskin. Det mest intressanta här är vad som händer med IP-adressen (adresserna) som tilldelas containern.
Vi kan tilldela containrar samma IP-adresser som noderna där dessa containrar körs. När containern startas på en annan maskin, ändras dess IP-adress, och alla klienter måste förstå att containern har flyttat, och nu måste de använda en annan adress, vilket kräver en separat Service Discovery-tjänst.
Service Discovery är praktiskt. Det finns många lösningar på marknaden med olika grad av felresistens för att etablera en tjänsteregister. I många sådana lösningar implementeras logik för lastbalansering, lagring av ytterligare konfiguration i form av en nyckel-värde-lager, etc.
Vi vill dock gärna undvika behovet av att införa ett separat register, eftersom det skulle innebära införandet av ett kritiskt system som används av alla tjänster i produktion. Det innebär att det är en potentiell felpunkt, och man måste välja eller utveckla en mycket felresistent lösning, vilket uppenbarligen är mycket komplicerat, tidskrävande och kostsamt.
En stor nackdel är att för att vår gamla infrastruktur ska kunna fungera med den nya måste vi omprogrammera alla uppgifter för att använda ett Service Discovery-system. Det finns EXTREMT mycket arbete, och ibland är det praktiskt taget omöjligt, särskilt när det gäller lågnivå-enheter som arbetar på OS-kärnnivå eller direkt med hårdvara. Att implementera denna funktionalitet med hjälp av etablerade lösningsmönster, som till exempel , skulle innebära extra belastning på vissa ställen, och i andra fall skulle det komplicera drift och skapa ytterligare felhanteringsscenarier. Vi ville inte komplicera saker, så vi beslutade att göra användningen av Service Discovery valfri.
I one-cloud följer IP-adressen efter containern, det vill säga varje instans av uppgiften har sin egen IP-adress. Denna adress är "statisk": den knyts till varje instans vid första gången tjänsten skickas till molnet. Om tjänsten under sin livstid har haft ett varierande antal instanser, kommer så många IP-adresser att knytas till den som det maximala antalet instanser var.
Dessa adresser ändras inte senare: de tilldelas en gång och kvarstår under hela tjänstens livstid i produktionen. IP-adresserna följer efter containrarna i nätverket. Om containern flyttas till en annan nod, följer också adressen med.
Således förändras sambandet mellan tjänstens namn och listan över dess IP-adresser mycket sällan. Om vi ser på namnen på tjänsteinstanserna som vi nämnde i början av artikeln (1.ok-web.group1.web.front.prod, 2.ok-web.group1.web.front.prod, …), kommer vi att märka att de liknar FQDN som används i DNS. Det stämmer, för att visa namnen på tjänsternas instanser i deras IP-adresser använder vi DNS-protokollet. Detta DNS returnerar även alla reserverade IP-adresser för alla containrar — både aktiva och inaktiva (antag att tre repliker används, men fem adresser är reserverade — alla fem kommer att returneras). Kunderna, efter att ha fått denna information, kommer att försöka etablera en anslutning till alla fem repliker — och på så sätt identifiera vilka som fungerar. Denna metod för tillgänglighetsbestämning är betydligt mer tillförlitlig, eftersom varken DNS eller Service Discovery är involverade, vilket eliminerar svåra problem med att säkerställa informationens aktualitet och systemens redundans. Dessutom kan vi i kritiska tjänster, som är avgörande för hela portalens funktion, helt undvika att använda DNS och istället direkt ange IP-adresser i konfigurationen.
Implementeringen av en sådan överföring av IP bakom containrarna kan vara en utmaning — och vi kommer att stanna vid hur detta fungerar i följande exempel:
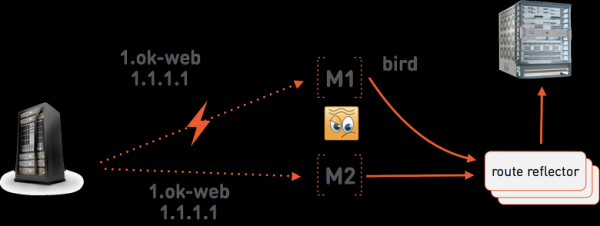
Anta att one-cloud-mästaren ger order till minion M1 att starta 1.ok-web.group1.web.front.prod med adressen 1.1.1.1. Minionen kör , som annonserar denna adress till specifika servrar . De har en BGP-session med nätverksutrustningen, som slussar vidare routen för adressen 1.1.1.1 till M1. M1 vidarebefordrar paketen inuti containern med hjälp av Linux. Det finns tre route reflectors, eftersom detta är en mycket kritisk del av one-cloud-infrastrukturen — utan dem kommer nätverket i one-cloud att sluta fungera. Vi placerar dem i olika rack, helst i olika datahallar, för att minska risken för att alla tre skulle sluta fungera samtidigt.
Låt oss nu anta att kommunikationen mellan one-cloud-mästaren och minion M1 har brutits. One-cloud-mästaren kommer nu att agera under antagandet att M1 har gått helt ner. Det vill säga, den kommer att ge order till minion M2 att starta web.group1.web.front.prod med samma IP-adress 1.1.1.1. Nu har vi två konfliktfulla rutter i nätverket för 1.1.1.1: på M1 och M2. För att lösa sådana konflikter använder vi Multi Exit Discriminator, som anges i BGP-annonsen. Detta är ett nummer som visar vikten på den annonserade rutten. Rutten med lägre MED-värde kommer att väljas av de konfliktfulla. Masten one-cloud stöder MED som en integrerad del av container-IP-adresser. Första gången skrivs adressen ut med ett tillräckligt stort MED = 1 000 000. I en situation med en nödflyttning av containern minskar masten MED, och M2 får en order att annonsera IP-adressen 1.1.1.1 med MED = 999 999. Instansen som körs på M1 kommer att förbli utan kontakt, och dess öde intresserar oss inte mycket förrän kontakten med masten återställs, då den kommer att stoppas som en gammal dubblett.
Avbrott
Alla datacenterhanteringssystem hanterar alltid mindre fel på ett acceptabelt sätt. Avbrott av en container är nästan normen överallt.
Låt oss titta på hur vi hanterar ett avbrott, till exempel strömavbrott i en eller flera hallar i datacentret.
Vad betyder ett avbrott för datacenterhanteringssystemet? Först och främst betyder det en massiv samtidigt fel av många maskiner, och systemet måste migrera ett stort antal containrar samtidigt. Men om avbrottet är mycket omfattande kan det hända att alla uppgifter inte kan omplaceras till andra noder, eftersom resurskapaciteten i datacentret faller under 100 % belastning.
Ofta åtföljs avbrott av förlust av kontrollskiktet. Detta kan ske på grund av att dess utrustning går sönder, men oftare beror det på att avbrotten inte testas, och kontrollskiktet själv kraschar på grund av ökad belastning.
Vad kan göras med allt detta?
Massaöverföringar innebär att det uppstår ett stort antal åtgärder, överföringar och placeringar i infrastrukturen. Varje överföring kan ta tid som krävs för att överföra och packa upp containerbilder till noder, starta och initiera containrar etc. Därför är det önskvärt att mer viktiga uppgifter startas före mindre viktiga.
Låt oss återigen titta på den bekanta hierarkin av tjänster och försöka avgöra vilka uppgifter vi vill köra först.
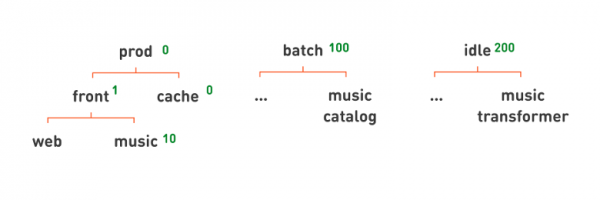
Självklart, det är de processer som direkt deltar i behandlingen av användarförfrågningar, dvs. prod. Vi anger detta med placeringsprioritet — ett nummer som kan tilldelas en kö. Om en kö har en högre prioritet placeras dess tjänster först.
På prod tilldelar vi högre prioriteringar, 0; på batch — något lägre, 100; på idle — ännu lägre, 200. Prioriteter tillämpas hierarkiskt. Alla uppgifter längre ner i hierarkin har motsvarande prioritet. Om vi vill att cache ska köras före front-end i prod, tilldelar vi prioriteten cache = 0 och front-subkön = 1. Om vi till exempel vill att huvudportalen ska starta först bland front-end, medan music front körs efteråt, kan vi tilldela den senare en lägre prioritet — 10.
Nästa problem är brist på resurser. Så, vi har haft stora utrustningsavbrott, hela hallar i datacentret, och vi har startat så många tjänster att det nu inte finns tillräckliga resurser för alla. Vi måste avgöra vilka uppgifter vi kan offra för att de viktigaste kritiska tjänsterna ska fungera.
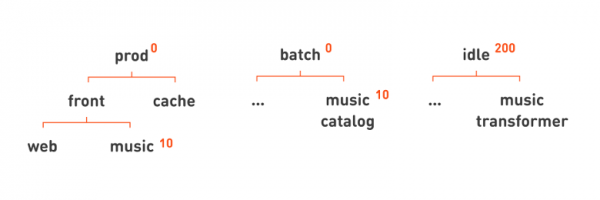
Till skillnad från placeringsprioriteten kan vi inte helt enkelt offra alla batch-uppgifter, vissa av dem är viktiga för portalen. Därför har vi särskilt identifierat utdragningsprioritet För uppgifter. Vid placering kan en uppgift med högre prioritet utdriva, dvs. stoppa en uppgift med lägre prioritet, om det inte finns några lediga minions. Om så är fallet kommer en uppgift med låg prioritet sannolikt att förbli oplacerad, dvs. det kommer inte att finnas någon lämplig minion med tillräckliga lediga resurser för den.
I vår hierarki är det mycket enkelt att ange en sådan utdragningsprioritet så att prod- och batch-uppgifter utdriver eller stoppar idle-uppgifter, men inte varandra, genom att ange en prioritet för idle som är 200. Precis som med placeringsprioritet kan vi använda vår hierarki för att beskriva mer komplexa regler. Till exempel kan vi ange att musikinnehåll offras om vi inte har tillräckliga resurser för huvudwebbportalen, genom att sätta lägre prioritet på de relevanta noderna: 10.
Hela datacentrets krascher
Varför kan hela datacentret fallera? Naturkatastrofer. Det fanns ett bra inlägg om hur . Elementet kan beskrivas som hemlösa, som en gång skadade fiberoptiken i en avloppsledning, vilket gjorde att datacentret helt förlorade kontakten med andra platser. Orsaken till haveri kan också vara mänsklig: en operatör kan ge en sådan direktiv att hela datacentret går ner. Detta kan hända på grund av allvarliga buggar. Sammanfattningsvis, datacenter kraschar - det är inte ovanligt. Det händer hos oss några gånger per år.
Och detta är vad vi gör för att ingen #överbrygga ska posta på Twitter.
Den första strategin är isolering. Varje instans av one-cloud är isolerad och kan bara hantera maskiner från ett enda datacenter. Det innebär att förlust av molnet på grund av buggar eller felaktiga kommandon från operatören - det är bara förlust av ett datacenter. Vi är förberedda för detta: det finns en reservpolicy där applikations- och datakopior placeras i alla datacenter. Vi använder hög tillgänglighet i databaserna och testar regelbundet systemfel.
Eftersom vi idag har fyra datacenter, finns det också fyra separata, helt isolerade instanser av one-cloud.
Denna metod skyddar inte bara mot fysiska fel, utan kan också skydda mot operatörsfel.
Vad mer kan göras med det mänskliga faktorn? När operatören ger molnet något konstigt eller potentiellt farligt kommando, kan de plötsligt behöva lösa en liten uppgift för att kontrollera hur noga de har tänkt. Till exempel, om det handlar om ett massavbrott av många kopior eller bara ett konstigt kommando - att minska antalet kopior eller ändra namnet på en bild i stället för bara versionsnumret i den nya manifestfilen.
Sammanfattning
Utmärkande drag av one-cloud:
- En hierarkisk och tydlig namngivningsschema för tjänster och containrar, vilket gör att man snabbt kan förstå vilken uppgift det handlar om, vad den relaterar till, hur den fungerar och vem som ansvarar för den.
- Vi tillämpar vår teknik för att kombinera prod- och batch-uppgifter på minioner för att öka effektiviteten av resursdelning. Istället för cpuset använder vi CPU-quota, shares, policyer för CPU-schemaläggning och Linux QoS.
- Att helt isolera containrar som körs på en maskin har vi inte lyckats med, men deras ömsesidiga påverkan förblir inom 20%.
- Att organisera tjänster i en hierarki hjälper vid automatiskt felavhjälpande med hjälp av placering och utstötningsprioriteter.
FAQ
Varför vi inte valde en färdig lösning.
- Olika klasser av isolering av uppgifter kräver olika logik för placering på minioner. Medan produktionsuppgifter kan placeras enkelt genom resursreservering, behöver batch och idle placeras genom att övervaka den faktiska resursutnyttjandet på maskinminionerna.
- Behov av att ta hänsyn till resurser som uppgifterna konsumerar, såsom:
- nätverksbandbredd;
- typer och "spindlar" av diskar.
- Behov av att ange prioriteringar för tjänster vid avbrott, rättigheter och kvoter för team på resurser, vilket löses med hierarkiska köer i one-cloud.
- Behov av att ha mänskliga namn för containrar för att minska reaktionstiden på avbrott och incidenter.
- Oförmåga att implementera Service Discovery överallt samtidigt; behovet av att samexistera länge med uppgifter som är placerade på fysiska värdar – vilket löses med "statisk" IP-adresser som följer containrarna, och därmed behovet av unik integration med en stor nätverksinfrastruktur.
Alla dessa funktioner skulle kräva betydande ombyggnader av de befintliga lösningarna, och efter att ha bedömt mängden arbete insåg vi att vi skulle kunna utveckla vår egen lösning med ungefär samma arbetsinsats. Men vår lösning kommer att vara mycket enklare att använda och utveckla – den har inga onödiga abstraktioner som stöder funktionalitet vi inte behöver.
Till alla som läser de sista raderna – tack för ert tålamod och uppmärksamhet!
Källa: habr.com
