

För flera månader sedan arbetade jag med implementeringen av en OpenID Connect-server för att hantera åtkomsten till hundratals av våra interna applikationer. Från egna lösningar, lämpliga för mindre skalor, gick vi över till en allmänt accepterad standard. Åtkomst genom en central tjänst förenklar monokroma operationer avsevärt, minskar kostnaderna för att implementera autentiseringar, gör det möjligt att hitta många färdiga lösningar och slipper huvudbry vid utveckling av nya. I den här artikeln kommer jag att berätta om detta steg och de misstag vi hunnit göra.
Länge sedan… Hur allt började
För flera år sedan, när antalet interna applikationer blev för stort för manuell hantering, skrev vi en applikation för att kontrollera åtkomster inom företaget. Det var en enkel Rails-applikation som kopplades till en databas med information om anställda, där åtkomsten till olika funktioner konfigurerades. Samtidigt satte vi upp vårt första SSO, som baserades på tokenkontroll från klient- och autentiseringstjänsten; token överfördes i krypterad form med flera parametrar och kontrollerades på autentiseringstjänsten. Det var inte det mest bekväma alternativet, eftersom varje intern applikation behövde beskriva ett stort lager av logik, och anställdas databaser synkroniserades inte ens med autentiseringstjänsten.
Efter en tid beslutade vi att förenkla uppgiften för centraliserad autentisering. SSO överfördes till en belastningsutjämnare. Med hjälp av OpenResty på Lua lade vi till en mall som kontrollerade tokens, visste vilken applikation begäran gick till och kunde kontrollera om det fanns åtkomst. Denna metod förenklade avsevärt hanteringen av åtkomster för interna applikationer – i koden för varje applikation behövdes inte längre extra logik beskrivas. Som ett resultat stängde vi trafiken externt, och själva applikationen visste ingenting om autentiseringen.
Men ett av problemen förblir olöst. Hur hanterar vi applikationer som behöver information om anställda? Man skulle kunna skriva en API för autentiseringstjänsten, men då skulle det krävas att man lade till extra logik för varje sådan applikation. Dessutom ville vi bli av med beroendet av en av våra egna applikationer, som planeras att bli öppen källkod, och vår interna autentiseringsserver. Mer om det senare. Lösningen på båda problemen blev OAuth.
Tillgängliga standarder
OAuth är en förståelig, allmänt accepterad standard för autentisering, men eftersom dess funktionalitet inte är tillräcklig såg vi även på OpenID Connect (OIDC). OIDC är i sig själv den tredje implementeringen av en öppen autentiseringsstandard som kompletterar OAuth 2.0-protokollet (öppen autentisering). Detta löser problemet med avsaknad av data om slutanvändaren och ger även möjlighet att byta autentiseringstjänst.
Vi valde dock inte en specifik leverantör och beslöt att integrera OIDC med vår befintliga autentiseringstjänst. Fördelarna med denna lösning var att OIDC är mycket flexibelt när det gäller autentisering av slutanvändare. På så sätt fanns möjligheten att implementera stöd för OIDC på vår nuvarande autentiseringstjänst.
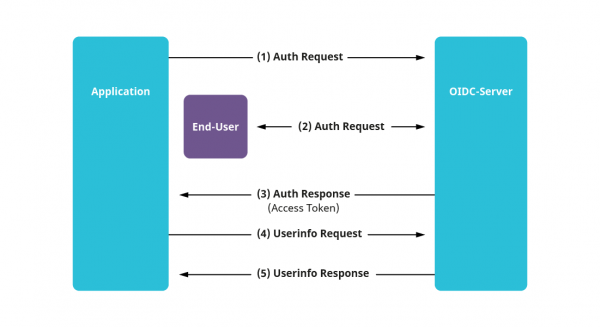
Vår väg att implementera en egen OIDC-server
1) Vi anpassade data till önskat format
För att integrera OIDC måste nuvarande data om användare anpassas till ett format som är förståeligt för standarden. Inom OIDC kallas detta Claims. Claims är i grunden de slutgiltiga fälten i databasen om användare (namn, e-post, telefon osv.). Det finns , och allt som inte ingår i denna lista betraktas som anpassat. Därför är det första att tänka på, om du väljer att använda en befintlig OIDC-leverantör, möjligheten till smidig anpassning av nya claims.
Gruppen av claims kombineras i följande undergrupp - Scope. Vid autentisering begärs åtkomst inte till specifika claims, utan just till scopes, även om vissa claims inom scopet inte behövs.
2) Vi implementerade nödvändiga grants
Den nästa delen av OIDC-integrationen handlar om att välja och implementera typer av auktorisering, de så kallade granttyperna. Beroende på vilken granttyp som väljs kommer det framtida interaktionsscenariot mellan den valda applikationen och auktoriseringsservern att variera. En ungefärlig översikt över hur man väljer rätt granttyp visas i diagrammet nedan.
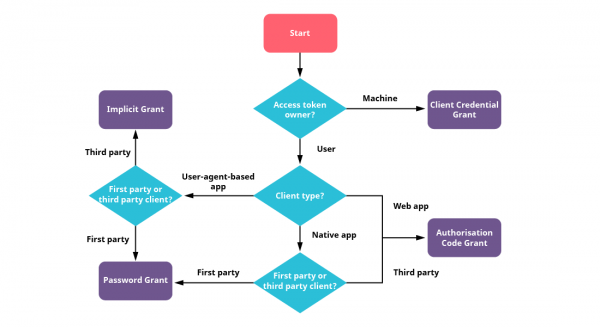
För vår första applikation använde vi den mest spridda granttypen – Authorization Code. Skillnaden mellan denna och andra är att den är trestegsbaserad, dvs. det är en ytterligare kontroll. Först begär användaren en auktorisationsbehörighet, får en token – Authorization Code, och med denna token, som en biljett för resa, begär åtkomsttokenen. Allt huvudsakligt samspel i detta auktoriseringsscenario baseras på omdirigeringar mellan applikationen och auktoriseringsservern. Du kan läsa mer om denna granttyp .
OAuth följer konceptet att åtkomsttokens som erhållits efter auktorisering ska vara tidsbegränsade och bytas helst var tionde minut. Granttypen Authorization Code är en trestegsverifiering genom omdirigeringar, och att göra detta varje tionde minut är, ärligt talat, inget behagligt inslag för ögonen. För att lösa detta problem finns det en annan granttyp – Refresh Token, som vi också använder. Här är det enklare. Under verifieringen från en annan granttyp, utfärdas det utöver huvudåtkomsttokenen också en – Refresh Token, som endast kan användas en gång och dess livslängd är vanligtvis betydligt längre. Med denna Refresh Token, när TTL (Time to Live) för huvudåtkomsttokenen har löpt ut, kommer begäran om en ny åtkomsttoken att ske mot en endpoint för en annan granttyp. Den använda Refresh Token nollställs direkt. Denna verifiering är tvåstegs och kan utföras i bakgrunden, utan att användaren märker det.
3) Vi har ställt in format för utdata av användardata
När de valda bidragen har genomförts och autentiseringen fungerar, är det värt att nämna hur man får data om den slutliga användaren. I OIDC finns det en särskild slutpunkt för detta, där man med sin aktuella åtkomsttoken, så länge den är giltig, kan begära användardata. Och om användardata inte ändras så ofta och man behöver hämta dem flera gånger, kan man komma fram till en lösning såsom JWT-token. Dessa token stöds också av standarden. En JWT-token består av tre delar: header (information om token), payload (alla nödvändiga data) och signature (token signeras av servern och kan i framtiden användas för att verifiera signaturens källa).
I OIDC-implementeringen kallas JWT-token för id_token. Den kan begäras tillsammans med den vanliga åtkomsttoken och allt som återstår är att verifiera signaturen. För detta har autentiseringstjänsten en separat slutpunkt med en uppsättning publika nycklar i formatet . Och när vi pratar om detta är det värt att nämna att det finns ytterligare en slutpunkt som, baserat på standarden , återspeglar den aktuella konfigurationen av OIDC-servern. Den innehåller alla adresser till slutpunkter (inklusive adressen för uppsättningen av publika nycklar som används för signering), stödde claims och scopes, använda krypteringsmetoder, stödde bidrag, etc.
Till exempel i Google:
{
 "issuer": "https://accounts.google.com",
 "authorization_endpoint": "https://accounts.google.com/o/oauth2/v2/auth",
 "device_authorization_endpoint": "https://oauth2.googleapis.com/device/code",
 "token_endpoint": "https://oauth2.googleapis.com/token",
 "userinfo_endpoint": "https://openidconnect.googleapis.com/v1/userinfo",
 "revocation_endpoint": "https://oauth2.googleapis.com/revoke",
 "jwks_uri": "https://www.googleapis.com/oauth2/v3/certs",
 "response_types_supported": [
  "code",
  "token",
  "id_token",
  "code token",
  "code id_token",
  "token id_token",
  "code token id_token",
  "none"
 ],
 "subject_types_supported": [
  "public"
 ],
 "id_token_signing_alg_values_supported": [
  "RS256"
 ],
 "scopes_supported": [
  "openid",
  "email",
  "profile"
 ],
 "token_endpoint_auth_methods_supported": [
  "client_secret_post",
  "client_secret_basic"
 ],
 "claims_supported": [
  "aud",
  "email",
  "email_verified",
  "exp",
  "family_name",
  "given_name",
  "iat",
  "iss",
  "locale",
  "name",
  "picture",
  "sub"
 ],
 "code_challenge_methods_supported": [
  "plain",
  "S256"
 ],
 "grant_types_supported": [
  "authorization_code",
  "refresh_token",
  "urn:ietf:params:oauth:grant-type:device_code",
  "urn:ietf:params:oauth:grant-type:jwt-bearer"
 ]
}
På så sätt kan man med hjälp av id_token överföra alla nödvändiga claims i tokenens payload utan att behöva kontakta autentiseringstjänsten varje gång för att begära användardata. Nackdelen med denna metod är att ändringar i användardata på servern inte kommer omedelbart, utan med den nya åtkomsttoken.
Sammanfattning av implementeringen
Så efter att vi implementerat vår egen OIDC-server och ställt in anslutningar till den på applikationssidan, löste vi problemet att överföra information om användare.
Eftersom OIDC är en öppen standard fick vi möjlighet att välja en befintlig leverantör eller implementera en server. Vi prövade Keycloak, som visade sig vara mycket användarvänlig för konfiguration. Efter inställning och ändring av anslutningskonfigurationerna på applikationssidan var den redo att användas. På applikationssidan återstår det bara att ändra anslutningskonfigurationer.
När det gäller befintliga lösningar
Inom vår organisation byggde vi vår egen implementation som det första OIDC-servern, vilket har kompletterats efter behov. Efter noggrant övervägande av andra färdiga lösningar kan man säga att detta är en omtvistad fråga. Argumenten för att implementera sin egen server var oro från leverantörerna om bristen på nödvändig funktionalitet, samt att det fanns ett gammalt system med olika skräddarsydda autentiseringar för vissa tjänster där det redan fanns en hel del data om anställda. Men i de färdiga lösningarna finns det fördelar för integration. Till exempel har Keycloak sitt eget användarhanteringssystem och data lagras direkt där, och att migrera sina användare dit är inte särskilt svårt. Det finns ett API i Keycloak som gör att man kan genomföra alla nödvändiga åtgärder för migreringen.
Ett annat exempel på en certifierad, intressant implementation — Ory Hydra. Den är intressant eftersom den består av olika komponenter. För integration behöver du koppla din användarhanteringstjänst med deras autentiseringstjänst och utöka den vid behov.
Keycloak och Ory Hydra är inte de enda färdiga lösningarna. Det är bäst att välja en certifierad implementation från OpenID Foundation. Vanligtvis har sådana lösningar en OpenID Certification-symbol.
Kom ihåg att det finns betalda tjänster om du inte vill hantera din egen OIDC-server. Det finns många bra alternativ tillgängliga idag.
Vad händer härnäst
Inom en snar framtid planerar vi att dirigera trafik till interna tjänster på ett annat sätt. Vi planerar att flytta vårt nuvarande SSO till en lastbalanserare med hjälp av OpenResty på en proxy baserad på OAuth. Det finns redan många färdiga lösningar här, till exempel:
Ytterligare material
– en bra tjänst för att verifiera JWT-token
— en lista med certifierade OIDC-implementationer
Källa: habr.com
