

Introduktion till operativsystem
Hej, Habr! Jag vill presentera för er en serie översättningsartiklar av en intressant litteratur — OSTEP. I detta material behandlas djupgående hur unix-liknande operativsystem fungerar, nämligen arbetet med processer, olika schemaläggare, minne och andra liknande komponenter som utgör ett modernt OS. Originalet av allt material kan du se här . Observera att översättningen är utförd oprofessionellt (relativt fritt), men jag hoppas att jag har bevarat den övergripande meningen.
Laborationsarbeten för detta ämne kan hittas här:
Andra delar:
Och du kan också kolla in min kanal på =)
Schemaläggning: Multi-Level Feedback Queue
I denna föreläsning kommer vi att diskutera problemen med att utveckla en av de mest kända metoderna för
schemaläggning, som kallas Multi-Level Feedback Queue (MLFQ). Första gången MLFQ-schemaläggaren beskrevs var 1962 av Fernando J. Corbató i systemet känt som
Compatible Time-Sharing System (CTSS). Dessa arbeten (inklusive senare arbeten inom
Multics) presenterades senare för Turing Award. Schemaläggaren har
sedan förbättrats och fått formen som vi ser i
några moderna system.
MLFQ-algoritmen försöker lösa 2 grundläggande överlappande problem.
För det första, den försöker optimera genomloppstiden, som vi diskuterade i den föregående föreläsningen, och som optimeras genom att köra de
kortaste uppgifterna först. Men, OS vet inte hur länge en viss process kommer att ta, och detta
är nödvändig kunskap för att algoritmer som SJF, STCF ska fungera. För det andra, MLFQ försöker
göra systemet responsivt för användare (till exempel de som väntar och
ser på skärmen i väntan på att uppgiften ska slutföras) och på så sätt minimera
respons tiden. Tyvärr minskar algoritmer som RR respons tiden, men de påverkar negativt
genomloppstiden. Därmed har vi vårt problem: Hur kan vi designa en
schemaläggare som uppfyller våra krav utan att veta något om
processens natur, generellt? Hur kan schemaläggaren lära sig egenskaperna hos uppgifterna
som den kör och därmed fatta bättre beslut om schemaläggning?
Kärnproblemet: Hur schemalägger man uppgifter utan perfekt kunskap?
Hur kan vi utveckla en schemaläggare som både minimerar respons tiden
för interaktiva uppgifter och samtidigt minimerar genomloppstiden utan tydlig
kunskap om uppgiftens exekveringstid?
Notering: lär sig av tidigare händelser
MLFQ-kö är ett utmärkt exempel på ett system som lär sig från
tidigare händelser för att förutsäga framtiden. Liknande metoder förekommer ofta
i OS (och många andra områden inom datavetenskap, inklusive
prediktioner inom hårdvara och cachalgoritmer). Liknande metoder
fungerar när uppgifterna har beteendefaser och därmed är förutsägbara.
Men med sådan teknik bör man vara försiktig, eftersom förutsägelser mycket lätt
kan visa sig vara felaktiga och leda systemet till att fatta sämre beslut än
vad som skulle vara fallet utan kunskap överhuvudtaget.
MLFQ: Grundläggande regler
Låt oss titta på de grundläggande reglerna för MLFQ-algoritmen. Även om det finns flera
implementationer av denna algoritm, är de grundläggande tillvägagångssätten liknande.
I den implementation vi kommer att titta på, kommer MLFQ att ha flera
separata köer, där varje kö har olika prioritet. När som helst
är en uppgift som är redo att köras i en kö. MLFQ använder prioriteringar
för att avgöra vilken uppgift som ska köras, det vill säga, uppgiften med högre
prioritet (uppgiften från kön med högst prioritet) kommer att köras först.
Självklart kan det finnas mer än en uppgift i en specifik kö, så de
kommer att ha samma prioritet. I så fall kommer en RR-mekanism
att användas för att schemalägga körningen mellan dessa uppgifter.
Således kommer vi till två grundläggande regler för MLFQ:
Regel 1: Om Prioritet(A) > Prioritet(B), kommer uppgift A att köras (B kommer inte)
- Regel 2: Om Prioritet(A) = Prioritet(B), A och B körs med hjälp av RR
- Baserat på ovanstående, är nyckelelementen för MLFQ-schemaläggning
prioriteter. Istället för att ge varje uppgift en fast prioritet,
ändrar MLFQ sin prioritet baserat på observerat beteende.
Till exempel, om en uppgift ständigt slänger CPU-arbete i väntan på tangentbordsinmatning,
kommer MLFQ att hålla processens prioritet hög, eftersom det är så
en interaktiv process bör fungera. Om en uppgift däremot ständigt och
intensivt använder CPU under en längre period, kommer MLFQ att sänka dess
prioritet. Således kommer MLFQ att studera processers beteende under deras körning
och använda detta beteende.
Låt oss rita ett exempel på hur köerna skulle kunna se ut vid en viss tidpunkt
och då få något i stil med detta:
I detta schema ligger processerna A och B i kön med högst prioritet. Process C
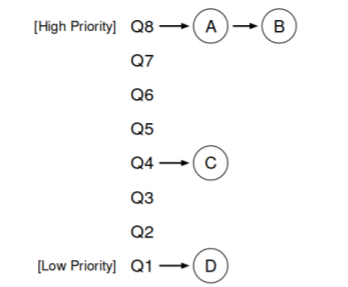
är någonstans i mitten, och process D i slutet av kön. Enligt de ovan nämnda
beskrivningarna av MLFQ-algoritmen kommer schemaläggaren att utföra uppgifter med högst prioritet.
описаниям алгоритма MLFQ планировщик будет исполнять задачи только с наивысшим
prioriteras enligt RR, medan uppgifterna C och D inte kommer att vara aktuella.
Självklart kommer en statisk snapshot inte att ge en fullständig bild av hur MLFQ fungerar.
Det är viktigt att förstå hur bilden förändras över tid.
Försök 1: Hur man ändrar prioritet
Vid denna punkt måste det lösas hur MLFQ kommer att justera prioriteringsnivån
för uppgifter (och därigenom positionen för uppgiften i kön) under hela dess livscykel. För
detta måste man ha arbetsflödet i åtanke: ett visst antal
interaktiva uppgifter med kort tid av arbete (och därigenom frekvent frigivning av
CPU) och ett par långa uppgifter som använder CPU hela sin arbetstid, där
responsiviteten för sådana uppgifter inte är viktig. Och så kan man göra det första försöket
att implementera MLFQ-algoritmen med följande regler:
- Rule3: När en uppgift kommer in i systemet placeras den i kön med högst
- prioritet.
- Rule4a: Om en uppgift använder hela det tilldelade tidsfönstret, då sänks dess
- prioritet.
- Rule4b: Om uppgiften frigör CPU innan tidsfönstret har löpt ut, förblir den
- med samma prioritet.
Exempel 1: En långvarig uppgift
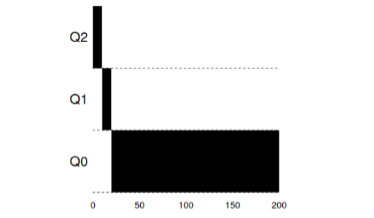
I detta exempel placeras uppgiften vid ankomst med högsta
prioritet. Efter ett tidsfönster på 10 ms sänks prioriteten av
schemaläggaren. Efter nästa tidsfönster sänks uppgiften till
den lägsta prioriteten i systemet, där den förblir.
Exempel 2: En kort uppgift har anlänt
Nu ska vi se ett exempel på hur MLFQ försöker närma sig SJF. I detta
exempel finns två uppgifter: A, som är en långvarig uppgift som konstant
använder CPU och B, som är en kort interaktiv uppgift. Anta att
A redan har arbetat en tid när uppgift B kommer.
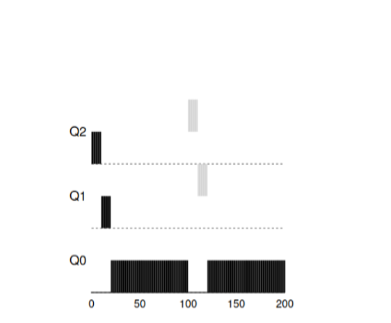
I denna graf kan resultaten av scenariot ses. Uppgift A, som alla uppgifter,
som använder CPU hamnar längst ner. Uppgift B kommer vid tid T=100 och kommer
att placeras i kön med högsta prioritet. Eftersom tiden för dess arbete är kort, kommer
den att avslutas innan den når den sista kön.
Från detta exempel kan man förstå algoritmens huvudmål: eftersom algoritmen inte
vet om en uppgift är lång eller kort, antar den först att uppgiften
kort och ger den högsta prioritet. Om det verkligen är en kort uppgift, så
kommer den att utföras snabbt, annars, om det är en lång uppgift, kommer den att ta tid
prioritet nedåt och snart bevisa att det faktiskt är en lång uppgift som inte
kräver svar.
Exempel 3: Vad gäller in- och utmatning?
Låt oss nu titta på ett exempel med in- och utmatning. Som nämnts i regel 4b,
om en process frigör processorn utan att ha använt hela sin processor-tid,
så förblir den på samma prioriteringsnivå. Syftet med denna regel är ganska enkelt
— om en interaktiv uppgift utför många in- och utmatningsoperationer, till exempel och väntar
på att användaren ska trycka på tangenterna eller musen, kommer en sådan uppgift att frigöra processorn
tidigare än det tilldelade fönstret. Vi vill inte sänka prioriteten för en sådan uppgift,
och därför förblir den på samma nivå.
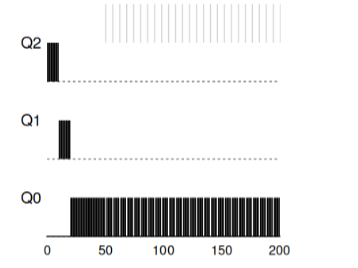
Detta exempel visar hur algoritmen kommer att fungera med sådana processer — den interaktiva uppgiften B, som behöver CPU endast i 1 ms innan den utför
in- och utmatningsprocessen och den långa uppgiften A, som använder CPU hela sin tid.
MLFQ håller process B på den högsta prioriteten, eftersom den alltid fortsätter
att frigöra CPU. Om B är en interaktiv uppgift, då har algoritmen på så sätt uppnått
sitt mål att snabbt köra interaktiva uppgifter.
Problem med den nuvarande MLFQ-algoritmen
I de föregående exemplen har vi byggt en grundläggande version av MLFQ. Och det verkar som om den
gör sitt jobb väl och rättvist, fördelar processortid rättvist mellan
långa uppgifter och låter korta uppgifter eller uppgifter som intensivt använder
in- och utmatning bearbeta snabbt. Tyvärr innehåller detta tillvägagångssätt flera
allvarliga problem.
För det första, hungersproblem: om det finns många interaktiva
uppgifter i systemet, kommer de att konsumera all processortid och därmed kommer ingen lång
uppgift att få möjlighet att utföras (de svälter).
För det andra, smarta användare kan skriva sina program så att
de lurar schemaläggaren. Fällan ligger i att göra något sådant som tvingar
schemaläggaren att ge processen mer processortid. Algoritmen som
beskrivs ovan är helt sårbart för sådana attacker: innan tidsfönstret nästan är
utslutat behöver en in-och-ut operation (till någon, vilken som helst fil) utföras
och på så sätt frigöra CPU:n. Ett sådant beteende gör att man kan förbli i samma
kö och återfå en större procentandel av processortiden. Om man gör detta
korrekt (till exempel att köras 99 % av tiden under fönstret innan CPU:n frigörs),
kan en sådan uppgift enkelt monopoliserar processorn.
Slutligen kan programmet ändra sitt beteende över tid. De uppgifter som
använde CPU:n kan bli interaktiva. I vårt exempel kommer sådana
uppgifter inte att få rätt hantering av schemaläggaren, som de skulle ha fått av andra
(ursprungliga) interaktiva uppgifter.
Fråga till publiken: vilka attacker på schemaläggaren skulle kunna utföras i den moderna världen?
Försök 2: Höja prioriteten
Vi försöker ändra reglerna och se om vi kan undvika problem med
svält. Vad skulle vi kunna göra för att säkerställa att CPU-relaterade
uppgifter får sin tid (även om det inte är länge).
En enkel lösning på problemet skulle kunna vara att regelbundet
höja prioriteten för alla sådana uppgifter i systemet. Det finns många sätt
att uppnå detta, låt oss försöka genomföra något enkelt som exempel: att omedelbart
översätta alla uppgifter till högsta prioritet, därav den nya regeln:
- Regel 5: Efter en viss period S, att översätta alla uppgifter i systemet till högsta kö.
Vår nya regel löser två problem på en gång. För det första garanteras att processerna
inte svälter: uppgifter som befinner sig i den högsta kön kommer att dela
processortid enligt RR-algoritmen och på så sätt kommer alla processer att få
processortid. För det andra, om en process som tidigare endast använde
processorn blir interaktiv, kommer den att förbli i kön med högre
prioritet efter att ha fått en höjning av prioriteten till högsta.
Låt oss överväga ett exempel. I det här scenariot ska vi granska en process som använder
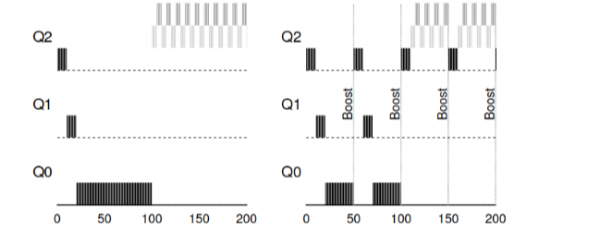
CPU och två interaktiva, korta processer. Till vänster visar bilden beteende utan prioriteringshöjning, vilket innebär att en lång uppgift börjar svälta efter att två interaktiva uppgifter anländer till systemet. Till höger utförs prioriteringshöjning var 50ms, vilket gör att alla processer garanterat får CPU-tid och kommer att köras periodiskt. 50ms är här ett exempel; i verkligheten är detta tal något större.
Det är uppenbart att tillägg av tidsperiodisk höjning S leder till
den ofrånkomliga frågan: vilket värde bör sättas? En av de ansedda
systemingenjörerna John Ousterhout benämnde sådana storheter i systemen som voo-doo
konstanter, eftersom de på något sätt krävde svart magi för korrekt
inställning. Och tyvärr har S en sådan arom. Om man sätter värdet för högt
börjar de långvariga uppgifterna svälta. Och om man sätter värdet för lågt,
får de interaktiva uppgifterna inte tillräcklig CPU-tid.
Försök 3: Bästa redovisning
Nu har vi ett annat problem som behöver lösas: hur får vi inte
vår schemaläggare att bli lurad? Anklagade för denna möjlighet är
reglerna 4a, 4b, som tillåter en uppgift att behålla sin prioritet genom att frigöra CPU
innan den tilldelade tiden har gått ut. Hur hanterar vi detta?
Lösningen i det här fallet kan ses som bästa redovisning av CPU-tid på varje
nivå av MLFQ. Istället för att glömma den tid programmet använde
CPU:n under den tilldelade perioden, bör den beaktas och sparas. Efter att
processen har förbrukat den tilldelade tiden, bör den sänkas till nästa
prioritetsnivå. Nu spelar det ingen roll hur processen använder sin tid — om
den konstant beräknar på processorn eller om den gör ett flertal anrop. På så sätt
bör regel 4 skrivas om till följande:
- Rule4: Efter att uppgiften har förbrukat sin tilldelade tid i den aktuella kön (oavsett hur många gånger den har frigjort CPU:n) sänks prioriteten för en sådan uppgift (den flyttas nedåt i kön).
Låt oss titta på ett exempel:
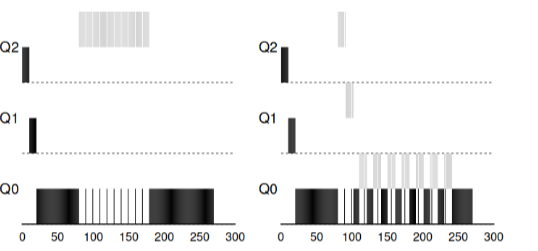 »
Bilden visar vad som händer om man försöker lura schemaläggaren, hur
om det skulle vara med de tidigare reglerna 4a, 4b, skulle resultatet bli till vänster. Med den nya
regeln - resultatet till höger. Före skyddet kunde vilken process som helst orsaka I/O till avslut och
därmed dominera CPU:n, efter aktivering av skyddet, oavsett I/O-beteende
kommer det fortfarande att sjunka i köerna och därmed inte kunna orättvist
tillgodogöra sig CPU-resurser.
Förbättringar av MLFQ och andra problem
Med de ovan nämnda förbättringarna uppstår nya problem: en av de största
frågorna är hur man ska parametrisera en sådan schemaläggare? Dvs. Hur många skall det finnas
köer? Vad bör storleken på arbetsfönstret vara inom kön? Hur
ofta bör man höja programmets prioritet för att undvika svält och
ta hänsyn till förändringar i programmets beteende? Det finns inget enkelt
svar på dessa frågor och endast experiment med belastningar och efterföljande konfigurationer
av schemaläggaren kan leda till en viss tillfredsställande balans.
Till exempel tillåter de flesta implementationer av MLFQ att olika
tidsintervall tilldelas olika köer. Högt prioriterade köer tilldelas vanligtvis
korta intervall. Dessa köer består av interaktiva uppgifter,
där växlingen mellan dem är ganska känslig och bör ta 10 millisekunder eller mindre.
I kontrast består lågt prioriterade köer av långa uppgifter som använder
CPU:n. I det här fallet passar långa tidsintervall väldigt bra (100 ms).
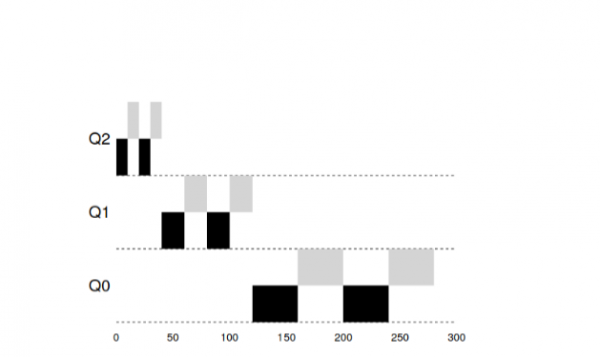
I detta exempel finns det 2 uppgifter som har arbetat i den högprioriterade kön i 20
ms, uppdelat i fönster om 10 ms. 40 ms i den medelprioriterade kön (fönster om 20 ms) och i den lågt prioriterade
kön blev tidsfönstret 40 ms, där uppgifterna avslutade sitt arbete.
Implementation av MLFQ i Solaris-OS - en klass av tidsdelade schemaläggare.
Schemaläggaren tillhandahåller en uppsättning tabeller som exakt definierar hur
prioriteten för processen ska ändras under dess livstid, vad storleken på
det tilldelade fönstret ska vara och hur ofta uppgifternas prioriteringar ska höjas. Systemadministratören
kan interagera med denna tabell och få schemaläggaren att bete sig
annorlunda. Som standard innehåller denna tabell 60 köer med gradvis ökande
fönsterstorlek från 20 ms (högt prioritet) till flera hundra ms (lägre prioritet), och
även med boost av alla uppgifter en gång per sekund.
Andra MLFQ-schemaläggare använder inte tabeller eller specifika
regler som beskrivs i denna föreläsning, å andra sidan beräknar de prioriteringar med hjälp av
matematiska formler. Till exempel använder schemaläggaren i FreeBSD en formel för
att beräkna den aktuella prioriteten för en uppgift, baserat på hur mycket processorn
har använt CPU. Dessutom förfaller CPU-användningen över tid, och på så sätt
höjs prioriteten på ett något annat sätt än beskrivits ovan. Detta kallas så
kallade decay-algoritmer. Från version 7.1 används schemaläggaren ULE i FreeBSD.
Slutligen har många schemaläggare andra funktioner. Till exempel
reserverar vissa schemaläggare de högsta nivåerna för att driva operativsystemet, vilket gör att
ingen användarprocess kan få högsta prioritet i
systemet. Vissa system tillåter att ge tips för att hjälpa
schemaläggaren att korrekt sätta prioriteringar. Till exempel kan man med hjälp av kommandot trevlig
öka eller minska prioriteten för en uppgift och därigenom höja eller
sänka programmets chanser till processorstid.
MLFQ: Sammanfattning
Vi har beskrivit en planeringsmetod som kallas MLFQ. Namnet
ligger i dess funktion — den har flera köer och använder återkoppling
för att bestämma uppgiftens prioritet.
Den slutgiltiga beskrivningen av reglerna kommer att vara som följer:
- Regel1: Om prioritet(A) > Prioritet(B), kommer uppgift A att köras (B kommer inte att köras)
- Regel2: Om prioritet(A) = Prioritet(B), A och B körs med RR
- Regel3: När en uppgift kommer in i systemet, placeras den i kön med högsta prioritet.
- Rule4: Efter att uppgiften har förbrukat sin tilldelade tid i den aktuella kön (oavsett hur många gånger den har frigjort CPU:n) sänks prioriteten för en sådan uppgift (den flyttas nedåt i kön).
- Regel 5: Efter en viss period S, att översätta alla uppgifter i systemet till högsta kö.
MLFQ är intressant av följande anledning — istället för att kräva förkunskaper om
uppdragets natur i förväg, studerar algoritmen tidigare beteenden av uppgiften och sätter
prioriteringar därefter. På så sätt försöker den klara två mål samtidigt — uppnå prestanda för små uppgifter (SJF, STCF) och rättvist köra långvariga,
CPU-krävande uppgifter. Därför använder många system, inklusive BSD och deras derivat,
Solaris, Windows, Mac, någon form av algoritm
MLFQ som grundläggande planeringsmetod.
Ytterligare material:
- (beräkning)
Källa: habr.com
