

Mikrotjänstarkitektur, precis som allt annat i denna värld, har sina fördelar och nackdelar. Vissa processer blir enklare med den, andra blir svårare. För att åstadkomma snabbare förändringar och bättre skalbarhet måste man göra vissa uppoffringar. En av dessa är kompliceringen av analysen. Om man i ett monolitiskt system kan reducera all operativ analys till SQL-frågor mot en analytisk replika, så har varje tjänst i en multitjänstarkitektur sin egen databas, och det verkar som att man inte kan klara sig med en enda fråga (eller kanske kan?). För dem som är intresserade av hur vi löste problemet med operativ analys i vårt företag och hur vi har lärt oss att leva med denna lösning – välkomna.
Jag heter Pavel Sivash, och på DomKlik jobbar jag i teamet som ansvarar för underhåll av det analytiska datalageret. Vår verksamhet kan grovt kategoriseras som dataengineering, men egentligen är spektrum av uppgifter mycket bredare. Det handlar om standarder för dataengineering som ETL/ELT, stöd och anpassning av verktyg för dataanalys samt utveckling av egna verktyg. Specifikt för operativ rapportering har vi valt att "låtsas" att vi har ett monolitiskt system och ge analytikerna en databas där all nödvändig information finns.
Vi har övervägt olika alternativ. Man skulle kunna bygga ett fullständigt lagringssystem — vi provade till och med det, men ärligt talat lyckades vi aldrig få tillräckligt med frekventa förändringar i logiken att stämma överens med den relativt långsamma processen för att bygga lagringen och göra ändringar i den (om någon lyckades, skriv gärna i kommentarerna hur). Man kunde ha sagt till analytikerna: "Grabbar, lär er python och jobba med analytiska repliker", men det skulle innebära ett extra krav på att rekrytera personal, och det verkade som något att undvika om möjligt. Vi beslöt oss för att prova teknologin FDW (Foreign Data Wrapper): i grunden är det en standard dblink som finns i SQL-standarden, men med ett mycket mer användarvänligt gränssnitt. Baserat på detta skapade vi en lösning som slutligen blev accepterad, och det är där vi har stannat. Detaljerna kring detta är ämnet för en separat artikel, och kanske för flera, eftersom vi har mycket att berätta: från synkronisering av databasstrukturer till åtkomsthantering och anonymisering av personuppgifter. Det bör också nämnas att denna lösning inte ersätter verkliga analytiska databaser och lagringssystem; den löser bara en specifik uppgift.
Övergripande ser det ut så här:
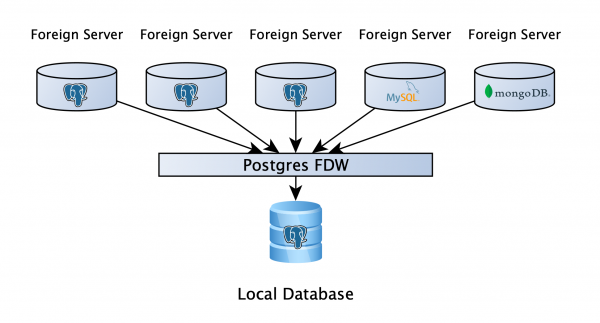
Det finns en PostgreSQL-databas där användarna kan lagra sina arbetsdata, och det viktigaste är att denna databas är ansluten till analytiska repliker av alla tjänster via FDW. Detta ger möjlighet att skriva en fråga till flera databaser, oavsett om det handlar om: PostgreSQL, MySQL, MongoDB eller något annat (en fil, API, om det inte finns någon passande wrapper kan man skriva sin egen). Så, allt verkar bra! Ska vi avsluta här?
Om allt slutade så snabbt och enkelt, skulle det antagligen inte finnas någon artikel.
Det är viktigt att tydligt förstå hur Postgres hanterar begärningar till fjärrservrar. Det verkar logiskt, men mycket ofta uppmärksammar man inte detta: Postgres delar upp begäran i delar som körs på fjärrservrar oberoende av varandra, samlar dessa data och gör de slutgiltiga beräkningarna själv, så hastigheten för att utföra en begäran beror starkt på hur den är skriven. Det bör också påpekas att när data kommer från en fjärrserver har de redan inga index, och inget som kan hjälpa planeringsverktyget; därför kan vi endast hjälpa och vägleda det själva. Och det är just detta jag vill berätta mer om.
Ett enkelt förfrågan och planen med den
För att visa hur PostgreSQL utför en fråga mot en tabell med 6 miljoner rader på en avlägsen servern, låt oss titta på den enkla planen.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table;

Aggregate  (cost=418383.23..418383.24 rows=1 width=8) (actual time=3857.198..3857.198 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.00..402376.14 rows=6402838 width=0) (actual time=4.874..3256.511 rows=6406868 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Remote SQL: SELECT NULL FROM fdw_schema.table
Planning time: 0.986 ms
Execution time: 3857.436 ms
Användningen av VERBOSE-instruktionen möjliggör att se den fråga som kommer att skickas till den avlägsna servern och vars resultat vi får för vidare behandling (rad RemoteSQL).
Låt oss gå lite längre och lägga till några filter i vår fråga: ett på boolean fältet, ett på förekomsten timestamp inom intervallet och ett på jsonb.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 month'
AND CURRENT_DATE - INTERVAL '6 month'
AND meta->>'source' = 'test';

Aggregate  (cost=577487.69..577487.70 rows=1 width=8) (actual time=27473.818..25473.819 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.00..577469.21 rows=7390 width=0) (actual time=31.369..25372.466 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: (("table".is_active IS TRUE) AND (("table".meta ->> 'source'::text) = 'test'::text) AND ("table".created_dt >= (('now'::cstring)::date - '7 mons'::interval)) AND ("table".created_dt <= ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)))
        Rows Removed by Filter: 5046843
        Remote SQL: SELECT created_dt, is_active, meta FROM fdw_schema.table
Planning time: 0.665 ms
Execution time: 27474.118 ms
Det är precis här som det finns en punkt som behöver uppmärksammas vid skrivning av frågor. Filtren överfördes inte till den avlägsna servern, vilket betyder att PostgreSQL hämtar alla 6 miljoner rader för att sedan lokalt filtrera (rad Filter) och utföra aggregationen. Nyckeln till framgång är att skriva frågan så att filtren överförs till den avlägsna maskinen, så att vi får och aggregerar endast de nödvändiga raderna.
Det är en del booleanshit
Med booleanfält är allt enkelt. Problemet i den ursprungliga frågan uppstod på grund av operatorn is. Om vi byter ut den mot =, får vi följande resultat:
förklara analysera detaljerat
VÄLJ räkna(1)
FRÅN fdw_schema.tabell
DÄR is_active = Sant
OCH created_dt MELLAN NU_DAG - INTERVAL '7 månader'
OCH NU_DAG - INTERVAL '6 månader'
OCH meta->>'source' = 'test';

Aggregat  (kostnad=508010.14..508010.15 rader=1 bredd=8) (faktisk tid=19064.314..19064.314 rader=1 loop=1)
  Utmatning: räkna(1)
  ->  Utländsk skanning på fdw_schema."tabell"  (kostnad=100.00..507988.44 rader=8679 bredd=0) (faktisk tid=33.035..18951.278 rader=1360025 loop=1)
        Utmatning: "tabell".id, "tabell".is_active, "tabell".meta, "tabell".created_dt
        Filter: ((("tabell".meta ->> 'source'::text) = 'test'::text) OCH ("tabell".created_dt >= (('nu'::cstring)::datum - '7 mån'::intervall)) OCH ("tabell".created_dt <= ((('nu'::cstring)::datum)::tidsstämpel med tidszon - '6 mån'::intervall)))
        Rader borttagna av filter: 3567989
        Fjärr SQL: VÄLJ created_dt, meta FRÅN fdw_schema.tabell DÄR (is_active)
Planeringstid: 0.834 ms
Exekveringstid: 19064.534 ms
Som ni ser har filtret gått till den fjärranslutna servern, och exekveringstiden har minskat från 27 till 19 sekunder.
Det är värt att notera att operatorn is skiljer sig från operatorn = i att den kan hantera värdet Null. Detta innebär att is not True i filtret lämnar värdena Falskt och Null, medan != True bara lämnar värdena Falskt. Därför, vid byte av operatorn is not bör man ange två villkor i filtret med operatorn OR, till exempel, DÄR (col != True) ELLER (col is null).
Vi har kommit överens om boolean, låt oss gå vidare. Under tiden återställer vi filtret för booleska värden till sitt ursprungliga tillstånd för att oberoende överväga effekten av andra förändringar.
timestamptz? hz
Överlag måste man ofta experimentera med hur man korrekt skriver en fråga som involverar fjärrservrar, och först därefter söka förklaringar till varför saker och ting fungerar så. Mycket lite information finns att hitta om detta på Internet. I våra experiment har vi upptäckt att ett filter för ett fast datum går undan till den fjärranslutna servern, men när vi vill ställa in ett datum dynamiskt, till exempel now() eller CURRENT_DATE, så händer inte detta. I vårt exempel lade vi till ett sådant filter för att kolumnen created_at skulle innehålla data exakt en månad tillbaka i tiden (MELLAN NU_DAG - INTERVAL '7 månader' OCH NU_DAG - INTERVAL '6 månader'). Vad gjorde vi i det här fallet?
förklara analysera detaljerat
VÄLJ count(1)
FRÅN fdw_schema.tabell
DÄR is_active är Sant
OCH created_dt >= (VÄLJ CURRENT_DATE::timestamptz - INTERVAL '7 månader')
OCH created_dt >'source' = 'test';

Aggregat  (kostnad=306875.17..306875.18 rader=1 bredd=8) (faktisk tid=4789.114..4789.115 rader=1 loopar=1)
  Utdata: count(1)
  InitPlan 1 (returnerar $0)
    ->  Resultat  (kostnad=0.00..0.02 rader=1 bredd=8) (faktisk tid=0.007..0.008 rader=1 loopar=1)
          Utdata: ((('nu'::cstring)::datum)::timestamp med tidszon - '7 mån'::intervall)
  InitPlan 2 (returnerar $1)
    ->  Resultat  (kostnad=0.00..0.02 rader=1 bredd=8) (faktisk tid=0.002..0.002 rader=1 loopar=1)
          Utdata: ((('nu'::cstring)::datum)::timestamp med tidszon - '6 mån'::intervall)
  ->  Utlandsundersökning på fdw_schema."tabell"  (kostnad=100.02..306874.86 rader=105 bredd=0) (faktisk tid=23.475..4681.419 rader=1360025 loopar=1)
        Utdata: "tabell".id, "tabell".is_active, "tabell".meta, "tabell".created_dt
        Filter: (("tabell".is_active ÄR SANT) OCH (("tabell".meta ->> 'source'::text) = 'test'::text))
        Rader borttagna av filter: 76934
        Fjärr SQL: VÄLJ is_active, meta FRÅN fdw_schema.tabell DÄR ((created_dt >= $1::timestamp med tidszon)) OCH ((created_dt < $2::timestamp med tidszon))
Planeringstid: 0.703 ms
Utförandetid: 4789.379 ms
Vi föreslog för planeringsverktyget att beräkna datumet i underfrågan och skicka den färdiga variabeln till filtret. Och denna rekommendation gav oss ett utmärkt resultat, förfrågan blev nästan sex gånger snabbare!
Återigen, det är viktigt att vara uppmärksam: datatypen i underfrågan måste vara densamma som för fältet vi filtrerar på, annars kommer planeringsverktyget att besluta att eftersom typerna är olika måste alla data först hämtas och sedan filtreras lokalt.
Vi återgår till datumfiltret till sitt ursprungliga värde.
Freddy mot Jsonb
Överlag har booleska fält och datum redan accelererat vår förfrågan ganska mycket, men det fanns fortfarande en datatyp kvar. Striden med filtreringen på den, ärligt talat, är fortfarande inte avslutad, även om där finns framsteg. Så här lyckades vi skicka filtret för jsonb fältet till den fjärrserver.
förklara analysera detaljerat
VÄLJ count(1)
FRÅN fdw_schema.tabell
DÄR is_active är Sant
OCH created_dt mellan CURRENT_DATE - INTERVAL '7 månader'
OCH CURRENT_DATE - INTERVAL '6 månader'
OCH meta @> '{"source":"test"}'::jsonb;

Aggregat  (kostnad=245463.60..245463.61 rader=1 bredd=8) (faktisk tid=6727.589..6727.590 rader=1 loopar=1)
  Utdata: count(1)
  ->  Utlandsundersökning på fdw_schema."tabell"  (kostnad=1100.00..245459.90 rader=1478 bredd=0) (faktisk tid=16.213..6634.794 rader=1360025 loopar=1)
        Utdata: "tabell".id, "tabell".is_active, "tabell".meta, "tabell".created_dt
        Filter: (("tabell".is_active ÄR SANT) OCH ("tabell".created_dt >= (('nu'::cstring)::datum - '7 mån'::intervall)) OCH ("tabell".created_dt  '{"source": "test"}'::jsonb))
Planeringstid: 0.747 ms
Utförandetid: 6727.815 ms
Istället för filtreringsoperatorer ska en operator för närvaro användas. jsonb i en annan. 7 sekunder istället för ursprungliga 29. Detta är hittills det enda framgångsrika sättet att överföra filter genom jsonb till en fjärrserver, men här är det viktigt att ta hänsyn till en begränsning: vi använder version 9.6 av databasen, men fram till slutet av april planerar vi att slutföra de sista testerna och uppgradera till version 12. Så snart vi har uppdaterat kommer vi att skriva om hur detta påverkade oss, eftersom det finns många förändringar som vi har stora förhoppningar på: json_path, nytt beteende för CTE, push down (som funnits sedan version 10). Det skulle vara bra att prova snart.
Finish him
Vi har kontrollerat hur varje ändring påverkar hastigheten för förfrågan var för sig. Låt oss nu se vad som händer när alla tre filter är korrekt skrivna.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active = True
AND created_dt >= (SELECT CURRENT_DATE::timestamptz - INTERVAL '7 month')
AND created_dt  '{"source":"test"}'::jsonb;

Aggregate  (cost=322041.51..322041.52 rows=1 width=8) (actual time=2278.867..2278.867 rows=1 loops=1)
  Output: count(1)
  InitPlan 1 (returns $0)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.010..0.010 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '7 mons'::interval)
  InitPlan 2 (returns $1)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.003..0.003 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.02..322041.41 rows=25 width=0) (actual time=8.597..2153.809 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Remote SQL: SELECT NULL FROM fdw_schema.table WHERE (is_active) AND ((created_dt >= $1::timestamp with time zone)) AND ((created_dt  '{"source": "test"}'::jsonb))
Planning time: 0.820 ms
Execution time: 2279.087 ms
Ja, förfrågan verkar mer komplex, det är en oundviklig kostnad, men exekveringstiden är 2 sekunder, vilket är mer än 10 gånger snabbare! Och detta handlar om en enkel förfrågan mot en relativt liten datamängd. Vid verkliga förfrågningar har vi fått en ökning med upp till flera hundra gånger.
Sammanfattningsvis: Om du använder PostgreSQL med FDW, kontrollera alltid att alla filter skickas till fjärrservern, så blir du lycklig… åtminstone tills du når join mellan tabeller från olika servrar. Men det är redan en historia för en annan artikel.
Tack för din uppmärksamhet! Jag ser fram emot frågor, kommentarer och även berättelser om din erfarenhet i kommentarerna.
Källa: habr.com
