

Rapportet handlar om praktiska frågor kring utveckling av operatörer i Kubernetes, design av deras arkitektur och grundläggande funktionsprinciper.
I den första delen av rapporten kommer vi att gå igenom:
- vad en operatör i Kubernetes är och varför den behövs;
- hur en operatör förenklar hanteringen av komplexa system;
- vad en operatör kan och vad den inte kan.
Därefter går vi vidare till diskussionen om operatörens interna strukturer. Vi kommer att betrakta arkitekturen och funktionen av en operatör steg för steg. Vi kommer att detaljerat analysera:
- interaktionen mellan operatören och Kubernetes;
- vilka funktioner operatören tar på sig och vad den delegerar till Kubernetes.
Vi kommer att titta på hantering av shardar och repliker av databaser i Kubernetes.
Därefter diskuterar vi frågor kring datalagring:
- hur man arbetar med Persistent Storage ur operatörens perspektiv;
- fällor med användning av Local Storage.
I den avslutande delen av rapporten ska vi gå igenom praktiska exempel på tillämpning av med Amazon eller Google Cloud Service. Rapporten bygger på exempel från utvecklingen och driften av en operatör för ClickHouse.
Video:
Jag heter Vladislav Klimenko. Jag ville idag berätta om vår erfarenhet av utveckling och drift av operatören, som är en specialiserad operatör för hantering av databaskluster. Som exempel kommer vi att titta på för att hantera ett ClickHouse-kluster.
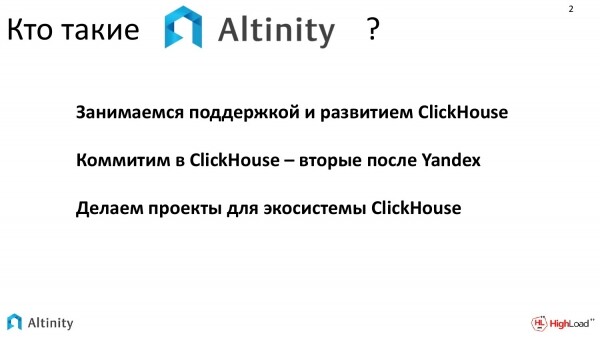
Varför har vi möjlighet att tala om operatören och ClickHouse?
- Vi arbetar med support och utveckling av ClickHouse.
- Just nu försöker vi långsamt bidra med det vi kan till utvecklingen av ClickHouse. Vi är de näst största efter Yandex när det kommer till antalet ändringar som gjorts i ClickHouse.
- Vi försöker göra ytterligare projekt för ClickHouse-ekosystemet.
Jag skulle vilja berätta om ett av dessa projekt. Det handlar om ClickHouse-operatorn för Kubernetes.
I min presentation vill jag ta upp två ämnen:
- Det första ämnet handlar om hur vår operatör för hantering av ClickHouse-databaser i Kubernetes fungerar.
- Det andra ämnet handlar om hur en operatör fungerar generellt, dvs. hur den interagerar med Kubernetes.
Dessa två frågor kommer att korsas genom hela min presentation.
Vem skulle vara intresserad av att lyssna på det jag försöker förmedla?
- Det är mest intressant för dem som driver operatörer.
- Eller för dem som vill bygga sin egen för att förstå hur den fungerar internt, hur operatören interagerar med Kubernetes och vilka fällor som kan dyka upp.
För att bättre förstå vad vi kommer att diskutera idag, vore det bra att veta hur Kubernetes fungerar och ha en grundläggande kunskap om molnteknologier.
Vad är ClickHouse? Det är en kolumnorienterad databas med fokus på onlinebehandling av analytiska förfrågningar. Och den är helt öppen källkod.
Och vi behöver veta två saker. För det första vet vi att detta är en databas, så det jag kommer att förklara kommer att vara tillämpligt på nästan alla databaser. För det andra att databashanteringssystemet ClickHouse skalas mycket bra, det ger praktiskt taget linjär skalbarhet. Därför är klustrets tillstånd det normala tillståndet för ClickHouse. Det mest intressanta för oss är att diskutera hur man underhåller ett ClickHouse-kluster i Kubernetes.
Varför behövs det där? Varför kan vi inte fortsätta att driva det själva? Svaren är delvis tekniska och delvis organisatoriska.
- I praktiken stöter vi allt oftare på situationer där nästan alla komponenter i stora företag redan körs i Kubernetes. Databaserna blir kvar utanför.
- Och allt oftare ställs frågan: "Kan vi integrera detta?". Därför försöker stora företag att maximera standardiseringen av hanteringen för att snabbt kunna administrera sina datalagringar.
- Och det här är särskilt hjälpsamt om det krävs maximal möjlighet att återskapa samma sak på en ny plats, det vill säga maximal portabilitet.
Hur enkelt eller svårt är det? Det kan självklart göras manuellt. Men det är inte så enkelt, eftersom vi har den totala komplexiteten av att hantera Kubernetes, samtidigt som vi måste ta hänsyn till ClickHouse-specifikationen. Resultatet blir en sådan aggregering.
Och allt detta ger en ganska stor uppsättning teknologier som blir svåra att hantera, eftersom Kubernetes kommer med sina dagliga driftfrågor och ClickHouse med sina specifika dagliga driftutmaningar. Särskilt om vi har flera ClickHouse-instanser och ständigt måste hantera något med dem.
ClickHouse har med dynamisk konfiguration ett stort antal frågor som skapar en konstant belastning på DevOps:
- När vi vill ändra något i ClickHouse, till exempel lägga till en replik eller shard, måste vi hantera konfigurationen.
- Sedan måste dataskeman ändras eftersom ClickHouse har ett speciellt sätt att sharda. Man behöver distribuera dataskeman och konfigurationerna.
- Övervakning måste ställas in.
- Insamling av loggar för nya shards, för nya repliker.
- Man måste ta hand om återställning.
- Och om omstart.
Det är sådana rutinarbeten som man verkligen skulle vilja underlätta i driften.
Kubernetes hjälper bra till med driften, men när det gäller de grundläggande systemaspekterna.
Kubernetes underlättar och automatiserar saker såsom:
- Återställning.
- Omstart.
- Systemlagringshantering.
Detta är bra, det är rätt riktning, men det har ingen komplett förståelse för hur man driver en databascluster.
Man vill ha mer, man vill att hela databasen ska fungera i Kubernetes.
Man vill få något som en stor magisk röd knapp, som man trycker på och får ett cluster som installeras och underhålls under hela livscykeln, med dagliga uppgifter som måste lösas. ClickHouse-cluster i Kubernetes.
Och vi har försökt skapa en lösning som underlättar arbetet. Det är ClickHouse-operatören för Kubernetes från Altinity.
Operatören är ett program vars huvuduppgift är att hantera andra program, det vill säga, det är en förvaltare.
Och det innehåller beteendemallar. Man kan kalla det kodifierad kunskap om ämnesområdet.
Och dess huvuduppgift är att underlätta livet för DevOps och minska micromanagement, så att han (DevOps) tänker i termer av hög nivå, det vill säga, att han (DevOps) inte ägnar sig åt micromanagement och inte behöver ställa in alla detaljer manuellt.
Och just operatören är en hjälprobot som tacklar mikrouppgifter och hjälper DevOps.
Varför behövs en operatör? Den visar sig särskilt bra i två frågor:
- När en specialist som sysslar med ClickHouse har otillräcklig erfarenhet, men måste börja använda ClickHouse, underlättar operatören driften och möjliggör att driva ClickHouse-cluster med en ganska komplex konfiguration, utan att behöva gå in på detaljer om hur allt fungerar inuti. Man ger honom bara högre uppgifter, och det fungerar.
- Och den andra uppgiften, där han verkligen utmärker sig, är när det handlar om att automatisera ett stort antal repetitiva uppgifter. Han avlastar sysadmins från mikrouppgifter.
Det här behövs mest av allt för antingen de som just har börjat sin resa, eller de som behöver fokusera mycket på automatisering.
Vad är då skillnaden mellan ett operatörsbaserat tillvägagångssätt och andra system? Finns det inte Helm? Det hjälper ju också att installera ClickHouse, man kan rita helm charts som till och med sätter upp en hel ClickHouse-kluster. Vad är då skillnaden mellan en operatör och till exempel Helm?
Den grundläggande skillnaden är att Helm är en pakethanterare, medan en operatör går ett steg längre. Det handlar om att stödja hela livscykeln. Det handlar inte bara om installation, utan även om dagliga uppgifter som inkluderar skalning, sharding, det vill säga allt som måste utföras under livscykeln (om det behövs, även borttagning) - det är allt en operatör hanterar. Han försöker automatisera och underhålla hela programvarans livscykel. Det är hans fundamentala skillnad från andra lösningar på marknaden.
Detta var den inledande delen, låt oss gå vidare.
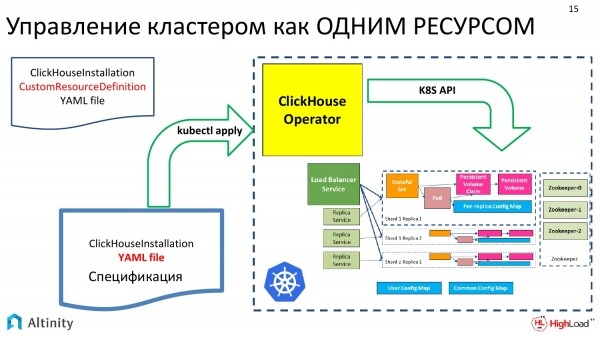
Hur bygger vi vår operatör? Vi försöker närma oss frågan om hur man hanterar en ClickHouse-kluster som en resurs.
Här på vänster sida av bilden har vi indata. Det här är YAML med specifikationen för klustret, som på det klassiska sättet överförs till Kubernetes via kubectl. Där fångar operatören upp det, gör sin magi. Och ut kommer vi med en sådan här schema. Detta är implementeringen av ClickHouse i Kubernetes.
Och så kommer vi långsamt att se hur operatören faktiskt fungerar, vilka repetitiva uppgifter som kan lösas. Vi kommer endast att titta på typiska uppgifter, eftersom vi har begränsad tid. Det kommer inte att handla om allt vad operatören kan hantera.
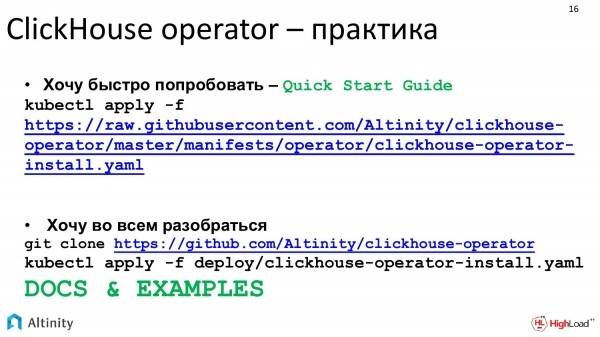
Låt oss basera oss på praktiken. Vårt projekt är helt open source, så man kan titta på GitHub hur det fungerar. Och man kan basera sig på överväganden, om man bara vill sätta igång, kan man börja med Quick Start Guide.
Om man vill gå på djupet, försöker vi hålla dokumentationen i ett hyfsat skick.
Låt oss börja med en praktisk uppgift. Den första uppgiften vi vill starta med är att köra det första exemplet på något sätt. Hur kör man ClickHouse med hjälp av operatören, även om man inte riktigt vet hur den fungerar? Vi skriver en manifest, eftersom all kommunikation med k8s sker genom manifester.
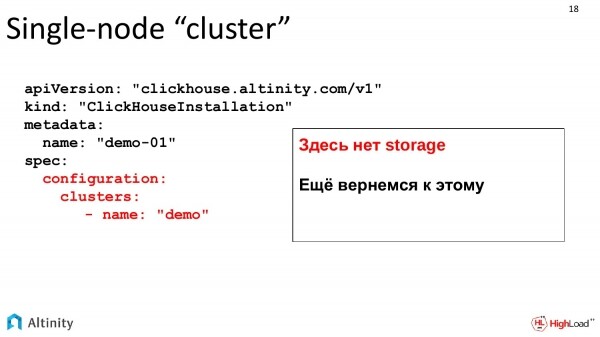
Här är en komplex manifest. Det som vi har markerat i rött är det som vi måste fokusera på. Vi ber operatören att skapa ett kluster med namnet demo.
Detta är grundläggande exempel. Storage beskrivs ännu inte, men vi kommer tillbaka till storage lite senare. För nu kommer vi att observera utvecklingen av klustret i realtid.
Vi har skapat denna manifest. Vi matar den till vår operatör. Den har arbetat, gjort sin magi.
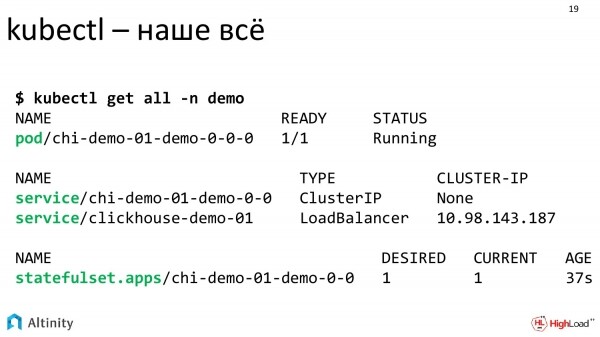
Vi kollar i konsolen. Tre komponenter väcker intresse – det är Pod, två tjänster och StatefulSet.
Operatören har arbetat, och vi kan titta på vad den har skapat.
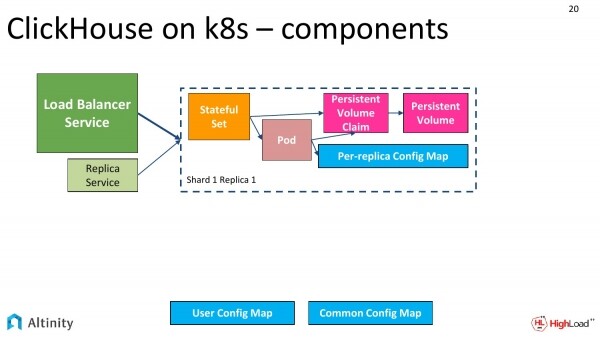
Den skapar ungefär ett sådant schema. Vi har StatefulSet, Pod, ConfigMap för varje replika, ConfigMap för hela klustret. Tjänsterna är nödvändigtvis ingångspunkter för klustret.
Tjänster är den centrala Load Balancer-tjänsten och man kan även ha en för varje replika, för varje shard.
Här är vårt grundläggande kluster som ser ut ungefär så här. Det består av en enda nod.
Vi går vidare och komplicerar saker. Klustret måste shardas.
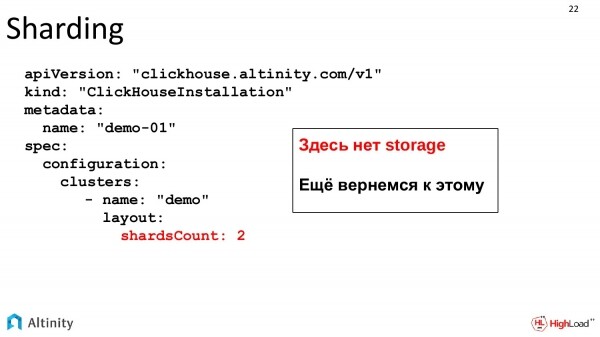
Våra uppgifter ökar, dynamiken börjar. Vi vill lägga till en shard. Vi följer utvecklingen. Vi ändrar vår specifikation. Vi anger att vi vill ha två shards.
Detta är samma fil som dynamiskt utvecklas med systemets tillväxt. Storage finns inte, det kommer att diskuteras senare, det är ett separat ämne.
Vi matar YAML-operatören och ser vad som händer.
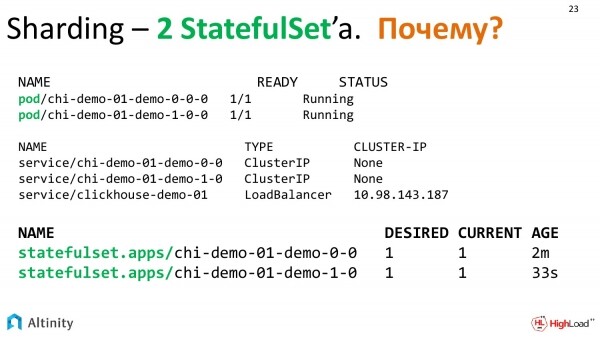
Operatören tänkte efter och skapade följande entiteter. Vi har redan två Pods, tre tjänster och plötsligt, 2 StatefulSets. Varför 2 StatefulSets?
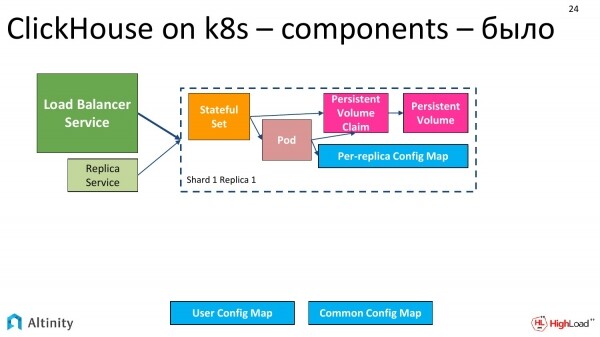
På schemat var det så här – detta är vårt ursprungliga tillstånd, när vi hade en pod.
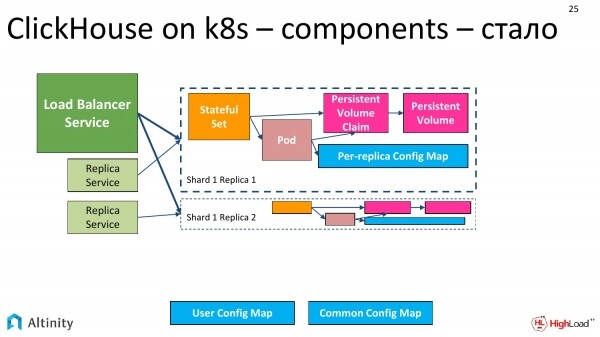
Det blev så här. För nu är allt enkelt, det har duplicerats.
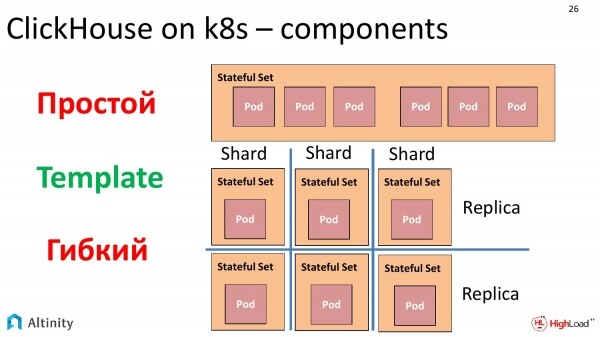
Och varför blev StatefulSet två? Här måste vi avledas och diskutera hur Kubernetes hanterar Pods.
Det finns ett objekt som heter StatefulSet, som gör att man kan skapa en uppsättning Pods från en mall. Här är nyckelfaktorn – den här mallen. Och man kan starta många Pods från en mall inom en StatefulSet. Nyckelfrasen här är 'många Pods från en och samma mall'.
Det fanns en stor frestelse att skapa hela klustret genom att packa det i en enda StatefulSet. Det skulle fungera, det finns inga problem med det. Men det finns en liten nyans. Om vi vill bygga ett heterogent kluster, det vill säga med flera versioner av ClickHouse, så börjar vi få frågor. Ja, StatefulSet kan göra en rolling update, och man kan rulla ut en ny version, och förklara att man inte bör försöka uppgradera fler än ett visst antal noder samtidigt.
Men om vi extrapolerar uppgiften och säger att vi vill skapa ett helt heterogent kluster, där vi vill skapa ett heterogent kluster både med olika versioner av ClickHouse och med olika lagring. Vi vill till exempel skapa vissa repliker på separata diskar, på långsamma diskar, i grunden bygga ett helt heterogent kluster. Och eftersom StatefulSet skapar en standardiserad lösning från en och samma mall, så finns det ingen möjlighet att göra detta.
Efter viss eftertanke togs beslutet att göra så här. Varje replik har sin egen StatefulSet. Det finns vissa nackdelar med denna lösning, men i praktiken inkapslar den fullt ut operatorn. Det finns också många fördelar. Vi kan bygga exakt det kluster vi vill, till exempel helt heterogent. Därför, i klustret där vi har två shardar med en replik vardera, kommer vi att ha 2 StatefulSets och 2 Pods just för att vi valde detta tillvägagångssätt på grund av de ovan nämnda skälen för möjligheten att bygga ett heterogent kluster.
Låt oss återgå till praktiska uppgifter. I vårt kluster behöver vi konfigurera användare, det vill säga vi måste göra någon slags konfiguration av ClickHouse i Kubernetes. Operatören tillhandahåller alla möjligheter för detta.
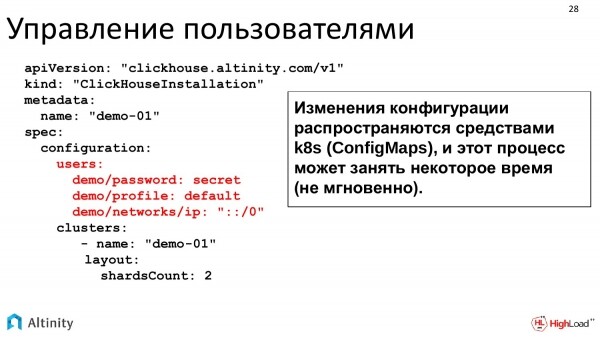
Vi kan skriva direkt i YAML vad vi vill. Alla konfigurationsalternativ mappas direkt från denna YAML till ClickHouse-konfigurationer, som sedan sprids över hela klustret.
Detta är ett alternativ. Som ett exempel kan lösenordet göras krypterat. Alla konfigurationsalternativ för ClickHouse stöds. Här är det bara ett exempel.
Konfigurationen för klustret distribueras som ConfigMap. I praktiken sker uppdateringen av ConfigMap inte omedelbart, så om klustret är stort tar processen att trycka ut konfigurationen en viss tid. Men allt detta är mycket praktiskt i drift.
Vi komplicerar uppgiften. Klustret utvecklas. Vi vill replikera data. Det vill säga, vi har redan två shardar, med en replik vardera, och användarna är inställda. Vi växer och vill ägna oss åt replikering.
Vad behöver vi för replikering?
Vi behöver ZooKeeper. I ClickHouse är replikering byggd med hjälp av ZooKeeper. ZooKeeper behövs för att olika replikor av ClickHouse ska ha konsensus om vilka datablokkar som finns på vilken ClickHouse.
Vilken ZooKeeper som helst kan användas. Om företaget har en extern ZooKeeper kan den användas. Om inte, kan vi installera en från vårt repository. Det finns en installationsprogram som underlättar detta.
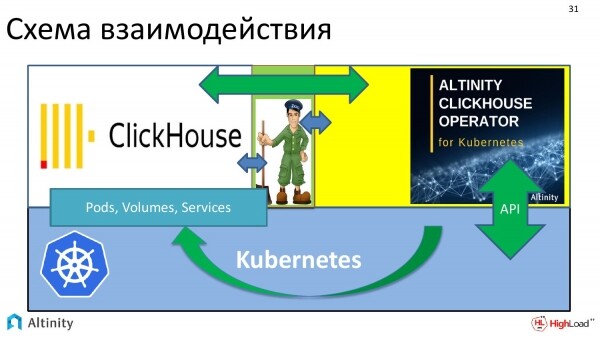
Och interaktionsschemat för hela systemet ser ut så här. Vi har Kubernetes som plattform. På den körs ClickHouse-operatören. ZooKeeper har jag illustrerat här. Operatören interagerar både med ClickHouse och med ZooKeeper. Det vill säga, det blir en interaktion.
Och allt detta behövs för att ClickHouse framgångsrikt ska kunna replikera data i k8s.
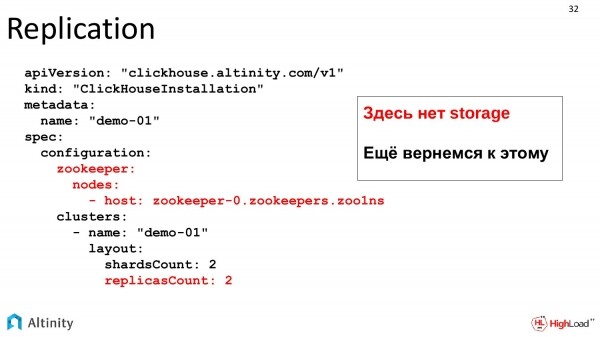
Låt oss nu titta på själva uppgiften, hur manifestet för replikering kommer att se ut.
Vi lägger till två sektioner till vårt manifest. Den första är var vi ska hämta ZooKeeper, som kan vara antingen inuti Kubernetes eller extern. Detta är bara en beskrivning. Och vi begär replikor. Det vill säga, vi vill ha två replikor. Så totalt ska vi ha 4 poddar. Vi kommer ihåg lagringen, den kommer tillbaka lite längre fram. Lagring är en egen historia.
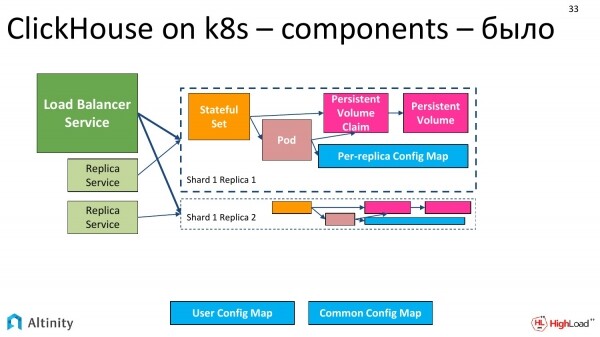
Det var så här.
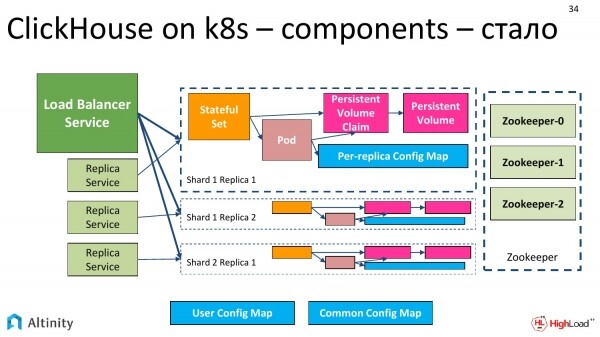
Det blir så här. Replikor läggs till. Den fjärde fick inte plats, så vi tror att det kan finnas många där. Och ZooKeeper läggs till på sidan. Scheman blir mer komplexa.
Och det är dags att lägga till nästa uppgift. Vi kommer att lägga till Persistent Storage.
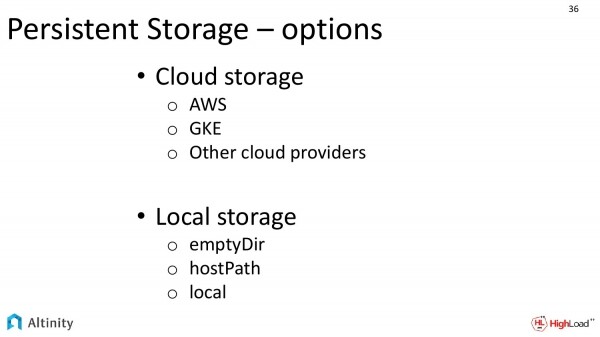 När det gäller Persistent Storage har vi olika implementationsalternativ.
Om vi kör i en molnleverantör, till exempel, när vi använder Amazon, Google, finns det en stark frestelse att använda molnlagring. Det är mycket bekvämt, det är bra.
Och det finns ett andra alternativ. Det är för lokal lagring, när vi har lokala diskar på varje nod. Detta alternativ är mycket svårare att implementera, men det är mer effektivt.
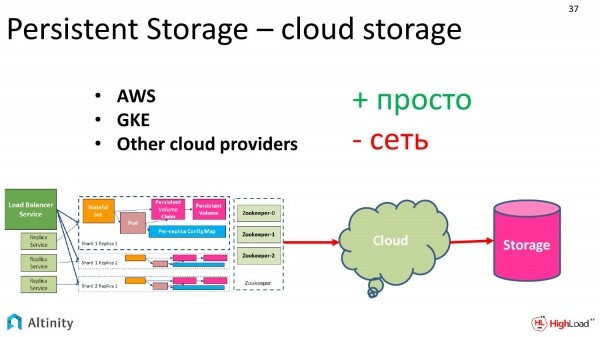
Låt oss titta på vad vi har när det gäller molnlagring.
Det finns fördelar. Det är mycket enkelt att konfigurera. Vi beställer bara hos molnleverantören, att ge oss lagring av viss kapacitet och klass. Klasserna är specificerade av leverantörerna själva.
Och det finns en nackdel. För vissa är detta en icke-kritisk nackdel. Självklart kommer det att finnas vissa prestandaproblem. Det är mycket praktiskt att arbeta med, pålitligt, men det finns vissa potentiella prestandautmaningar.
Och eftersom ClickHouse fokuserar just på prestanda, kan man till och med säga att det pressar allt som går, därför försöker många kunder maximera prestandan.
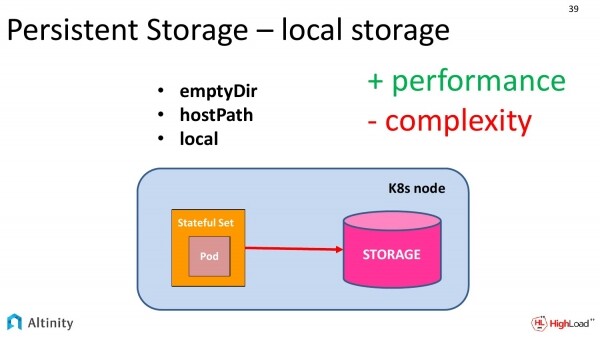
För att maximera detta behöver vi lokal lagring.
Kubernetes tillhandahåller tre abstraktioner för användning av lokal lagring i Kubernetes. Dessa är:
- EmptyDir
- HostPath.
- Local
Låt oss titta på hur de skiljer sig åt och vad de har gemensamt.
För det första har vi i alla tre metoderna lagring – det är lokala diskar som finns på samma fysiska k8s-nod. Men de har vissa skillnader.
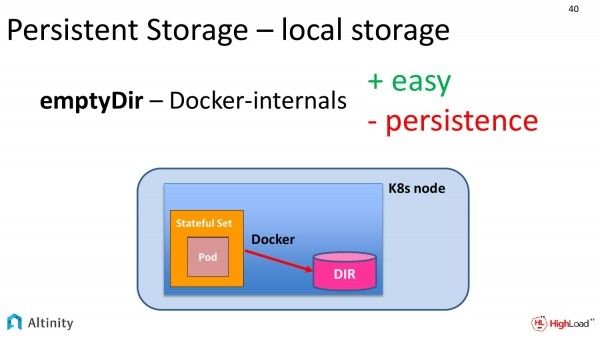
Vi börjar med det enklaste, dvs. med emptyDir. Vad är detta i praktiken? Det är när vi ber vårt system för containerhantering (oftast Docker) att ge oss åtkomst till en mapp på den lokala disken.
I praktiken skapar Docker någonstans på sina egna vägar en temporär mapp, döper den till en lång hash. Och ger ett gränssnitt för åtkomst till den.
Hur kommer detta att fungera sett till prestanda? Det kommer att fungera med hastigheten av den lokala disken, dvs. det är en fullständig åtkomst till sin enhet.
Men detta har sin nackdel. Persistent i detta avseende är ganska osäkert. Vid den minsta inverkan av Docker på containrarna förloras persistent data. Om Kubernetes av någon anledning vill flytta denna Pod till en annan disk, så går uppgifterna förlorade.
Denna metod är bra för tester, eftersom hastigheten redan är acceptabel, men för något mer seriöst är detta alternativ inte lämpligt.
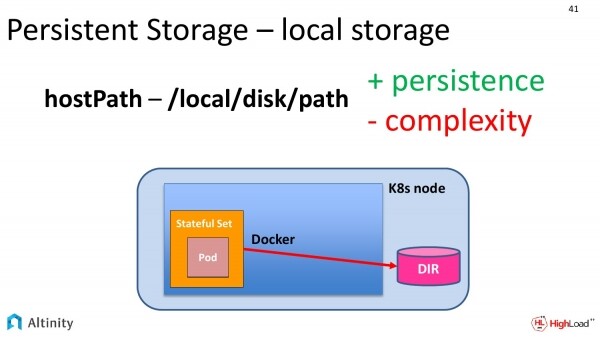
Därför finns det en andra metod. Det är hostPath. Om man tittar på den föregående sliden och denna, så kan man se bara en enda skillnad. Vår mapp har flyttat från Docker direkt till Kubernetes-noden. Här är det lite enklare. Vi anger direkt sökvägen i det lokala filsystemet där vi vill lagra våra data.
Fördelar finns med denna metod. Det är redan en riktig persistent lagring, och dessutom klassisk. Uppgifterna kommer att skrivas till disken på en viss adress.
Det finns nackdelar. Det handlar om hanteringskomplexitet. Vår Kubernetes kan vilja flytta en Pod till en annan fysisk nod. Här kommer DevOps in i bilden. De måste förklara systemet korrekt att dessa pods bara kan flyttas till sådana noder som har något monterat längs dessa vägar, och högst en nod åt gången. Det är ganska komplicerat.
För dessa ändamål har vi skapat mallar hos oss som operatör för att dölja all denna komplexitet. Man skulle enkelt kunna säga: "Jag vill ha en instans av ClickHouse på varje fysisk nod och i en specifik sökväg."
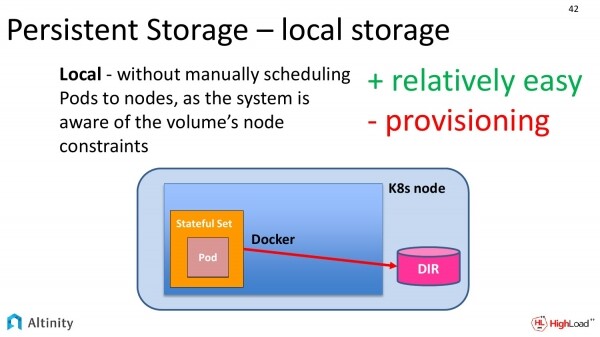
Men denna nödvändighet gäller inte bara oss, därför förstår även herrarna från Kubernetes att människor vill ha tillgång till fysiska diskar, så de erbjuder en tredje nivå.
Den kallas local. Det finns praktiskt taget ingen skillnad från föregående bild. Tidigare var vi tvungna att manuellt genomföra att dessa pods inte kunde flyttas från nod till nod, eftersom de måste vara kopplade langs en specifik sökväg till den lokala fysiska disken, men nu inkapslas all denna kunskap inom Kubernetes. Det blir mycket enklare att konfigurera.
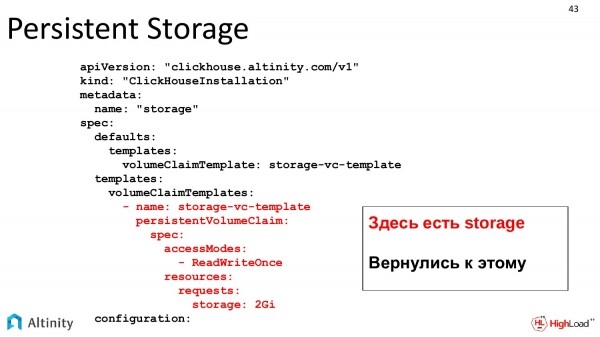
Låt oss återgå till vår praktiska uppgift. Låt oss återgå till YAML-mallen. Här har vi en riktig lagring. Vi kom tillbaka till detta. Vi definierar en klassisk VolumeClaim-mall som i k8s. Och beskriver vilken lagring vi vill ha.
Efter detta kommer k8s att begära lagring. Det kommer att tilldela det till oss i StatefulSet. Och slutligen kommer det att bli tillgängligt för ClickHouse.
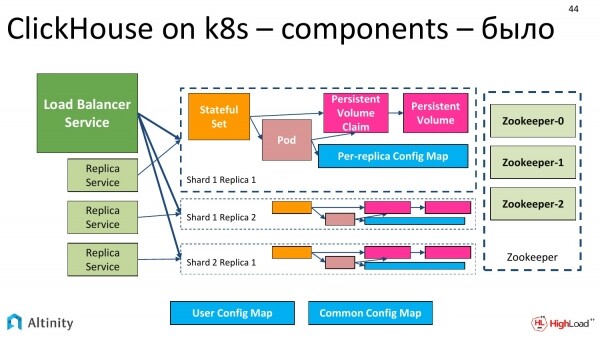
Vi hade en sådan här schema. Vår Persistenta Lagring var röd, vilket liksom antydde att vi borde åtgärda det.
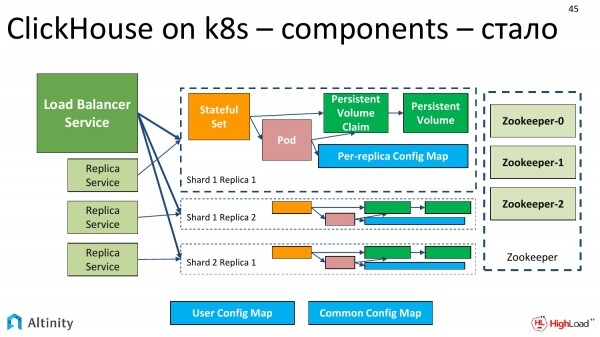
Och den blir grön. Nu har schemat för ClickHouse-klustret på k8s fullbordats. Vi har shards, repliker, ZooKeeper, och det finns en riktig Persistent, som har realiserats på olika sätt. Schemat är nu helt fungerande.
Vi fortsätter framåt. Vårt kluster växer. Och Aleksej anstränger sig och släpper en ny version av ClickHouse.
En praktisk uppgift uppstår – att testa den nya versionen av ClickHouse på vårt kluster. Naturligtvis vill vi inte rulla ut den helt, vi vill kanske sätta en ny version i ett avlägset hörn på en replika, och kanske inte bara en ny version, utan två, eftersom de släpps ganska ofta.
Vad kan vi säga om detta?
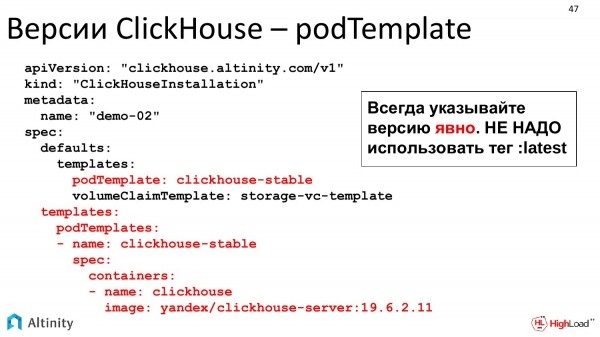
Här har vi precis en sådan möjlighet. Det handlar om mallarna för poddar. Vi kan specificera hur vår operator helt och hållet tillåter att bygga en heterogen kluster. Det vill säga konfigurera, från att ha alla repliker i en hög, till att ha varje individuell replika med vilken version av ClickHouse vi vill ha, vilken lagringsversion vi vill ha. Vi kan helt konfigurera klustret enligt den konfiguration vi behöver.
Nu kommer vi att fördjupa oss lite mer. Tidigare har vi pratat om hur ClickHouse-operatorn fungerar specifikt för ClickHouse.
Nu skulle jag vilja säga några ord om hur vilken operator som helst fungerar, samt hur den interagerar med K8s.
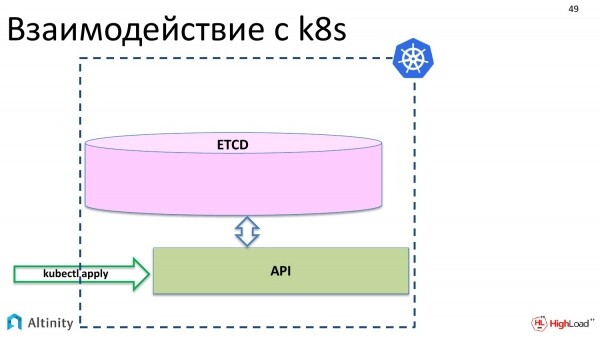
Vi börjar med att titta på interaktionen med K8s. Vad händer när vi gör kubectl apply? Våra objekt dyker upp i etcd via API:et.
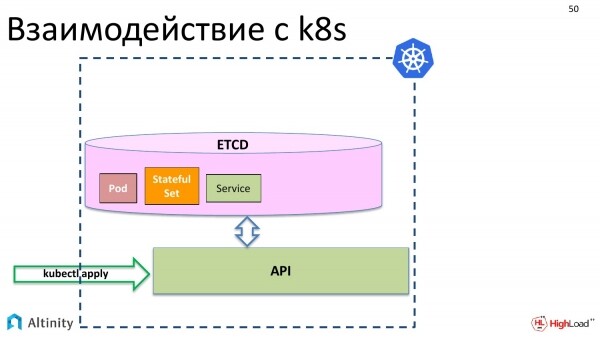
Till exempel de grundläggande objekten i Kubernetes: pod, StatefulSet, service och så vidare.
Ingenting fysiskt händer ännu. Dessa objekt måste materialiseras i klustret.
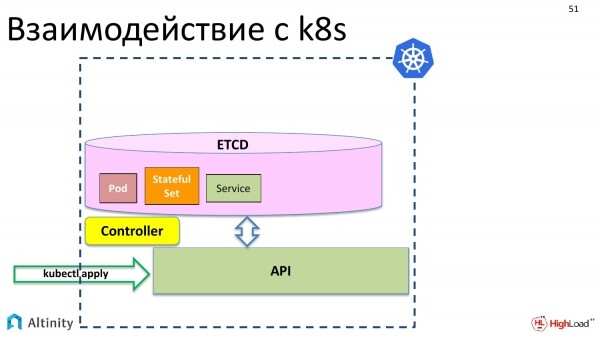
För detta kommer en controller in i bilden. En controller är en speciell komponent i k8s som vet hur man materialiserar dessa beskrivningar. Den vet hur och vad som måste göras fysiskt. Den vet hur man startar containrar och vad som måste konfigureras för att servern ska fungera.
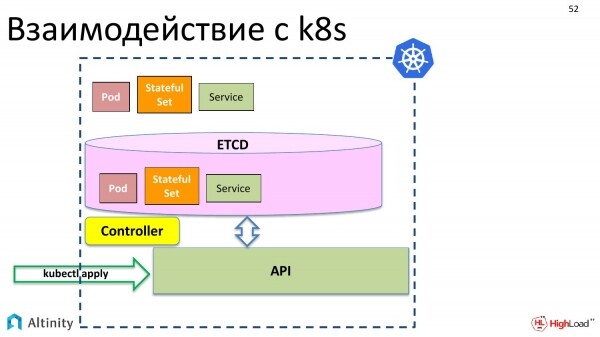
Och den materialiserar våra objekt i K8s.
Men vi vill inte bara hantera poddar och StatefulSet:er, vi vill skapa ClickHouseInstallation, det vill säga ett objekt av typen ClickHouse, för att hantera det som en helhet. För närvarande finns det ingen sådan möjlighet.
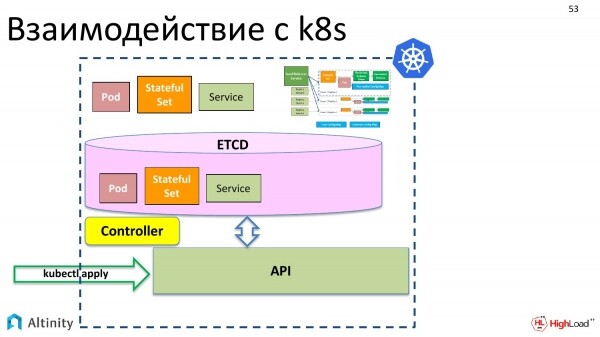
Men K8s har en annan trevlig funktion. Vi vill att det ska finnas en sådan komplex entitet där vår kluster sammanställs av poddar och StatefulSet.
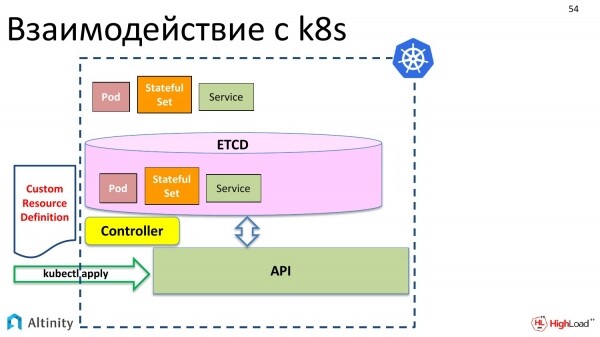
Vad behöver vi göra för detta? För det första kommer Custom Resource Definition in på scenen. Vad är det? Det är en beskrivning för K8s av att du kommer få ytterligare en datatyp, och att vi vill lägga till en anpassad resurs för poddar och StatefulSet, som blir komplex inuti. Det är en beskrivning av datastukturen.
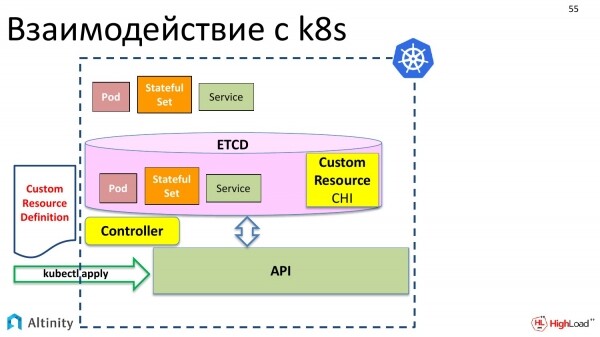
Vi skickar också denna via kubectl apply dit. Kubernetes tar den med glädje.
Och nu har vi i lagringen, hos objektet i etcd, möjlighet att registrera den anpassade resursen med namnet ClickHouseInstallation.
Men för nu kommer ingenting att hända. D.v.s. om vi nu skapar en YAML-fil som vi diskuterade med beskrivning av shards, repliker och säger "kubectl apply", så kommer Kubernetes att ta emot den, spara den i etcd och säga: "Bra, men jag vet inte vad jag ska göra med den. Jag vet inte hur man underhåller ClickHouseInstallation."
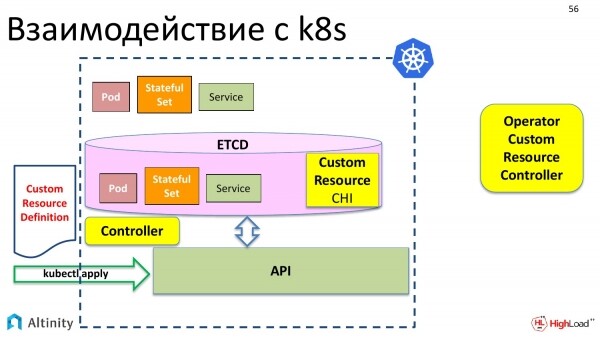
Därför behöver vi någon som hjälper Kubernetes att underhålla den nya datatypen. Till vänster har vi den inbyggda Kubernetes-controllern som arbetar med inbyggda datatyper. Och till höger bör vi få en anpassad controller som kan arbeta med anpassade datatyper.
Och på ett annat sätt kallas den operatör. Jag har specifikt placerat den utanför Kubernetes, eftersom den kan köras utanför K8s. Oftast körs dock alla operatörer i Kubernetes, men ingenting hindrar den från att stå utanför, därför har den placerats externt här.
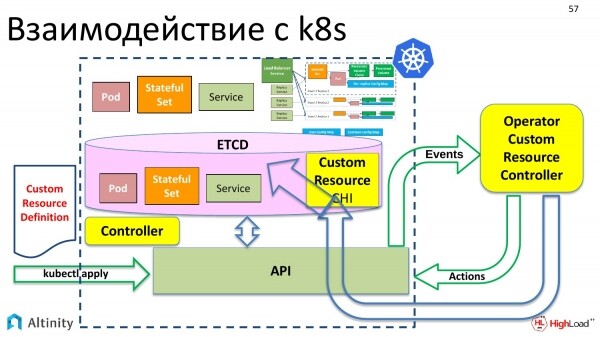
Och i sin tur interagerar den anpassade controllern, även kallad operatör, med Kubernetes via API. Den kan redan interagera med API. Och den vet redan hur man materialiserar en komplex struktur från en anpassad resurs, som vi vill skapa. Det är precis det operatören gör.
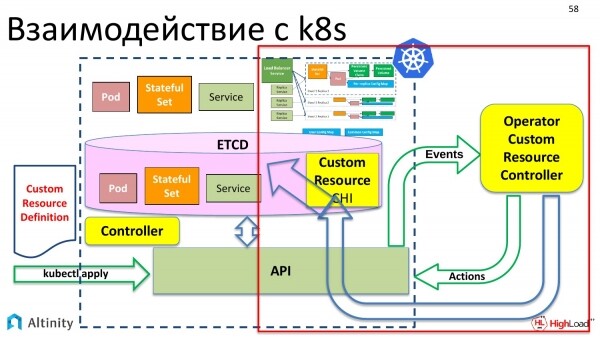
Hur fungerar operatören? Låt oss titta på den högra delen för att förstå hur den gör detta. Vi ska ta reda på hur operatören materialiserar allt detta och hur interaktionen med K8s går till.
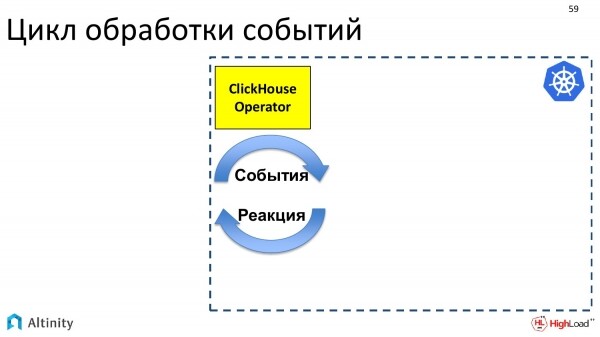
Operatören är ett program. Det är händelsestyrt. Operatören registrerar sig via Kubernetes API för händelser. I Kubernetes API finns ingångspunkter där man kan registrera sig för händelser. Och om något förändras i K8s, skickar Kubernetes händelser till alla som vill, d.v.s. den som har registrerat sig på den här API-punkten får meddelanden.
Operatören registrerar sig för händelser och måste reagera på dem. Dess uppgift är att reagera på uppkommande händelser.
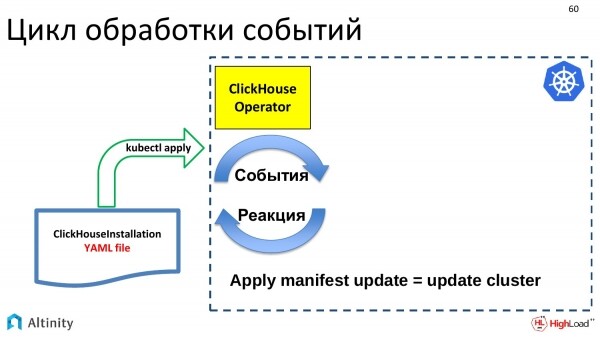
Händelser genereras av vissa uppdateringar. Vår YAML-fil med beskrivningen av ClickHouseInstallation kommer in. Den har gått till etcd genom kubectl apply. Där utlöste det en händelse, och denna händelse kom till ClickHouse-operatören. Operatören fick denna beskrivning. Och den måste göra något. Om en uppdatering av objektet ClickHouseInstallation har kommit, så måste klustret uppdateras. Och operatörens uppgift är att uppdatera klustret.
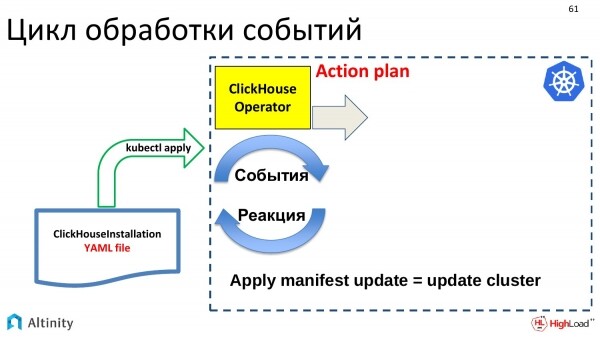
Vad gör han? Först och främst måste en handlingsplan upprättas för vad vi ska göra med denna uppdatering. Uppdateringar kan vara mycket små, det vill säga små i YAML-implementering, men de kan leda till mycket stora förändringar i klustret. Därför skapar operatören en plan och följer den därefter.
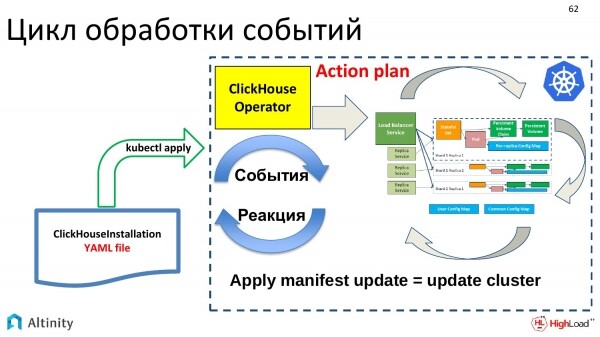
Han börjar att enligt denna plan bearbeta denna struktur inuti för att materialisera poddar, tjänster, det vill säga göra det som är hans huvuduppgift. Det är som att bygga ett ClickHouse-kluster i Kubernetes.
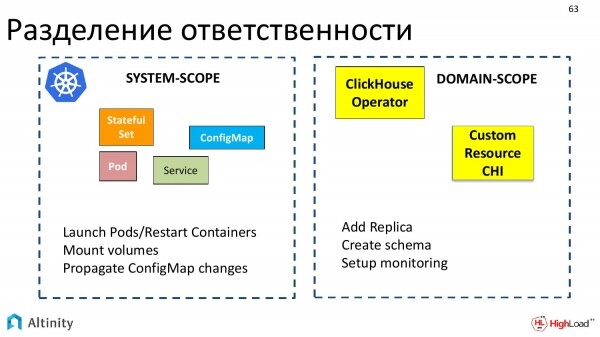
Nu ska vi ta upp en intressant sak. Det är delningen av ansvar mellan Kubernetes och operatören, det vill säga vad Kubernetes gör, vad operatören gör och hur de interagerar med varandra.
Kubernetes ansvarar för systemrelaterade saker, det vill säga för den grundläggande uppsättningen objekt som kan tolkas som systemomfattande. Kubernetes vet hur man startar poddar, hur man startar om containrar, hur man monterar volymer, hur man arbetar med ConfigMap, det vill säga allt som kan kallas systemet.
Operatörer arbetar inom specifika ämnesområden. Varje operatör är specifik för sitt ämnesområde. Vi har gjort en för ClickHouse.
Och operatören interagerar just i termer av ämnesområden, såsom att lägga till en replik, skapa ett schema, ställa in övervakning. Det blir en sådan separation.
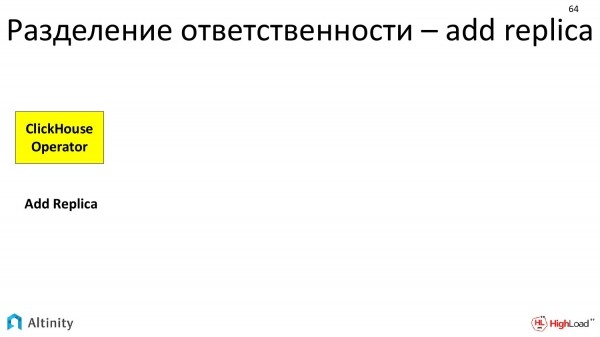
Låt oss titta på ett praktiskt exempel på hur denna ansvarsdela sker när vi utför åtgärden att lägga till en replik.
Operatören får i uppdrag att lägga till en replik. Vad gör operatören? Operatören beräknar att en ny StatefulSet måste skapas, där sådana mallar och volymanspråk måste beskrivas.
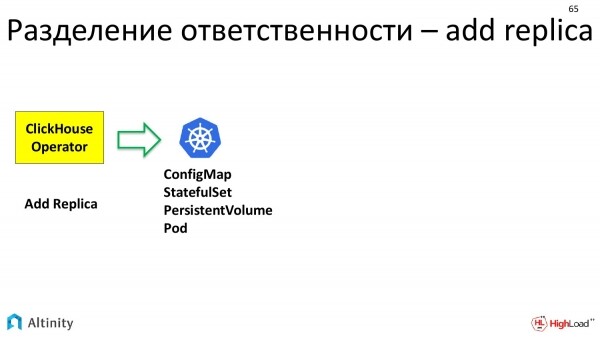
Han har förberett allt detta och vidarebefordrar det till K8s. Han säger att han behöver ConfigMap, StatefulSet, Volym. Kubernetes utför det. Han materialiserar de grundläggande enheter som han arbetar med.
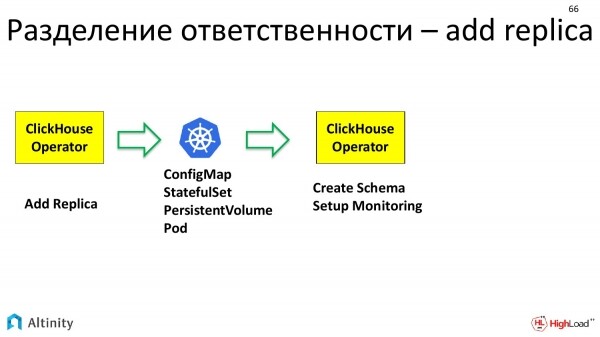
Och sedan kommer ClickHouse-operatören återigen in i bilden. Han har redan en fysisk pod där man kan göra något. Och ClickHouse-operatören arbetar återigen i termer av ämnesområden. Det vill säga för ClickHouse, för att aktivera en replik i klustret, måste dataskeman som finns i detta kluster ställas in. Och för det andra måste denna replik inkluderas i övervakning så att den kan spåras väl. Det är operatören som ställer detta in.
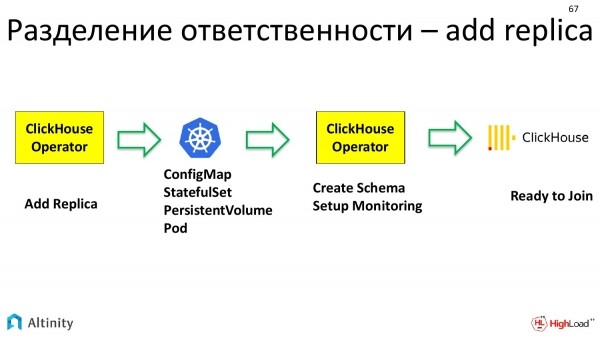
Och först efter detta kommer själva ClickHouse i spel, det vill säga ytterligare en mer högstående enhet. Detta är redan en databas. Den har sin egen instans, en konfigurerad replika som är redo att gå in i klustret.
Det blir en lång kedja av utförande och ansvarsfördelning vid tillägg av en replika.
Vi fortsätter med våra praktiska uppgifter. Om klustret redan finns kan vi genomföra migrering av konfigurering.
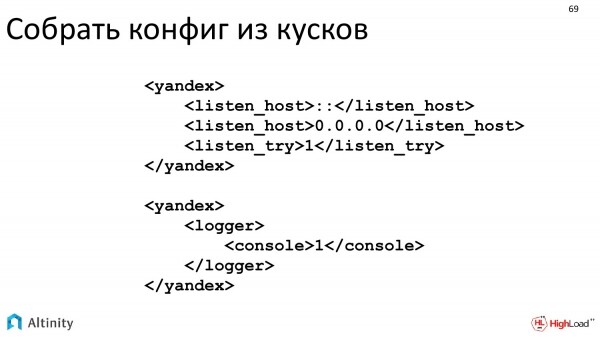
Vi har gjort det så att i den befintliga xml som ClickHouse förstår kan vi skicka igenom data.
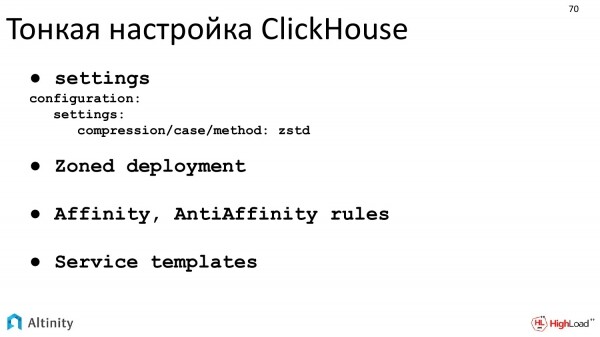
Det går att göra en finjustering av ClickHouse. Just zonad distribution är det jag nämnde när jag förklarade hostPath, lokal lagring. Hur man korrekt gör zonad distribution.
Den nästa praktiska uppgiften är övervakning.
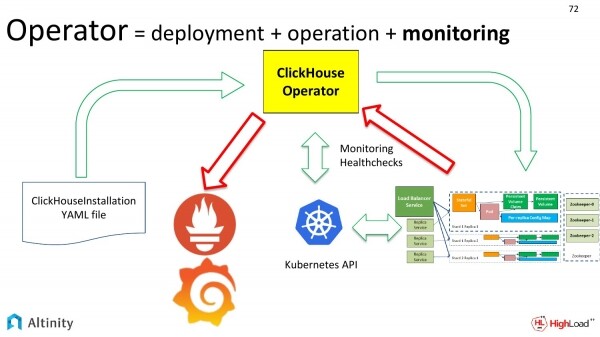
Om vårt kluster förändras måste vi periodiskt ställa in övervakningen.
Låt oss titta på schemat. Vi har redan diskuterat de gröna pilarna. Nu låt oss titta på de röda pilarna. Det är hur vi vill övervaka vårt kluster. Hur mätvärden från ClickHouse-klustret hamnar i Prometheus, och sedan i Grafana.
Vad är svårigheten med övervakning? Varför framhålls det som någon slags prestation? Svårigheten ligger just i dynamiken. När vi har ett kluster och det är statiskt kan vi en gång ställa in övervakningen och sedan inte bekymra oss mer.
Men om vi har många kluster, eller om något ständigt ändras, så är processen dynamisk. Att ständigt behöva omkonfigurera övervakningen är en slöseri med resurser och tid, det vill säga även bara lathet. Detta måste automatiseras. Svårigheten ligger just i den dynamiska processen. Och operatören automatiserar detta mycket bra.
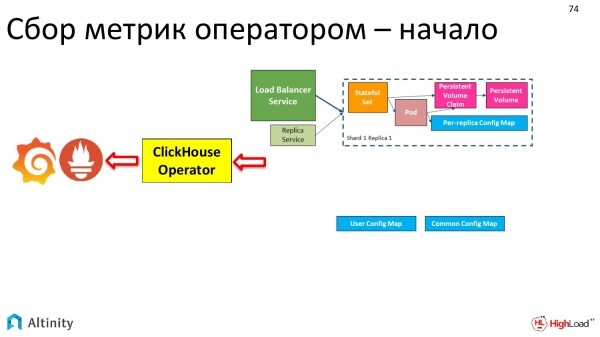
Hur har vårt kluster utvecklats? I början såg det ut så här.
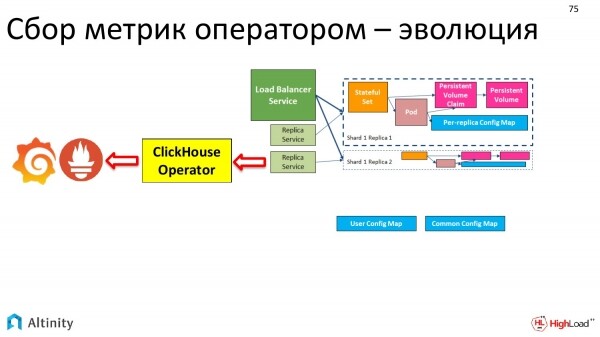
Sedan såg det ut så här.
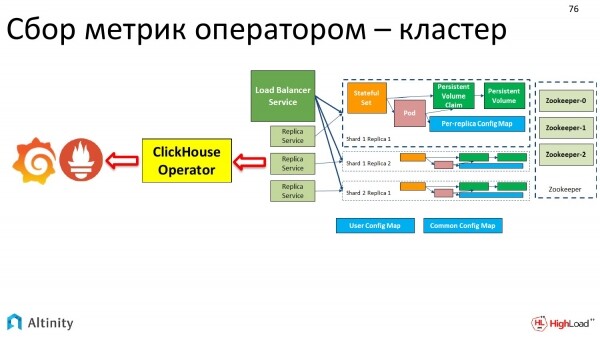
I slutändan blev det så här.
Och övervakningen görs automatiskt av operatören. En enda ingångspunkt.
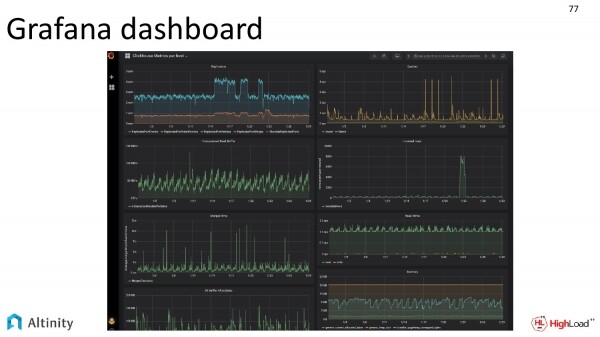
Och vi tittar bara på utdata i Grafana-dashboarden, hur livet i vårt kluster pulserar inuti.
För övrigt sprids också Grafana-dashboards med vår operatör direkt i källkoden. Man kan ansluta och använda det. Denna skärmdump fick jag av våra DevOps.
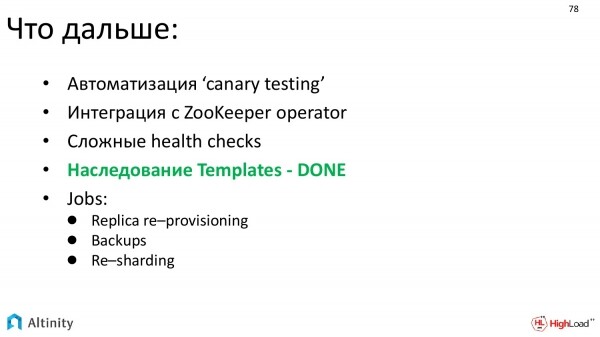
Vart skulle vi vilja gå härifrån? Det är:
- Att utveckla automatisering av testning. Huvuduppgiften är automatisk testning av nya versioner.
- Vi vill också automatisera integrationen med ZooKeeper. Vi planerar att integrera med ZooKeeper-operatorn. Det vill säga, en operator för ZooKeeper har skrivits och det är logiskt att de två operatorerna börjar integrera sig för att bygga en mer bekväm lösning.
- Vi vill göra mer komplexa livscykelkontroller.
- Jag har markerat i grönt det som är på gång — arv av mallar – KLAR, alltså i nästa version av operatorn kommer vi redan att ha möjligheten att arva mallar. Detta är ett kraftfullt verktyg som möjliggör att bygga komplexa konfigurationer från bitar.
- Och vi vill automatisera komplexa uppgifter. Den största av dem är Re-sharding.
Låt oss göra en mellanliggande sammanfattning.
Vad får vi ut på andra sidan? Är det värt att syssla med detta eller inte? Borde vi alls försöka dra databasen till Kubernetes och använda operatorn i allmänhet och Alitnity-operatorn i synnerhet?
Resultatet blir:
- Väsentlig förenkling och automatisering av konfiguration, distribution samt underhåll.
- Omedelbart inbyggd övervakning.
- Och färdiga, kodifierade mallar för komplexa situationer. Redan åtgärder som att lägga till en replik behöver inte göras manuellt. Det gör operatorn.
Det finns bara en sista fråga kvar. Vi har redan databasen i Kubernetes, virtualisering. Hur är det med prestandan hos en sådan lösning, särskilt med tanke på att ClickHouse är optimerad för prestanda?
Svaret – allt är okej! Jag kommer inte att gå in på detaljer, det är ett ämne för en separat presentation.
Men det finns ett projekt som heter TSBS. Vad är dess huvuduppgift? Det är en prestandatest av databaser. Det är ett försök att jämföra lika med lika.
Hur fungerar det? En uppsättning data genereras. Sedan körs denna uppsättning data genom samma uppsättning tester på olika databaser. Och varje databas löser en uppgift på det sätt som den kan. Sedan kan resultaten jämföras.
Det stöder redan många databaser. Jag har markerat tre huvudsakliga. Det är:
- TimescaleDB.
- InfluxDB.
- ClickHouse.
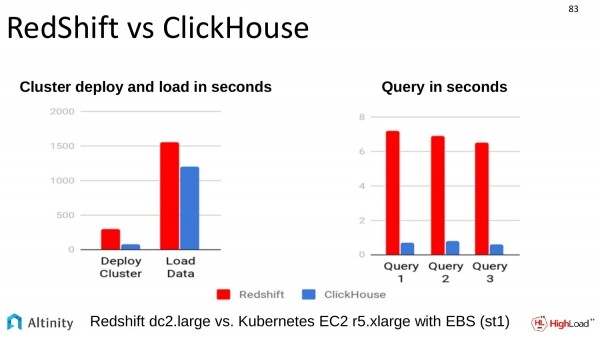
Det har också gjorts en jämförelse med en annan liknande lösning. En jämförelse med RedShift. Jämförelsen gjordes på Amazon. ClickHouse slår också alla i denna fråga.
Vilka slutsatser kan dras från det jag har berättat?
- Databaser i Kubernetes är möjliga. Troligtvis kan man använda vilken som helst, men överlag verkar det som att det är möjligt. ClickHouse i Kubernetes kan definitivt användas av vår operatör.
- Operatören hjälper till att automatisera processer och förenklar verkligen livet.
- Prestandan är normal.
- Och vi tycker att detta är något som både kan och bör användas.
Öppen källkod – gå med!
Som jag redan nämnt, operatören är en helt öppen källkodsprodukt, så det skulle vara mycket bra om så många som möjligt använde den. Gå med! Vi väntar på er alla!
Tack alla!
Frågor
Tack för presentationen! Jag heter Anton. Jag kommer från företaget SEMrush. Jag undrar över loggning. Jag har hört om övervakning, men inget om loggning när det gäller hela klustret. Vi har exempelvis satt upp ett kluster på hårdvara. Och vi använder centraliserad loggning, samlar in med standardverktyg till en gemensam plats. Och sedan hämtar vi intressanta data därifrån.
Bra fråga, det vill säga loggning står på listan över att göra. Vår operatör automatiserar fortfarande inte detta. Den utvecklas fortfarande, projektet är relativt ungt. Vi förstår behovet av loggning. Det är också ett mycket viktigt ämne. Och det är nog inte mindre viktigt än övervakning. Men först på listan för implementering var övervakning. Loggning kommer att ske. Vi försöker naturligtvis automatisera alla aspekter av klusterets livscykel. Så svaret är att i nuläget kan operatören tyvärr inte detta, men det finns på planerna, vi kommer att göra detta. Om det finns intresse att gå med, gör gärna en pull request.
Hej! Tack för presentationen! Jag har en standardfråga som rör Persistenta Volymer. När vi skapar en konfiguration med denna operatör, hur bestämmer operatören på vilken nod vi har monterat en viss disk eller mapp? Måste vi förklara för den att den ska placera vår ClickHouse just på dessa noder där det finns en disk?
Såvitt jag förstår, denna fråga är en fortsättning på lokal lagring, särskilt delen som rör hostPath. Det handlar om att förklara hela systemet att en pod ska startas på en viss nod, där vi har en fysiskt ansluten disk som är monterad på en viss väg. Det är en hel sektion som jag endast berört ytligt, för svaret är ganska omfattande.
Sammanfattningsvis ser det ut så här. Självklart måste vi göra provisioning av dessa volymer. För närvarande finns det ingen dynamisk provisioning i lokal lagring, så DevOps måste själva partitionera diskarna, alltså dessa volymer. Och de måste förklara för Kubernetes provisioning att du kommer att ha Persistent volumes av en viss klass som finns på vissa noder. Sen måste de förklara för Kubernetes att poddar som kräver en viss klass av lokal lagring, måste schemaläggas endast på dessa noder. För dessa syften finns det möjlighet att tilldela vissa etiketter och en per värdinstans. Och det kommer att resultera i att poddarna kommer att routas av Kubernetes för att bara köras på noder som uppfyller kraven, etiketter, för att uttrycka det enkelt. Administratörerna tilldelar etiketter, gör provisioning av diskarna manuellt. Och då går det att skala.
Och just den tredje varianten av lokal lagring hjälper att förenkla detta något. Som jag redan har betonat, är det ett noggrant arbete med inställningar som i slutänden hjälper att få ut maximal prestanda.
Jag har en andra fråga som är relaterad till detta. Kubernetes är utformad så att vi inte ska bry oss om vi förlorar en nod eller inte. Vad ska vi göra i det här fallet om vi har förlorat noden där vår shard finns?
Ja, Kubernetes positionerade sig från början så att vår relation till våra poddar är som boskap, men här blir varje disk något som liknar ett husdjur. Det finns ett problem med att vi inte kan slänga dem hur som helst. Och utvecklingen av Kubernetes går i en riktning där vi inte kan helt hantera detta filosofiskt som helt förbrukningsbara resurser.
Nu till den praktiska frågan. Vad ska man göra om en nod som hade disken försvann? Här löser man problemet på en högre nivå. I fallet med ClickHouse har vi replikat som arbetar på en högre nivå, alltså på ClickHouse-nivå.
Vad blir dispositionen? DevOps ansvarar för att inga data går förlorade. De måste korrekt ställa in replikeringen och följa upp så att replikeringen utförs. I replikatet på ClickHouse-nivå måste data duplikeras. Det här är inte en uppgift som operatören löser. Och det är inte en uppgift som Kubernetes löser. Det ligger på ClickHouse-nivå.
Vad ska man göra om ni har en fysisk nod som har fallit bort? Så det blir nödvändigt att sätta upp en ny, korrekt provisionera en disk på den, applicera labels. Och efter det kommer den att uppfylla kraven så att Kubernetes kan starta en instans av podden på den. Kubernetes kommer att starta den. Ni har ju inte tillräckligt med pods enligt det angivna antalet. Den kommer att gå igenom cykeln som jag visade. Och på den översta nivån kommer ClickHouse att förstå att en replika har kommit in, den är fortfarande tom och vi måste börja överföra data till den. D.v.s. den här processen är fortfarande dåligt automatiserad.
Tack för presentationen! När det sker olika problem, faller operatören och startar om, och under den tiden kommer det in händelser, hanterar ni detta på något sätt?
Vad händer om operatören har fallit och startat om, eller hur?
Ja. Och under den tiden kom händelser.
Uppgiften om vad man ska göra i det här fallet delas delvis mellan operatören och Kubernetes. Kubernetes har möjlighet att återspela den inträffade händelsen. Den återspelar. Och operatörens uppgift är att se till att när han får en replay av händelselogg, så är dessa händelser idempotenta. Så att en upprepning av samma händelse inte bryter vår system. Och vår operatör klarar av den uppgiften.
Hej! Tack för presentationen! Dmitry Zavyalov, företaget Smedova. Planeras det att lägga till möjlighet att konfigurera operatören med haproxy? Det skulle vara intressant med någon annan lastbalanserare än den standardmässiga, som är smart och förstår att det verkligen handlar om ClickHouse.
Pratar ni om Ingress?
Ja, ersätt Ingress med haproxy. I haproxy kan man ange klustrets topologi, där den har repliker.
Vi har ännu inte tänkt på det. Om ni behöver det och kan förklara varför det behövs, så kan det genomföras, speciellt om ni vill delta. Vi kommer gärna att överväga alternativet. Kort svar – nej, vi har för närvarande inte den funktionen. Tack för tipset, vi kommer att titta på det. Om ni också kan förklara use case och varför det behövs i praktiken, till exempel, om ni skapar issues på GitHub, så vore det fantastiskt.
Det finns redan.
Bra. Vi är öppna för alla förslag. Och haproxy sätts på to-do-listan. To-do-listan växer och minskar inte för tillfället. Men det är bra, det betyder att produkten är efterfrågad.
Källa: habr.com
