

Obs. övers.: I denna artikel delar Banzai Cloud med sig av ett exempel på hur deras specialverktyg kan underlätta driften av Kafka inom Kubernetes. Instruktionerna visar hur man kan bestämma den optimala storleken på infrastrukturen och konfigurera Kafka för att uppnå önskad kapacitet.
Apache Kafka är en distribuerad strömmande plattform för skapande av pålitliga, skalbara och högpresterande realtids-system. Dess imponerande funktioner kan förstärkas med hjälp av Kubernetes. För detta har vi utvecklat och ett verktyg som kallas . De möjliggör driftsättning av Kafka i Kubernetes och utnyttja dess olika funktioner, såsom finjustering av broker-konfiguration, skalning baserad på metrics med ombalansering, rack awareness, "mjuk" (graceful) uppgradering av versioner m.m.
Testa Supertubes i din kluster:
curl https://getsupertubes.sh | sh och supertubes install -a --no-democluster --kubeconfigEller kontakta . Det går också att läsa om vissa funktioner av Kafka, vars hantering är automatiserad med hjälp av Supertubes och Kafka-operatorn. Vi har redan skrivit om dem i bloggen:
- ;
- ;
- ;
- ;
- ;
- ;
- .
När du beslutar att sätta upp en Kafka-kluster i Kubernetes kommer du säkert att stöta på problemet att bestämma den optimala storleken på den grundläggande infrastrukturen och behovet av att finjustera Kafka-konfigurationen för att möta kapacitetskraven. Den maximala prestandan för varje broker bestäms av prestandan hos infrastrukturens komponenter, såsom minne, processor, diskens hastighet, nätverkskapacitet osv.
I idealfallet bör brokerkonfigurationen vara sådan att alla infrastrukturella element används maximalt. Men i verkliga livet är en sådan inställning ganska svår. Det är mer sannolikt att användare konfigurerar brokerinställningar för att maximera användningen av en eller två komponenter (disk, minne eller processor). Generellt visar en broker maximal prestanda när dess konfiguration tillåter den långsammaste komponenten att utnyttjas fullt ut. På så sätt kan vi få en ungefärlig uppfattning om den belastning som en broker kan hantera.
Teoretiskt kan vi även uppskatta antalet brokers som behövs för att hantera en viss belastning. Men i praktiken är det så många konfigurationsalternativ på olika nivåer att det är ganska svårt (om inte omöjligt) att bedöma den potentiella prestandan hos en viss konfiguration. Med andra ord är det mycket utmanande att planera en konfiguration med utgångspunkt från en viss förväntad prestanda.
För användare av Supertubes tillämpar vi vanligtvis följande metod: vi börjar med en viss konfiguration (infrastruktur + inställningar), mäter dess prestanda, justerar brokerinställningarna och upprepar processen. Detta pågår tills potentialen hos den långsammaste infrastrukturella komponenten är helt utnyttjad.
Genom denna metod får vi en klarare uppfattning om hur många brokers som krävs för klustret för att hantera en viss belastning (antalet brokers beror också på andra faktorer, såsom minimalt antal meddelandekopior för att säkerställa redundans, antalet partitionledare osv.). Dessutom får vi en uppfattning om vilken infrastrukturell komponent som bör skalas vertikalt.
I den här artikeln kommer vi att diskutera de steg vi tar för att "få ut allt" från de långsammaste komponenterna i initiala konfigurationer och mäta klustrets genomströmning i Kafka. En högt tillförlitlig konfiguration kräver minst tre aktiva brokers (min.insync.replicas=3), spridda över tre olika tillgänglighetszoner. För att konfigurera, skala och övervaka Kubernetes-infrastrukturen använder vi vår egen containerhanteringsplattform för hybridmoln — . Den stöder on-premise (bare metal, VMware) och fem typer av moln (Alibaba, AWS, Azure, Google, Oracle), samt alla tänkbara kombinationer av dem.
Tankar kring infrastruktur och konfiguration av Kafka-klustret
För exemplen nedan har vi valt AWS som molnleverantör och EKS som Kubernetes-distribution. En liknande konfiguration kan realiseras med — en Kubernetes-distribution från Banzai Cloud, certifierad av CNCF.
Enhet
Amazon erbjuder olika . I grunden gp2 och io1 baseras på SSD-enheter, men för att säkerställa hög genomströmning gp2 förbrukar ackumulerade krediter (I/O credits), därför föredrog vi en typ io1, som erbjuder stabil hög genomströmning.
Typer av instanser
Kafkas prestanda beror starkt på operativsystemets sid-cache, så vi behöver instanser med tillräckligt med minne för mäklare (JVM) och sid-cache. Instansen c5.2xlarge är en bra början, eftersom den har 16 GB minne och . Nackdelen är att den kan leverera maximal prestanda under högst 30 minuter om dygnet. Om arbetsbelastningen kräver maximal prestanda under längre perioder bör vi överväga andra typer av instanser. Och så gjorde vi, när vi stannade vid c5.4xlarge. Den erbjuder maximal genomströmning på 593,75 MB/s. Den maximala genomströmningen för EBS-volymen io1 är högre än för instansen c5.4xlarge, så den långsammaste delen av infrastrukturen är uppenbarligen I/O-genomströmningen för den här instansen (vilket också bör bekräftas av resultaten av våra belastningstester).
Nätverk
Nätverksbandbredden måste vara tillräckligt stor jämfört med instansens VM-prestanda och disken, annars blir nätverk den svaga länken. I vårt fall stöder nätverksgränssnittet c5.4xlarge hastigheter upp till 10 Gb/s, vilket är betydligt mer än I/O-genomströmningen för VM-instansen.
Distribuering av mäklare
Mäklarna bör distribueras (planeras i Kubernetes) på dedikerade noder för att undvika konkurrens med andra processer om CPU-, minnes-, nätverks- och diskresurser.
Java-version
Ett rimligt val är Java 11, eftersom det är kompatibelt med Docker på så sätt att JVM korrekt identifierar de processorer och det minne som är tillgängligt för den container där mäklaren körs. Med vetskap om att CPU-gränser är viktiga, ställer JVM internt och transparent in antalet GC-trådar och JIT-kompilatortrådar. Vi använde bilden Kafka banzaicloud/kafka:2.13-2.4.0, som inkluderar version 2.4.0 av Kafka (Scala 2.13) på Java 11.
Om du vill veta mer om Java/JVM på Kubernetes, kolla gärna på våra följande publikationer:
- ;
- .
Mäklarnas minnesinställningar
Det finns två viktiga aspekter av att konfigurera mäklarens minne: inställningar för JVM och för Kubernetes-poden. Gränsen för minnet som sätts för podden bör vara större än det maximala heap-storleken, så att JVM har utrymme för Java-metaplatsen, som ligger i sin egen minne, och för operativsystemets sid cache, som Kafka aktivt använder. I våra tester körde vi Kafka-mäklare med parametrarna -Xmx4G -Xms2G, medan minnesgränsen för podden var 10 Gi. Observera att minnesinställningar för JVM automatiskt kan fås med -XX:MaxRAMPercentage och -X:MinRAMPercentage, baserat på minnesgränsen för podden.
Mäklarnas processorinställningar
Generellt sett kan prestandan ökas genom att öka parallellismen genom att öka antalet trådar som Kafka använder. Ju fler processorer som är tillgängliga för Kafka, desto bättre. I vårt test började vi med en begränsning på 6 processorer och ökade successivt (i iterationer) antalet till 15. Dessutom ställde vi in num.network.threads=12 i mäklarens inställningar för att öka antalet trådar som tar emot data från nätverket och skickar dem. Vi upptäckte omedelbart att följarna inte kunde ta emot repliker tillräckligt snabbt, så vi ökade num.replica.fetchers till 4 för att öka hastigheten med vilken följarna replikerade meddelanden från ledarna.
Belastningstestverktyg
Det är viktigt att säkerställa att potentialen hos den valda belastningsgeneratorn inte tar slut innan Kafka-klustret (vars prestanda mäts) når sin maximala belastning. Med andra ord är det nödvändigt att göra en förhandsutvärdering av belastningsgeneratorns kapabiliteter samt välja instanser med tillräckligt med processorer och minne. Under dessa förhållanden kommer vårt verktyg att generera mer belastning än vad Kafka-klustret kan hantera. Efter flera tester har vi valt att använda tre instanser c5.4xlarge, där varje instans körde en generator.
Benchmarking
Prestandamätning är en iterativ process som involverar följande steg:
- konfigurering av infrastrukturen (EKS-kluster, Kafka-kluster, belastningsgenerator och även Prometheus och Grafana);
- generering av belastning under en viss tidsperiod för att filtrera bort slumpmässiga avvikelser i de insamlade prestandamåtten;
- justering av infrastrukturen och brokerkonfigurationen baserat på observerade prestandaindikatorer;
- upprepning av processen tills den önskade genomströmningen i Kafka-klustret uppnås. Det ska också vara stabilt reproducerbart och visa minimala variationer i genomströmning.
I nästa avsnitt beskrivs stegen som utfördes under benchmarking-processen av testklustret.
Verktyg
För snabb distribution av en grundkonfiguration, belastningsgenerering och prestandamätning användes följande verktyg:
- för att organisera EKS-klustret från Amazon med (för insamling av Kafka och infrastrukturmetrik) och (för visualisering av dessa metrik). Vi använde integrerade på tjänster som erbjuder federativ övervakning, centraliserad logginsamlning, sårbarhetsskanning, återställning efter driftstopp, företagsklassens säkerhet och mycket mer.
- — ett verktyg för belastningstestning av Kafka-klustret.
- Grafana-paneler för visualisering av Kafka- och infrastrukturmetrik: , .
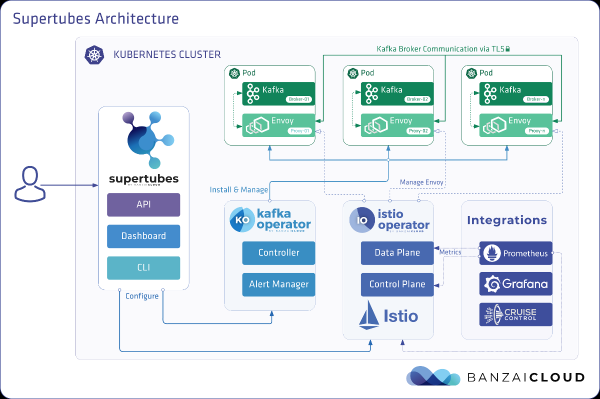
- Supertubes CLI för den enklaste konfigurationen av ett Kafka-kluster i Kubernetes. Zookeeper, Kafka-operator, Envoy och många andra komponenter installeras och konfigureras korrekt för att köra ett produktionsklart Kafka-kluster i Kubernetes.
- För installation supertubes CLI använd instruktionerna som anges .
EKS-kluster
Förbered EKS-klustret med dedikerade noder c5.4xlarge i olika tillgänglighetszoner för poddar med Kafka-brokers samt dedikerade noder för lastgenerering och övervakningsinfrastruktur.
banzai cluster create -f https://raw.githubusercontent.com/banzaicloud/kafka-operator/master/docs/benchmarks/infrastructure/cluster_eks_202001.jsonNär EKS-klustret är igång, aktivera dess integrerade — den kommer att installera Prometheus och Grafana i klustret.
Systemkomponenter för Kafka
Installera systemkomponenter för Kafka (Zookeeper, kafka-operator) i EKS med hjälp av supertubes CLI:
supertubes install -a --no-democluster --kubeconfigKafka-kluster
Som standard används EBS-volymer av typen gp2, så det är nödvändigt att skapa en särskild lagringsklass baserad på volymer io1 för Kafka-klustret:
kubectl create -f - <<EOF
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: fast-ssd
provisioner: kubernetes.io/aws-ebs
parameters:
  type: io1
  iopsPerGB: "50"
  fsType: ext4
volumeBindingMode: WaitForFirstConsumer
EOF
Ställ in parametern för brokerns min.insync.replicas=3 och distribuera poddar för brokers på noder i tre olika tillgänglighetszoner:
supertubes cluster create -n kafka --kubeconfig -f https://raw.githubusercontent.com/banzaicloud/kafka-operator/master/docs/benchmarks/infrastructure/kafka_202001_3brokers.yaml --wait --timeout 600Ämnen
Vi körde samtidigt tre instanser av lastgeneratorn. Var och en skriver till sitt eget ämne, totalt behöver vi alltså tre ämnen:
supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
  name: perftest1
spec:
  name: perftest1
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF

supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
    name: perftest2
spec:
  name: perftest2
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF

supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
  name: perftest3
spec:
  name: perftest3
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF
För varje ämne är faktorn för replikering 3 — det minimi rekommenderade värdet för hög tillgänglighet i produktionssystem.
Belastningstestverktyg
Vi startade tre instanser av belastningstestgeneratorn (varje instans skrev till en separat topic). För belastningstestgeneratorns poddar måste node affinity anges så att de endast schemaläggs på de reserverade noderna:
apiVersion: extensions/v1beta1
kind: Deployment
metadata:
  labels:
    app: loadtest
  name: perf-load1
  namespace: kafka
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      app: loadtest
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        app: loadtest
    spec:
      affinity:
        nodeAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            nodeSelectorTerms:
            - matchExpressions:
              - key: nodepool.banzaicloud.io/name
                operator: In
                values:
                - loadgen
      containers:
      - args:
        - -brokers=kafka-0:29092,kafka-1:29092,kafka-2:29092,kafka-3:29092
        - -topic=perftest1
        - -required-acks=all
        - -message-size=512
        - -workers=20
        image: banzaicloud/perfload:0.1.0-blog
        imagePullPolicy: Always
        name: sangrenel
        resources:
          limits:
            cpu: 2
            memory: 1Gi
          requests:
            cpu: 2
            memory: 1Gi
        terminationMessagePath: /dev/termination-log
        terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      terminationGracePeriodSeconds: 30
Några punkter att tänka på:
- Belastningstestgeneratorn genererar meddelanden på 512 byte och publicerar dem i Kafka i batcher om 500 meddelanden.
- Med hjälp av argumentet
-required-acks=allanses publiceringen vara lyckad när alla synkroniserade repliker av meddelandet har mottagits och bekräftats av Kafka-brokers. Det innebär att vi i benchmarket mätte inte bara hastigheten hos ledarna som tar emot meddelanden, utan också deras efterföljare som replikerar meddelanden. Målet med detta test är inte att utvärdera hastigheten hos konsumenterna (consumers) för nyligen mottagna meddelanden, som fortfarande ligger i operativsystemets sidcache, och dess jämförelse med hastigheten för att läsa meddelanden som lagras på disk. - Belastningstestgeneratorn kör parallellt 20 arbetare (
-workers=20). Varje arbetare innehåller 5 producenter som gemensamt använder arbetarnas anslutning till Kafka-klustret. Totalt har varje generator 100 producenter och alla skickar meddelanden till Kafka-klustret.
Övervakning av klustrets tillstånd
Under load testing of the Kafka cluster, we also monitored its health to ensure there were no pod restarts, unsynchronized replicas, and maximum throughput with minimal fluctuations:
- The load generator writes standard statistics on the number of published messages and the error rate. The error percentage should remain at
0,00%. - , deployed by kafka-operator, provides a monitoring dashboard where we can also observe the state of the cluster. To view this dashboard, execute:
supertubes cluster cruisecontrol show -n kafka --kubeconfig - The ISR level (number of 'in-sync' replicas) is equal to 0 for shrink and expansion.
Measurement results
3 brokers, message size — 512 bytes
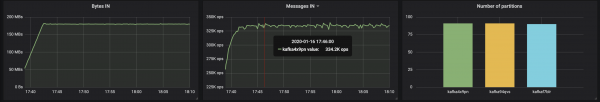
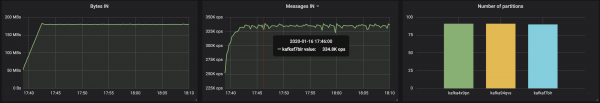
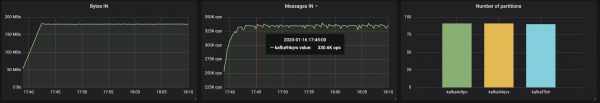
With partitions evenly distributed across three brokers, we managed to achieve a performance of ~500 MB/s (approximately 990 thousand messages per second):
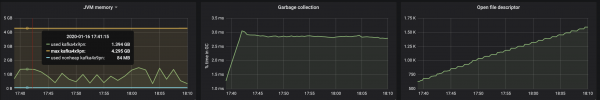
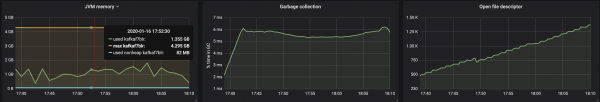
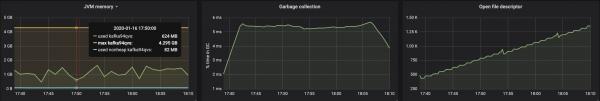
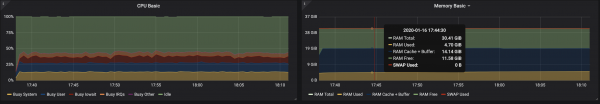
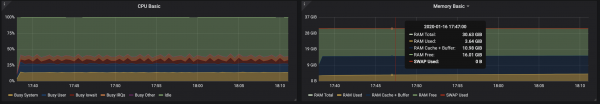
The memory consumption by the JVM virtual machine did not exceed 2 GB:
Disk throughput reached the maximum I/O throughput of the node across all three instances where the brokers were running:
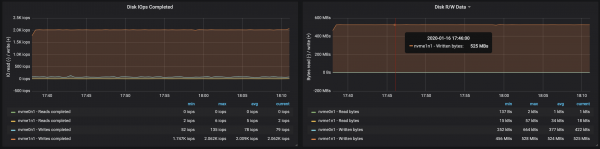
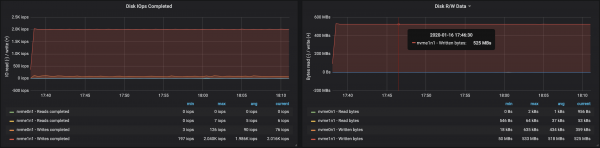
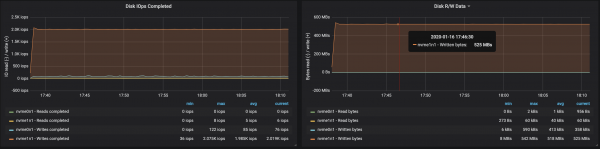
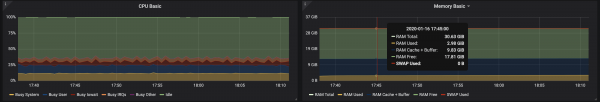
From the data on memory usage by the nodes, it can be seen that system buffering and caching took ~10-15 GB:
3 brokers, message size — 100 bytes
With the reduction in message size, the throughput decreases by approximately 15-20%: this is affected by the time spent processing each message. Additionally, the CPU load nearly doubled.
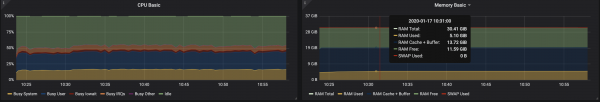
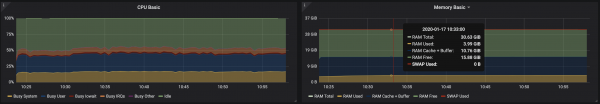
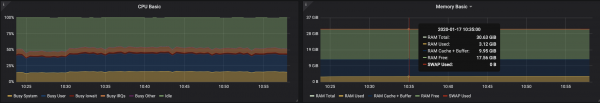
Since there are still unused cores on the broker nodes, performance can be improved by modifying the Kafka configuration. This is a complex task, so to increase throughput, it is better to work with larger messages.
4 brokers, message size — 512 bytes
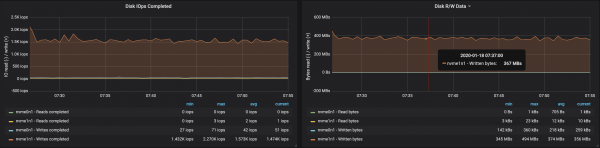
It is easy to increase the performance of the Kafka cluster simply by adding new brokers and maintaining partition balance (this ensures an even distribution of load among brokers). In our case, after adding a broker, the cluster throughput increased to ~580 MB/s (~1.1 million messages per second). The increase was less than expected: this is mainly explained by the imbalance of partitions (not all brokers are operating at peak capacity).
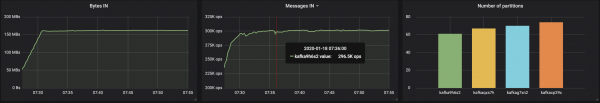
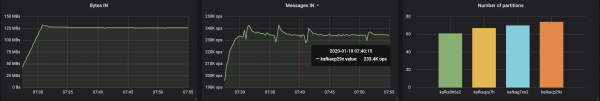
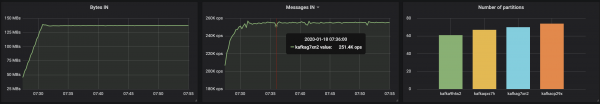
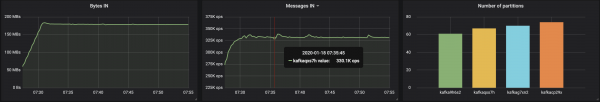
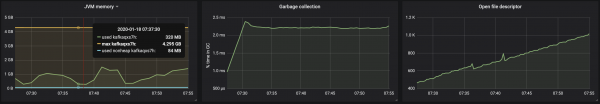
JVM-maskinens minnesanvändning har hållits under 2 GB:
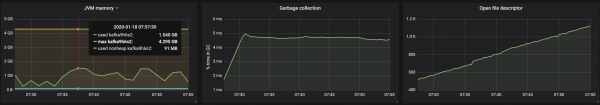
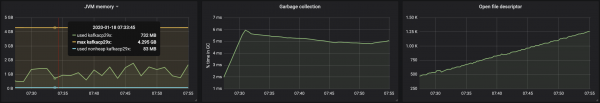
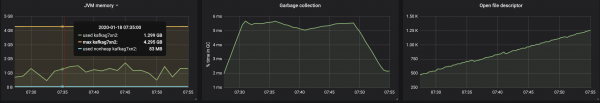
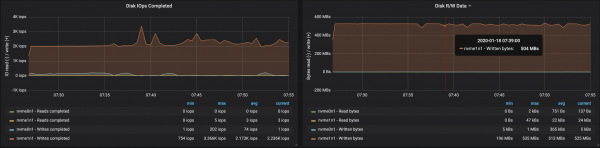
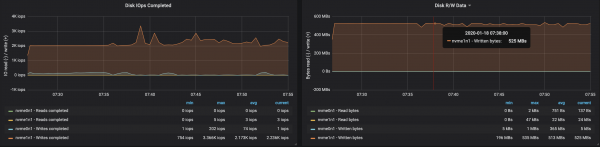
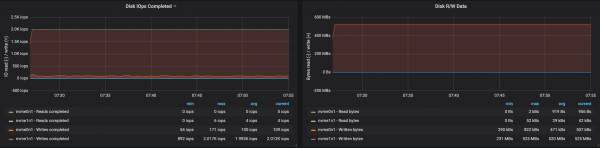
Brokers arbete med lagringsenheter har påverkats av en obalans i partitioner:
Slutsatser
Den iterativa metoden som presenteras ovan kan utvidgas för att inkludera mer komplexa scenarier med hundratals konsumenter, ompartitionering, rullande uppdateringar, omstarter av poddar etc. Detta gör att vi kan bedöma gränserna för Kafkas klusterkapacitet under olika förhållanden, identifiera flaskhalsar i dess prestanda och hitta sätt att åtgärda dem.
Vi har utvecklat Supertubes för snabb och enkel distribution av klustret, dess konfiguration, tillägg/borttagning av brokers och teman, reagere på aviseringar och säkerställa en korrekt funktion av Kafka i Kubernetes i stort. Vårt mål är att hjälpa till att koncentrera sig på huvuduppgiften ("generera" och "konsumera" Kafka-meddelanden), medan allt det tunga arbetet överlåts till Supertubes och Kafka-operatören.
Om du är intresserad av Banzai Clouds teknik och Open Source-projekt, följ företaget på , eller .
P.S. från översättaren
Läs även i vår blogg:
- «»;
- «»;
- «».
Källa: habr.com
