

Hej, Habr! Jag heter Maxim Vasiliev, och jag arbetar som analytiker och projektledare på FINCH. Idag skulle jag vilja berätta hur vi med hjälp av ElasticSearch lyckades bearbeta 15 miljoner förfrågningar på 6 minuter och optimera de dagliga belastningarna på en av våra kunders webbplatser. Tyvärr får vi klara oss utan namn, eftersom vi har ett NDA, men vi hoppas att innehållet i artikeln inte påverkas av detta. Låt oss börja.
Hur projektet är uppbyggt
I vår backend skapar vi tjänster som säkerställer funktionaliteten på våra kunders webbplatser och mobilapplikationer. Den allmänna strukturen kan ses i schemat:
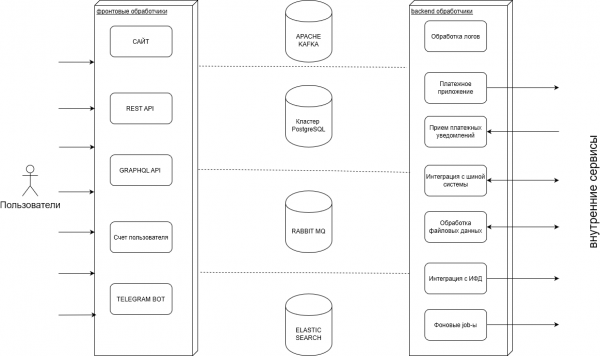
Under arbetets gång hanterar vi ett stort antal transaktioner: köp, utbetalningar, användarbalanser, för vilka vi sparar mycket loggar, samt importerar och exporterar dessa data till externa system.
Det finns också omvända processer, när vi får data från kunden och överför dem till användarna. Dessutom finns det processer för att hantera betalningar och bonusprogram.
Kort bakgrund
Ursprungligen använde vi PostgreSQL som den enda datalagringen. Dess standardfördelar för databashanteringssystem: support för transaktioner, en avancerad datavalsspråk och ett brett utbud av integrationsverktyg, kombinerat med god prestanda, tillfredsställde våra behov under lång tid.
Vi lagrade alla data i Postgres: från transaktioner till nyheter. Men antalet användare växte, och därmed antalet förfrågningar.
För att ge en uppfattning, det årliga antalet sessioner 2017 var endast på den stationära webbplatsen — 131 miljoner. Under 2018 — 125 miljoner. 2019 igen 130 miljoner. Lägg till ytterligare 100-200 miljoner från den mobila versionen av webbplatsen och mobilapplikationen, så får ni ett enormt antal förfrågningar.
Med projektets tillväxt slutade Postgres att klara av belastningen, vi hängde inte med — en stor mängd olika förfrågningar dök upp, för vilka vi inte kunde skapa tillräckligt många index.
Vi insåg att vi behövde andra datalagringslösningar som kunde tillgodose våra behov och avlasta PostgreSQL. Vi övervägde Elasticsearch och MongoDB som möjliga alternativ. Den senare förlorade på följande punkter:
- Långsam indexeringshastighet med ökande datavolymer i indexen. Hos Elastic beror hastigheten inte på datamängden.
- Ingen fulltextsökning
Så vi valde Elastic och förberedde oss för övergången.
Övergång till Elastic
1. Vi började övergången med söktjänsten för försäljningsställen. Vår kund har totalt cirka 70 000 försäljningsställen och det krävs flera typer av sökningar på webbplatsen och i appen:
- Textuell sökning efter namn på tätorten
- Geosökning inom ett visst radie från en punkt. Till exempel, om användaren vill se vilka försäljningsställen som ligger närmast hen.
- Sökning inom ett angivet område – användaren ritar upp ett område på kartan, och alla punkter inom den radien visas.
- Sökning med ytterligare filter. Försäljningsställena skiljer sig åt i sitt sortiment.
Om vi pratar om organisationen, så har vi en datakälla i Postgres både för kartan och nyheterna, medan snapshot:ar görs av originaldata i Elastic. Poängen är att Postgres från början inte klarade av att söka enligt alla kriterier. Det fanns många index som kunde krocka med varandra, vilket gjorde att Postgres planläggare blev förvirrad och inte visste vilket index som skulle användas.
2. Nästa steg var nyhetsavsnittet. På webbplatsen publiceras nya artiklar varje dag, och för att användaren inte ska tappa tråden i informationsflödet behöver data sorteras innan de presenteras. Därför behövs sökningen: på webbplatsen kan man söka efter textmatchning, och dessutom koppla in ytterligare filter, eftersom dessa också är implementerade genom Elastic.
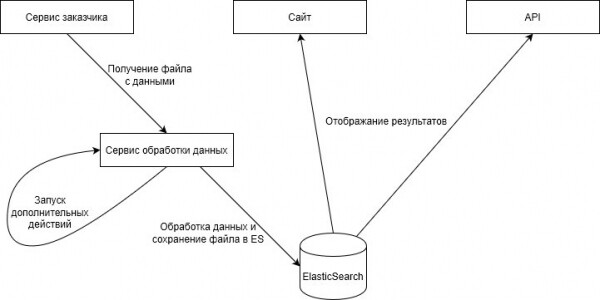
3. Sedan flyttade vi över behandlingen av transaktioner. Användare kan köpa specifika produkter på webbplatsen och delta i tävlingar. Efter sådana köp bearbetar vi en stor mängd data, särskilt under helger och högtider. För jämförelse, om antalet köp under vanliga dagar ligger runt 1,5-2 miljoner, kan siffran under helger nå upp till 53 miljoner.
Data måste behandlas på minimal tid — användare tycker inte om att vänta flera dagar på resultatet. Genom Postgres går sådana tider helt enkelt inte att uppnå — vi fick ofta låsningar, och medan vi bearbetade alla förfrågningar kunde användarna inte kontrollera om de hade vunnit priser eller inte. Det är inte särskilt trevligt för företag, därför flyttade vi behandlingen till Elasticsearch.
Frekvens
Nu är uppdateringarna inställda att ske automatiskt under följande villkor:
- Försäljningsställen. Så snart vi får data från en extern källa börjar vi direkt en uppdatering.
- Nyheter. Så snart en nyhet redigeras på webbplatsen skickas den automatiskt till Elastic.
Här bör vi återigen nämna fördelarna med Elastic. I Postgres måste man vänta på att alla poster hanteras vid varje förfrågan. I Elastic kan man skicka 10 000 poster och börja arbeta med en gång, utan att vänta på att posterna sprids över alla Shards. Visst kan en viss Shard eller Replica kanske inte se data direkt, men det blir snart tillgängligt.
Integrationsmetoder
Det finns 2 sätt att integrera med Elastic:
- Via inbyggd klient över TCP. Den inbyggda drivrutinen försvinner gradvis: den får inget stöd längre och har en mycket obekväm syntax. Därför använder vi den knappt och försöker helt överge den.
- Via HTTP-gränssnittet, där både JSON-förfrågningar och Lucene-syntax kan användas. Det sistnämnda är en textmotor som används av Elastic. I så fall får vi möjlighet till Batch via JSON-förfrågningar över HTTP. Det är just den här metoden vi försöker använda.
Tack vare HTTP-gränssnittet kan vi använda bibliotek som erbjuder asynkron implementering av HTTP-klienten. Vi kan dra nytta av Batch och asynkront API, vilket slutligen ger hög prestanda, vilket har varit till stor hjälp under dagar med stora kampanjer (mer om detta nedan)
Lite siffror för jämförelse:
- Sparande av användare som fick priser i Postgres med 20 strömmar utan gruppering: 460713 poster på 42 sekunder
- Elastic + reaktiv klient med 10 strömmar + batch på 1000 element: 596749 poster på 11 sekunder
- Elastic + reaktiv klient med 10 strömmar + batch på 1000 element: 23801684 poster på 4 minuter
Nu har vi skrivit en HTTP-förfrågningshanterare som bygger JSON, som Batch/inte Batch och skickar via vilken HTTP-klient som helst oavsett bibliotek. Det går också att välja att skicka förfrågningar synkront eller asynkront.
I vissa integrationer använder vi fortfarande den officiella transportklienten, men det är bara en fråga om nära refaktorisering. För bearbetning används en egen klient baserad på Spring WebClient.
Större kampanj
En gång om året hålls en stor kampanj för användare på projektet – det är just den stora belastningen, eftersom vi då arbetar med tiotals miljoner användare samtidigt.
Vanligtvis sker belastningstoppar under helgdagar, men denna kampanj är av en helt annan nivå. För två år sedan sålde vi 27 580 890 enheter av varan på kampanjdagen. Data behandlades i mer än en halvtimme, vilket orsakade problem för användarna. Användarna fick priser för att delta, men det blev tydligt att processen behövde snabba upp.
I början av 2019 beslutade vi att vi behövde ElasticSearch. Under ett helt år organiserade vi bearbetningen av de mottagna uppgifterna i Elastic och deras utdelning via API:er till mobilapplikationen och webbplatsen. Resultatet blev att vi under nästa år under kampanjen bearbetade 15 131 783 poster på 6 minuter.
Eftersom vi har ett stort antal personer som vill köpa varor och delta i lotterier i kampanjerna, är detta en tillfällig åtgärd. Just nu skickar vi aktuell information till Elastic, men vi planerar att i framtiden flytta arkivinformation från tidigare månader till Postgres som en permanent lagringslösning. Detta för att undvika att överbelasta Elastic-indexet, som också har sina begränsningar.
Slutsats/Resultat
För närvarande har vi flyttat alla tjänster vi ville ha till Elastic och vi har gjort en paus här. Just nu bygger vi en index ovanför huvudlagringslösningen i Postgres, som tar emot användarbelastningen.
I framtiden planerar vi att flytta tjänster om vi märker att databehovet blir alltför mångfaldigt och söks över ett obegränsat antal kolumner. Det är redan en uppgift som inte lämpar sig för Postgres.
Om vi behöver en fulltextsökning i funktionaliteten eller om vi får många olika sökkriterier vet vi redan att det måste överföras till Elastic.
⌘⌘⌘
Tack för att ni läste. Om ni också använder ElasticSearch i ert företag och har egna implementeringsfall, berätta gärna. Det skulle vara intressant att veta hur andra gör 🙂
Källa: habr.com
