

Den analytiska databasen ClickHouse hanterar en mängd olika strängar och förbrukar resurser. För att påskynda systemets arbete läggs ständigt till nya optimeringar. Utvecklaren av ClickHouse, Nikolai Kochetov, berättar om strängdatatypen, inklusive den nya typen LowCardinality, och förklarar hur man kan snabba upp arbetet med strängar.
— Låt oss först gå igenom hur vi kan lagra strängar.
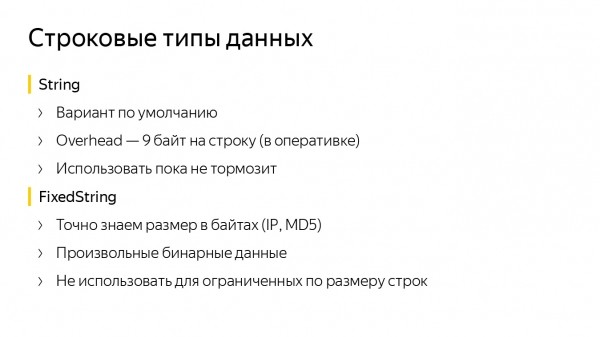
Vi har strängdatatyper. String är bra som standard och bör nästan alltid användas. Den har en liten overhead — 9 byte per sträng. Om vi vill att storleken på strängarna ska vara fast och känd på förhand, är det bättre att använda FixedString. Här kan vi ange det antal byte vi behöver, vilket är praktiskt för data som IP-adresser eller hash-funktioner.
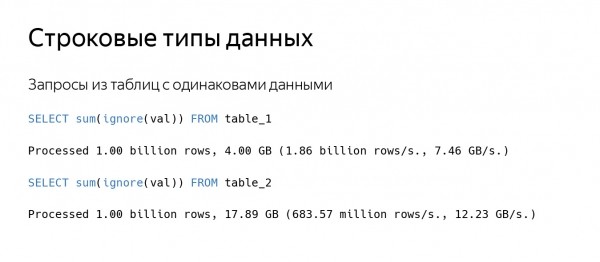
Självklart, ibland går något långsamt. Anta att du gör en förfrågan till en tabell. ClickHouse läser en ganska stor mängd data, låt säga i hastighet av 100 GB/s, medan strängar hanteras väldigt lite. Vi har två tabeller som lagrar nästan identiska data. Från den andra tabellen läser ClickHouse data snabbare, men antalet strängar som läses per sekund är tre gånger lägre.
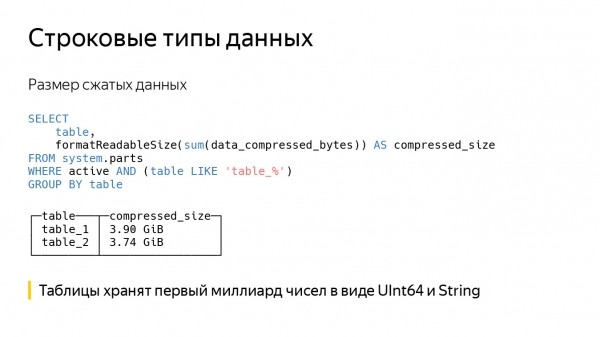
Om vi tittar på storleken på de komprimerade data, kommer den att visa sig vara nästan likvärdig. I själva verket är de samma data skrivna i tabellerna — den första miljarden siffror — men i den första kolumnen skrivs de som UInt64, och i den andra som String. På grund av detta tar den andra förfrågan längre tid att läsa data från disken och att dekomprimera dem.
Här är ett annat exempel. Anta att det finns ett förutbestämt antal strängar, begränsat till en konstant 1000 eller 10 000, och som praktiskt taget aldrig förändras. För detta fall passar datatypen Enum, i ClickHouse finns det två — Enum8 och Enum16. Genom att lagra i Enum kan vi snabbt bearbeta förfrågningarna.
I ClickHouse finns det optimeringar för GROUP BY, IN, DISTINCT och optimeringar för vissa funktioner, till exempel för att jämföra med en konstant sträng. Självklart omvandlas inte siffror i strängen, utan istället omvandlas den konstanta strängen till ett värde av Enum. Efter detta jämförs allt snabbt.
Men det finns också nackdelar. Även om vi känner till det exakta antalet strängar, kan det ibland behöva utökas. Om en ny sträng kommer in — måste vi göra ett ALTER.
ALTER för Enum i ClickHouse har implementerats på ett optimalt sätt. Vi skriver inte om data på disken, men ALTER kan vara trögt på grund av att Enum-strukturer lagras i själva tabellens schema. Därför måste vi vänta på läsförfrågningar från tabellen, till exempel.
Frågan uppstår, kan vi göra det bättre? Kanske, ja. Vi kan lagra Enum-strukturen inte i tabellens schema utan i ZooKeeper. Men det kan uppstå problem relaterade till synkronisering. Till exempel, en replik får data, en annan gör det inte, och om den har en gammal Enum, kan något gå fel. (I ClickHouse har vi nästan färdigställt icke-blockerande ALTER-förfrågningar. När vi har slutfört dem helt behöver vi inte vänta på läsförfrågningar.)
För att slippa krångel med ALTER Enum kan vi använda externa ordlistor i ClickHouse. Jag påminner om att det är en key-value datastruktur inuti ClickHouse, som gör att vi kan hämta data från externa källor, till exempel från MySQL-tabeller.
I ClickHouse-ordlistan lagrar vi många olika strängar, medan tabellen innehåller deras identifierare i form av siffror. Om vi behöver en sträng, anropar vi funktionen dictGet och arbetar med den. Efter det behöver vi inte göra ALTER. För att lägga till något i Enum, sätter vi in det i samma MySQL-tabell.
Men här uppstår andra problem. För det första, ett besvärligt syntax. Om vi vill hämta en sträng måste vi anropa dictGet. För det andra, brist på vissa optimeringar. Att jämföra med en konstant sträng för ordlistor går inte lika snabbt.
Det kan också bli problem med uppdateringar. Anta att vi begärde en sträng i cache-ordlistan, men den kom inte in i cachen. Då måste vi vänta på att data laddas från den externa källan.
En allmän nackdel med båda metoderna är att vi lagrar alla nycklar på ett ställe och synkroniserar dem. Så varför inte lagra ordlistor lokalt? Ingen synkronisering — inga problem. Vi kan lagra ordlistan lokalt på en del av disken. Det vill säga vi utförde en Insert, registrerade ordlistan. Om vi arbetar med data i minnet kan vi skriva ordlistan antingen i en datablok, en kolonnkli eller i någon sorts cache för att snabba upp beräkningarna.
Ordlistkodning av strängar
Så kom vi till skapandet av en ny datatyp i ClickHouse — LowCardinality. Det är ett format för datalagring: hur de skrivs till disken och hur de läses, hur de representeras i minnet och schemat för deras bearbetning.
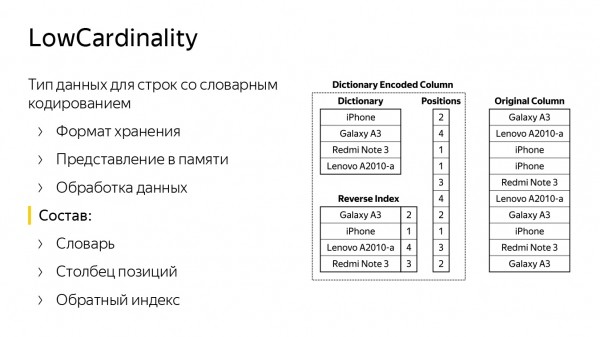
På sliden finns det två kolumner. Till höger lagras rader standardmässigt som typ String. Det är uppenbart att detta är modeller av mobiltelefoner. Till vänster finns en likadan kolumn, men av typen LowCardinality. Den består av en ordbok med många olika strängar (strängarna från kolumnen till höger) och en lista med positioner (radnummer).
Med hjälp av dessa två strukturer kan man återskapa den ursprungliga kolumnen. Det finns också en invers index — en hash-tabell som hjälper till att hitta positionen i ordboken baserat på strängen. Detta behövs för att snabba upp vissa förfrågningar. Till exempel, om vi vill jämföra, söka efter en sträng i vår kolumn eller slå samman dem.
LowCardinality är en parametertyp. Den kan vara antingen ett tal, eller något som lagras som ett tal, eller en sträng, eller Nullable av dem.
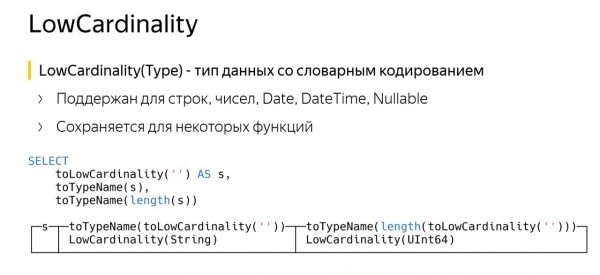
Särskilt med LowCardinality är att den kan sparas för vissa funktioner. På sliden ses ett exempel på en förfrågan. I den första raden skapade jag en kolumn av typen LowCardinality från String, som jag kallade S. Därefter frågade jag dess namn — ClickHouse sa att det är LowCardinality av String. Helt korrekt.
Den tredje raden är nästan likadan, för vi anropade funktionen length. I ClickHouse returnerar funktionen length datatypen UInt64. Men vår kolumn blev LowCardinality av UInt64. Vad är meningen med det?
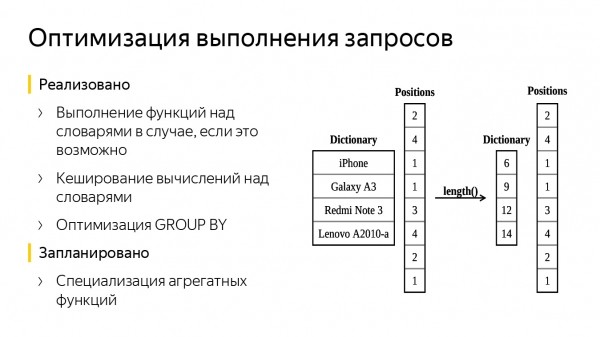
I ordboken låg namnen på mobiltelefonerna, och vi tillämpade funktionen length. Nu har vi en motsvarande ordbok bestående enbart av siffror — detta är längderna på strängarna. Kolumnen med positioner har inte ändrats. Resultatet är att vi har bearbetat mindre data, vilket sparade tid för förfrågan.
Det kan finnas andra optimeringar, till exempel att lägga till en enkel cache. Vid beräkning av värdet för funktionen kan man komma ihåg det och skapa ett likadant utan att beräkna det på nytt.
Det kan också göras en optimering av GROUP BY, eftersom vår kolumn med ordboken redan delvis är aggregerad — man kan snabbare beräkna värden för hash-funktioner och ungefärligt hitta den hink där man ska placera den nästa raden. Dessutom kan man specialisera vissa aggregeringsfunktioner, till exempel uniq, eftersom man bara kan skicka ordboken dit och lämna positionerna oförändrade — så kommer allt att fungera snabbare. De första två optimeringarna har vi redan lagt till i ClickHouse.
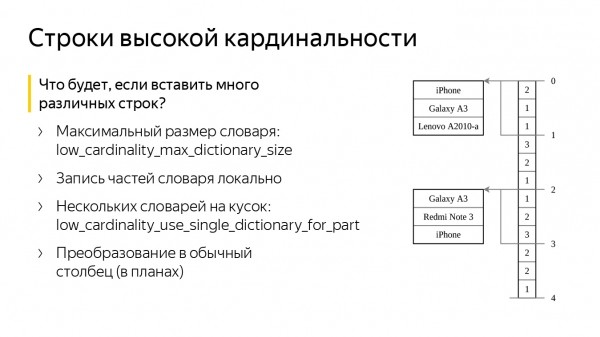
Vad händer om vi skapar en kolumn med vår datatyp och sätter in många dåliga olika rader? Kommer vårt minne att överfullas? Nej, för detta finns det två specialinställningar i ClickHouse. Den första är low_cardinality_max_dictionary_size. Detta är den maximala storleken på en ordbok som kan skrivas till disken. Insättningen sker på följande sätt: när vi sätter in data får vi en ström av rader, av dem bildar vi en stor gemensam ordbok. Om ordboken blir större än värdet på inställningen skriver vi den aktuella ordboken till disken och de återstående raderna hamnar någonstans "vid sidan om", nära indexen. I slutändan kommer vi aldrig att omberäkna den stora ordboken och få problem med minnet.
Den andra inställningen kallas low_cardinality_use_single_dictionary_for_part. Föreställ dig att i det förra schemat, när vi satte in data, överfullades vår ordbok och vi skrev den till disken. Frågan uppstår, varför skulle vi inte nu bilda en till exakt samma ordbok?
När den överfullnas, skriver vi den åter till disken och börjar bilda den tredje. Denna inställning inaktiverar just den möjligheten som standard.
Faktum är att flera ordböcker kan vara användbara om vi vill sätta in en mängd rader, men av misstag har satt in "skräp". Låt oss säga att vi först satte in dåliga rader, och sedan satte in bra. Då kommer ordboken att delas upp i många små ordböcker. Vissa av dem kommer att ha "skräp", men de senaste kommer att vara med bra rader. Och om vi läser, säg, bara den senaste granuleringen, så kommer allt fortfarande att fungera snabbt.
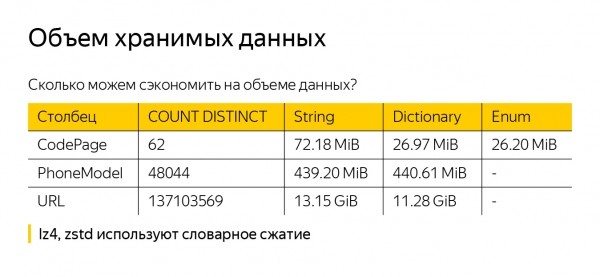
Innan vi pratar om fördelarna med LowCardinality, vill jag snabbt nämna att vi troligen inte kommer att uppnå en minskning av data på disken (även om det kan hända) eftersom ClickHouse komprimerar data. Det finns en standardversion - LZ4. Det går också att göra komprimering med ZSTD. Men båda algoritmerna implementerar redan ordboks komprimering, så vår externa ordbok ClickHouse kommer inte vara så mycket till hjälp.
För att inte bara prata tomt har jag tagit några data från mätningen – String, LowCardinality(String) och Enum – och sparat dem i olika datatyper. Det blev tre kolumner med en miljard rader. I den första kolumnen, CodePage, finns det totalt 62 värden. Och det syns att vi har komprimerat dem bättre i LowCardinality(String). String är något sämre, men det beror troligen på att strängarna är korta; vi lagrar deras längd, och de tar mycket plats och komprimeras dåligt.
Om vi tar PhoneModel, finns det 48 000 – redan fler, och skillnaderna mellan String och LowCardinality(String) är nästan obefintliga. För URL har vi också sparat bara 2 GB – jag tror inte att man ska lita för mycket på det.
Bedömning av hastigheten
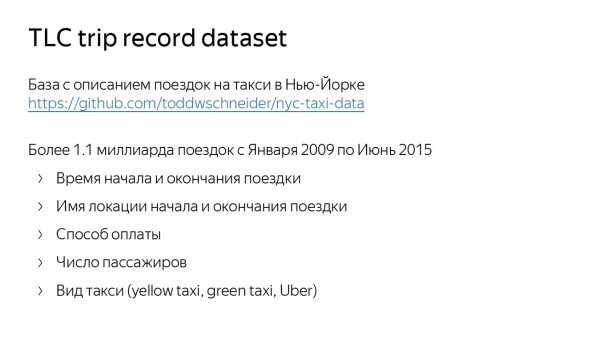
Nu ska vi bedöma hastigheten. För att göra det använde jag ett dataset som beskriver taxiresor i New York. Det finns på GitHub. Det handlar om lite mer än en miljard resor. Det visar plats, tid för start och slut, betalningsmetod, antal passagerare och till och med typ av taxi – grön, gul och Uber.
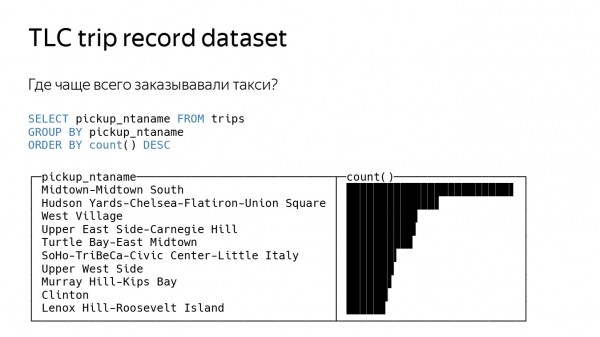
Den första frågan jag ställde var ganska enkel – jag frågade var man oftast beställer taxi. För det behövs att vi tar platsen där taxin beställdes, gör en GROUP BY på den och räknar antalet med funktionen count. Här är vad ClickHouse ger.
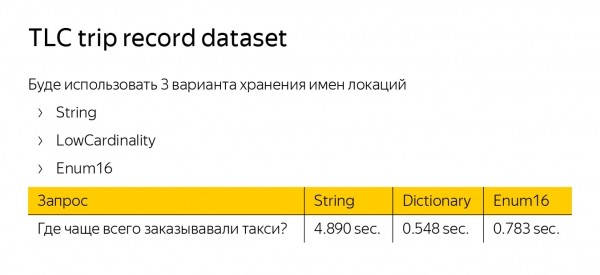
För att mäta hastigheten på fråga skapade jag tre tabeller med samma data, men använde tre olika datatyper för vår startplats – String, LowCardinality och Enum. LowCardinality och Enum visade sig vara fem gånger snabbare än String. Enum är snabbare eftersom den arbetar med siffror. LowCardinality är snabbare på grund av att det finns en optimering för GROUP BY.
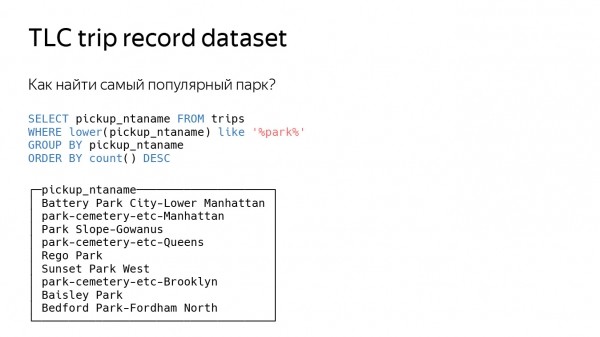
Låt oss komplicera frågan ytterligare – vi frågar var den mest populära parken i New York ligger. Återigen kommer vi att mäta detta på grundval av var taxin oftast beställs, men filtrerar endast på de platser där det finns ordet "park". Vi lägger också till funktionen like.
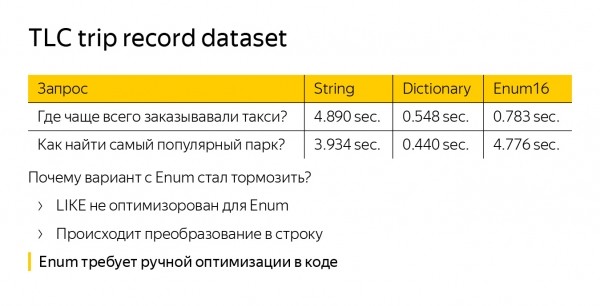
Vi tittar på tiden – vi ser att Enum plötsligt började släpa efter. Det verkar till och med gå långsammare än den vanliga datatypen String. Detta händer eftersom funktionen like inte är optimerad för Enum. Vi måste omvandla våra strängar från Enum till vanliga strängar – vi gör mer arbete. LowCardinality(String) är inte heller optimerad som standard, men där fungerar like på ordboken, så därför är frågan snabbare i jämförelse med String.
När man arbetar med Enum finns det ett mer globalt problem. Om vi vill optimera det måste vi göra det på varje ställe i koden. Låt oss säga att vi har skrivit en ny funktion – vi måste absolut tänka ut en optimering för Enum. Men i LowCardinality är allt optimerat som standard.
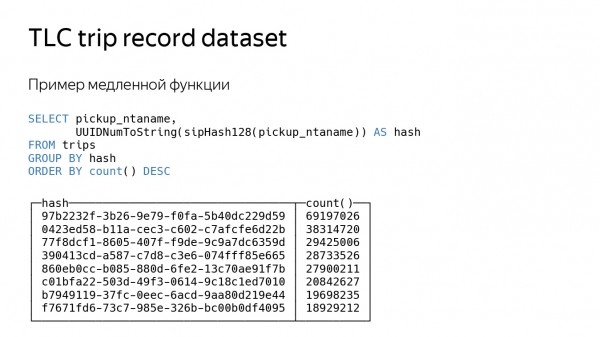
Låt oss titta på den senaste frågan, som är mer konstlad. Vi räknar helt enkelt ut hash-funktionen av vår plats. Hash-funktionen är en ganska långsam förfrågan, den tar lång tid att beräkna, därför kommer allt att sakta ner tre gånger.
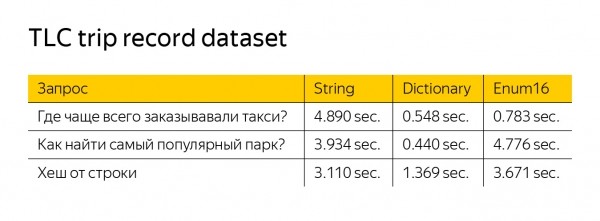
LowCardinality fungerar fortfarande snabbare, även om det inte finns någon filtrering här. Detta beror på att våra funktioner arbetar endast med ordboken. Hashberäkningsfunktionen har en parameter – den kan behandla mindre data och kan också returnera LowCardinality.
Vår globala plan är att uppnå hastighet som inte är lägre än för String i alla fall, och att behålla hastighetsökningarna. Och kanske kommer vi någon gång att ersätta String med LowCardinality, du uppdaterar ClickHouse, och allt kommer att fungera lite snabbare.
Källa: habr.com
