

Vad kan få ett så stort företag som Lamoda med en väl fungerande process och dussintals sammanlänkade tjänster att verkligen ändra sitt tillvägagångssätt? Motivation kan vara helt olika: allt från lagkrav till det som alla programmerare har en inneboende lust att experimentera.
Men det betyder inte att man inte kan förvänta sig extra vinster. Hur man kan vinna konkret om man implementerar ett events-driven API på Kafka kommer Sergey Zaika att berätta (). Det kommer också att finnas berättelser om lärdomar och intressanta upptäckter – ett experiment kan inte undvika sådana.
Disclaimer: Denna artikel är baserad på material från en meetup som Sergey höll i november 2018 på HighLoad++. Den verkliga erfarenheten av Lamodas arbete med Kafka lockade lyssnare lika mycket som andra presentationer på schemat. Vi tycker att detta är ett utmärkt exempel på att man alltid kan och bör hitta likasinnade, och att arrangörerna av HighLoad++ kommer att fortsätta att skapa en atmosfär som uppmuntrar till detta.
Om processen
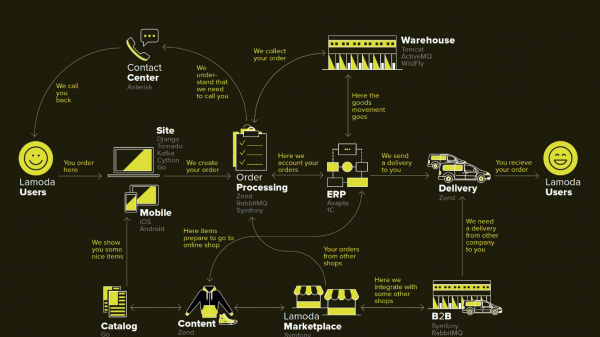
Lamoda är en stor e-handelplattform som har sitt eget kontaktcenter, leveranstjänst (och många partners), fotostudio, en stor lager och allt detta fungerar på egen mjukvara. Det finns dussintals betalningsmetoder, b2b-partners som kan använda en del eller alla dessa tjänster och vill veta aktuell information om sina produkter. Dessutom verkar Lamoda i tre länder utöver Ryssland, och där fungerar allt lite annorlunda. Totalt finns det nog mer än hundra sätt att konfigurera en ny beställning som måste bearbetas på sitt eget sätt. Allt detta fungerar med hjälp av dussintals tjänster som ibland kommunicerar på ett otydligt sätt. Det finns också ett centralt system vars huvudansvar är orderstatusar. Vi kallar det BOB, jag arbetar med det.
Refund Tool with events-driven API
Ordet events-driven är ganska slitet, längre fram kommer vi att definiera mer specifikt vad som menas med detta. Jag börjar med kontexten där vi beslutade att testa tillvägagångssättet för events-driven API i Kafka.
I varje butik, utöver beställningar som kunder betalar för, finns det tillfällen då butiken förväntas återbetala pengar, eftersom varan inte passade kunden. Denna relativt korta process innebär att vi klargör information, om det är nödvändigt, och överför pengarna.
Men återbetalningsprocessen blev mer komplicerad på grund av förändringar i lagstiftningen, och vi var tvungna att implementera en separat mikrotjänst för detta.
Vår motivation:
- Lag FZ-54 — kort sagt kräver lagen att varje penningtransaktion, oavsett om det är en återbetalning eller en inbetalning, rapporteras till skatteverket inom en ganska kort SLA på några minuter. Vi, som e-handel, utför ganska många transaktioner. Tekniskt sett innebär det ett nytt ansvar (och därmed en ny tjänst) och förändringar i alla berörda system.
- BOB split — ett internt projekt för att avlasta BOB från ett stort antal orelaterade ansvar och minska dess övergripande komplexitet.
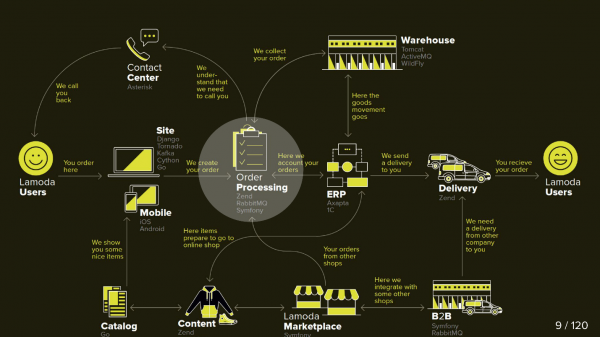
I detta diagram ritas de grundläggande systemen i Lamoda. För närvarande består de flesta av dessa snarare av ett stjärnsystem av 5-10 mikrotjänster runt en minskande monolit. De växer sakta, men vi försöker göra dem mindre, eftersom det är skrämmande att deploya en dedikerad del i mitten — vi får inte låta den krascha. Alla utbyten (pilarna) måste vi reservera och förbereda oss för att någon av dem kan bli otillgänglig.
Det finns också ganska många utbyten i BOB: betalningssystem, transport, notifieringar, etc.
Tekniskt är BOB:
- ~150k rader kod + ~100k rader tester;
- php7.2 + Zend 1 & Symfony Components 3;
- >100 API & ~50 utgående integrationer;
- 4 länder med sin egen affärslogik.
Att deploya BOB är kostsamt och smärtsamt; mängden kod och de uppgifter som hanteras är sådana att ingen kan hålla allt i huvudet på en gång. Sammanfattningsvis finns det många anledningar att förenkla det.
Återbetalningsprocessen
I processen är två system inblandade: BOB och Payment. Nu tillkommer ytterligare två:
- Fiscalization Service, som tar hand om problemen med fiscalisering och kommunikation med externa tjänster.
- Refund Tool, där nya utbyten hanteras för att inte öka storleken på BOB.
Nu ser processen ut så här:
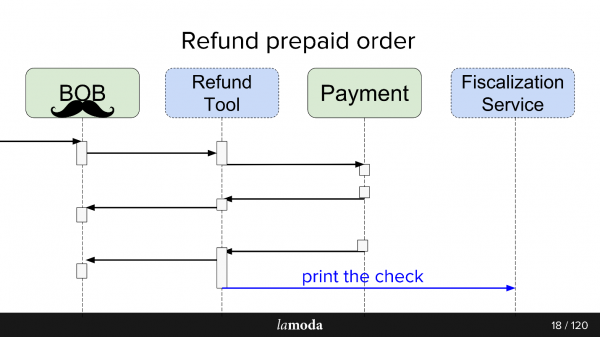
- En begäran om återbetalning kommer till BOB.
- BOB informerar Refund Tool om detta.
- Refund Tool meddelar Payment: "Återbetala pengarna".
- Payment återbetalar pengarna.
- Refund Tool och BOB synkroniserar statusar med varandra, eftersom båda behöver det för tillfället. Vi är dock inte redo att helt byta till Refund Tool, eftersom BOB har UI, rapporter för bokföring och generellt mycket data som inte kan flyttas så enkelt. Vi sitter fortfarande på två stolar.
- En begäran om fiscalisering skickas.
Som vi har gjort har vi skapat en event-bus baserad på Kafka, där allt är kopplat. Hurra, nu har vi en enda felpunkt (sarkasm).
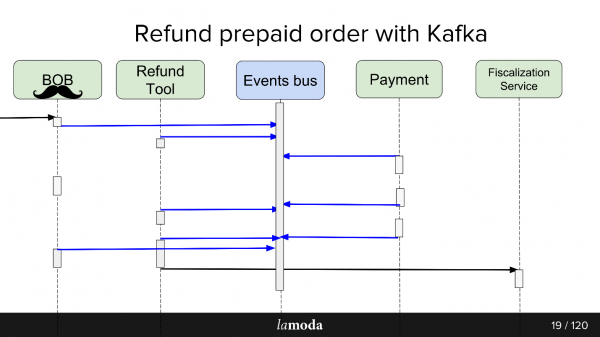
Fördelar och nackdelar är ganska uppenbara. Vi har skapat en bus, så nu är alla tjänster beroende av den. Detta förenklar designen, men inför en enda felpunkt i systemet. Om Kafka faller, stannar processen.
Vad är ett event-driven API
Ett bra svar på denna fråga finns i Martin Fowlers föredrag (GOTO 2017) .
Kort sagt, vad vi har gjort:
- Vi har kapslat in alla asynkrona utbyten genom events storage. Istället för att informera varje intresserad konsument om statusändringar via nätverket, skriver vi ett evenemang om statusändringen till ett centraliserat lagringsutrymme, och intresserade konsumenter läser därifrån allt som dyker upp.
- Ett evenemang (event) i det här fallet är en notifikation (notifications) om att något har förändrats någonstans. Till exempel, en beställningsstatus har ändrats. Konsumenten, som är intresserad av vissa tilläggsdata relaterade till statusändringen, och som inte finns i notifikationen, kan själv ta reda på deras tillstånd.
- Det maximala alternativet är fullskalig event sourcing, state transfer, där evenemanget innehåller all information som behövs för bearbetning: vart vi kom ifrån, vilken status vi övergick till, hur data förändrades, och så vidare. Frågan kvarstår dock om det är rimligt och hur mycket information du kan tillåta dig att lagra.
Inom ramen för lanseringen av Refund Tool använde vi det tredje alternativet. Detta förenklade händelsebehandlingen eftersom det inte behövdes samla in detaljerad information, och det uteslöt scenariot där varje nytt evenemang ger upphov till en våg av uppföljande get-förfrågningar från konsumenterna.
Tjänsten Refund Tool är inte belastad, så Kafka där är mer en provövning än ett krav. Jag tror inte att om tjänsten för återbetalning blev ett highload-projekt, skulle företaget vara glatt.
Async exchange AS IS
För asynkrona utbyten använder PHP-avdelningen vanligtvis RabbitMQ. Vi samlade in data för förfrågningen, la det i kön, och konsumenten av samma tjänst läste och skickade det (eller inte). För API:et använder Lamoda aktivt Swagger. Vi designar API:et, beskriver det i Swagger, och genererar klient- och serverkod. Vi använder även en något utvidgad JSON RPC 2.0.
ESB-bussar används här och där, vissa lever på ActiveMQ, men i stort sett, RabbitMQ - standard.
Asynk växla TO BE
När vi designar överföring via events-bus, kan vi se en parallell. Vi beskriver på liknande sätt den framtida datatransfereringen genom att beskriva strukturen av eventet. YAML-formatet, kodgenereringen fick vi göra själva; generatorn efter specifikationen skapar DTO och lär klienter och servrar att arbeta med dem. Genereringen sker på två språk - golang och php. Detta säkerställer att biblioteken är konsekventa. Generatorn är skriven i golang, vilket gav den namnet gogi.
Event-sourcing på Kafka är typiskt. Det finns en lösning från den huvudsakliga företagsversionen Kafka Confluent, och det finns , en lösning från våra "bröder" inom domänområdet Zalando. Vår motivation att börja med vanilla Kafka är att hålla lösningen gratis tills vi definitivt beslutar om vi kommer att använda den allmänt, samt att behålla utrymme för manövrering och förbättringar: vi vill ha stöd för vår JSON RPC 2.0, generatorer för två språk och vi får se vad mer.
Ironiskt nog, även i det lyckliga fallet när det finns ett ungefär liknande företag som Zalando som har gjort en ungefär liknande lösning, kan vi inte använda den effektivt.
Arkitektoniskt, vid starten, är mönstret att läsa direkt från Kafka, men skriva endast genom events-bus. För att läsa från Kafka finns det mycket färdigt: mäklare, lastbalanserare och den är mer eller mindre klar för horisontell skalning, vilket vi ville behålla. Skriften ville vi dock linda in genom en Gateway aka Events-bus, och det är därför.
Events-bus
eller händelsebussen. Det är bara en stateless http-gateway som tar på sig flera viktiga roller:
- Validering av producering – vi kontrollerar att händelserna uppfyller vår specifikation.
- Master-systemet för händelser, det vill säga det huvudsakliga och enda systemet i företaget som svarar på frågan om vilka händelser med vilka strukturer som anses giltiga. Valideringen inkluderar bara datatyper och enums för en strikt specifikation av innehållet.
- Hash-funktion för sharding – Kafka-meddelandets struktur är key-value och här beräknas var det ska läggas utifrån hash av key.
Varför
Vi arbetar i ett stort företag med en väletablerad process. Varför ändra något? Det här är ett experiment, och vi förväntar oss att få flera fördelar.
1:n+1 överföringar (en till många)
Med Kafka är det mycket enkelt att koppla in nya konsumenter till API:t.
Anta att du har en katalog som du behöver hålla uppdaterad i flera system samtidigt (och kanske i nya också). Tidigare utvecklade vi ett bundle som implementerade set-API, medan master-systemet informerade om konsumenternas adresser. Nu skickar master-systemet uppdateringar till en topic, och alla som är intresserade läser dem. Det har kommit ett nytt system – vi har prenumererat på topicen. Ja, det är också ett bundle, men enklare.
I fallet med refund-tool, som i grunden är en del av BOB, är det praktiskt för oss att hålla dem synkroniserade via Kafka. Payment meddelar att pengarna har återbetalats: BOB och RT får veta det, ändrar sina statusar, och Fiscalization Service får veta det och skriver ut kvittot.
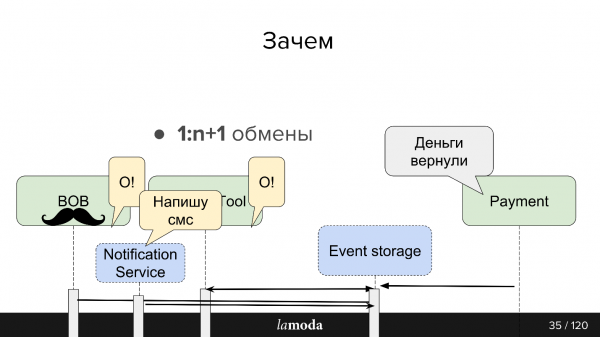
Vi planerar att skapa en enhetlig Notifications Service som skulle informera kunder om nyheter kring deras beställningar/returer. Just nu är det ansvaret spritt mellan systemen. Det kommer att räcka med att lära Notifications Service att fånga relevant information från Kafka och reagera på den (och stänga av dessa meddelanden i de andra systemen). Inga nya direkta utbyten krävs.
Data-driven
Informationen mellan systemen blir transparent – oavsett vilket "blodigt enterprise" ni har och hur omfattande er backlog är. Lamoda har en avdelning för Data Analytics som samlar in data från systemen och omvandlar dem till ett återanvändbart format, både för affärsändamål och för intelligenta system. Kafka gör det möjligt att snabbt ge dem mycket data och hålla denna informationsström aktuell.
Replication log
Meddelanden försvinner inte efter läsning, som i RabbitMQ. När en händelse innehåller tillräckligt med information för bearbetning, får vi en historia av de senaste ändringarna för objektet och, om vi vill, möjlighet att tillämpa dessa ändringar.
Lagringstiden för replication log beror på hur intensivt data skrivs till denna topic; Kafka tillåter att vi flexibelt kan ställa in lagringsgränser både vad gäller tidsperiod och datavolym. För intensiva topics är det viktigt att alla konsumenter hinner läsa informationen innan den försvinner, även vid kortvariga driftstopp. Vanligtvis kan vi lagra data under ett par dagar, vilket är fullt tillräckligt för support.
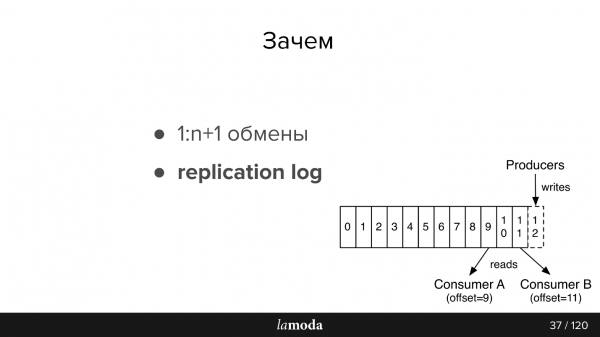
Här följer lite sammanfattning av dokumentationen för dem som inte är bekanta med Kafka (bilden är också från dokumentationen)
I AMQP finns det köer: vi skriver meddelanden till en kö för konsumenten. Vanligtvis behandlar ett system med en och samma affärslogik en kö. Om flera system behöver meddelas kan vi lära appliceringen att skriva till flera köer eller konfigurera en exchange med en fanout-mekanism som klonar dem.
I Kafka finns en liknande abstraktion topic, dit du skriver meddelanden, men de försvinner inte efter läsning. Som standard, när du ansluter till Kafka, får du alla meddelanden, och du har möjlighet att spara platsen där du stannade. Det vill säga att du läser sekventiellt, kan välja att inte markera meddelandet som läst men spara id där du sedan fortsätter läsa. Id, där du stannade, kallas offset, och mekanismen är commit offset.
Därför kan olika logik implementeras. Till exempel, vår BOB finns i 4 instanser för olika länder — Lamoda finns i Ryssland, Kazakstan, Ukraina, Vitryssland. Eftersom de distribueras separat har de lite egna konfigurationer och sin egen affärslogik. Vi anger i meddelandet vilket land det hör till. Varje BOB-konsument i varje land läser med olika groupId, och om meddelandet inte gäller dem, hoppar de över det, det vill säga de kommittar offset +1 direkt. Om samma ämne läses av vår Payment Service gör den detta med en separat grupp, och därför överlappar inte offset.
Krav på händelser:
- Fullständighet av data. Vi skulle vilja att händelsen innehöll tillräckligt med data för att kunna bearbeta den.
- Integritet. Vi delegerar Events-bus att kontrollera att händelsen är konsekvent och att den kan bearbetas.
- Ordning är viktig. I fallet med returer måste vi arbeta med historik. Vid notifieringar är ordningen inte viktig, om det handlar om homogena notifieringar, blir e-postmeddelandet detsamma oavsett vilken beställning som kom först. I fallet med retur finns det en tydlig process; om ordningen ändras kan det uppstå undantag, återbetalningen kan inte skapas eller bearbetas — vi kommer att hamna i ett annat status.
- Konsistens. Vi har ett lagringsutrymme, och nu skapar vi events istället för API. Vi behöver ett sätt att snabbt och billigt överföra information om nya events och om förändringar i redan existerande till våra tjänster. Detta uppnås genom en gemensam specifikation i ett separat git-repository och kodgeneratorer. Därför är kunder och servrar i olika tjänster synkroniserade.
Kafka i Lamoda
Vi har tre installationer av Kafka:
- Logs;
- R&D;
- Events-bus.
Idag pratar vi bara om den senaste punkten. I events-busen har vi inte så stora installationer – 3 mäklare (servrar) och totalt 27 ämnen. Som regel är ett ämne en process. Men detta är en delikat fråga, och vi kommer att beröra den snart.
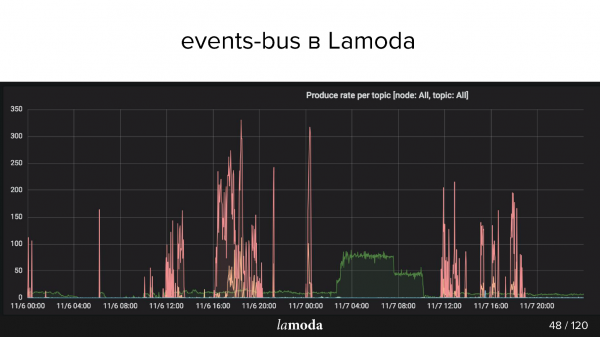
Ovan är en graf över rps. Processen för återbetalningar är markerad med en turkos linje (ja, ja, den som ligger på X-axeln), och med en rosa linje – processen för att uppdatera innehåll.
Katalogen Lamoda innehåller miljontals produkter, och data uppdateras hela tiden. Vissa kollektioner går ur modet, nya släpps istället, och nya modeller dyker ständigt upp i katalogen. Vi försöker förutsäga vad som kommer att intressera våra kunder i morgon, så vi köper ständigt nya saker, fotograferar dem och uppdaterar skyltfönstret.
De rosa topparna representerar produktuppdateringar, det vill säga förändringar av produkter. Det är tydligt att teamet fotograferade, fotograferade, och sedan plötsligt! – laddade upp en mängd events.
Lamoda Events användningsfall
Den byggda arkitekturen använder vi för följande operationer:
- Övervakning av returstatusar: call-to-action och spårning av statusar från alla involverade system. Betalning, statusar, fackalisering, notifieringar. Här prövade vi en metod, skapade verktyg, samlade alla buggar, skrev dokumentation och berättade för kollegor hur man använder det.
- Uppdatering av produktkort: konfiguration, metadata, specifikationer. En system läser (som visar), medan flera skriver.
- Email, push och sms: beställningen har samlats, beställningen har kommit fram, returen har accepterats etc., många av dem.
- Lager, uppdatering av lager – kvantitativ uppdatering av artiklar, bara siffror: ankomst till lagret, retur. Det är viktigt att alla system som är kopplade till varureserviingen hanterar så aktuella data som möjligt. För närvarande är lagersystemet ganska komplext, Kafka kommer att förenkla det.
- Dataanalys (F&U-avdelning), ML-verktyg, analys, statistik. Vi vill att informationen ska vara transparent - för detta passar Kafka bra.
Nu kommer den mer intressanta delen om de misstag som gjorts och de intressanta upptäckter som har skett under det senaste halvåret.
Designproblem
Anta att vi vill skapa något nytt - till exempel, överföra hela leveransprocessen till Kafka. Just nu implementeras en del av processen i Order Processing i BOB. Bakom överföringen av beställningen till fraktjänsten, flyttning till ett mellanlager och annat ligger en statusmodell. Det finns en hel monolit, till och med två, plus massor av API:er relaterade till leverans. De vet mycket mer om leveransen.
Det verkar som om dessa områden är lika, men för Order Processing i BOB och för leveranssystemet är statusarna olika. Vissa budfirmor skickar till exempel inte mellanliggande statusar, utan bara de slutgiltiga: "levererad" eller "förlorad". Andra, tvärtom, rapporterar väldigt detaljerat om varans rörelse. Var och en har sina egna valideringsregler: för vissa är en e-postadress giltig, så den behandlas; för andra är den ogiltig, men beställningen kommer fortfarande att behandlas eftersom det finns ett telefonnummer för kontakt, medan någon annan säger att en sådan beställning överhuvudtaget inte kommer att behandlas.
Datastream
I fallet med Kafka uppstår frågan om organisationen av datastreamen. Denna uppgift är kopplad till valet av strategi på flera punkter, låt oss gå igenom dem alla.
I en topic eller i flera?
Vi har en specifikation för händelsen. I BOB skriver vi att en viss beställning ska levereras, och vi anger: beställningsnummer, dess innehåll, några SKU och streckkoder etc. När varan anländer till lagret kommer leveransen att kunna få statusar, tidsstämplar och allt som behövs. Men vi vill sedan i BOB få uppdateringar baserat på dessa data. En omvänd process för att hämta data från leveransen uppstår. Är det samma händelse? Eller är det en separat utbyte som förtjänar en egen topic?
Förmodligen kommer de att likna varandra starkt, och frestelsen att skapa en topic är inte ogrundad, eftersom en separat topic innebär separata konsumenter, separata konfigurationer, separat generering av allt detta. Men det är inte säkert.
Nytt fält eller ny händelse?
Men om man använder samma händelser, uppstår ett annat problem. Till exempel kan inte alla distributionssystem generera ett sådant DTO som BOB kan generera. Vi skickar dem id, men de sparar inte dessa eftersom de inte behövs, och sett ur händelse-hubbens startpunkt är det här fältet obligatoriskt.
Om vi sätter en regel för händelse-hubben att detta fält är obligatoriskt, tvingas vi införa ytterligare valideringsregler i BOB eller i hanteraren för start-händelsen. Valideringen börjar sprida sig över tjänsten – det är inte särskilt praktiskt.
Ett annat problem är frestelsen till inkrementell utveckling. Man säger till oss att vi behöver lägga till något i händelsen, och kanske, om man verkligen tänker efter, borde det ha varit en separat händelse. Men i vår struktur är en separat händelse ett separat ämne. Ett separat ämne innebär hela den process jag beskrev ovan. Utvecklaren frestas att helt enkelt lägga till ett annat fält i JSON-schemat och regenerera.
För refunds kom vi på ett halvår till händelse av händelser. Vi hade en meta-händelse som kallas refund update, som hade ett fält av typen som beskrev vad den här uppdateringen egentligen handlar om. Från detta hade vi "fantastiska" switchar med validerare som sa hur man skulle valida denna händelse med denna typ.
Versionering av händelser
För validering av meddelanden i Kafka kan man använda , men man behövde planera för detta direkt och använda Confluent. I vårt fall med versioneringen måste vi vara försiktiga. Det kommer inte alltid att vara möjligt att läsa om meddelandena från repliceringsloggen, eftersom modellen har "åkt iväg". I huvudsak får vi bygga versioner så att modellen är bakåtkompatibel: till exempel göra fältet tillfälligt icke-obligatoriskt. Om skillnaderna är för stora börjar vi skriva i ett nytt ämne, och klienterna byter över när de har läst klart det gamla.
Garanti för läsningsordning av partitioner
Ämnen i Kafka är uppdelade i partitioner. Detta är inte särskilt viktigt medan vi designar entiteter och utbyten, men viktigt när vi beslutar hur vi ska konsumera och skala.
I normala fall skriver du till Kafka en topic. Som standard används en partition, och alla meddelanden i denna topic hamnar där. Consumer läser därefter dessa meddelanden sekventiellt. Anta nu att du behöver utöka systemet så att meddelandena kan läsas av två olika consumrar. Om du till exempel skickar ett SMS kan du be Kafka att skapa en extra partition, och Kafka börjar fördela meddelandena mellan två delar — hälften dit, hälften hit.
Hur delar Kafka dem? Varje meddelande har en kropp (där vi lagrar JSON) och en nyckel. Till denna nyckel kan en hash-funktion kopplas, som kommer att bestämma vilken partition meddelandet hamnar i.
I vårt fall med refunds är detta viktigt. Om vi tar två partitioner finns risken att en parallell consumer hanterar den andra händelsen tidigare än den första, vilket kan leda till problem. Hash-funktionen garanterar att meddelanden med samma nyckel hamnar i samma partition.
Events vs kommandon
Detta är ett annat problem som vi stötte på. Event är en händelse: vi säger att något har hänt (something_happened), till exempel att ett objekt har avbrutits eller en återbetalning har skett. Om någon lyssnar på dessa händelser, kommer en entitet refund att skapas vid "objektet avbröts", och "återbetalning har skett" kommer att registreras någonstans i inställningarna.
Men vanligtvis, när du designar händelser, vill du inte bara skriva dem för sakens skull — du förväntar dig att de ska läsas av någon. Det finns en stark frestelse att skriva något som inte är something_happened (item_canceled, refund_refunded), utan något som bör göras, till exempel item klar för retur.
Å ena sidan indikerar detta hur händelsen kommer att användas. Å andra sidan liknar det mycket mindre ett normalt händelse namn. Dessutom ligger det nära till hands att ge en kommando do_something. Men du har ingen garanti för att detta event har blivit läst; och om det har lästs, så har det lästs framgångsrikt; och om det har lästs framgångsrikt, så gjordes något, och det något gick igenom framgångsrikt. I det ögonblick händelsen blir do_something, blir återkoppling nödvändig, och det är ett problem.
Vid asynkron kommunikation i RabbitMQ, när du har läst ett meddelande, gått vidare till http, har du en respons — åtminstone att meddelandet har accepterats. När du skriver i Kafka har du ett meddelande om att du har skrivit i Kafka, men du vet ingenting om hur det har behandlats.
Därför var vi tvungna att införa en svarshändelse i vårt fall och konfigurera övervakning för att om det inträffade ett visst antal händelser på en viss tid, så skulle lika många svarshändelser komma in. Om detta inte hände, verkar det som om något gick fel. Till exempel, om vi skickade händelsen "item_ready_to_refund", förväntar vi oss att en återbetalning ska skapas, att kunden ska få tillbaka sina pengar och att vi ska få händelsen "money_refunded". Men det är inte säkert, därför behövs övervakning.
Detaljer
Det finns ett ganska uppenbart problem: om du läser från ämnet sekventiellt och du har något meddelande som är dåligt, kraschar konsumenten och du kommer inte vidare. Du behöver stoppa alla konsumenter, begå offset längre fram för att kunna fortsätta läsa.
Vi var medvetna om detta, vi hade förberett oss för det, men det hände ändå. Detta inträffade eftersom händelsen var giltig ur events-bus perspektiv, händelsen var giltig ur applikationsvaliderarens perspektiv, men den var inte giltig ur PostgreSQL:s perspektiv, eftersom vi i ett system har MySQL med UNSIGNED INT, medan det nyss skrivna systemet hade PostgreSQL med bara INT. Dess storlek är något mindre och Id fick inte plats. Symfony dog med ett undantag. Självklart fångade vi undantaget eftersom vi hade förberett oss för det och planerade att begå detta offset, men innan dess ville vi inkrementera problemräknaren, eftersom meddelandet hanterades misslyckat. Räknarna i detta projekt ligger också i databasen, och Symfony hade redan avslutat kommunikationen med databasen, och det andra undantaget dödade hela processen utan chans att begå offset.
Servicen låg nere ett tag - lyckligtvis är det inte så farligt med Kafka, för meddelandena ligger kvar. När arbetet återupptas kan de läsas igen. Det är praktiskt.
Kafka har möjlighet att via verktyg sätta en godtycklig offset. Men för att göra detta behöver du stoppa alla konsumenter - i vårt fall förbereda en separat release där det inte finns några konsumenter, inga omlokaliseringar. Då kan du via verktygen i Kafka justera offset, och meddelandet kommer att gå igenom.
En annan detalj - replikationslogg vs rdkafka.so — är kopplad till specifikationen av vårt projekt. Vi använder PHP, och i PHP kommunicerar ofta alla bibliotek med Kafka via rdkafka.so-repositoriet, och sedan finns det något slags omslag. Kanske är det våra personliga utmaningar, men det visade sig att det helt enkelt inte är så lätt att läsa om något som man redan har läst. Sammanfattningsvis hade vi programvaruproblem.
Tillbaka till specifikationerna för hur man arbetar med partitions, står det skrivet direkt i dokumentationen consumers >= topic partitions. Men jag fick veta detta mycket senare än jag hade velat. Om du vill skala upp och ha två konsumenter behöver du minst två partitions. Det innebär att om du har haft en partition där 20 000 meddelanden har samlats, och du har skapat en ny, kommer antalet meddelanden att jämnas ut först efter en tid. Så för att ha två parallella konsumenter måste man förstå sig på partitions.
Övervakning
Jag tror att det kommer att bli ännu tydligare, baserat på hur vi övervakar, vilka problem som finns i den nuvarande metoden.
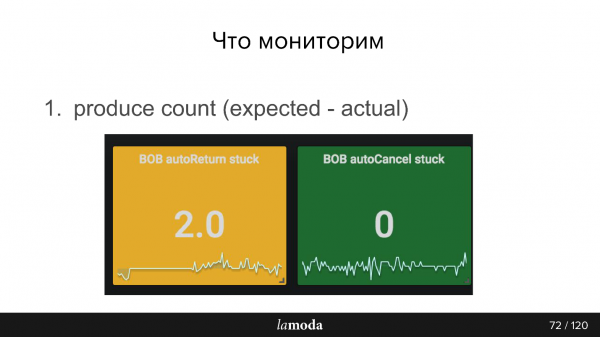
Till exempel räknar vi hur många produkter som nyligen har ändrat status i databasen, och i enlighet med dessa förändringar borde det ha inträffat händelser, och vi skickar detta nummer till vårt övervakningssystem. Sedan får vi från Kafka det andra numret, det som faktiskt har registrerats av händelser. Uppenbarligen ska skillnaden mellan dessa två siffror alltid vara noll.
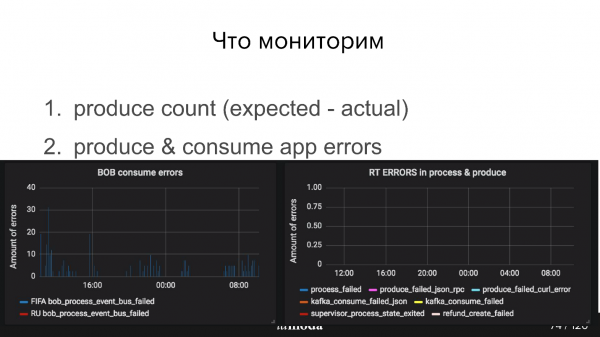
Dessutom måste vi övervaka hur det går för producenterna, om events-bussen har tagit emot meddelanden, och hur det går för konsumenten. Till exempel är allt bra med Refund Tool på graferna nedan, men BOB har uppenbarligen några problem (blå toppar).
Jag har redan nämnt consumer-group lag. Grovt sagt är det antalet olästa meddelanden. Generellt arbetar konsumenterna snabbt, så lag är vanligtvis 0, men ibland kan det uppstå kortvariga toppar. Kafka hanterar detta ur lådan, men man måste ange en viss tidsram.
Det finns ett projekt , som ger dig mer information om Kafka. Det ger helt enkelt via API:n statusen för consumer-group och hur det går för denna grupp. Förutom OK och Failed finns det också warning, och du kan få veta att dina konsumenter inte klarar av tempot i producerandet – att de inte hinner läsa det som skrivs. Systemet är ganska smart, det är praktiskt att använda.
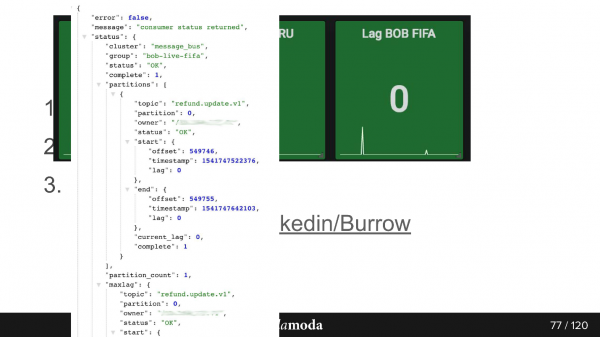
Så här ser svaret ut via API:n. Här är gruppen bob-live-fifa, partition refund.update.v1, status OK, lag 0 – den senaste slutliga offset är så här.
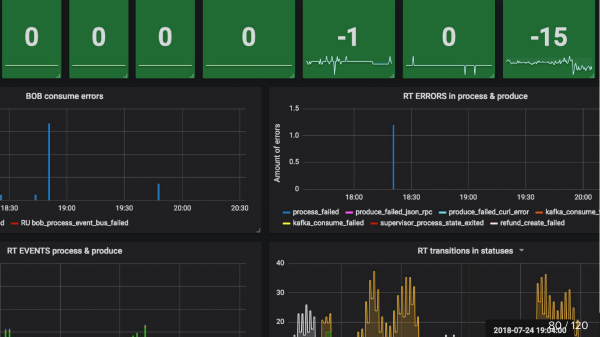
Övervakning updated_at SLA (stuck) Jag har redan nämnt det. Till exempel har produkten övergått till statusen "redo för återbetalning". Vi sätter upp en Cron som säger att om den här objektet inte har övergått till återbetalning inom 5 minuter (vi återbetalar pengar snabbt via betalningssystem), så har något definitivt gått fel, och det är en klar fall för supporten. Så vi använder helt enkelt en Cron som läser sådana saker, och om de är fler än 0, så skickar den en alert.
Sammanfattningsvis är det bekvämt att använda händelser när:
- information behövs av flera system;
- resultatet av bearbetningen inte betyder något;
- det finns få händelser eller händelserna är små.
Det kan tyckas som att artikeln har ett helt konkret ämne – asynkront API på Kafka, men jag har mycket att rekommendera i samband med det.
För det första, nästa behöver vi vänta till november, men redan i april kommer den lokala versionen att hållas i Sankt Petersburg, och i juni pratar vi om hög belastning i Novosibirsk.
För det andra, rapportförfattaren Sergey Zaika är medlem av det programkommitté för vår nya konferens om kunskapsstyrning. Konferensen är en endags och äger rum den 26 april, men programmet är mycket intensivt.
Och dessutom kommer det i maj och (med DevOpsConf som del) – dit kan du även foreslå ditt ämne, berätta om din erfarenhet och klaga på dina inlärda läxor.
Källa: habr.com
