

Varje stort projekt börjar med ett par servrar. Först fanns det en databasserver, sedan lades ytterligare slavar till för att skala läsningen. Och här — stopp! Det finns en master och många slavar; om en av slavarna går ner är det okej, men om mastern går ner — då blir det problem: driftstopp, administratörer står med huvudet i händerna för att återställa servern. Vad ska vi göra? Reservkopiera mastern. Min kollega Pavel har redan skrivit om detta. , jag kommer inte att upprepa det. Istället kommer jag att berätta varför du absolut behöver Orchestrator för MySQL!
Låt oss börja med den viktigaste frågan: "Hur ska vi växla koden till den nya maskinen när mastern går ner?".
- Schemat med VIP (Virtual IP) gillar jag mest, och det är det vi kommer att diskutera nedan. Det är det enklaste och mest uppenbara, även om det har en tydlig begränsning: den master som vi ska reservkopiera måste ligga inom L2-segmentet med den nya maskinen, vilket innebär att den andra datacentret kan glömmas. Dessutom, om man ska vara ärlig, om man följer regeln att stora L2 är ont, eftersom L2 bara är på stativet, och mellan stativen L3, så har detta schema ännu fler begränsningar.
- Man kan ange DNS-namnet i koden och lösa det via /etc/hosts. I verkligheten kommer dock ingen lösning att ske. Fördel med schemat: det finns ingen av dessa begränsningar som kännetecknar den första metoden, så man kan även skapa en cross-Datacenter lösning. Men då uppkommer den uppenbara frågan, hur snabbt vi genom Puppet-Ansible kan leverera förändringen i /etc/hosts.
- Man kan ändra den andra metoden lite: på alla webbservrar installerar vi en cache-DNS, genom vilken koden ska gå till master-databasen. Man kan ange TTL 60 för denna post i DNS. Det verkar som en bra metod om den implementeras korrekt.
- Schemat med service discovery som involverar användningen av Consul och etcd.
- En intressant variant med . All trafik till MySQL behöver gå genom ProxySQL, som själv kan avgöra vem som för närvarande är master. För övrigt, om en av användningarna av denna produkt kan läsas i min .
Författaren av Orchestrator, jobbade på Github, implementerade först det första schemat med VIP, och sedan ändrade han till schemat med Consul.
Typiskt schema för infrastruktur:
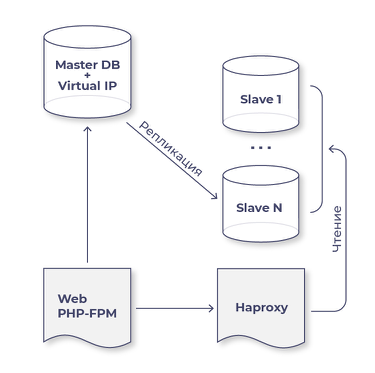
Låt mig omedelbart beskriva uppenbara situationer som måste beaktas:
- VIP-adressen får inte anges i konfigurationen på någon av servrarna. Föreställ dig situationen: mastern startades om, och medan den bootar, har Orchestrator gått över till failover-läge och gjort en av slavarna till master; sedan startar den gamla mastern igen, och nu har vi VIP på två maskiner. Det är dåligt.
- För orkestatorn behöver du skriva ett skript som kontaktar den gamla mastern och den nya mastern. På den gamla måste ifdown köras, medan ifup vip ska köras på den nya mastern. Det vore bra att också inkludera i detta skript att, vid failover, porten på switchen till den gamla mastern stängs för att undvika någon splitbrain.
- Efter att Orchestrator har kallat ditt skript för att först ta bort VIP och/eller stänga porten på switchen, och därefter kalla skriptet för att aktivera VIP på den nya mastern, glöm inte att använda kommandot arping för att informera alla om att den nya VIP nu är här.
- Alla slavar ska ha read_only=1, och så snart du gör en slav till master, ska den ha read_only=0.
- Kom ihåg att vilken slav som helst som vi väljer för detta kan bli master (Orchestrator har en mekanism för att prioritera vilken slav som ska bli ny master först, vilken andra och vilken slav som under inga omständigheter ska bli vald som master). Om en slav blir master, så kommer den ha lasten av slaven och dessutom lagt till lasten av mastern, vilket måste beaktas.
Varför behöver du Orchestrator, om du inte har en?
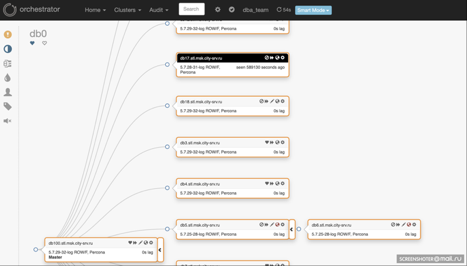
- Orchestrator har ett mycket användarvänligt gränssnitt som visar hela topologin (se skärmdumpen nedan).
- Orchestrator kan övervaka vilka slavar som har fördröjning och var replikeringen har brutit samman (vi har skript anslutna till Orchestrator för att skicka SMS).
- Orchestrator informerar dig om vilka slavar som har ett fel GTID errant.
Orchestrator-gränssnittet:
Vad är GTID errant?
Det finns två grundläggande krav för att Orchestrator ska fungera:
- Det måste vara aktiverat pseudo GTID på alla maskiner i MySQL-klustret, och vi har GTID aktiverat.
- Det måste finnas en typ av binlogs överallt, gärna statement. Vi hade en sådan konfiguration där mastern och de flesta slavar hade Row, medan två historiskt hade Mixed-läget. Som ett resultat ville Orchestrator helt enkelt inte ansluta dessa slavar till den nya mastern.
Kom ihåg att det viktigaste på en production-slav är dess konsistens med mastern! Om både mastern och slaven har Global Transaction ID (GTID) aktiverat, kan man med funktionen gtid_subset ta reda på om samma förändringsförfrågningar faktiskt har utförts på dessa maskiner. Du kan läsa mer om detta. .
På så sätt visar Orchestrator genom GTID-felmeddelandet att det finns transaktioner på slaven som inte finns på mastern. Hur kan detta hända?
- På slaven är read_only=1 inte aktiverat, någon har anslutit och utfört en databasändringsfråga.
- På slaven är super_read_only=1 inte aktiverat, så en administratör kan ha förväxlat servrar och utfört en fråga där.
- Om du har beaktat de två tidigare punkterna finns det en annan finess: i MySQL registreras också frågan om att tömma binloggar i binloggen, så vid första flush på mastern och på alla slavar kommer GTID-felmeddelandet att visas. Hur kan man undvika detta? I perona-5.7.25-28 introducerades inställningen binlog_skip_flush_commands=1, som förhindrar att flush skrivs i binloggar. På mysql.com finns det en uppteckning. .
Sammanfattningsvis allt ovanstående. Om du ännu inte vill använda Orchestrator i failover-läge, sätt det då i bevakningsläge. Då har du alltid en karta över interaktionen mellan MySQL-maskiner framför dig och tydlig information om vilken typ av replikering som finns på varje maskin, om slavar ligger efter och viktigast av allt — hur konsistent de är med mastern!
En uppenbar fråga: "Hur ska Orchestrator fungera?" Den ska välja en ny master bland de nuvarande slavarna och sedan återansluta alla slavar till den (detta är anledningen till att GTID behövs; om man använder den gamla mekanismen med binlog_name och binlog_pos är det helt omöjligt att byta slav från nuvarande master till en ny!). Före Orchestrators tid var jag tvungen att göra allt detta manuellt en gång. Den gamla mastern hängde sig på grund av en buggig Adaptec-kontroll, och den hade cirka 10 slavar. Jag behövde flytta VIP från mastern till en av slavarna och återansluta alla andra slavar dit. Hur många konsoler fick jag inte öppna, hur många kommandon fick jag inte skriva in samtidigt... Jag fick vänta till klockan 03:00, avlasta alla slavar utom två, göra den första maskinen till master av de två, koppla den andra direkt till den, så att alla andra slavar återansluts till den nya mastern och belastningen återställs. I allmänhet, hemskt...
Hur fungerar Orchestrator när den går in i failover-läge? Det är enklast att visa med ett exempel där vi vill göra en kraftfullare och modernare maskin till master än den vi har just nu.
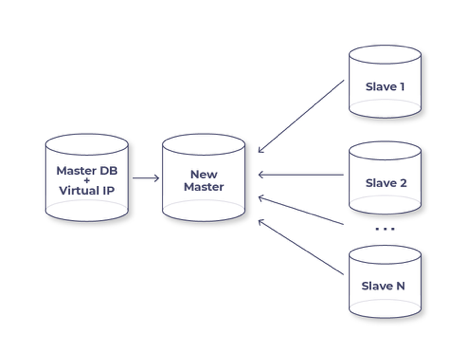
På bilden visas mitten av processen. Vad har redan gjorts fram till den här punkten? Vi sa att vi ville göra en slavinspelare till den nya mästaren, Orchestrator började helt enkelt koppla om alla andra slavar till den, medan den nya mästaren fungerar som en transitmaskin. Med detta system uppstår inga fel, alla slavar fungerar, Orchestrator tar bort VIP från den gamla mästaren, flyttar den till den nya, sätter read_only=0 och glömmer den gamla mästaren. Klart! Driftstoppet för vår tjänst är den tid det tar att flytta VIP, det är 2-3 sekunder.
Det var allt för idag, tack alla. Snart kommer den andra artikeln om Orchestrator. I den välkända sovjetiska filmen "Garaget" sa en karaktär: "Jag skulle inte gå med honom på spaning!" Så, Orchestrator, jag skulle gå med dig på spaning!
Källa: habr.com
