

Hej vänner. Innan vi går in i den andra delen av majhelgerna delar vi med oss av material som vi har översatt inför lanseringen av den nya kursen. .
Apputvecklare lägger ner mycket tid på att jämföra flera olika operativa databaser för att välja den som passar bäst för den planerade arbetsbelastningen. Behoven kan inkludera förenklad datamodellering, transaktionsgarantier, läs-/skrivprestanda, horisontell skalbarhet och fel tolerans. Traditionellt börjar valet med kategorin databas, SQL eller NoSQL, eftersom varje kategori erbjuder en tydlig uppsättning kompromisser. Hög prestanda när det gäller låg latens och hög genomströmning betraktas vanligtvis som ett krav utan kompromisser och är därför nödvändigt för varje databas i urvalet.
Syftet med denna artikel är att hjälpa apputvecklare att göra rätt val mellan SQL och NoSQL i kontexten av applikationsdatamodellering. Vi kommer att titta på en SQL databas, nämligen PostgreSQL, och två NoSQL databaser – Cassandra och MongoDB, för att berätta om grunderna i databasdesign, såsom att skapa tabeller, fylla dem, läsa data från tabeller och ta bort data. I nästa artikel kommer vi att titta på index, transaktioner, JOINs, TTL-direktiv och databasdesign baserat på JSON.
Vad är skillnaden mellan SQL och NoSQL?
SQL-databaser ökar applikationens flexibilitet genom ACID-transaktionsgarantier och deras förmåga att hämta data med JOIN på oväntade sätt ovanpå befintliga normaliserade modeller av relationsdatabaser.
Med tanke på deras monolitiska/en-nodstruktur och användning av master-slave-replikationsmodellen för redundans har traditionella SQL-databaser inte två viktiga egenskaper - linjär skrivskalerbarhet (d.v.s. automatisk splittring på flera noder) och automatisk/ingen datarförlust. Det betyder att mängden mottagna data inte kan överskrida den maximala skrivgenomströmningen för en nod. Dessutom måste viss tillfällig datarförlust beaktas vid felhantering (i arkitekturer utan resursdelning). Här måste vi komma ihåg att nyliga commits ännu inte har återspeglats i den underordnade (slave) kopian. Uppdateringar utan driftstopp är också svåra att uppnå i SQL-databaser.
NoSQL-databaser är i sin natur vanligtvis distribuerade, vilket innebär att data delas upp i sektioner och sprids över flera noder. De kräver denormalisering. Det innebär att inskickade data också måste kopieras flera gånger för att svara på specifika förfrågningar som du skickar. Det övergripande målet är att uppnå hög prestanda genom att minska antalet shards som är tillgängliga under läsning. Därför är det viktigt att påpeka att NoSQL kräver att du modellerar dina förfrågningar, medan SQL kräver att du modellerar dina data.
NoSQL fokuserar på att uppnå hög prestanda i en distribuerad kluster och det är den grundläggande motiveringen för många designkompromisser i databaser, som inkluderar förlust av ACID-transaktionsgarantier, JOIN:ar och konsekventa globala sekundära index.
Det finns en uppfattning att även om NoSQL-databaser erbjuder linjär skrivskalerbarhet och hög felhantering, gör förlusten av transaktionsgarantier dem olämpliga för kritiska data.
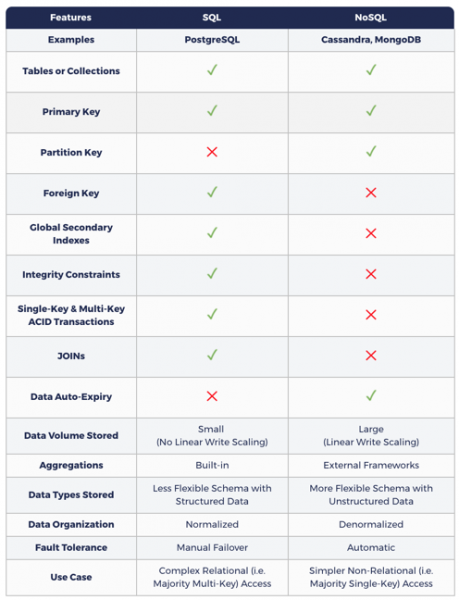
Följande tabell visar hur datamodellering i NoSQL skiljer sig från SQL.
SQL och NoSQL: Varför behöver vi båda?
I verkliga applikationer med ett stort antal användare, som Amazon.com, Netflix, Uber och Airbnb, faller genomförandet av komplexa och olika uppgifter. Till exempel behöver en e-handelsapplikation liknande Amazon.com lagra lätta, högkänsliga uppgifter, såsom användarinformation, produktinformation, beställningar, fakturor, tillsammans med tyngre, men mindre känsliga uppgifter, som produktrecensioner, kundsupportmeddelanden, användaraktivitet, feedback och rekommendationer. Naturligtvis litar dessa applikationer på åtminstone en SQL-databas tillsammans med minst en NoSQL-databas. I interregionala och globala system fungerar NoSQL-databasen som en geografiskt distribuerad cache för data som lagras i en betrodd källa, SQL-databasen som körs i en viss region.
Hur förenar YugaByte DB SQL och NoSQL?
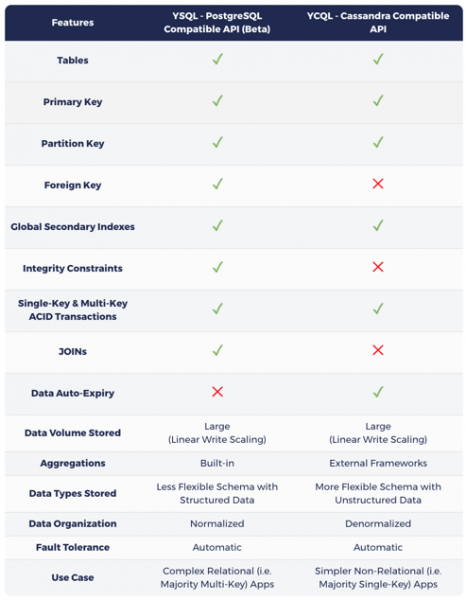
Byggd på en loggorienterad blandmotor för lagring, automatisk sharding, sharddistribution och ACID-distribuerad Consensus-replikerings- och distribuerade transaktioner (inspirerade av Google Spanner), är YugaByte DB den första open-source databasen i världen som är samtidigt kompatibel med NoSQL (Cassandra & Redis) och SQL (PostgreSQL). Som det visas i tabellen nedan, lägger YCQL, YugaByte DB:s Cassandra-kompatibla API, till begrepp av en- och flernyckel ACID-transaktioner och globala sekundära index i NoSQL API:t, vilket öppnar en era av transaktionella NoSQL-databaser. Dessutom lägger YCQL, YugaByte DB:s PostgreSQL-kompatibla API, till begrepp för linjär skrivskaling och automatisk felsäkerhet till SQL API:t, och presenterar för världen distribuerade SQL-databaser. Eftersom YugaByte DB i grunden är transaktionell, kan NoSQL-API:t nu användas i kontexten av kritiskt viktiga data.
Som nämnts tidigare i artikeln , valet mellan SQL eller NoSQL i YugaByte DB beror helt på egenskaperna hos den underliggande arbetsbelastningen:
- Om den underliggande arbetsbelastningen består av flernyckeloperationer med JOIN:ar, välj YSQL och förstå att dina nycklar kan vara spridda över flera noder, vilket kommer att resultera i högre latens och/eller minskad genomströmning än i NoSQL.
- Annars kan du välja något av de två NoSQL-API:erna, med vetskap om att du kommer att få högre prestanda som ett resultat av förfrågningar som hanteras av en nod åt gången. YugaByte DB kan fungera som en enda operativ databas för verkligt komplexa applikationer där det behövs hantering av flera arbetsbelastningar samtidigt.
I den kommande sektionen av datamodelleringslaboratoriet baseras på YugaByte DB:s API:er som är kompatibla med PostgreSQL och Cassandra, till skillnad från de ursprungliga databaserna. Denna metod betonar enkelheten i att interagera med två olika API:er (på två olika portar) av samma databas som motsats till att använda helt oberoende kluster av två olika databaser.
I de kommande sektionerna kommer vi att utforska datamodelleringslaboratoriet för att illustrera skillnaderna och vissa likheter mellan de granskade databaserna.
Datamodelleringslaboratorium
Installation av databaser
Med fokus på datamodellens design (och inte komplexa distributionsarkitekturer) kommer vi att installera databaserna i Docker-containrar på den lokala datorn och sedan interagera med dem via deras respektive kommandoradsgränssnitt.
YugaByte DB, kompatibel med PostgreSQL & Cassandra
mkdir ~/yugabyte && cd ~/yugabyte
wget https://downloads.yugabyte.com/yb-docker-ctl && chmod +x yb-docker-ctl
docker pull yugabytedb/yugabyte
./yb-docker-ctl create --enable_postgres
MongoDB
docker run --name my-mongo -d mongo:latestÅtkomst via kommandoraden
Låt oss ansluta till databaserna med hjälp av kommandoradsgränssnittet för de respektive API:erna.
PostgreSQL
— detta är kommandoradsgränssnittet för att interagera med PostgreSQL. För enkelhetens skull levereras YugaByte DB med psql direkt i bin-mappen.
docker exec -it yb-postgres-n1 /home/yugabyte/postgres/bin/psql -p 5433 -U postgresCassandra
— detta är kommandoradsgränssnittet för att interagera med Cassandra och dess kompatibla databaser via CQL (Cassandra Query Language). För användarvänlighet gör YugaByte DB det klart att cqlsh i katalogen bin.
Observera att CQL är inspirerat av SQL och har liknande begrepp som tabeller, rader, kolumner och index. Men som ett NoSQL-språk lägger det till en viss uppsättning begränsningar, de flesta av vilka vi också kommer att granska i andra artiklar.
docker exec -it yb-tserver-n1 /home/yugabyte/bin/cqlshMongoDB
– är ett kommandoradsgränssnitt för att interagera med MongoDB. Det kan hittas i bin-katalogen för MongoDB-installationen.
docker exec -it my-mongo bash
cd bin
mongo
Skapa en tabell
Nu kan vi interagera med databasen för att utföra olika operationer via kommandoraden. Låt oss börja med att skapa en tabell som lagrar information om låtar skrivna av olika artister. Dessa låtar kan vara en del av ett album. Även valfria attribut för låten – utgivningsår, pris, genre och betyg. Vi behöver ta hänsyn till ytterligare attribut som kan behövas i framtiden genom fältet "taggar". Det kan lagra semi-strukturerade data i form av nyckel-värde-par.
PostgreSQL
CREATE TABLE Music (
    Artist VARCHAR(20) NOT NULL,
    SongTitle VARCHAR(30) NOT NULL,
    AlbumTitle VARCHAR(25),
    Year INT,
    Price FLOAT,
    Genre VARCHAR(10),
    CriticRating FLOAT,
    Tags TEXT,
    PRIMARY KEY(Artist, SongTitle)
);
Cassandra
Att skapa en tabell i Cassandra är mycket likt PostgreSQL. En av de stora skillnaderna är avsaknaden av integritetsbegränsningar (t.ex. NOT NULL), men detta faller inom applikationens ansvar, inte NoSQL-databasen.. Den primära nyckeln består av en partition key (kolumnen Artist i exemplet nedan) och ett set av clustering columns (kolumnen SongTitle i det nedan givna exemplet). Partition key anger vilken partition/shard som en rad ska placeras i, medan clustering columns anger hur datan ska organiseras inom den aktuella sharden.
CREATE KEYSPACE myapp;
USE myapp;
CREATE TABLE Music (
    Artist TEXT,
    SongTitle TEXT,
    AlbumTitle TEXT,
    Year INT,
    Price FLOAT,
    Genre TEXT,
    CriticRating FLOAT,
    Tags TEXT,
    PRIMARY KEY(Artist, SongTitle)
);
MongoDB
MongoDB organiserar data i databaser (Database) (motsvarande Keyspace i Cassandra), där det finns samlingar (Collections) (motsvarande tabeller), i vilka dokument (Documents) (motsvarande rader i en tabell) finns. I MongoDB krävs principiellt ingen initial definitionsschema. Kommandot "use database", som visas nedan, skapar en instans av databasen vid första anropet och ändrar kontexten till den nyss skapade databasen. Även samlingar behöver inte skapas explicit, de skapas automatiskt när den första dokumentet läggs till i en ny samling. Observera att MongoDB som standard använder en testdatabas, så alla operationer på samlingsnivå utan att ange en specifik databas kommer att utföras där som standard.
use myNewDatabase;Hämta information om tabellen
PostgreSQL
d Musik
Tabell "public.music"
    Kolumn    |         Typ          | Sortering | Nullable | Standard
--------------+-----------------------+-----------+----------+--------
 artist       | tecken varierande(20) |           | ej null |
 songtitle    | tecken varierande(30) |           | ej null |
 albumtitle   | tecken varierande(25) |           |          |
 år           | heltal               |           |          |
 pris         | dubbel precision      |           |          |
 genre        | tecken varierande(10) |           |          |
 kritikerbetyg | dubbel precision      |           |          |
 tags         | text                  |           |          |
Index:
    "music_pkey" PRIMÄR NYCKEL, btree (artist, songtitle)
Cassandra
BESKRIV TABELL MUSIC;
SKAPA TABELL myapp.music (
    artist text,
    songtitle text,
    albumtitle text,
    år int,
    pris float,
    genre text,
    tags text,
    PRIMÄR NYCKEL (artist, songtitle)
) MED KLUSTERINGSORDNING EFTER (songtitle ASC)
    OCH default_time_to_live = 0
    OCH transaktioner = {'enabled': 'false'};
MongoDB
använd myNewDatabase;
visa kollektioner;
Införande av data i tabellen
PostgreSQL
INFÖR i Musik
    (Artist, Låt, Album,
    År, Pris, Genre, Kritikerbetyg,
    Taggar)
VALUES(
    'No One You Know', 'Call Me Today', 'Somewhat Famous',
    2015, 2.14, 'Country', 7.8,
    '{"Composers": ["Smith", "Jones", "Davis"],"LengthInSeconds": 214}'
);
INFÖR i Musik
    (Artist, Låt, Album,
    Pris, Genre, Kritikerbetyg)
VALUES(
    'No One You Know', 'My Dog Spot', 'Hey Now',
    1.98, 'Country', 8.4
);
INFÖR i Musik
    (Artist, Låt, Album,
    Pris, Genre)
VALUES(
    'The Acme Band', 'Look Out, World', 'The Buck Starts Here',
    0.99, 'Rock'
);
INFÖR i Musik
    (Artist, Låt, Album,
    Pris, Genre,
    Taggar)
VALUES(
    'The Acme Band', 'Still In Love', 'The Buck Starts Here',
    2.47, 'Rock',
    '{"radioStationsPlaying": ["KHCR", "KBQX", "WTNR", "WJJH"], "tourDates": { "Seattle": "20150625", "Cleveland": "20150630"}, "rotation": Heavy}'
);
Cassandra
Generellt uttryck INSÄTT i Cassandra ser väldigt liknande ut som det motsvarande i PostgreSQL. Men det finns en stor skillnad i semantiken. I Cassandra INSÄTT är det faktiskt en operation UPSERT, där de senaste värdena läggs till i raden, om raden redan finns.
Datainmatning sker på ett sätt som liknar PostgreSQL.
INSÄTTmetoden.
.
MongoDB
Trots att MongoDB är en NoSQL-databas, liknande Cassandra, har dess datainmatningsoperationer inget gemensamt med semantiken i Cassandra. I MongoDB har ingen kapacitet UPSERT, vilket gör att den liknar PostgreSQL. Att lägga till data som standard utan _idspecified kommer resultera i att ett nytt dokument läggs till i kollektionen.
db.music.insert( {
 artist: "Ingen som du känner",
 songTitle: "Ring mig idag",
 albumTitle: "Något berömt",
 year: 2015,
 price: 2.14,
 genre: "Country",
 tags: {
 Composers: ["Smith", "Jones", "Davis"],
 LengthInSeconds: 214
 }
 }
 );
 db.music.insert( {
 artist: "Ingen som du känner",
 songTitle: "Min hund Spot",
 albumTitle: "Hej nu",
 price: 1.98,
 genre: "Country",
 criticRating: 8.4
 }
 );
 db.music.insert( {
 artist: "The Acme Band",
 songTitle: "Se upp, världen",
 albumTitle:"Dollar börjar här",
 price: 0.99,
 genre: "Rock"
 }
 );
 db.music.insert( {
 artist: "The Acme Band",
 songTitle: "Fortfarande förälskad",
 albumTitle:"Dollar börjar här",
 price: 2.47,
 genre: "Rock",
 tags: {
 radioStationsPlaying:["KHCR", "KBQX", "WTNR", "WJJH"],
 tourDates: {
 Seattle: "20150625",
 Cleveland: "20150630"
 },
 rotation: "Heavy"
 }
 }
 );
Förfrågan i tabellen
Kanske den mest betydande skillnaden mellan SQL och NoSQL i termer av att göra förfrågningar ligger i användningen av formuleringar FRÅN och DÄR. SQL tillåter flera tabeller efter uttrycket FRÅN att välja, och uttrycket med DÄR kan ha vilken komplexitet som helst (inklusive operationer JOIN mellan tabeller). Men NoSQL tenderar att införa strikta begränsningar på FRÅN, och fungerar endast med en angiven tabell, medan i DÄR, måste en primärnyckel alltid anges. Detta beror på strävan att öka prestandan på NoSQL, som vi tidigare har diskuterat. Denna strävan leder till en minskning av all kors-tabell och kors-nyckel interaktion. Det kan orsaka stor fördröjning i nod-nod kommunikation vid svar på förfrågningar och bör därför undvikas helt. Till exempel kräver Cassandra att förfrågningar begränsas till specifika operationer (endast tillåtna =, IN, , =>, <=) på partitionsnycklar, förutom i fall av sekundärindexförfrågningar (här tillåts endast operatorn =).
PostgreSQL
Här är tre exempel på förfrågningar som lätt kan utföras av en SQL-databas.
- Hämta alla låtar av artisten;
- Hämta alla låtar av artisten som matchar den första delen av titeln;
- Hämta alla låtar av artisten som har ett visst ord i titeln och kostar mindre än 1.00.
SELECT * FROM Music
WHERE Artist='No One You Know';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle LIKE 'Call%';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle LIKE '%Today%'
AND Price > 1.00;
Cassandra
Av de ovan nämnda frågorna kommer endast den första att fungera i Cassandra utan ändringar, eftersom operatorn LIKE inte kan tillämpas på klusterkolumner, såsom SongTitle. I detta fall tillåts endast operatorer = och IN.
SELECT * FROM Music
WHERE Artist='No One You Know';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle IN ('Call Me Today', 'My Dog Spot')
AND Price > 1.00;
MongoDB
Som visat i de tidigare exemplen, är den främsta metoden för att skapa förfrågningar i MongoDB . Denna metod innehåller tydligt namnet på samlingen (music i exemplet nedan), så förfrågningar över flera samlingar är inte tillåtna.
db.music.find( {
  artist: "No One You Know"
 }
);
db.music.find( {
  artist: "No One You Know",
  songTitle: /Call/
 }
);
Läsa alla rader i tabellen
Att läsa alla rader är helt enkelt ett specialfall av den frågemall som vi diskuterat tidigare.
PostgreSQL
SELECT *
FROM Music;
Cassandra
På samma sätt som exemplet i PostgreSQL ovan.
MongoDB
db.music.find( {} );Redigera data i tabellen
PostgreSQL
PostgreSQL tillhandahåller instruktionen UPPDATERA för att ändra data. Den har ingen funktionalitet UPSERT, så att köra denna instruktion kommer att resultera i ett felmeddelande om raderna inte längre finns i databasen.
UPDATE Music
SET Genre = 'Disco'
WHERE Artist = 'The Acme Band' AND SongTitle = 'Still In Love';
Cassandra
I Cassandra finns det UPPDATERA en motsvarande PostgreSQL. UPPDATERA har samma semantik UPSERT, liknande INSÄTT.
På samma sätt som exemplet i PostgreSQL ovan.
MongoDB
Operation I MongoDB kan man helt uppdatera ett befintligt dokument eller endast uppdatera specifika fält. Som standard uppdaterar den endast ett dokument med semantiken inaktiverad. UPSERT. Att uppdatera flera dokument och beteende är liknande. UPSERT det kan tillämpas genom att ställa in ytterligare flaggor för operationen. Precis som i det följande exemplet, uppdateras genren för en specifik artist baserat på deras låt.
db.music.update(
  {"artist": "The Acme Band"},
  {
    $set: {
      "genre": "Disco"
    }
  },
  {"multi": true, "upsert": true}
);
Ta bort data från tabellen
PostgreSQL
DELETE FROM Music
WHERE Artist = 'The Acme Band' AND SongTitle = 'Look Out, World';
Cassandra
På samma sätt som exemplet i PostgreSQL ovan.
MongoDB
I MongoDB finns det två typer av operationer för att ta bort dokument — och . Båda typerna tar bort dokument, men returnerar olika resultat.
db.music.deleteMany( {
        artist: "The Acme Band"
    }
);
Ta bort tabellen
PostgreSQL
DROP TABLE Music;Cassandra
På samma sätt som exemplet i PostgreSQL ovan.
MongoDB
db.music.drop();Slutsats
Debatten om valet mellan SQL och NoSQL har pågått i över 10 år. Det finns två huvudaspekter av denna debatt: kärnarkitekturen i databasen (monolitisk, transaktionell SQL mot distribuerad, icke-transaktionell NoSQL) och designmetoden för databasen (datamodellering i SQL mot att modellera dina förfrågningar i NoSQL).
Med en distribuerad transaktionell databas som YugaByte DB kan debatten om databasarkitektur enkelt skingras. Allt eftersom datamängderna blir större än vad som kan skrivs på en nod, blir en helt distribuerad arkitektur som stödjer linjär skrivskalerbarhet med automatisk sharding/omfördelning nödvändig.
Förutom det som nämns i en av artiklarna , används transaktionella, strikt överenskomna arkitekturer nu i större utsträckning för att säkerställa bättre flexibilitet i utvecklingen än icke-transaktionella, slutligen överenskomna arkitekturer.
Återkommer till diskussionen om databasdesign, är det rimligt att säga att båda designmetoderna (SQL och NoSQL) är nödvändiga för alla komplexa verkliga applikationer. SQL-ansatsen "datamodellering" gör det lättare för utvecklare att möta föränderliga affärskrav, medan NoSQL-ansatsen "frågemodellering" tillåter samma utvecklare att hantera stora datamängder med låg latens och hög genomströmning. Just av denna anledning erbjuder YugaByte DB både SQL- och NoSQL-API:er i en gemensam kärna, snarare än att förespråka någon av metoderna. Dessutom, genom att säkerställa kompatibilitet med populära databasspråk, inklusive PostgreSQL och Cassandra, garanterar YugaByte DB att utvecklare inte behöver lära sig ett annat språk för att arbeta med den distribuerade, strikt konsistenta databasisskern.
I den här artikeln har vi undersökt hur grunderna för databasdesign skiljer sig mellan PostgreSQL, Cassandra och MongoDB. I kommande artiklar kommer vi att dyka in i avancerade designkoncept som index, transaktioner, JOIN:ar, TTL-direktiv och JSON-dokument.
Vi önskar er en trevlig kvarvarande helg och inbjuder till , som redan äger rum den 14 maj.
Källa: habr.com
