

Den här våren har vi redan diskuterat vissa introduktionsteman, som och . I den andra lovade vi till och med att fortsätta studera prestanda för olika fler-disktopologier i ZFS. Detta är nästa generations filsystem som nu implementeras överallt: från till .
Nåväl, idag är den mest passande dagen för att bekanta sig med ZFS, nyfikna läsare. Bara kom ihåg att enligt en blygsam uppskattning från OpenZFS-utvecklaren Matt Arens, "det är verkligen komplicerat".
Men innan vi kommer till siffrorna - och de kommer, det lovar jag - för alla alternativ för åttadiskkonfigurationer av ZFS, måste vi prata om hur som ZFS överhuvudtaget lagrar data på disken.
Zpool, vdev och device
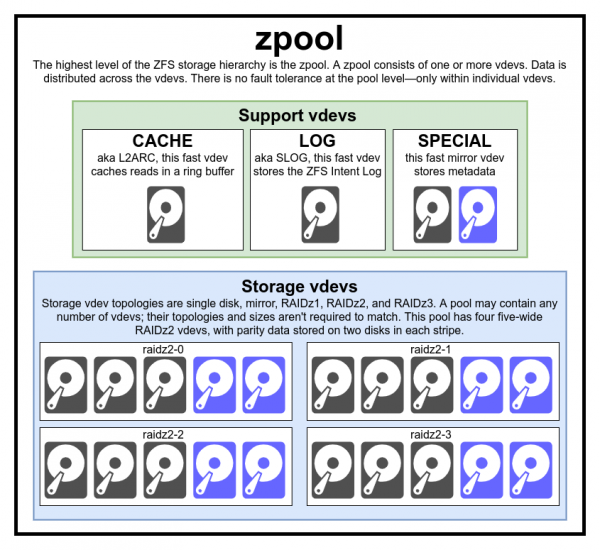
Detta diagram över hela poolen innehåller tre hjälp-vdev:er, en av varje klass, och fyra för RAIDz2
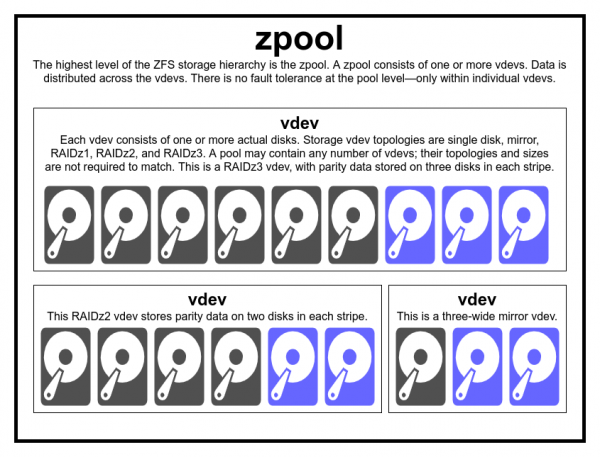
Vanligtvis finns det inga skäl att skapa en pool av olika typer och storlekar av vdev - men om du vill, finns inget som hindrar dig från att göra det
För att verkligen förstå filsystemet ZFS måste man ta en noggrann titt på dess faktiska struktur. För det första förenar ZFS traditionella nivåer av volymhantering och filsystem. För det andra använder det en transaktionell mekanism för kopiering vid skrivning. Dessa egenskaper innebär att systemet är strukturellt mycket annorlunda än vanliga filsystem och RAID-arrayer. Den första uppsättningen grundläggande byggstenar för förståelse: det är lagringspoolen (zpool), det virtuella enhet (vdev) och den verkliga enheten (device).
zpool
Lagringspoolen zpool är den översta strukturen i ZFS. Varje pool innehåller en eller flera virtuella enheter. I sin tur innehåller var och en av dem en eller flera verkliga enheter (device). Virtuella pooler är fristående block. En fysisk dator kan innehålla två eller flera separata pooler, men varje är helt oberoende av de andra. Pooler kan inte dela virtuella enheter.
Redundansen i ZFS finns på nivån av virtuella enheter, snarare än på nivån av pooler. På poolnivå finns det absolut ingen redundans - om någon vdev-lagringsenhet eller special-vdev går förlorad, förloras hela poolen.
Moderna lagringspooler kan överleva förlust av cache eller logg från det virtuella enheten – även om de kan förlora en liten mängd orena data om de förlorar vdev-loggen under strömavbrott eller systemfel.
Det finns en vanlig missuppfattning om att "data stripes" (strimmor) av ZFS skrivs över hela poolen. Detta är fel. Zpool är inte helt enkelt en rolig RAID0, det är snarare en rolig med en komplex och variabel mekanism för fördelning.
För det mesta fördelas poster mellan tillgängliga virtuella enheter baserat på det tillgängliga fria utrymmet så att teoretiskt alla kommer att fyllas samtidigt. I senare versioner av ZFS beaktas den aktuella användningen (utnyttjandet) av vdev - om en virtuell enhet är betydligt mer belastad än en annan (till exempel på grund av läsningsbelastning) kommer den tillfälligt att hoppa över för skrivning, trots att det finns den högsta andelen ledigt utrymme.
De inbyggda mekanismerna för att bestämma utnyttjandet i moderna metoder för skrivfördelning i ZFS kan minska latensen och öka bandbredden under perioder av ovanligt hög belastning - men det är inte fritt spelrum för oavsiktlig blandning av långsamma HDD och snabba SSD i en och samma pool. En sådan ojämlik pool kommer fortfarande att fungera med hastigheten hos den långsammaste enheten, det vill säga som om den helt består av sådana enheter.
vdev
Varje lagringspool består av en eller flera virtuella enheter (virtual device, vdev). I sin tur inkluderar varje vdev en eller flera verkliga enheter. De flesta virtuella enheter används för enkel datalagring, men det finns flera hjälpklasser av vdev, inklusive CACHE, LOG och SPECIAL. Varje typ av vdev kan ha en av fem topologier: enhet (single-device), RAIDz1, RAIDz2, RAIDz3 eller spegel (mirror).
RAIDz1, RAIDz2 och RAIDz3 är speciella varianter av det som gamla kallar RAID med dubbel (diagonal) paritet. 1, 2 och 3 syftar på hur många paritetsblock som tilldelas för varje dataruta. Istället för separata diskar för att säkerställa paritet, fördelar RAIDz virtuella enheter denna paritet jämnt över diskarna. En RAIDz-array kan förlora lika många diskar som den har paritetsblock; om den förlorar en till, går den sönder och drar med sig lagringspoolen.
I speglade virtuella enheter (mirror vdev) lagras varje block på varje enhet i vdev. Även om de vanligaste är dubbelspeglar (two-wide) kan det i spegeln finnas ett godtyckligt antal enheter — i större installationer används ofta tredubbla speglar för att öka läsprestanda och redundans. En vdev-spegel kan överleva vilken fel som helst så länge minst en enhet i vdev fortsätter att fungera.
Enskilda vdev är i grunden farliga. En sådan virtuell enhet överlever inte ett enda fel — och om den används som lagring eller speciell vdev, kommer dess fel att förstöra hela poolen. Värna om detta, var mycket, mycket försiktig.
Virtuella enheter CACHE, LOG och SPECIAL kan skapas enligt någon av de ovanstående topologierna — men kom ihåg att förlust av den virtuella enheten SPECIAL innebär förlust av poolen, så det rekommenderas starkt att ha en redundant topologi.
enhet
Detta är troligen den enklaste termen att förstå inom ZFS — det är bokstavligen ett blockenhet av godtycklig åtkomst. Kom ihåg att virtuella enheter består av separata enheter, och en pool är gjord av virtuella enheter.
Diskar — magnetiska eller solid state — är de mest vanligt förekommande blockenheter som används som byggstenar för vdev. Men vilken enhet som helst med en beskrivning i /dev fungerar — så hela hårdvaru-RAID-arrayer kan användas som separata enheter.
En enkel råfil är en av de viktigaste alternativa blockenheterna som kan användas för att bygga en vdev. Testpoolar av är ett mycket bekvämt sätt att kontrollera poolkommandon och se hur mycket utrymme som är tillgängligt i poolen eller det virtuella enheten i den aktuella topologin.
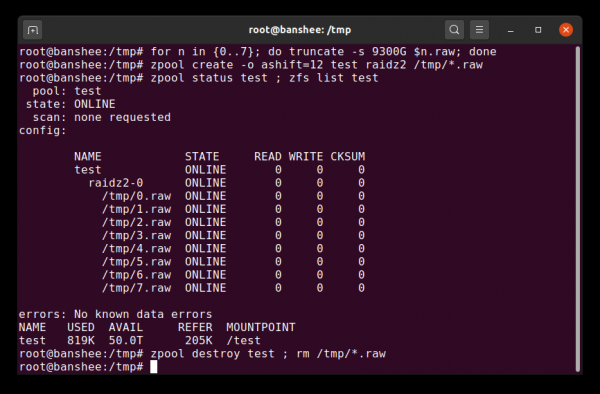
Du kan skapa en testpool av sparade filer på bara några sekunder – men glöm inte att ta bort hela poolen och dess komponenter efteråt.
Anta att du vill sätta upp en server med åtta diskar och planerar att använda diskar på 10 TB (~9300 GiB) – men du är inte säker på vilken topologi som bäst matchar dina behov. I exemplet ovan bygger vi en testpool av sparade filer på bara några sekunder – och nu vet vi att en RAIDz2 vdev av åtta diskar på 10 TB ger 50 TiB användbar kapacitet.
En annan speciell klass av enheter är SPARE (reserv). Hot-swap-enheter, till skillnad från vanliga enheter, tillhör hela poolen och inte en enskild virtuell enhet. Om någon vdev i poolen går sönder och reservutrustningen är ansluten till poolen och tillgänglig, ansluter den automatiskt till den skadade vdev.
När reservutrustningen ansluts till den skadade vdev börjar den ta emot kopior eller rekonstruktioner av de data som borde finnas på den förlorade enheten. I traditionell RAID kallas detta återuppbyggnad (rebuilding), och i ZFS kallas det "återställning av redundans" (resilvering).
Det är viktigt att notera att reservutrustningen inte permanent ersätter de enheter som har slutat fungera. Det är bara en tillfällig ersättning för att minska den tid under vilken vdev är i ett försämrat tillstånd. När administratören har ersatt den trasiga enheten i vdev, sker det en återställning av redundans på den permanenta enheten, och SPARE kopplas från vdev och återgår till att vara en reserv för hela poolen.
Datasatser, block och sektorer
Den nästa uppsättningen byggstenar som vi behöver förstå i vår resa genom ZFS handlar mindre om hårdvaran och mer om hur själva data är organiserade och lagrade. Här hoppar vi över några nivåer – såsom metaslab – för att inte överbelasta detaljerna, och bibehålla förståelsen för den övergripande strukturen.
Datasats (dataset)
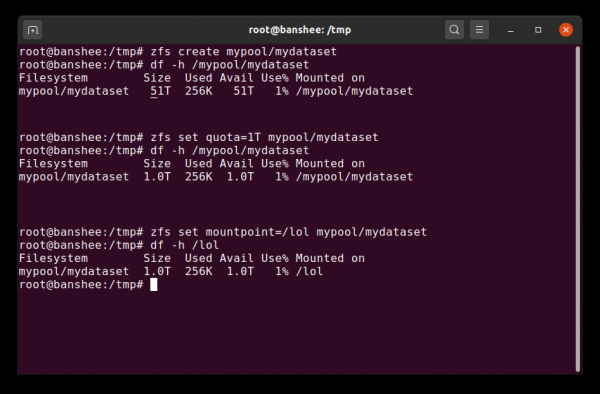
När vi först skapar en datasats visar den hela det tillgängliga utrymmet i poolen. Sedan ställer vi in en kvot – och ändrar monteringspunkten. Magi!
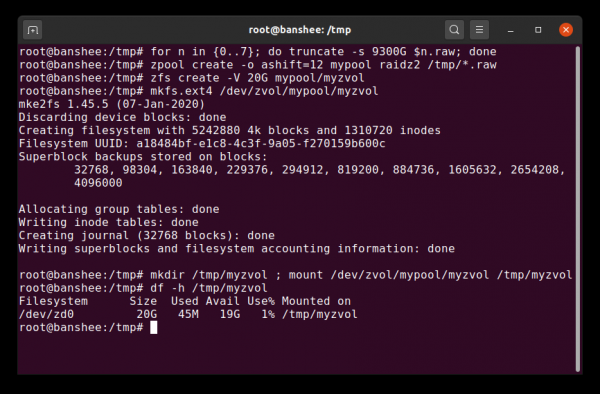
Zvol är mestadels bara en datasats utan sitt filsystemslager, som vi här ersätter med ett helt normalt filsystem som ext4.
ZFS-datasettet är ungefär liknande en standardmonterad filsystem. Precis som ett vanligt filsystem kan det vid första anblick verka som "bara en annan mapp". Men precis som med vanliga monterade filsystem har varje ZFS-dataset sin egen uppsättning grundläggande egenskaper.
För det första kan det finnas en tilldelad kvot för datasetet. Om du ställer in zfs set quota=100G poolname/datasetname, kan du inte skriva till den monterade mappen /poolname/datasetname mer än 100 GiB.
Märkte du närvaron – och frånvaron – av snedstreck i början av varje rad? Varje dataset har sin egen plats både i ZFS-hierarkin och i systemmonteringshierarkin. I ZFS-hierarkin finns det inget ledande snedstreck – du börjar med poolens namn och går sedan vägen från ett dataset till nästa. Till exempel, pool/parent/child för ett dataset med namnet child under den överordnade datasetet parent i en pool med ett kreativt namn. pool.
Som standard är monteringspunkten för datasetet likvärdig med dess namn i ZFS-hierarkin, med ett snedstreck i början – poolen med namnet pool monteras som /pool, datasetet parent monteras i /pool/parent, och det underordnade datasetet child monteras i /pool/parent/child. Men den systemmonterade punkten för datasetet kan ändras.
Om vi anger zfs set mountpoint=/lol pool/parent/child, då kommer datasetet pool/parent/child att monteras i systemet som /lol.
Förutom datasets måste vi nämna volymer (zvols). En volym är ungefär liknande ett dataset, förutom att den faktiskt inte har något filsystem – det är bara en blockenhet. Du kan till exempel skapa zvol med namnet mypool/myzvol, formattera det med ett ext4-filsystem och sedan montera detta filsystem – nu har du ett ext4-filsystem, men med stöd för alla ZFS-säkerhetsfunktioner! Det kan verka dumt på en dator, men ger mycket mer mening som backend när du exporterar en iSCSI-enhet.
Block
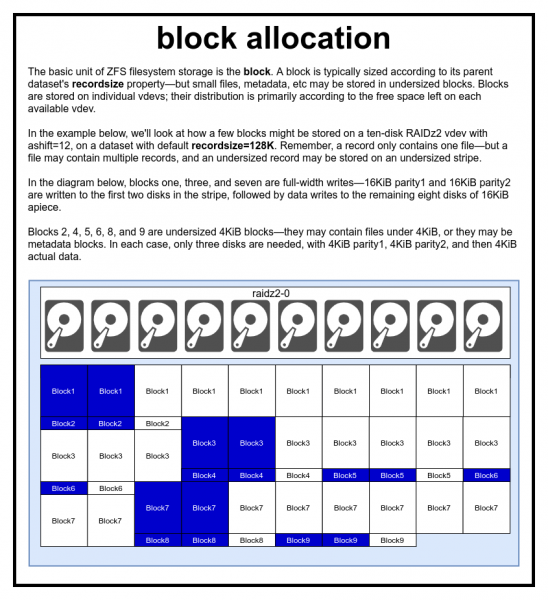
En fil presenteras av en eller flera block. Varje block lagras på en virtuell enhet. Blockstorleken är vanligtvis lika med parametern recordsize, men kan minskas till 2^ashift, om den innehåller metadata eller en liten fil.
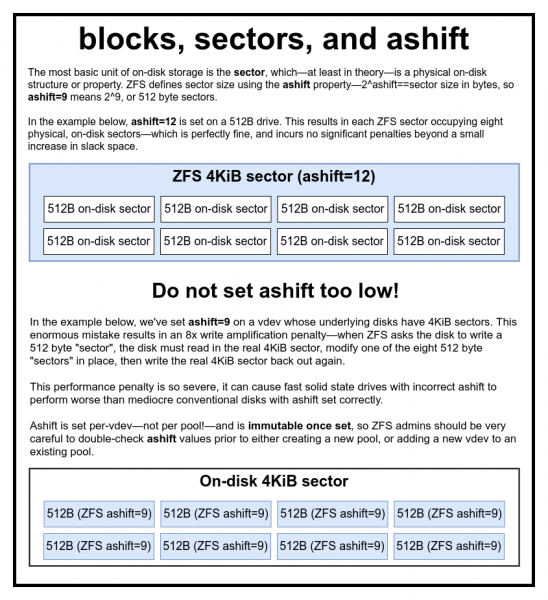
Vi menar verkligen, verkligen att vi inte skämtar om den enorma prestandaförlusten om ashift ställs in på för lågt.
I ZFS-pool lagras all data, inklusive metadata, i block. Den maximala blockstorleken för varje datasets definieras i egenskapen recordsize (inrecordstorlek). Recordstorleken kan ändras, men detta påverkar inte storleken eller placeringen av några block som redan har skrivits till datasetet – det gäller endast för nya block när de skrivs.
Om inget annat anges är den aktuella standardrecordstorleken 128 KiB. Detta är en slags kompromiss där prestandan inte kommer att vara perfekt, men inte heller dålig i de flesta fall. Recordsize kan ställas in på vilket värde som helst från 4K till 1M (med ytterligare inställningar recordsize kan ställas in ännu högre, men det är sällan en bra idé).
Varje block refererar endast till data från en fil – du kan inte trycka in två olika filer i ett block. Varje fil består av ett eller flera block, beroende på storlek. Om filens storlek är mindre än recordstorleken, kommer den att sparas i ett mindre block – till exempel kommer ett block med en 2 KiB fil bara att ta en sektor på 4 KiB på disken.
Om filen är tillräckligt stor och kräver flera block, då kommer alla poster med denna fil att ha storlek recordsize – inklusive den sista posten, vars huvudsakliga del kan visa sig vara .
Zvol-voly har ingen egenskap recordsize – istället har de en motsvarande egenskap volblocksize.
Sektorer
Den sista, mest grundläggande byggstenen är sektorn. Detta är den minsta fysiska enheten som kan skrivas eller läsas från den grundläggande enheten. Under flera decennier har de flesta diskar använt sektorer på 512 byte. På senare tid har de flesta diskar ställts in på sektorer på 4 KiB, och i vissa fall – speciellt SSD – sektorer på 8 KiB eller till och med mer.
I ZFS-systemet finns det en egenskap som tillåter manuell inställning av sektorns storlek. Denna egenskap ashift. Det är ganska förvirrande att ashift är en exponent av två. Till exempel, ashift=9 betyder sektorns storlek 2^9 eller 512 byte.
ZFS begär detaljerad information om varje blockenhet från operativsystemet när den läggs till i en ny vdev och ställer teoretiskt sett in ashift automatiskt baserat på denna information. Tyvärr ljuger många diskar om sin sektorstorlek för att behålla kompatibilitet med Windows XP (som inte kunde förstå diskar med andra sektorstorlekar).
Detta innebär att en ZFS-administratör starkt rekommenderas att känna till den faktiska sektorstorleken på sina enheter och ställa in den manuellt ashift. Om ashift är inställt för lågt ökar antalet läs-/skrivoperationer astronomiskt. Så om man skriver 512-byte «sektorer» till en verklig 4 KiB-sektor måste man först skriva den första «sektorn», sedan läsa 4 KiB-sektorn, ändra den med den andra 512-byte «sektorn», skriva tillbaka den till den nya 4 KiB-sektorn och så vidare för varje skrivning.
I den verkliga världen träffar en sådan straff de fasta lagringsenheterna Samsung EVO, för vilka det måste gälla ashift=13, men dessa SSD:er ljuger om sin sektorstorlek, och därför ställs som standard in ashift=9. Om inte en erfaren systemadministratör ändrar denna parameter kommer denna SSD att fungera långsammare som en vanlig magnetisk HDD.
För jämförelse, det finns praktiskt taget inget straff för att ha en för stor storlek ashift . Det finns ingen verklig prestandaförlust, och ökningen av oanvänt utrymme är oändligt liten (eller noll vid aktiverad komprimering). Därför rekommenderar vi starkt även för de diskar som verkligen använder 512-byte sektorer att ställa in ashift=12 eller till och med ashift=13, för att framgångsrikt se in i framtiden.
Egenskap ashift ställs in för varje virtuellt enhet vdev, och inte för poolen, som många felaktigt tror – och ändras inte efter att den har ställts in. Om du av misstag rubbar ashift när du lägger till ett nytt vdev i poolen, har du permanent förorenat denna pool med en enhet med låg prestanda, och det finns vanligtvis inget annat sätt än att förstöra poolen och börja om från början. Även borttagning av vdev räddar inte från en felaktig inställning. ashift!
Skrivningskopieringsmekanism
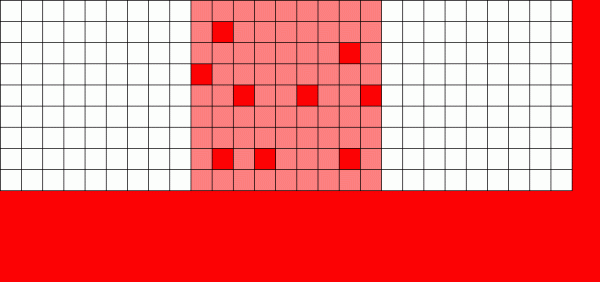
Om ett vanligt filsystem behöver skriva om data – ändrar den varje block där det står.
Filssystemet med skrivkopiering skriver en ny version av blocket och låser sedan upp den gamla versionen.
I abstrakt bemärkelse, om vi ignorerar den faktiska fysiska placeringen av blocken, förenklas vår "datakomets" till ett "datmask", som rör sig från vänster till höger över kartan av tillgängligt utrymme.
Nu kan vi få en bra uppfattning om hur skrivkopieringssnapshot fungerar – varje block kan tillhöra flera snapshots och kommer att sparas så länge alla relaterade snapshots inte har raderats.
Skrivkopieringsmekanismen (Copy on Write, CoW) är den grundläggande basen för vad som gör ZFS till ett så fantastiskt system. Huvudkonceptet är enkelt – om du ber ett traditionellt filsystem att ändra en fil, gör den precis vad du begärde. Om du ber ett skrivkopierande filsystem att göra samma sak, säger det "okej" – men ljuger för dig.
Istället skriver det skrivkopierande filsystemet en ny version av det förändrade blocket och uppdaterar sedan filens metadata för att bryta kopplingen med det gamla blocket och koppla det till det nya block som just har skrivits.
Kopplingen av det gamla blocket och bindningen av det nya sker i en operation, så denna kan inte avbrytas – om du stänger av strömmen efter att det har skett, har du en ny version av filen, och om du stänger av strömmen tidigare, har du den gamla versionen. I vilket fall som helst kommer det inte att uppstå några konflikter i filsystemet.
Skrivkopiering i ZFS sker inte bara på filsystemnivå utan också på diskhanteringsnivå. Detta innebär att ZFS inte påverkas av skrivluckor () – ett fenomen där bandet bara har skrivits delvis innan systemet kraschar, med skador på arrayen efter omstart. Här skrivs bandet atomärt, vdev är alltid konsekvent, och .
ZIL: ZFS avsiktslogg.
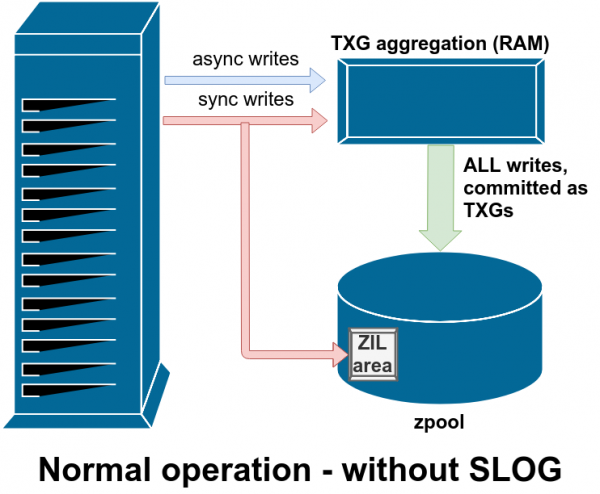
ZFS-systemet hanterar synkrona skrivningar på ett speciellt sätt – det sparar dem temporärt men omedelbart i ZIL, innan de senare skrivs permanent tillsammans med asynkrona skrivningar.
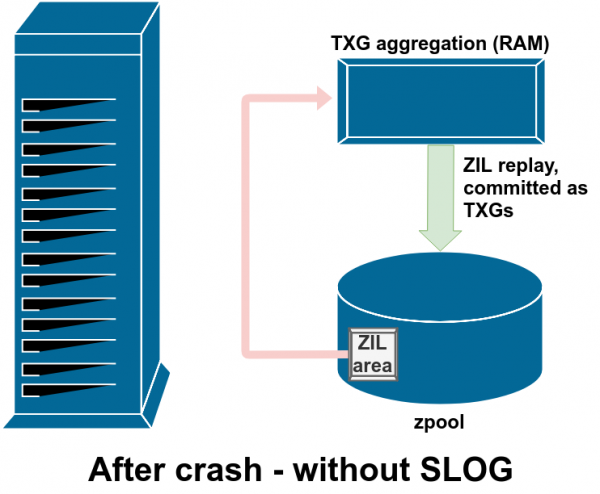
Vanligtvis läses inte data som skrivs till ZIL någonsin igen. Men det är möjligt efter ett systemfel.
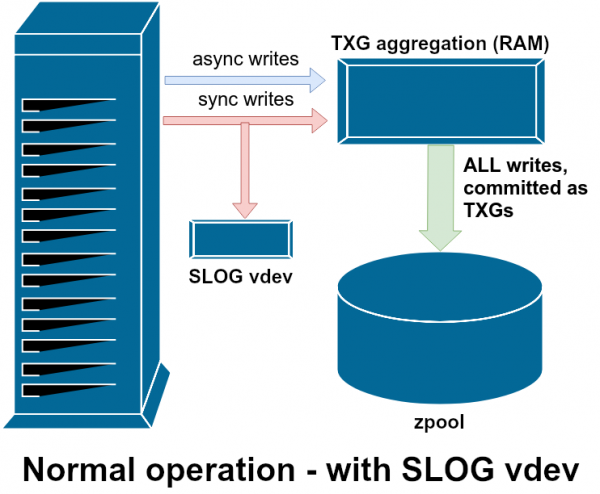
SLOG, eller sekundär LOG-enhet, är helt enkelt en speciell - och helst väldigt snabb - vdev där ZIL kan lagras separat från det primära lagringsutrymmet.
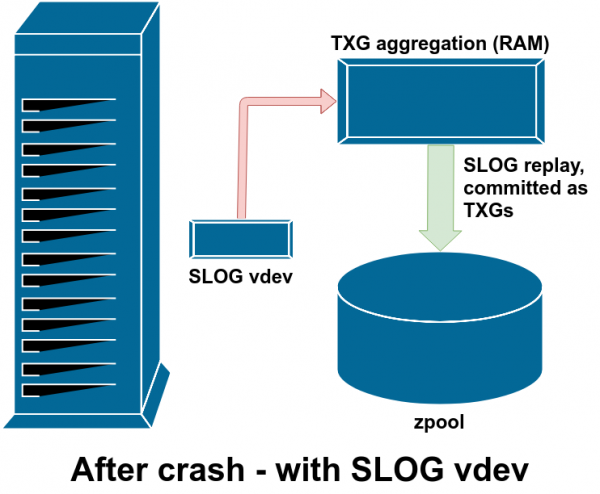
Efter ett fel återställs alla smutsiga data i ZIL - i det här fallet ligger ZIL på SLOG, så de återställs därifrån.
Det finns två huvudkategorier av skrivoperationer - synkrona (sync) och asynkrona (async). För de flesta arbetsbelastningar är den överväldigande majoriteten av skrivoperationer asynkrona - filsystemet tillåter att de aggregeras och skickas i paket, vilket minskar fragmenteringen och avsevärt ökar bandbredden.
Synkrona skrivningar är en helt annan sak. När en applikation begär en synkron skrivning, säger den till filsystemet: "Du behöver spara det här i icke-flyktigt minne, just nu.och under tiden kan jag inte göra något mer." Därför måste synkrona skrivningar omedelbart sparas på disken - och om det ökar fragmenteringen eller minskar bandbredden, då får det vara så.
ZFS hanterar synkrona skrivningar annorlunda än vanliga filsystem - istället för att omedelbart skriva dem till det vanliga lagringsutrymmet, sparar ZFS dem i ett speciellt lagringsområde som kallas ZFS Intent Log, eller ZIL. Kniffen är att dessa skrivningar även förblir i minnet, samtidigt som de aggregeras med vanliga asynkrona skrivförfrågningar, för att senare skrivas till lagringsutrymmet som helt normala TXG (transaktionsgrupper, Transaction Groups).
Under normal drift skrivs ZIL till och läses aldrig mer. När skrivningarna från ZIL efter några ögonblick sparas i det primära lagringsutrymmet i vanliga TXG från RAM, kopplas de bort från ZIL. Det är endast då något läses från ZIL - vid import av poolen.
Om det inträffar ett ZFS-fel - en krasch av operativsystemet eller strömavbrott - när det finns data i ZIL, kommer dessa data att läsas under nästa import av poolen (t.ex. vid omstart av den avbrutna systemet). Allt som finns i ZIL kommer att läsas, aggregeras i TXG-grupper, sparas i det primära lagringsutrymmet och därefter kopplas loss från ZIL under importprocessen.
En av hjälpklasserna i vdev kallas LOG eller SLOG, en sekundär enhet LOG. Dess enda uppgift är att tillhandahålla poolen med en separat och, helst, mycket snabbare enhet med hög skrivbeständighet för lagring av ZIL, istället för att lagra ZIL på huvudlagringsvdev. ZIL beter sig likadant oavsett lagringsplats, men om vdev med LOG har mycket hög skrivprestanda kommer synkrona skrivningar att ske snabbare.
Att lägga till vdev med LOG i poolen påverkar inte kan inte prestationsförbättringen av asynkrona skrivningar – även om du tvingar fram alla skrivningar till ZIL med zfs set sync=always, kommer de fortfarande att vara bundna till huvudlagringen i TXG på samma sätt och i samma takt som utan logg. Den enda direkta prestandaförbättringen är latensen av synkrona skrivningar (eftersom en högre hastighet för loggen påskyndar utförandet av operationer. sync).
Men i en miljö som redan kräver många synkrona skrivningar kan vdev LOG indirekt påskynda asynkrona skrivningar och okashad läsning. Att avlastar ZIL-skrivningar till en separat vdev LOG innebär mindre konkurrens om IOPS i den primära lagringen, vilket på vissa sätt ökar prestandan för alla läs- och skrivoperationer.
Snapshots
Skriv-kopieringsmekanismen är även en nödvändig grund för atomära momentana bilder i ZFS och inkrementell asynkron replikering. I ett aktivt filsystem finns det ett träd av pekare som markerar alla skrivningar med aktuella data – när du gör en snapshot skapar du helt enkelt en kopia av detta pekarträd.
När en skrivning överskrivs i det aktiva filsystemet, skriver ZFS först den nya versionen av blocket till oanvändbart utrymme. Därefter kopplar den bort den gamla versionen av blocket från det aktuella filsystemet. Men om en snapshot hänvisar till det gamla blocket förblir det oförändrat. Det gamla blocket kommer faktiskt inte att återställas som ledigt utrymme förrän alla snapshots som hänvisar till det blocket har raderats!
Replikation
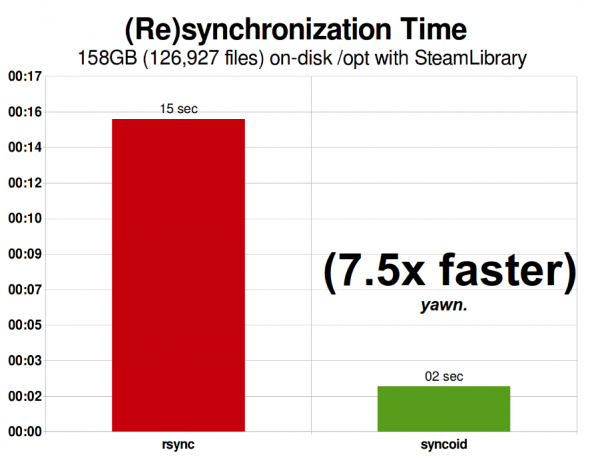
Mitt Steam-bibliotek år 2015 tog 158 GiB och inkluderade 126 927 filer. Detta är ganska nära den optimala situationen för rsync – ZFS-replikering över nätverket var "bara" 750% snabbare.
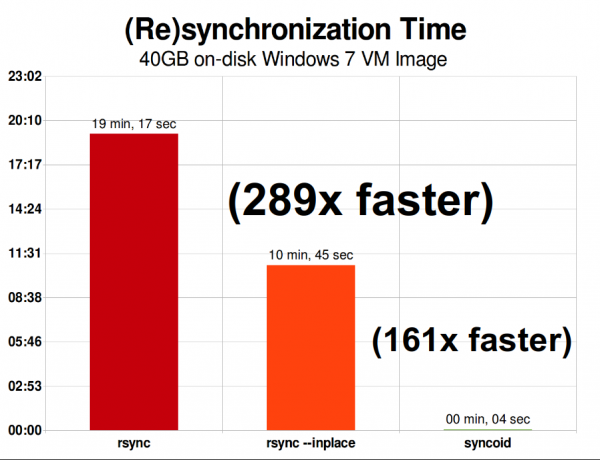
I samma nätverk är replikeringen av en 40-gigabyters Windows 7 virtuell maskinavbildning en helt annan historia. ZFS-replikering sker 289 gånger snabbare än rsync – eller "bara" 161 gånger snabbare, om du är tillräckligt kunnig för att kalla rsync med nyckeln –inplace.
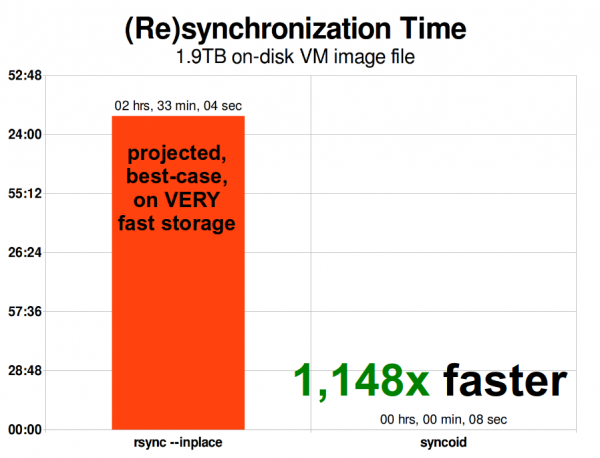
När bilden av den virtuella maskinen skalas, skalas rsync-problemen med den. Storleken 1,9 TiB är inte så stor för en modern virtuell maskinbild – men den är tillräckligt stor för att ZFS-replikering skulle vara 1148 gånger snabbare än rsync, även med rsync-argumentet –inplace.
Så snart du förstår hur snapshots fungerar, blir det inte svårt att fånga essensen av replikering. Eftersom en snapshot helt enkelt är ett träd av pekare till poster, innebär det att om vi gör zfs send en snapshot, så skickar vi både detta träd och alla relaterade poster. När vi överför detta zfs send på zfs receive till det destinationselement, skriver det både det faktiska blockinnehållet och trädet av pekare som hänvisar till blocken, i mål datasets.
Det blir ännu mer intressant på den andra zfs send. Nu har vi två system där var och en innehåller poolname/datasetname@1, och du tar en ny snapshot poolname/datasetname@2.Därför har du i källpoolen datasetname@1 och datasetname@2, men i målpoolen har vi tills vidare bara den första snapshoten. datasetname@1.
Eftersom vi har en gemensam snapshot mellan källan och målet, kan vi göra datasetname@1en inkrementell övan dem. När vi säger till systemet zfs send zfs send -i poolname/datasetname@1 poolname/datasetname@2 , jämför det de två pekarträden. Alla pekare som endast existerar i, pekar uppenbarligen på nya block – därför behöver vi innehållet i dessa block. @2I det fjärrsystemet är hanteringen av den inkrementella
lika enkel. Först skriver vi alla nya poster som ingår i strömmen send , och sedan lägger vi till pekarna till dessa block. Voilà, vi har sendi det nya systemet! @2 Asynkron inkrementell replikation av ZFS är en enorm förbättring jämfört med tidigare metoder som inte bygger på snapshots, som rsync. I båda fallen överförs endast ändrade data – men rsync måste först
från disken alla data på båda sidor för att kontrollera summan och jämföra den. Till skillnad från detta läser ZFS-replikering ingenting utom pekartavlor – och alla block som inte finns representerade i den gemensamma snapshoten. läsa с диска все данные с обеих сторон, чтобы проверить сумму и сравнить её. В отличие от этого, репликация ZFS не считывает ничего, кроме деревьев указателей — и любых блоков, которые не представлены в общем снапшоте.
Inbyggd komprimering
Skrivprocessens kopieringsmekanism förenklar också systemet med inbyggd komprimering. I ett traditionellt filsystem är komprimering problematiskt – både den gamla versionen och den nya versionen av ändrade data finns i samma utrymme.
Om vi ser på ett datastycke i mitten av en fil som börjar sitt liv som en megabyte av nollor från 0x00000000 och så vidare – kan det enkelt komprimeras till en sektor på disken. Men vad händer om vi ersätter denna megabyte av nollor med en megabyte av ocompressibla data, som JPEG eller pseudorandom brus? Plötsligt kommer denna megabyte av data att behöva inte en, utan 256 sektorer på 4 KiB, medan bara en sektor är reserverad på disken.
ZFS har inget sådant problem, eftersom de ändrade posterna alltid skrivs till oanvänt utrymme – den ursprungliga blocket tar bara en sektor på 4 KiB, medan den nya posten kommer att ta 256, men det är inget problem – det nyligen ändrade stycket från "mitten" av filen skulle skrivas till oanvänt utrymme oavsett om dess storlek förändrades eller inte, så det är en helt normal situation för ZFS.
Inbyggd komprimering i ZFS är avstängd som standard, och systemet erbjuder anslutbara algoritmer – för närvarande LZ4, gzip (1-9), LZJB och ZLE.
- LZ4 – är en strömmande algoritm som erbjuder extremt snabb komprimering och dekomprimering och prestandaförbättring för de flesta användningsfall – även på ganska långsamma CPU:er.
- GZIP – en respekterad algoritm som alla användare av Unix-system känner till och älskar. Den kan implementeras med komprimeringsnivåer 1-9, där komprimeringsgraden och CPU-användningen ökar ju närmare nivå 9 man kommer. Algoritmen är bra för alla textbaserade (eller andra extremt komprimerbara) användningsfall, men annars orsakar den ofta problem med CPU:en – använd den med försiktighet, särskilt på högre nivåer.
- LZJB – den ursprungliga algoritmen i ZFS. Den är föråldrad och bör inte längre användas, LZ4 överträffar den på alla punkter.
- ZLE — nollnivåkodning, Zero Level Encoding. Den påverkar överhuvudtaget inte normala data, men komprimerar stora sekvenser av nollor. Användbar för helt okomprimerade dataset (som JPEG, MP4 eller andra redan komprimerade format), eftersom den ignorerar okomprimerade data men komprimerar oanvänt utrymme i de slutliga posterna.
Vi rekommenderar komprimering med LZ4 för nästan alla användningsområden; prestandastraffet när man stöter på okomprimerade data är mycket litet, och ökning prestandan för typiska data är betydande. Kopieringen av en virtuell maskin för en ny installation av Windows-operativsystemet (nyinstallerat OS, inga data inuti ännu) med compression=lz4 gick 27% snabbare än med compression=none, i .
ARC – adaptiv ersättningscache
ZFS är det enda moderna filsystem som vi känner till som använder sin egen läsning-cachemekanism och inte förlitar sig på operativsystemets sidcache för att lagra kopior av nyligen lästa block i RAM.
Även om den egna cachen har sina problem – ZFS kan inte reagera på nya begärningar om minnesallokering lika snabbt som kärnan, så en ny begäran malloc() om minnesfördelning kan misslyckas om den behöver RAM som för närvarande upptas av ARC. Men det finns starka skäl att använda den egna cachen, åtminstone just nu.
Alla kända moderna operativsystem, inklusive MacOS, Windows, Linux och BSD, tillämpar LRU (Least Recently Used) algoritm för att implementera sidcachen. Detta är en primitiv algoritm som flyttar det cachade blocket "upp i kön" efter varje läsning och fördriver block "ner i kön" vid behov för att få plats för nya cachemissar (block som skulle ha lästs från disken istället för från cachen).
I allmänhet fungerar algoritmen bra, men i system med stora arbetsuppsättningar leder LRU lätt till thrashing – utdrivning av ofta behövda block för att frigöra utrymme för block som aldrig kommer att läsas igen från cachen.
— en betydligt mindre naiv algoritm som kan ses som en "viktad" cache. Efter varje läsning av en cachelagrad block blir den lite "tyngre" och svårare att avlägsna – och även efter att den har avlägsnats kan blocket spåras under en viss tidsperiod. Ett block som har avlägsnats men sedan behöver läsas tillbaka till cachen kommer också att bli "tyngre".
Det slutliga resultatet av allt detta är en cache med en mycket högre träffprocent (hit ratio) – förhållandet mellan träffar i cachen (läsningar som görs från cachen) och missar (läsningar från disken). Detta är en extremt viktig statistik – inte bara att själva träffarna i cachen hanteras ordentligt snabbare, utan även missarna kan hanteras snabbare, eftersom ju fler träffar i cachen – desto färre parallella förfrågningar till disken och mindre fördröjning för de kvarvarande missarna som måste hanteras från disken.
Slutsats
Efter att ha studerat den grundläggande semantiken av ZFS – hur skrivningskopiering fungerar, samt relationerna mellan lagringspooler, virtuella enheter, block, sektorer och filer – är vi redo att diskutera den verkliga prestandan med verkliga siffror.
I nästa del kommer vi att titta på den faktiska prestandan hos pooler med speglade vdev och RAIDz, i jämförelse med varandra, samt i jämförelse med traditionella RAID-topologier i Linux-kärnan som vi har utforskat. .
Först ville vi bara titta på grunderna – ZFS-topologierna själva – men efter så mycket är vi redo att diskutera mer avancerad konfigurering och justering av ZFS, inklusive användningen av hjälptyper av vdev, såsom L2ARC, SLOG och Special Allocation.
Källa: habr.com
