

Introduktion
 «Man måste springa för allt man är värd för att bara stanna kvar,
och för att komma någonstans måste man springa minst dubbelt så snabbt!»
(c) Alice i Underlandet
För ett tag sedan blev jag ombedd att hålla en föreläsning till analytikerna i vårt företag om datamodellering, eftersom vi, efter att ha suttit länge på projekt (ibland i flera år), missar vad som händer runt omkring i världen av IT-teknologier. I vårt företag (så har det blivit) används inte NoSQL-databaser på många projekt (åtminstone inte än), så i min föreläsning ägnade jag särskild uppmärksamhet åt dem med HBase som exempel och försökte rikta presentationen till dem som aldrig har arbetat med dem. Jag illustrerade särskilt några egenskaper av datamodellering med ett exempel som jag läste för flera år sedan . Genom att analysera exemplen jämförde jag flera lösningar på samma problem för att bättre förmedla de grundläggande idéerna till åhörarna.
Nyligen, «för att ha något att göra», ställde jag mig frågan (de långa majhelgerna i karantänläge gör detta särskilt aktuellt) hur teoretiska slutsatser skulle stämma överens med praktiken? Så föddes idén till den här artikeln. En utvecklare som har jobbat med NoSQL ett tag kanske inte kommer att få ut något nytt av den (och kan därför direkt scrolla igenom halva artikeln). Men för analytikerna, som ännu inte har arbetat nära med NoSQL, tror jag att den kommer att vara användbar för att få grundläggande insikter om datamodellering för HBase.
Analys av exemplet
Enligt min åsikt bör man tänka noga på för- och nackdelar innan man börjar använda NoSQL-databaser. Ofta kan uppgiften sannolikt lösas även med traditionella relationsdatabaser. Därför är det bättre att inte använda NoSQL utan betydande skäl. Om man ändå har beslutat att använda en NoSQL-databas, bör man beakta att designmetoderna här skiljer sig något. Särskilt vissa av dem kan vara ovanliga för dem som tidigare endast har arbetat med relationsdatabaser (enligt mina observationer). Så i den "relationsbaserade" världen går vi vanligtvis från modellering av ämnesområdet och sedan, vid behov, utför vi denormalisering av modellen. I NoSQL måste vi omedelbart ta hänsyn till de förväntade användningsscenarierna för data och initialt denormalisera data. Dessutom finns det en rad andra skillnader, som kommer att beskrivas nedan.
Låt oss betrakta följande "syntetiska" uppgift, som vi kommer att arbeta med framöver:
Det är nödvändigt att designa en lagringsstruktur för en lista över användares vänner i ett visst abstrakt socialt nätverk. För att förenkla antar vi att alla relationer är riktade (som på Instagram, inte på LinkedIn). Strukturen bör möjliggöra effektivt:
- Att besvara frågan om användare A läser användare B (läsningsmönster)
- Möjliggöra att lägga till/ta bort relationer vid abonnemang/avprenumeration av användare A från användare B (datamönster för förändring)
Självklart finns det många sätt att lösa uppgiften. I en vanlig relationsdatabas skulle vi förmodligen bara gjort en relations-tabell (möjligen typad, om vi till exempel behöver lagra en användargrupp: familj, arbete etc., som denna "vän" tillhör), och för att optimera åtkomsthastigheten skulle vi ha lagt till index/partitionering. Troligtvis skulle den slutliga tabellen se ungefär ut så här:
user_id
friend_id
Vasya
Petya
Vasya
Olya
Här och framöver kommer jag för tydlighetens skull att ange namn istället för ID
I fallet med HBase vet vi att:
- effektiv sökning som inte leder till fullständig tabellskanning är möjligt exklusivt med nyckel
- Just därför är det en dålig idé att skriva de vanliga SQL-frågorna till sådana databaser; tekniskt sett kan du självklart skicka en SQL-fråga med joins och annan logik från samma Impala till HBase, men hur effektivt kommer det att vara…
Därför måste vi använda användarens ID som nyckel. En första tanke kring "var och hur lagra vänners ID?" kan vara att lagra dem i kolumner. Det mest uppenbara och "naiva" alternativet kan se ut ungefär så här (låt oss kalla det Alternativ 1 (standard), för att referera till det senare):
RowKey
Kolumner
Vasya
1: Petya
2: Olya
3: Dasha
Petya
1: Masha
2: Vasya
Här motsvarar varje rad en användare av nätverket. Kolumnerna har namn: 1, 2, … — motsvarande antalet vänner, och i kolumnerna lagras vänners ID. Det är viktigt att notera att varje rad kan ha ett olika antal kolumner. I exemplet ovan har en rad tre kolumner (1, 2 och 3), medan den andra har endast två (1 och 2) – här använde vi två egenskaper hos HBase som inte finns i relationsdatabaser:
- möjligheten att dynamiskt ändra sammansättningen av kolumner (lägger till en vän -> lägger till en kolumn, tar bort en vän -> tar bort en kolumn)
- olika rader kan ha olika sammansättningar av kolumner
Låt oss nu kontrollera vår struktur mot kraven i uppgiften:
- Läsa data: för att förstå om Vasya följer Olya måste vi läsa hela raden med nyckeln RowKey = "Vasya" och gå igenom kolumnvärdena tills vi "träffar" Olya. Eller gå igenom värdena för alla kolumner, "inte träffa" Olya och returnera False;
- Ändra data: lägga till en vän: för en sådan uppgift behöver vi också läsa hela raden med nyckeln RowKey = "Vasya", för att räkna det totala antalet av hans vänner. Detta totala antal vänner behöver vi för att bestämma kolumnnumret där vi ska skriva ID för den nya vännen.
- Ändra data: ta bort en vän:
- Det behövs en läsning hela raden med nyckeln RowKey = "Vasya" och gå igenom kolumnerna för att hitta den som innehåller den borttagna vännen;
- Sedan måste vi efter att ha tagit bort vännen "flytta" alla data en kolumn över, så att vi inte får några "hål" i deras numrering.
Låt oss nu bedöma hur effektiva de algoritmer som vi måste implementera på sidan av "det hypotetiska programmet" blir, genom att använda Låt oss definiera storleken på vårt hypotetiska sociala nätverk som n. Den maximala antalet vänner en användare kan ha är (n-1). Denna (-1) kan vi bortse ifrån för våra syften, eftersom den är obetydlig inom ramen för användning av O-symbolik.
- Läsa data: det är nödvändigt att läsa hela raden och gå igenom alla dess kolumner. Således blir den övre gränsen för kostnaden cirka O(n)
- Ändra data: lägga till en vän: för att fastställa antalet vänner måste vi gå igenom alla kolumner i raden, varefter vi lägger till en ny kolumn => O(n)
- Ändra data: ta bort en vän:
- På liknande sätt som vid tillägg – det krävs att gå igenom alla kolumner => O(n)
- Efter att ha tagit bort kolumnerna måste vi ”flytta” dem. Om vi genomför detta ”direkt”, krävs det ytterligare upp till (n-1) operationer. Men här och framåt kommer vi att tillämpa en annan metod i den praktiska delen, som kommer att genomföra en ”pseudo-flytt” på ett fast antal operationer – det vill säga, det kommer att ta konstant tid oavsett n. Denna konstanta tiden (om vi ska vara exakta, O(2)) kan bortses ifrån jämfört med O(n). Metoden illustreras i bilden nedan: vi kopierar helt enkelt data från den ”sista” kolumnen till den där vi måste ta bort data, varefter vi tar bort den sista kolumnen:

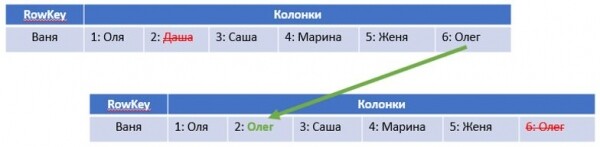
Sammanfattningsvis har vi i alla scenarier fått en asymptotisk beräkningskomplexitet O(n).
Du har kanske redan lagt märke till att vi nästan alltid måste läsa hela raden från databasen, och i två av tre fall bara för att gå igenom alla kolumner och räkna det totala antalet vänner. Därför, som ett försök till optimering, kan vi lägga till en kolumn ”count” där det totala antalet vänner för varje användare i nätverket lagras. På det här sättet behöver vi inte läsa hela raden för att räkna det totala antalet vänner, utan kan läsa endast en kolumn ”count”. Det viktigaste är att inte glömma att uppdatera ”count” när vi manipulerar med data. Således får vi en förbättrad Alternativ 2 (count):
RowKey
Kolumner
Vasya
1: Petya
2: Olya
3: Dasha
count: 3
Petya
1: Masha
2: Vasya
count: 2
Jämfört med det första alternativet:
- Läsa data: för att få svaret på frågan ”Läser Vasja Olya?” har inget förändrats => O(n)
- Ändra data: lägga till en vän: Vi har förenklat införandet av en ny vän, eftersom vi nu inte behöver gå igenom hela raden och iterera över dess kolumner, utan kan få värdet från kolumnen "count" och därmed direkt bestämma vilken kolumn som ska användas för att införa en ny vän. Detta minskar den beräkningsmässiga komplexiteten till O(1)
- Ändra data: ta bort en vän: När vi tar bort en vän kan vi också använda denna kolumn för att minska antalet in- och utdataoperationer vid "skiftningen" av data en cell åt vänster. Men behovet av att iterera genom kolumnerna för att hitta den som ska tas bort kvarstår, så => O(n)
- Å andra sidan måste vi nu vid uppdatering av data varje gång också uppdatera kolumnen "count", men detta tar konstant tid, vilket i O-notering kan försummas
Överlag framstår alternativ 2 som något mer optimalt, men det är snarare en "evolution än en revolution". För att genomföra en "revolution" behöver vi Alternativ 3 (col).
Låt oss vända allt "upp och ner": vi namnger kolumnen med användarens identifierare! Vad som kommer att skrivas i själva kolumnen spelar ingen roll för oss, låt det vara siffran 1 (allmänt kan vi lagra exempelvis gruppen "familj/vänner/osv."). Denna metod kan överraska den ovana "medborgaren", som inte haft erfarenhet av NoSQL-databaser, men just den gör det möjligt att utnyttja potentialen hos HBase i detta uppdrag mycket mer effektivt:
RowKey
Kolumner
Vasya
Petya: 1
Olya: 1
Dasha: 1
Petya
Masha: 1
Vasya: 1
Här får vi omedelbart flera fördelar. För att förstå dem, låt oss analysera den nya strukturen och bedöma den beräkningsmässiga komplexiteten:
- Läsa data: för att svara på frågan om Vasya har prenumererat på Olya, räcker det att läsa en kolumn "Olya": om den finns, är svaret True, om inte – False => O(1)
- Ändra data: lägga till en vän: Tillsättning av en vän: det räcker med att bara lägga till en ny kolumn "väns ID" => O(1)
- Ändra data: ta bort en vän: det räcker med att bara ta bort kolumnen "väns ID" => O(1)
Som vi ser är en betydande fördel med denna lagringsmodell att vi i alla våra nödvändiga scenarier endast arbetar med en kolumn, vilket undviker att läsa hela raden från databasen och förstås att iterera genom alla kolumner i denna rad. Det skulle kunna vara slutet på detta, men…
Man kan fundera på att gå längre i att optimera prestanda och minska in- och utdataoperationer när det gäller databasen. Vad sägs om att lagra fullständig informationskoppling direkt i nyckeln för raden? Det vill säga göra nyckeln sammansatt i formen userID.friendID? I så fall kan vi inte ens behöva läsa kolumnerna i raden.Alternativ 4(row)):
RowKey
Kolumner
Vasya.Petya
Petya: 1
Vasya.Olya
Olya: 1
Vasya.Dasha
Dasha: 1
Petya.Masha
Masha: 1
Petya.Vasya
Vasya: 1
Det är uppenbart att bedömningen av alla scenarier för datamanipulation i en sådan struktur, precis som i den tidigare varianten, också kommer att vara O(1). Skillnaden med alternativ 3 kommer att ligga uteslutande i effektiviteten för in- och utdataoperationer i databasen.
Och den sista "slipsen". Det är enkelt att se att i alternativ 4 kommer nyckeln för raden att ha en variabel längd, vilket eventuellt kan påverka prestandan (här påminner vi oss om att HBase lagrar data som en uppsättning byte och rader i tabeller sorteras efter nyckel). Dessutom har vi en avskiljare som i vissa scenarier kan behöva bearbetas. För att utesluta denna påverkan kan vi använda hashvärden från userID och friendID, och eftersom båda hashvärdena kommer att ha konstant längd kan vi helt enkelt konkatenera dem utan avskiljare. Då kommer datan i tabellen att se ut så här:Alternativ 5(hash)):
RowKey
Kolumner
dc084ef00e94aef49be885f9b01f51c01918fa783851db0dc1f72f83d33a5994
Petya: 1
dc084ef00e94aef49be885f9b01f51c0f06b7714b5ba522c3cf51328b66fe28a
Olya: 1
dc084ef00e94aef49be885f9b01f51c00d2c2e5d69df6b238754f650d56c896a
Dasha: 1
1918fa783851db0dc1f72f83d33a59949ee3309645bd2c0775899fca14f311e1
Masha: 1
1918fa783851db0dc1f72f83d33a5994dc084ef00e94aef49be885f9b01f51c0
Vasya: 1
Det är uppenbart att den algoritmiska komplexiteten för att arbeta med en sådan struktur i de scenarier vi överväger kommer att vara densamma som för alternativ 4 – det vill säga O(1).
Sammanfattningsvis, låt oss sammanfatta alla våra bedömningar av den beräkningsmässiga komplexiteten i en tabell:
Lägga till vän
Kontrollera vän
Ta bort vän
Alternativ 1 (standard)
O(n)
O(n)
O(n)
Alternativ 2 (count)
O(1)
O(n)
O(n)
Alternativ 3 (column)
O(1)
O(1)
O(1)
Alternativ 4 (row)
O(1)
O(1)
O(1)
Alternativ 5 (hash)
O(1)
O(1)
O(1)
Som det framgår verkar alternativ 3-5 vara de mest föredragna och teoretiskt sett säkerställer de att alla nödvändiga datamanipulationsscenarier kan utföras på konstant tid. I vår uppgift finns det inget explicit krav på att få en lista över alla användarens vänner, men i verkliga projekt skulle det vara bra för oss som analytiker att "förespegla" att en sådan uppgift kan uppstå och "steka halm", så att säga. Därför lutar jag åt alternativ 3. Men det är fullt möjligt att detta krav i ett verkligt projekt redan har lösts med andra medel, så utan en övergripande förståelse av hela uppgiften bör man inte dra några definitiva slutsatser.
Förberedelse av experimentet
De ovanstående teoretiska resonemangen skulle vi vilja pröva i praktiken – och det var målet med den idé som uppstod under de långa helgerna. För detta behöver vi bedöma hastigheten på vårt "hypotetiska program" i alla de beskrivna användarscenarierna samt hur denna tid ökar med storleken på det sociala nätverket (n). Den målparameter vi är intresserade av och som vi kommer att mäta under experimentet är den tid som det "hypotetiska programmet" lägger på att utföra en "affärsoperation". Med "affärsoperation" menar vi en av följande:
- Lägga till en ny vän
- Kontrollera om användare A är vän med användare B
- Ta bort en vän
Således, med hänsyn till de krav som angivits i den ursprungliga uppgiften, framträder följande scenario för kontroll:
- Skriva data. Generera slumpmässigt ett ursprungligt nätverk av storlek n. För att närma oss "verkliga världen" är antalet vänner per användare också en slumpmässig variabel. Mät tiden som vårt "hypotetiska program" tar för att skriva alla genererade data i HBase. Dela sedan den uppmätta tiden med det totala antalet tillagda vänner – så får vi den genomsnittliga tiden för en "affärsoperation".
- Läsa data. För varje användare skapa en lista över
- Borttagning av data. Ta bort alla vänskapsförbindelser för användaren. Borttagningsordningen ska vara slumpmässig (det vill säga
Scenarierna måste köras för varje av de fem modellerna för data och för olika storlekar av sociala nätverk, för att se hur tiden förändras med dess tillväxt. Inom varje n-länk i nätverket och listan över användare för kontroll måste, naturligtvis, vara desamma för alla fem varianter.
För bättre förståelse, nedan ger jag ett exempel på genererade data för n= 5. Den skrivna "generatorn" ger ut tre ordböcker med ID:n:
- den första - för insättning
- den andra - för kontroll
- den tredje - för borttagning
{0: [1], 1: [4, 5, 3, 2, 1], 2: [1, 2], 3: [2, 4, 1, 5, 3], 4: [2, 1]} # totalt 15 vänner

{0: [1, 10800], 1: [5, 10800, 2, 10801, 4, 10802], 2: [1, 10800], 3: [3, 10800, 1, 10801, 5, 10802], 4: [2, 10800]} # totalt 18 kontrollerade subjekt

{0: [1], 1: [1, 3, 2, 5, 4], 2: [1, 2], 3: [4, 1, 2, 3, 5], 4: [1, 2]} # totalt 15 vänner
Som man kan se, alla ID:n större än 10 000 i ordboken för kontroll är just de som med säkerhet kommer att ge svaret False. Insättning, kontroll och borttagning av "vänner" genomförs precis i den ordning som anges i ordboken.
Experimentet genomfördes på en bärbar dator som kör Windows 10, där en Docker-container körde en HBase-databas, medan en annan körde Python med Jupyter Notebook. Docker tilldelades 2 CPU-kärnor och 2 GB RAM. All logik, både emuleringen av "det hypotetiska programmet" och "infrastrukturen" för att generera testdata och mäta tid skrevs i Python. För att arbeta med HBase användes biblioteket , för att beräkna hashvärden (MD5) för alternativ 5 – hashlib
Med hänsyn till den specifika bärbar datorns beräkningskraft valdes experimentellt starten för n = 10, 30, …. 170 – när den totala tiden för hela testcykeln (alla scenarier för alla alternativ för alla n) fortfarande var mer eller mindre rimlig och fick plats under en kopp te (i genomsnitt 15 minuter).
Här måste jag påpeka att vi i detta experiment främst bedömer inte absoluta prestationstal. Även en relativ jämförelse mellan de två olika alternativen kan vara något otillförlitlig. Just nu är vi intresserade av hur tiden förändras beroende på n, eftersom det med hänsyn till den ovan nämnda konfigurationen av "testbänken" är mycket svårt att få tidsuppskattningar som är "rensade" från påverkan av slumpmässiga och andra faktorer (och ett sådant mål har inte ställts).
Experimentresultatet
Det första testet – hur tiden som används för att fylla i vänlistan förändras. Resultatet – i diagrammet nedan.
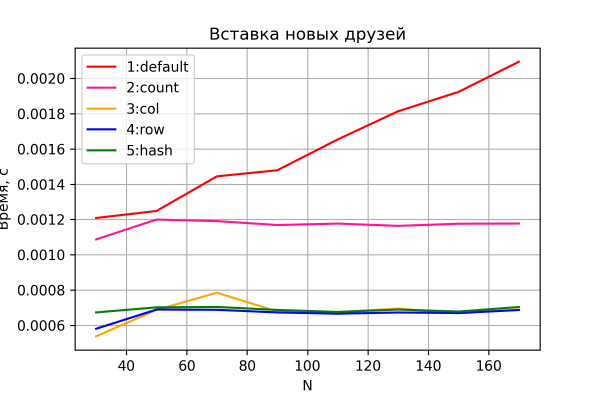
Alternativen 3-5 visar som förväntat praktiskt konstant tid för "affärsoperationen", som inte beror på nätverksstorlekens tillväxt och ingen märkbar skillnad i prestanda.
Alternativ 2 visar också konstant, men något sämre prestanda, nästan exakt 2 gånger jämfört med alternativen 3-5. Detta är glädjande, eftersom det stämmer överens med teorin – i detta alternativ är antalet in- och utdataoperationer till/från HBase faktiskt 2 gånger fler. Detta kan fungera som indirekt bevis på att vår testbänk i grunden ger en hyfsad noggrannhet.
Alternativ 1 visar sig också vara det långsammaste och demonstrerar en linjär ökning av tiden som krävs för att lägga till en vän i takt med nätverksstorleken.
Låt oss nu titta på resultaten från det andra testet.
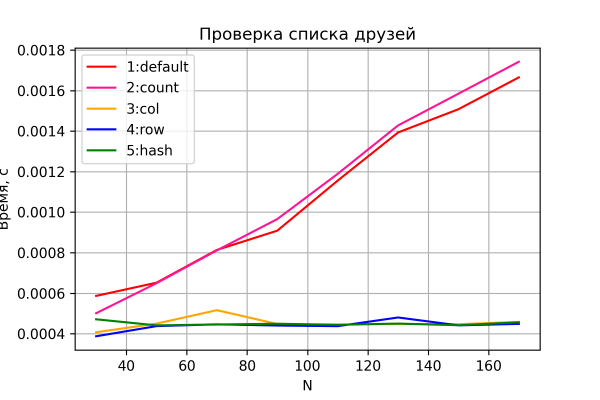
Alternativen 3-5 uppför sig förutsägbart – konstant tid som inte beror på nätverksstorleken. Alternativen 1 och 2 visar en linjär ökning av tiden när nätverksstorleken ökar och liknande prestanda. Alternativ 2 är dock något långsammare – uppenbarligen på grund av behovet av att läsa och bearbeta den extra kolumnen "count", vilket blir mer märkbart när n ökar. Men jag avstår ändå från att dra några slutsatser, eftersom noggrannheten i denna jämförelse är relativt låg. Dessutom varierade dessa relationer (vilket alternativ, 1 eller 2, är snabbare) från körning till körning (medan de upprätthöll karaktären av beroendeförhållandet och "gick näsa vid näsa").
Och den sista grafen – resultatet av borttagningstestet.
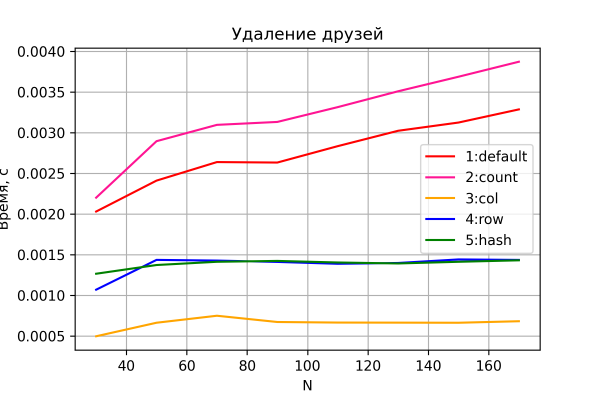
Här är det återigen utan överraskningar. Alternativen 3-5 utför borttagning på konstant tid.
Fascinerande nog visar alternativ 4 och 5, till skillnad från de tidigare scenarierna, något sämre prestanda än alternativ 3. Uppenbarligen är borttagning av en rad mer kostsam än borttagning av en kolumn, vilket är logiskt.
Alternativen 1 och 2 visar förutsägbart en linjär ökning av tiden. Dessutom är alternativ 2 konsekvent långsammare än alternativ 1 – på grund av den extra in- och utmatningsoperationen för "underhåll" av kolumnen count.
Allmänna slutsatser från experimentet:
- Alternativen 3-5 visar högre effektivitet eftersom de utnyttjar fördelarna med HBase; deras prestanda skiljer sig åt med en konstant och beror inte på nätverksstorleken.
- Skillnaden mellan alternativen 4 och 5 registrerades inte. Men det betyder inte att alternativ 5 inte bör användas. Det är fullt möjligt att det experimentella scenariot, med hänsyn till testbänkes specifikationer, inte möjliggjorde att den skulle identifieras.
- Karaktären av tidstillväxten för "affärsoperationer" med data bekräftade i stort sett tidigare teoretiska slutsatser för alla alternativ.
Epilog
Genomförda grova experiment bör inte betraktas som absolut sanning. Det finns flera faktorer som inte har beaktats och som förvränger resultaten (särskilt tydligt synligt i graferna vid små nätverksstorlekar). Till exempel hastigheten på thrift som används av happybase, mängden och sättet för implementationen av logiken som jag hade skrivit i Python (jag påstår inte att koden var skriven optimalt och nyttjade alla komponenters kapabiliteter effektivt), eventuella egenskaper av HBase-cache, bakgrundsaktiviteter på Windows 10 på min bärbara dator osv. Övergripande kan man hävda att alla teoretiska utläggningar experimentellt visade sin giltighet. Eller åtminstone gick det inte att motbevisa dem med ett sådant "rakt angrepp".
Till sist - rekommendationer till alla som just börjat designa datamodeller i HBase: abstrahera utifrån tidigare erfarenheter med relationsdatabaser och kom ihåg "budorden":
- När vi designar, utgår vi från uppgiften och mönster för datamanipulation, inte från modellen för ämnesområdet.
- Effektiv åtkomst (utan fullständig tabellskanning) – endast via nyckel.
- Deniormalisering.
- Olika rader kan innehålla olika kolumner.
- Dynamiskt kolumninnehåll.
Källa: habr.com
