

I fortsättningen av diskussionen om teknologier för att påskynda in- och utdataoperationer i samband med lagringssystem, inledda i , är det oavvisligt att nämna en populär funktion, nämligen tiering (Auto Tiering). Även om grundidén bakom denna funktion är ganska likartad hos olika tillverkare av lagringssystem, kommer vi att granska särdragen i implementeringen av tiering med Qsan .
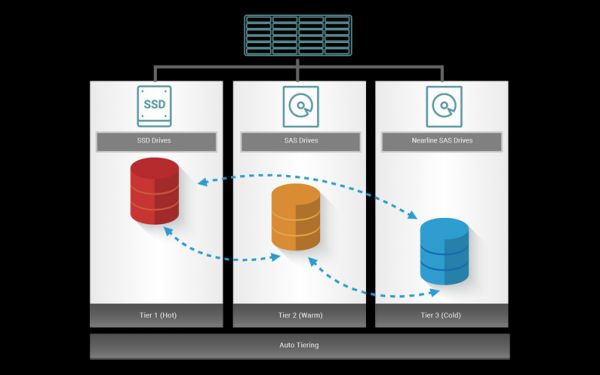
Trots mångfalden av data som lagras på lagringssystemet, kan dessa data delas in i flera grupper beroende på deras efterfrågan (användningsfrekvens). För de mest populära ("heta") data är det avgörande att organisera snabbt tillgång, medan mindre efterfrågade ("kalla") data kan behandlas med lägre prioritet.
För att organisera en sådan struktur används exakt tiering-funktionen. I det här fallet består datamängden inte av enhetliga diskar, utan av flera grupper av enheter som bildar olika lagringsnivåer (tier). Genom en speciell algoritm flyttas data automatiskt mellan nivåerna för att säkerställa maximal total prestanda.
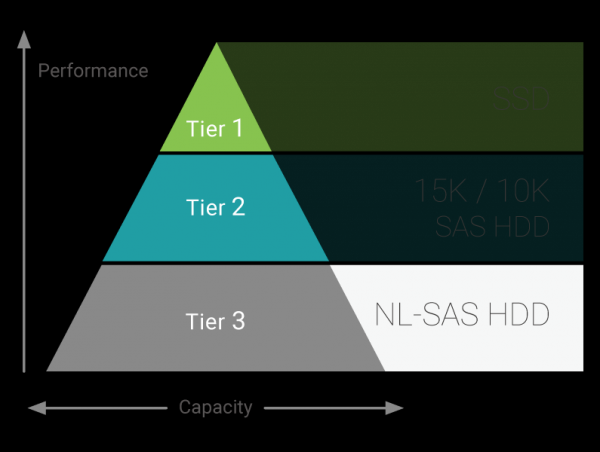
Lagring stöder upp till tre lagringsnivåer:
- Tier 1: SSD, maximal prestanda
- Tier 2: HDD SAS 10K/15K, hög prestanda
- Tier 3: HDD NL-SAS 7.2K, maximal kapacitet
Auto Tiering-poolen kan innehålla alla tre nivåerna eller bara två i valfria kombinationer. Inom varje Tier grupperas enheterna i vanliga RAID-grupper. För maximal flexibilitet kan RAID-nivån i varje Tier vara olika. D.v.s. till exempel, det finns inget som hindrar att organisera en struktur som 4x SSD RAID10 + 6x HDD 10K RAID5 + 12 HDD 7.2K RAID6.
Efter skapandet av volymer (virtuella diskar) på -poolen börjar bakgrundssamlingen av statistik om alla in- och utdataoperationer. För detta delades utrymmet upp i block med en storlek på 1 GB (s.k. sub LUN). Vid varje tillgång till ett sådant block tilldelas det en koefficient på 1. Med tiden minskar denna koefficient. Efter 24 timmar, vid avsaknad av in- och utdataförfrågningar till detta block, kommer den att vara 0.5 och fortsätter att falla varje efterföljande timme.
Vid en viss tidpunkt (som standard varje dag vid midnatt) rangordnas de insamlade resultaten baserat på aktiviteten i sub LUN efter deras poäng. Baserat på detta fattas beslut om vilka block som ska flyttas och i vilken riktning. Därefter sker faktiskt relokaliseringen av data mellan nivåerna.
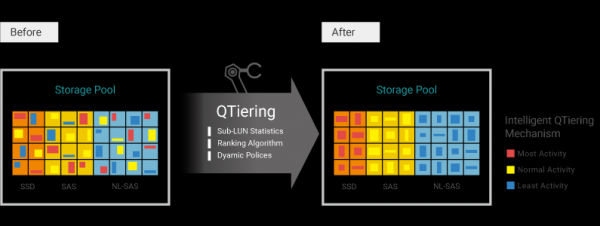
I Qsan-lagringssystemet är hanteringen av tiering-processen utmärkt implementerad med hjälp av många parametrar, vilket möjliggör en mycket flexibel anpassning av den slutgiltiga prestandan för arrayen.
För att bestämma det initiala läget för data och den prioriterade riktningen för deras flyttning används policies som anges separat för varje volym:
- Auto Tiering – standardpolicy, där den initiala placeringen och riktningen för flyttningen bestäms automatiskt, dvs. "heta" data strävar efter att hamna på den översta nivån, medan "kalla" data glider ner. Den initiala placeringen väljs baserat på det tillgängliga utrymmet på varje nivå. Men det är viktigt att förstå att systemet i första hand strävar efter att maximalt utnyttja de snabbaste lagringsenheterna. Således, om det finns ledigt utrymme, kommer data att placeras på de övre nivåerna. Denna policy passar de flesta scenarier där efterfrågan på data inte kan förutses i förväg.
- Börja med hög nivå, och sedan Auto Tiering – skillnaden från den föregående är endast i den initiala placeringen av data (på den snabbaste nivån)
- Maximalt hög nivå – data strävar alltid efter att ta den snabbaste nivån. Om de under arbetets gång flyttas nedåt, kommer de att flyttas tillbaka så snart som möjligt. Denna policy passar för data som kräver den snabbaste åtkomsten.
- Minimalt nivå – data strävar alltid efter att ta den lägsta nivån. Denna policy är utmärkt för sällan använda data (till exempel arkiv).
- Ingen flyttning – systemet identifierar automatiskt det initiala läget för data och utför inga flyttningar. Statistik fortsätter dock att samlas in ifall det senare skulle bli nödvändigt med relokalisering.
Det är värt att notera att även om policies definieras vid skapandet av varje volym, kan de ändras flera gånger "i realtid" under systemets livscykel.
Utöver politik för tiering-mekanismen kan även frekvens och takt för dataflytt mellan nivåer ställas in. Specifika tider för flytt kan anges: dagligen eller på utvalda veckodagar, samt minska intervallen för statistikinsamling till några timmar (minimalt intervall – 2 timmar). Om det behövs kan tidsramar (fönster för flytt) anges för att begränsa tiden för dataflytt. Dessutom anges även hastigheten för relokering – 3 lägen: snabbt, medelhastighet, långsamt.
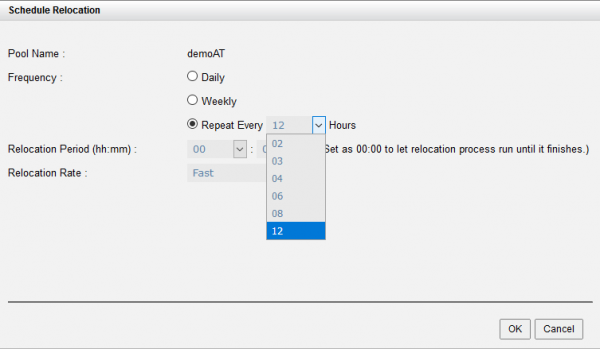
Vid behov av omedelbar relokering av data finns möjlighet att utföra detta manuellt när som helst på begäran av administratören.
Det är uppenbart att ju oftare och snabbare data flyttas mellan nivåerna, desto mer flexibelt kommer lagringssystemet att anpassa sig efter aktuella driftsförhållanden. Men man bör också komma ihåg att flyttning medför en extra belastning (framför allt på diskarna), så data bör inte flyttas utan verkligt behov. Det är bättre att planera flyttningen till tider med minimal belastning. Om lagringssystemets arbete ständigt kräver hög prestanda i ett 24/7-läge, bör hastigheten på relokeringen sänkas till minimalt.
Mängden inställningar för tiering kommer utan tvekan att glädja avancerade användare. Men även för dem som möter denna teknik för första gången finns det inget att vara rädd för. Standardinställningarna (Auto Tiering-politik, flyttning med maximal hastighet en gång per natt) kan tryggt användas, och i takt med att statistik samlas in kan olika parametrar justeras för att uppnå önskat resultat.
När man jämför tiering med en lika populär teknik för att öka prestanda, som , bör man komma ihåg de olika principerna bakom deras algoritmer.
SSD-caching
Auto Tiering
Tidsramen för effekten
Nästan omedelbart. Men den märkbara effekten kommer först efter att cachen har "värmts upp" (minuter-timmar)
Efter insamling av statistik (från 2 timmar, i idealfallet – en dag) plus tid för dataflytt
Effektens varaktighet
Tills data ersätts av en ny uppsättning (minuter-timmar)
Tills efterfrågan på data är aktuell (en dag och mer)
Indikationer för användning
Omedelbar ökning av prestanda under kort tid (databaser, virtualiseringsmiljöer)
Ökning av prestanda under en längre period (fil-, web-, och e-postservrar)
En annan egenskap hos tiering är möjligheten att använda det inte bara för scenarier av typen "SSD + HDD", utan även "snabba HDD + långsamma HDD" eller till och med alla tre nivåer, vilket i princip är omöjligt vid användning av SSD-cache.
Testning
För att testa funktionen hos tiering-algoritmerna genomförde vi ett enkelt test. En pool skapades bestående av två nivåer SSD (RAID 1) + 7.2K HDD (RAID1), där en volym med policy för "lägsta nivå" placerades. Det vill säga, data skulle alltid ligga på de långsammare diskarna.
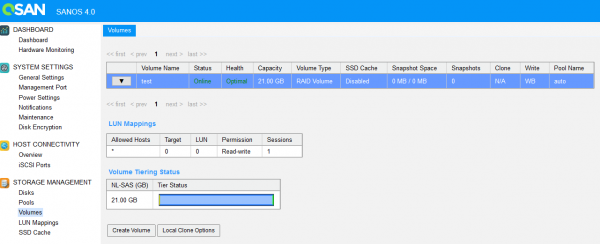
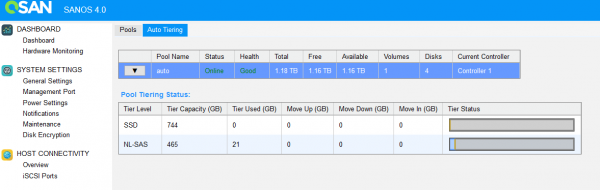
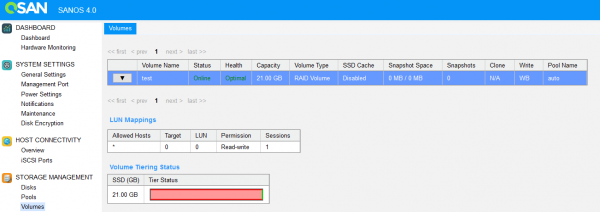
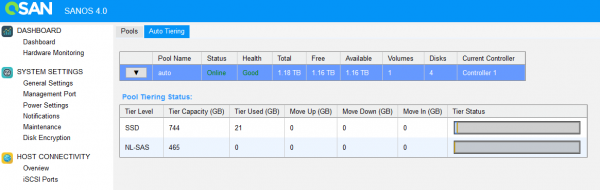
Användargränssnittet visar tydligt hur data placeras mellan nivåerna
Efter att volymen hade fyllts med data ändrade vi placeringspolicyn till Auto Tiering och körde IOmeter-testet.
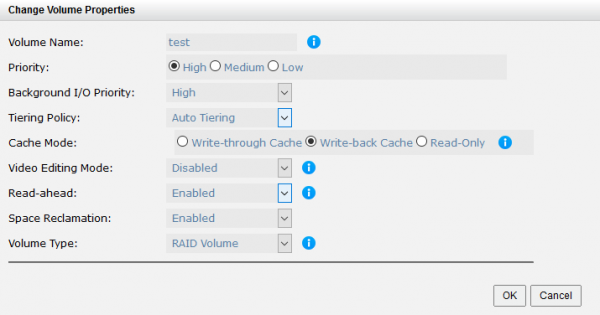
Efter flera timmars testande, när systemet lyckades samla statistik, inleddes omplaceringsprocessen.
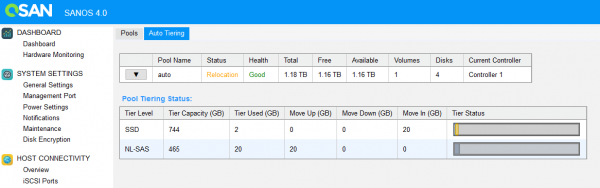
Vid slutet av dataflyttningen hade vår testvolym helt "krupit" upp till den översta nivån (SSD).
Utvärdering
Auto Tiering är en fantastisk teknologi som gör det möjligt att öka prestandan för lagringssystemet med minimala materiella och tidsmässiga kostnader genom mer intensiv användning av snabba enheter. Applicerad på den enda investeringen är licensen, som köps en gång för alla utan begränsningar för volym/antal diskar/hyllor/osv. Denna funktionalitet kommer med så rika inställningar att den kan tillfredsställa praktiskt taget alla affärsbehov. Visualiseringen av processerna i gränssnittet gör att man effektivt kan hantera enheten.
Källa: habr.com
