

Det finns många verktyg för att debugga kärnor och applikationer i Linux. De flesta av dem påverkar applikationers prestanda negativt och kan inte användas i produktion.
För ett par år sedan skapades — eBPF. Det gör det möjligt att spåra kärnan och användarapplikationer med låg overhead och utan behov av att återkompilera program eller ladda externa moduler i kärnan.
Idag finns det redan många applikationsverktyg som använder eBPF, och i den här artikeln kommer vi att titta på hur man skriver ett eget profileringsverktyg baserat på biblioteket . Artikeln baseras på verkliga händelser. Vi kommer att gå från problemets uppkomst till dess lösning för att visa hur redan existerande verktyg kan användas i specifika situationer.
Ceph är långsam
En ny värd har lagts till i Ceph-klustret. Efter migrering av delar av data till den märkte vi att hastigheten på skrivbegärningar var mycket lägre än på andra servrar.
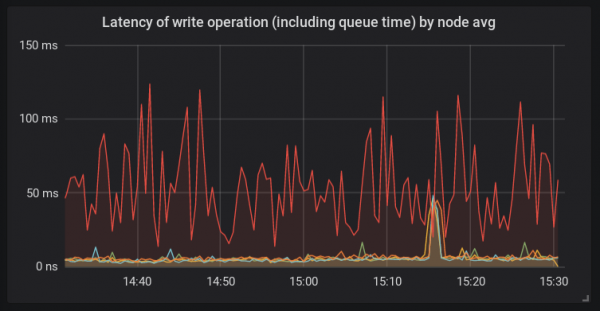
Till skillnad från andra plattformar användes bcache och en ny kärna linux 4.15 på denna värd. Denna konfiguration användes här för första gången. Och vid den tidpunkten var det klart att orsaken till problemet teoretiskt kunde vara vad som helst.
Undersöker värden
Vi börjar med att titta på vad som händer inuti processen ceph-osd. För detta kommer vi att använda och (mer om det kan läsas ):
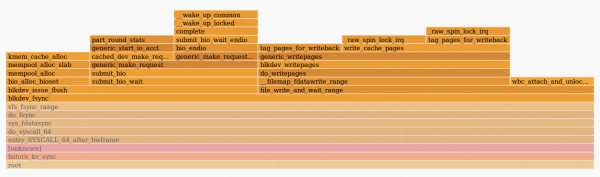
Bilden visar att funktionen fdatasync() tog mycket tid när en begäran skickades i funktionen generic_make_request(). Det betyder att orsaken till problemen troligen ligger någonstans utanför själva osd-demonen. Detta kan vara antingen kärnan eller diskarna. Utfallet av iostat visade hög fördröjning i hanteringen av begärningar från bcache-diskarna.
Vid kontroll av värden upptäckte vi att demon systemd-udevd förbrukade mycket CPU-tid — cirka 20% på flera kärnor. Detta är ett märkligt beteende, så vi måste ta reda på orsaken. Eftersom Systemd-udevd arbetar med uevent, bestämde vi oss för att titta på dem via udevadm monitor. Det visade sig att en stor mängd change-händelser genererades för varje blockenhet i systemet. Detta är ganska ovanligt, så vi måste undersöka vad som orsakar alla dessa händelser.
Använder BCC-verktyget
Som vi redan har bekräftat spenderar kärnan (och demon ceph i systemanropet) mycket tid på generic_make_request(). Låt oss försöka mäta hastigheten på denna funktion. I finns redan ett utmärkt verktyg — funclatency. Vi kommer att spåra demon via dess PID med en intervall på 1 sekund mellan informationsutskrifter och visa resultatet i millisekunder.
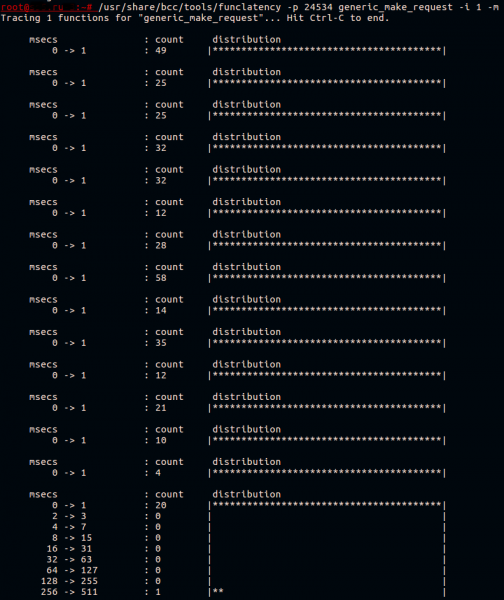
Normalt fungerar denna funktion snabbt. Allt den gör är att skicka en begäran till enhetsdrivrutins kö.
Bcache är en komplex enhet som faktiskt består av tre diskar:
- backing device (cachebar disk), i detta fall en långsam HDD;
- caching device (cacheminne), här är det en partition av NVMe-enheten;
- den virtuella enheten bcache, som programmet arbetar med.
Vi vet att överföringen av begäran saktar ner, men vilket av dessa enheter? Vi kommer att ta reda på det senare.
För nu vet vi att ueventerna sannolikt orsakar problemen. Att hitta vad som exakt utlöser deras generering är inte så enkelt. Låt oss anta att det är någon mjukvara som körs periodiskt. Vi ska se vilken mjukvara som startas i systemet med hjälp av skriptet execsnoop från samma . Vi kör det och dirigerar utdata till en fil.
Till exempel så här:
/usr/share/bcc/tools/execsnoop | tee ./execdump
Vi kommer inte att visa hela utskriften av execsnoop här, men en intressant rad såg ut så här:
sh 1764905 5802 0 sudo arcconf getconfig 1 AD | grep Temperature | awk -F '[:\/]' '{print $2}' | sed 's\/^ ([0-9]*) C.*\/1\/'
Den tredje kolumnen är PPID (parent PID) för processen. Processen med PID 5802 visade sig vara en av trådarna i vårt övervakningssystem. Vid kontroll av konfigurationen av övervakningssystemet upptäcktes felaktigt angivna parametrar. Temperaturen på HBA-adaptern mättes var 30:e sekund, vilket var mycket oftare än nödvändigt. Efter att ha ändrat kontrollintervallet till ett längre, upptäckte vi att fördröjningen i begärningsbehandlingen på denna värd inte längre stack ut i förhållande till andra värdar.
Men det är fortfarande oklart varför bcache-enheten var så seg. Vi förberedde en testplattform med identisk konfiguration och försökte reproducera problemet genom att köra fio på bcache och periodiskt starta udevadm trigger för att generera uevents.
Skriver BCC-baserade verktyg
Låt oss försöka skriva ett enkelt verktyg för att spåra och visa de långsammaste anropen generic_make_request(). Vi är också intresserade av namnet på disken för vilken denna funktion utfördes.
Planen är enkel:
- Registrera kprobe till generic_make_request():
- Vi sparar namnet på disken i minnet, tillgängligt via funktionsargumentet;
- Vi sparar tidsstämpeln.
- Registrera kretprobe på återvändo från generic_make_request():
- Hämtar den aktuella tidsstämpeln;
- Söker efter en sparad tidsstämpel och jämför med den aktuella;
- Om resultatet är större än det angivna, söker vi efter det sparade disknamnet och skriver ut det i terminalen.
Kprobes och kretprobes använder ett mekanism av stoppunkter för att ändra funktionskod på flygande. Du kan läsa och artikel om detta ämne. Om vi tittar på koden för olika verktyg i , kan vi märka att de har en identisk struktur. Så vi kommer att hoppa över att parsa skriptargument och gå direkt till BPF-programmet.
Texten eBPF i python-skriptet ser ut som följer:
bpf_text = ''' # Här kommer bpf-programkod att vara '''
För att utbyta data mellan funktioner använder eBPF-program . Låt oss göra samma sak. Som nyckel kommer vi att använda PID för processen, och som värde definierar vi strukturen:
struct data_t {
	u64 pid;
	u64 ts;
	char comm[TASK_COMM_LEN];
	u64 lat;
	char disk[DISK_NAME_LEN];
};

BPF_HASH(p, u64, struct data_t);
BPF_PERF_OUTPUT(events);
Här registrerar vi en hash-tabell som kallas p, med nyckeltyp u64 och värdetyp struct data_t. Tabellen kommer att vara tillgänglig i kontexten för vårt BPF-program. Makrot BPF_PERF_OUTPUT registrerar en annan tabell som kallas events, vilket används för till användarutrymmet.
När man mäter fördröjningar mellan funktionsanrop och återvändande från den, eller mellan anrop av olika funktioner, måste man ta hänsyn till att de erhållna uppgifterna måste tillhöra samma kontext. Med andra ord, man måste komma ihåg den möjliga parallella körningen av funktioner. Vi har möjlighet att mäta fördröjningen mellan anropet av en funktion i kontexten för en process och återvändandet från denna funktion i kontexten för en annan process, men detta är förmodligen meningslöst. Ett bra exempel här kan vara , där nyckeln till hash-tabellen ställs in som en pekare på struct request, vilket speglar en begäran till disken.
Därefter behöver vi skriva kod som körs när den undersökta funktionen anropas:
void start(struct pt_regs *ctx, struct bio *bio) {
	u64 pid = bpf_get_current_pid_tgid();
	struct data_t data = {};
	u64 ts = bpf_ktime_get_ns();
	data.pid = pid;
	data.ts = ts;
	bpf_probe_read_str(&data.disk, sizeof(data.disk), (void*)bio->bi_disk->disk_name);
	p.update(&pid, &data);
}
Här kommer den andra argumentet att sättas in som den första argumentet i den anropade funktionen . Efter detta får vi PID-processen som vi arbetar i samt den aktuella tidsstämpeln i nanosekunder. Vi skriver ner allt detta i den nyutdelade struct data_t data. Diskens namn får vi från strukturen bio, som skickas vid anropet generic_make_request(), och sparar det i samma struktur data. Det sista steget är att lägga till en post i hash-tabellen som nämndes tidigare.
Den nästa funktionen kommer att anropas vid återgång från generic_make_request():
void stop(struct pt_regs *ctx) {
    u64 pid = bpf_get_current_pid_tgid();
    u64 ts = bpf_ktime_get_ns();
    struct data_t* data = p.lookup(&pid);
    if (data != 0 && data->ts > 0) {
        bpf_get_current_comm(&data->comm, sizeof(data->comm));
        data->lat = (ts - data->ts)/1000;
        if (data->lat > MIN_US) {
            FACTOR
            data->pid >>= 32;
            events.perf_submit(ctx, data, sizeof(struct data_t));
        }
        p.delete(&pid);
    }
}
Denna funktion liknar den föregående: vi tar reda på PID-processen och tidsstämpeln, men allokerar inte minne för en ny data-struktur. Istället letar vi upp den redan existerande strukturen i hash-tabellen med nyckeln == nuvarande PID. Om strukturen hittas får vi reda på namnet på den körda processen och lägger till det i den.
Den binära skiftningen vi använder här behövs för att få tråd GID, d.v.s. PID för huvudprocessen som startade tråden, i sammanhanget vi arbetar. Den funktion vi anropar återvänder både GID för tråden och dess PID i ett enda 64-bitars värde.
Vid utskrift till terminalen är vi för närvarande inte intresserade av tråden, utan av huvudprocessen. Efter att ha jämfört den erhållna latensen med den angivna tröskeln, överför vi vår struktur data till användarrummet genom tabellen events, varefter vi tar bort posten från p.
I python-skriptet som kommer att ladda denna kod behöver vi ersätta MIN_US och FACTOR med latensgränser och tidsenheter som vi kommer att vidarebefordra genom argument:
bpf_text = bpf_text.replace('MIN_US',str(min_usec))
if args.milliseconds:
	bpf_text = bpf_text.replace('FACTOR','data->lat /= 1000;')
	label = "msek"
else:
	bpf_text = bpf_text.replace('FACTOR','')
	label = "mikrosek"
Nu måste vi förbereda BPF-programmet genom och registrera probes:
b = BPF(text=bpf_text)
b.attach_kprobe(event="generic_make_request",fn_name="start")
b.attach_kretprobe(event="generic_make_request",fn_name="stop")
Vi måste även definiera struct data_t i vårt skript, annars kommer inget att kunna läsas:
TASK_COMM_LEN = 16	# linux/sched.h
DISK_NAME_LEN = 32	# linux/genhd.h
class Data(ct.Structure):
	_fields_ = [("pid", ct.c_ulonglong),
            	("ts", ct.c_ulonglong),
            	("comm", ct.c_char * TASK_COMM_LEN),
            	("lat", ct.c_ulonglong),
            	("disk",ct.c_char * DISK_NAME_LEN)]
Det sista steget är att skriva ut data på terminalen:
def print_event(cpu, data, size):
    global start
    event = ct.cast(data, ct.POINTER(Data)).contents
    if start == 0:
        start = event.ts
    time_s = (float(event.ts - start)) / 1000000000
    print("%-18.9f %-16s %-6d   %-1s %s   %s" % (time_s, event.comm, event.pid, event.lat, label, event.disk))

b["events"].open_perf_buffer(print_event)
# formatera utdata
start = 0
while 1:
    try:
        b.perf_buffer_poll()
    except KeyboardInterrupt:
        exit()
Själva skriptet finns på . Låt oss försöka köra det på en testplattform där fio körs och skriver till bcache, och köra udevadm monitor:
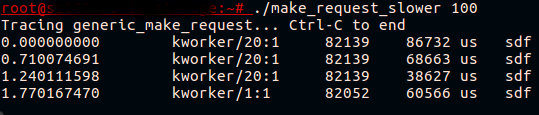
Äntligen! Nu ser vi att det som såg ut som ett bcache-enhet som saktade ner egentligen är ett saktande anrop generic_make_request() för den cachade disken.
Gräv i kärnan
Vad exakt orsakar fördröjning under begärans överföring? Vi ser att fördröjningen inträffar även innan begärans redovisning börjar, det vill säga redovisningen av den specifika begäran för vidare statistik ( /proc/diskstats eller iostat) har ännu inte börjat. Detta kan enkelt verifieras genom att köra iostat medan problemet reproduceras, eller , som baseras på början och slutet av begärans redovisning. Ingen av dessa verktyg kommer att visa några problem för begärningar till den cachade disken.
Om vi ser på funktionen generic_make_request(), kommer vi att se att innan begärans redovisning börjar anropas ytterligare två funktioner. Den första är generic_make_request_checks(), som utför legitimitetskontroller av begäran i förhållande till diskens inställningar. Den andra är , där det finns ett intressant anrop :
ret = wait_event_interruptible(q->mq_freeze_wq,
	(atomic_read(&q->mq_freeze_depth) == 0 &&
	(preempt || !blk_queue_preempt_only(q))) ||
	blk_queue_dying(q));
Kärnan väntar på att köa ska avfrysas. Låt oss mäta fördröjningen blk_queue_enter():
~# /usr/share/bcc/tools/funclatency  blk_queue_enter -i 1 -m
Spårar 1 funktioner för "blk_queue_enter"... Tryck Ctrl-C för att avsluta.

 	msecs           	: count 	distribution
     	0 -> 1      	: 341  	|****************************************|

 	msecs           	: count 	distribution
     	0 -> 1      	: 316  	|****************************************|

 	msecs           	: count 	distribution
     	0 -> 1      	: 255  	|****************************************|
     	2 -> 3      	: 0    	|                                    	|
     	4 -> 7      	: 0    	|                                    	|
     	8 -> 15     	: 1    	|                                    	|
Det verkar som att vi är nära en lösning. Funktionerna som används för att "frysa/avfrosta" kön är och . De används när det är nödvändigt att förändra köinställningar som potentiellt kan vara farliga för begärningar som redan finns i denna kö. Vid anropet blk_mq_freeze_queue() anropas av funktionen räknaren inkrementeras q->mq_freeze_depth. Efter detta väntar kärnan på att köen ska tömmas i .
Tiden för att rensa denna kö är ekvivalent med diskens fördröjning, eftersom kärnan väntar på att alla schemalagda operationer ska slutföras. Så snart kön är tom tillämpas inställningarna. Därefter anropas , vilket minskar räknaren freeze_depth.
Nu vet vi tillräckligt för att åtgärda situationen. Kommandot udevadm trigger resulterar i att inställningarna för det blockenheten tillämpas. Dessa inställningar beskrivs i udev-regler. Vi kan ta reda på vilka inställningar som "fryser" kön genom att försöka ändra dem via sysfs eller genom att titta på kärnans källkod. Vi kan också försöka med verktyget BCC , som kommer att visa stacktraces från kärnan och användarrummet för varje anrop av blk_freeze_queue, till exempel:
~# /usr/share/bcc/tools/trace blk_freeze_queue -K -U
PID 	TID 	COMM        	FUNC
3809642 3809642 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	elevator_switch+0x29 [kernel]
    	elv_iosched_store+0x197 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]

3809631 3809631 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	queue_requests_store+0xb6 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]
Udev-regler ändras ganska sällan och vanligtvis sker detta under kontroll. Så vi ser att även tillämpningen av redan angivna värden orsakar en ökning av fördröjningen för begäran från applikationen till disken. Naturligtvis är det ingen bra praxis att generera udev-händelser när det inte finns några ändringar i diskens konfiguration (till exempel när en enhet inte kopplas in/ur), men vi kan hjälpa kärnan att undvika onödig arbetsbelastning och att inte "frysa" begärningskön om det inte finns något behov. rättar till situationen.
Slutsats
eBPF är ett mycket flexibelt och kraftfullt verktyg. I artikeln har vi gått igenom ett praktiskt fall och visat en liten del av vad som är möjligt att göra. Om du är intresserad av att utveckla BCC-verktyg kan det vara värt att titta på , som bra beskriver grunderna i hur det fungerar.
Det finns också andra intressanta verktyg för felsökning och profilering som bygger på eBPF. Ett av dem är , som möjliggör att skriva kraftfulla enradare och små program i ett awk-liknande språk. Ett annat är , som gör det möjligt att samla in låg-nivå högupplösta metrik direkt till din Prometheus-server, med möjligheten att i framtiden få vacker visualisering och till och med larm.
Källa: habr.com
