

På RIT 2019 gjorde vår kollega Alexander Korotkov ett föredrag om automatisering av utvecklingen på CIAN: för att förenkla livet och arbetet använder vi vår egen plattform Integro. Den följer upp livscykeln för uppgifter, tar bort rutinoperationer från utvecklarna och minskar betydligt antalet buggar i produktion. I det här inlägget kommer vi att komplettera Alexanders presentation och berätta hur vi gick från enkla skript till att sammanfoga open source-produkter genom vår egen plattform och vad vårt separata automat team arbetar med.
Nollnivå
"Det finns ingen nollnivå, jag känner inte till något sådant"
Mästare Shifu från filmen "Kung Fu Panda"
Automatiseringen på CIAN började 14 år efter företagets grundande. Då fanns det 35 personer i utvecklingsteamet. Det är svårt att tro, eller hur? Självklart fanns automatisering i någon form, men ett separat spår för kontinuerlig integration och kodleverans började formas först 2015.
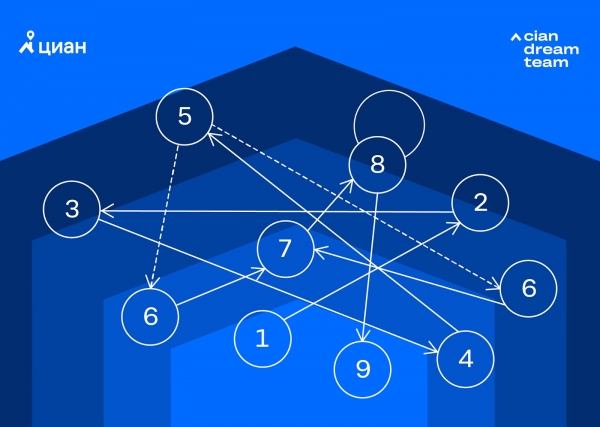
Vid den tidpunkten hade vi en stor monolit av Python, C# och PHP, som var distribuerad på Linux-/Windows-servrar. För att distribuera detta monster hade vi en uppsättning skript som vi körde manuellt. Det fanns också en byggprocess för monoliten, som skapade mycket smärta och lidande på grund av konflikter vid sammanslagning av grenar, buggfixar och nybyggnad "med en annan uppsättning uppgifter i bygget". Förenklat såg processen ut så här:
Det här var inte tillfredsställande för oss, och vi ville bygga en upprepbar, automatiserad och styrd bygg- och distributionsprocess. För detta behövde vi ett CI/CD-system och vi valde mellan den kostnadsfria versionen av Teamcity och den kostnadsfria Jenkins, eftersom vi hade arbetat med dem och båda uppfyllde våra funktionskrav. Vi valde Teamcity som en nyare produkt. Då använde vi fortfarande inte mikrotjänstarkitektur och räknade inte med ett stort antal uppgifter och projekt.
Vi kom då på idén om ett eget system
Implementeringen av Teamcity eliminera bara en del av det manuella arbetet: det återstod fortfarande skapandet av pull requests, befordran av uppgifter genom statusar i Jira, val av uppgifter för release. Systemet Teamcity hanterade inte detta. Det behövdes en väg för fortsatt automatisering. Vi övervägde alternativ för att arbeta med skript i Teamcity eller att gå över till externa automatiseringssystem. Men till slut beslutade vi att vi behövde maximal flexibilitet, som endast en egen lösning kan ge. Så föddes den första versionen av det interna automatiseringssystemet kallat Integro.
Teamcity hanterar automatiseringen på nivån för att starta bygg- och deployprocesser, medan Integro fokuserade på övergripande automatisering av utvecklingsprocesser. Det behövdes en sammanslagning av arbetet med uppgifter i Jira med bearbetningen av den relaterade koden i Bitbucket. Vid detta stadie började Integro utveckla sina egna arbetsflöden för att hantera uppgifter av olika typer.
På grund av den ökade automatiseringen i affärsprocesserna växte antalet projekt och körningar i Teamcity. Så kom ett nytt problem: en gratis instans av Teamcity räckte inte längre (3 agenter och 100 projekt), vi la till en till instans (ytterligare 3 agenter och 100 projekt), sedan ännu en. Totalt fick vi ett system bestående av flera kluster som var svårt att hantera.
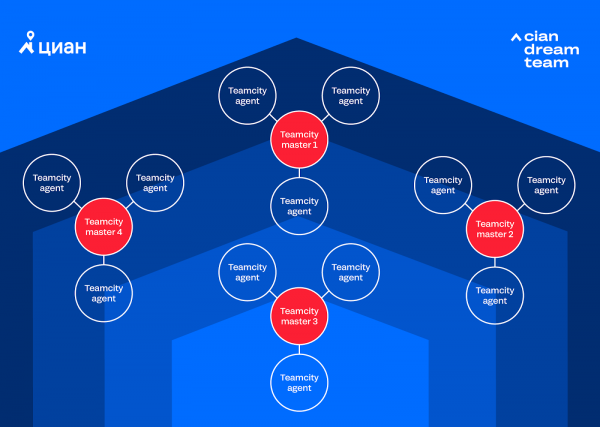
När frågan om en fjärde instans kom upp insåg vi att vi inte kunde fortsätta så här, eftersom de totala kostnaderna för att supporta 4 instanser redan inte passade inom några ramar. Frågan om att köpa en betalversion av Teamcity eller att välja gratis Jenkins dök upp. Vi gjorde beräkningar kring instanser och automatiseringsplaner och beslutade att vi skulle använda Jenkins. Efter ett par veckor bytte vi till Jenkins och blev av med en del av huvudvärken kopplad till att stödja flera instanser av Teamcity. Därför kunde vi fokusera på utvecklingen av Integro och anpassningen av Jenkins efter våra behov.
Med den ökande grundautomatiseringen (i form av automatisk skapande av Pull Request, insamling och publicering av kodtäckning och andra kontroller) uppstod en stark önskan att maximalt överge manuella releaser och överlämna detta arbete till robotar. Dessutom påbörjades en flytt till mikrotjänster inom företaget, vilket krävde frekventa releaser, dessutom separerade från varandra. Så vi har gradvis kommit fram till automatiserade releaser av våra mikrotjänster (monoliten släpper vi fortfarande manuellt på grund av processens komplexitet). Men, som det ofta är, uppstod en ny svårighet.
Automatiserar testning
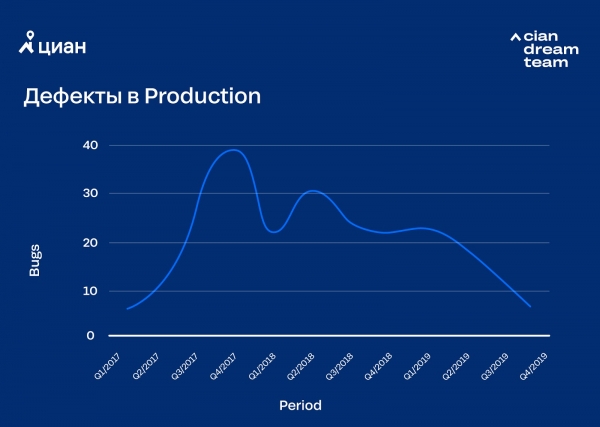
Genom automatiseringen av releaser har utvecklingsprocesserna accelererat, delvis genom att hoppa över vissa teststeg. Detta ledde till en tillfällig förlust av kvalitet. Det låter banalt, men tillsammans med accelerationen av releaser var det nödvändigt att ändra även metodologin för produktutveckling. Det var dags att tänka på automatisering av testning, främjande av personlig ansvarighet (här handlar det om "att ta idén i huvudet", inte monetära böter) av utvecklaren för den kod som släpps och buggar i den, samt att beslutet om att släppa / inte släppa uppgiften skulle fattas genom automatisk distribution.
Genom att åtgärda kvalitetsproblem kom vi fram till två viktiga beslut: vi började genomföra kanarietester och införde automatisk övervakning av bakgrundsfel med automatisk respons på dess överskridande. Den första lösningen gjorde det möjligt att identifiera uppenbara fel innan koden helt hamnade i produktion, den andra minskade svarstiden på problem i produktion. Fel förekommer såklart, men vi lägger större delen av tiden och energin inte på att rätta till, utan på att minimera.
Automatiseringsteamet
Just nu har vi en personalstyrka på 130 utvecklare, och vi fortsätter . Teamet för kontinuerlig integration och kodleverans (hädanefter kallat Deploy and Integration-teamet eller DI) består av 7 personer och arbetar i 2 riktningar: utveckling av automatiseringsplattformen Integro och DevOps.
DevOps ansvarar för Dev/Beta-miljöerna för CIAN, integro-miljöerna och hjälper utvecklare att lösa problem och utveckla nya strategier för att skala miljöerna. Utvecklingsinriktningen för Integro arbetar både med själva Integro och relaterade tjänster, som exempelvis plugins för Jenkins, Jira och Confluence, samt utvecklar hjälpprogram och applikationer för utvecklarteam.
DI-teamet arbetar tillsammans med plattformsteamet, som ansvarar för att utveckla arkitektur, bibliotek och utvecklingsmetoder inom företaget. Dessutom kan varje utvecklare inom CIAN bidra till automatisering, till exempel genom att skapa mikroautomatisering för teamets behov eller dela med sig av en bra idé för hur automatiseringen kan förbättras.
Tårtperspektiv på automatisering i CIAN
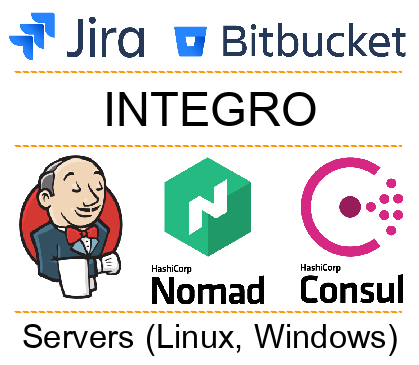
Alla system som involveras i automatiseringen kan delas in i flera lager:
- Externa system (Jira, Bitbucket, etc.). Dessa används av utvecklarteam.
- Integro-plattformen. Oftast jobbar inte utvecklarna direkt med den, men det är den som understöder hela automatiseringen.
- Leveranstjänster, orkestrering och upptäckning (till exempel Jenkins, Consul, Nomad). Med hjälp av dessa implementerar vi koden på servrar och ser till att tjänsterna fungerar tillsammans.
- Den fysiska nivån (servrar, operativsystem, relaterad programvara). På denna nivå körs vår kod. Det kan vara både en fysisk server och en virtuell (LXC, KVM, Docker).
Utifrån detta koncept delar vi upp ansvarsområden inom DI-teamet. De två första nivåerna faller under utvecklingsinriktningen för Integro, medan de två sista nivåerna faller under DevOps-ansvaret. Denna uppdelning gör det möjligt att fokusera på uppgifter och stör inte samarbetet, eftersom vi är nära varandra och kontinuerligt delar kunskap och erfarenhet.
Integro
Låt oss fokusera på Integro och börja med teknologistacken:
- CentOs 7
- Docker + Nomad + Consul + Vault
- Java 11 (den gamla monoliten av Integro kvarstår på Java 8)
- Spring Boot 2.X + Spring Cloud Config
- PostgreSql 11
- RabbitMQ
- Apache Ignite
- Camunda (inbäddad)
- Grafana + Graphite + Prometheus + Jaeger + ELK
- Web UI: React (CSR) + MobX
- SSO: Keycloak
Vi följer principen för mikrotjänstutveckling, även om vi har en legacy i form av en monolitisk tidig version av Integro. Varje mikrotjänst körs i sin egen Docker-container, och tjänsterna kommunicerar med varandra via HTTP-förfrågningar och RabbitMQ-meddelanden. Mikrotjänsterna hittar varandra via Consul och gör en förfrågan till den, där de autentiserar via SSO (Keycloak, OAuth 2/OpenID Connect).
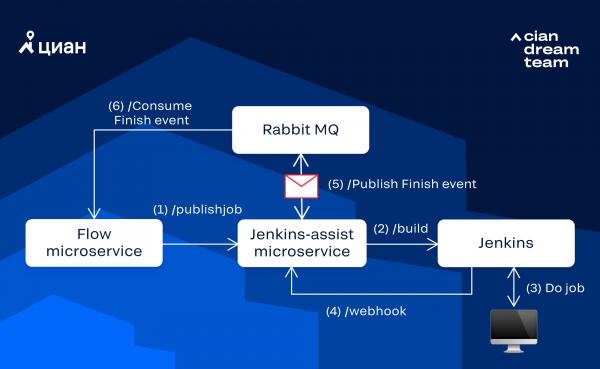
Som ett verkligt exempel kan vi titta på interaktionen med Jenkins, som består av följande steg:
- Mikrotjänsten för workflow-hantering (hädanefter Flow-mikrotjänsten) vill starta en byggprocess i Jenkins. För detta hittar den via Consul IP:PORT för mikrotjänsten som integrerar med Jenkins (hädanefter Jenkins-mikrotjänsten) och skickar en asynkron förfrågan för att starta bygget i Jenkins.
- Jenkins-mikrotjänsten, efter att ha mottagit förfrågan, formar och returnerar ett Job ID, som senare kan användas för att identifiera resultatet av arbetet. Samtidigt startar den bygget i Jenkins via anrop av REST API.
- Jenkins genomför bygget och efter avslutandet skickar en webhook med resultatet av exekveringen till Jenkins-mikrotjänsten.
- Jenkins-mikrotjänsten, som mottar webhooken, formar ett meddelande om att behandlingen av förfrågan är klar och bifogar resultatet av exekveringen. Det formade meddelandet skickas till RabbitMQ-kön.
- Genom RabbitMQ når det publicerade meddelandet Flow-mikrotjänsten, som får veta resultatet av sin uppgiftsbehandling genom att matcha Job ID från förfrågan med det mottagna meddelandet.
Just nu har vi runt 30 mikrotjänster som kan delas upp i flera grupper:
- Konfigurationshantering.
- Informationsspridning och interaktion med användare (meddelandeapplikationer, e-post).
- Arbete med källkod.
- Integration med distributionsverktyg (Jenkins, Nomad, Consul etc.).
- Övervakning (avsläpp, fel etc.).
- Webbverktyg (UI för att hantera testmiljöer, samla in statistik etc.).
- Integration med uppgiftsspårare och liknande system.
- Hantering av workflow för olika uppgifter.
Workflow för uppgift.
Integro automatiserar åtgärder relaterade till livscykeln för en uppgift. Förenklat definierar vi livscykeln för en uppgift som workflow i Jira. I våra utvecklingsprocesser finns det flera varianter av workflow beroende på projekt, uppgiftstyp och valda alternativ i den aktuella uppgiften.
Låt oss titta på det workflow som vi använder oftast:
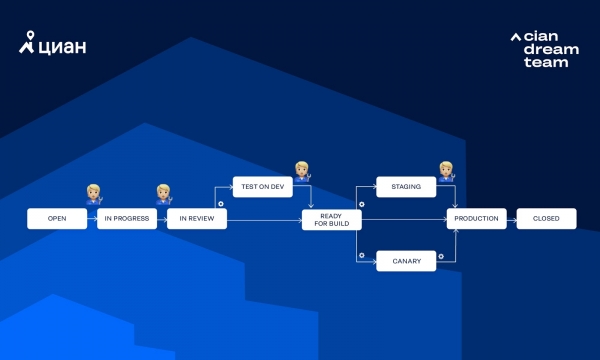
I schemat visar kugghjulet att övergången triggas automatiskt av Integro, medan mänsklig figuren indikerar att övergången triggas manuellt av en person. Låt oss titta på några vägar som uppgiften kan ta i denna arbetsflöde.
Helt manuell testning på DEV+BETA utan kanarietester (vi släpper vanligtvis monoliten så här):
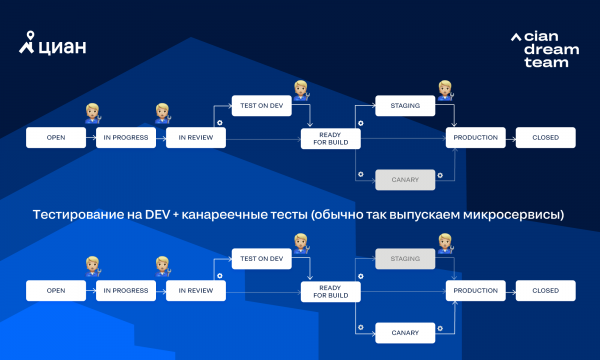
Det kan finnas andra kombinationer av övergångar. Ibland kan vägen som uppgiften tar väljas genom alternativ i Jira.
Uppgiftens rörelse
Låt oss titta på de viktigaste stegen som utförs när uppgiften rör sig genom arbetsflödet "Testning på DEV + kanarietester":
1. Utvecklare eller PM skapar uppgiften.
2. Utvecklaren tar uppgiften i arbete. Efter slutförandet flyttar de den till statusen IN REVIEW.
3. Jira skickar Webhook mot Jira-mikrotjänsten (ansvarar för integrationen med Jira).
4. Jira-mikrotjänsten skickar en begäran till Flow-tjänsten (ansvarar för interna arbetsflöden där arbetet utförs) för att starta arbetsflödet.
5. Inom Flow-tjänsten:
- Granskare tilldelas uppgiften (Users-mikrotjänsten, som vet allt om användare + Jira-mikrotjänsten).
- Genom Source-mikrotjänsten (som känner till förråd och grenar men inte arbetar med själva koden) görs sökningen av förråd där det finns en gren för vår uppgift (för att förenkla sökningen matchar grenens namn uppgiftsnumret i Jira). Vanligtvis har uppgiften bara en gren i ett förråd, vilket förenklar hanteringen av kö för deploy och minskar kopplingen mellan förråden.
- För varje hittad gren utförs följande sekvens av åtgärder:
i) Slå samman med master-grenen (Git-mikrotjänst för att arbeta med koden).
ii) Grenen blockeras från förändringar av utvecklaren (Bitbucket-mikrotjänst).
iii) En Pull Request skapas för denna gren (Bitbucket-mikrotjänst).
iv) Ett meddelande om den nya Pull Request skickas till utvecklarchattarna (Notify-mikrotjänst för att arbeta med meddelanden).
v) Byggnationen, testningen och deployeringen av uppgiften på DEV startas (Jenkins-mikrotjänst för att arbeta med Jenkins).
vi) Om alla tidigare punkter avslutas framgångsrikt, sätter Integro sitt godkännande i Pull Request (Bitbucket-mikrotjänst). - Integro väntar på godkännande i Pull Request från de tilldelade granskare.
- Så snart alla nödvändiga godkännanden har erhållits (inklusive positiva resultat från automatiserade tester), flyttar Integro uppgiften till statusen Test on Dev (Jira-mikrotjänst).
6. Testare utför tester av uppgiften. Om det inte finns några problem, flyttas uppgiften till statusen Ready For Build.
7. Integro "ser" att uppgiften är redo för release och startar dess deployment i kanarietillstånd (Jenkins-mikrotjänst). Beredskapen för release bestäms av en uppsättning regler. Till exempel, uppgiften är i rätt status, inga blockerande uppgifter finns, inga aktiva utrullningar av denna mikrotjänst just nu, osv.
8. Uppgiften flyttas till statusen Canary (Jira-mikrotjänst).
9. Jenkins startar deployment av uppgiften i kanarietillstånd via Nomad (vanligtvis 1-3 instanser) och meddelar release-monitoreringstjänsten (DeployWatch-mikrotjänst) om utrullningen.
10. DeployWatch-mikrotjänst samlar in felbakgrund och reagerar på den om nödvändigt. Om felbakgrunden överskrids (normalt bakgrund beräknas automatiskt) informeras utvecklarna genom Notify-mikrotjänst. Om utvecklaren inte har reagerat inom 5 minuter (tryckt Revert eller Stay) startas en automatisk återställning av kanarien instanser. Om bakgrunden inte överskrids, måste utvecklaren manuellt starta deployment av uppgiften på Production (genom att trycka på knappen i UI). Om utvecklaren inte har startat deployment på Production inom 60 minuter, kommer kanarien instanser även av säkerhetsskäl att tas bort.
11. Efter att deployments har startats på Production:
- Uppgiften flyttas till statusen Production (Jira-mikrotjänst).
- Jenkins-mikrotjänst startar deploymentsprocessen och meddelar DeployWatch-mikrotjänst om utrullningen.
- DeployWatch-mikrotjänst kontrollerar att alla containrar på Production har uppdaterats (det har funnits fall där inte allt har uppdaterats).
- Genom Notify-mikrotjänst skickas en avisering om resultaten av deployment på Production.
12. Utvecklarna har 30 minuter på sig att initiera återställning av uppgiften från Production vid upptäckten av felaktigt beteende hos mikrotjänsten. Efter denna tid kommer uppgiften automatiskt att slås samman i master (Git-mikrotjänst).
13. Efter en lyckad merge i master kommer uppgiftens status att ändras till Closed (Jira-mikrotjänst).
Schemat påstår inte att vara heltäckande (i verkligheten finns det fler steg), men det möjliggör en bedömning av integrationsgraden i processerna. Vi anser inte att detta schema är perfekt och förbättrar processerna för automatisk hantering av releaser och deployment.
Vad händer härnäst
Vi har stora planer för att utveckla automatisering, som att överge manuella operationer vid releaser av monoliter, förbättra övervakningen vid automatisk distribution och förbättra samarbetet med utvecklarna.
Men vi stannar här för nu. Vi har berört många ämnen i vår översikt över automatisering ytligt, och vissa har vi helt missat, så vi svarar gärna på frågor. Vi ser fram emot förslag på vad vi ska belysa mer ingående, skriv gärna i kommentarerna.
Källa: habr.com
