

, avsedd för insamling, omvandling och sändning av loggdata, mätvärden och händelser.
→
Skriven i Rust, kännetecknas den av hög prestanda och låg minnesförbrukning jämfört med liknande verktyg. Dessutom läggs stor vikt vid funktioner relaterade till korrekthet, särskilt möjligheterna att spara oanvända händelser i en buffert på disken och loggfiler rotation.
Arkitektoniskt är Vektor en händelse-router som tar emot meddelanden från ett eller flera källor, tillval som tillämpar transformationer på dessa meddelanden och skickar dem till en eller fleramottagare Vector är en ersättning för filebeat och logstash, den kan fungera i båda rollerna (ta emot och sända loggar), mer detaljerat om deras.
Om i Logstash byggs kedjan som input → filter → output så är det i Vektor .
källor → →
Denna instruktion är en omarbetad version av
Vyacheslav Rakhinskys Aug 05 06:25:31.889 DEBUG transform{name=nginx_parse_rename_fields type=rename_fields}: vector::transforms::rename_fields: Fält fanns inte field=«geoip.country_name» rate_limit_secs=30
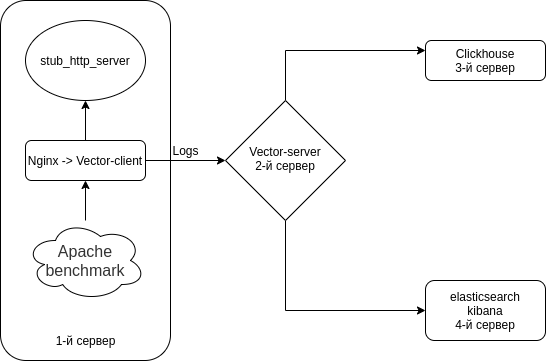
Om någon behöver bearbeta geoip, vänligen hänvisa till den ursprungliga instruktionen frånVi kommer att konfigurera kopplingen Nginx (Access logs) → Vector (Client | Filebeat) → Vector (Server | Logstash) → separat till Clickhouse och separat till Elasticsearch. Vi installerar 4 servrar. Även om det kan göras med 3 servrar. .
Schemat ser ungefär ut som följer.
Vi stänger av Selinux på alla dina servrar
sed -i 's/^SELINUX=.*$/SELINUX=disabled/g' /etc/selinux/config reboot
Vi installerar en HTTP-server emulator + verktyg på alla servrarNodejs-stub-server har ingen rpm.
Som HTTP server emulator kommer vi att använda från
Vi lägger till repositoriet antonpatsev/nodejs-stub-server skapar vi en rpm för den. RPM kommer att byggas med hjälp av
yum -y install yum-plugin-copr epel-release yes | yum copr enable antonpatsev/nodejs-stub-server
Vi installerar nodejs-stub-server, Apache benchmark och terminal-multiplexer screen på alla servraryum -y install stub_http_server screen mc httpd-tools screen
Jag har justerat svarstiden för stub_http_server i filen /var/lib/stub_http_server/stub_http_server.js för att få fler loggar.var max_sleep = 10;
Vi startar stub_http_server.systemctl start stub_http_server systemctl enable stub_http_server
Installation av ClickhouseClickHouse använder ett uppsättning instruktioner SSE 4.2, så om inget annat anges blir dess stöd i den använda processorn ett ytterligare systemkrav. Här är kommandot för att kontrollera om den aktuella processorn stöder SSE 4.2:
ClickHouse använder en uppsättning instruktioner från SSE 4.2, så om inget annat anges blir dess stöd i den använda processorn ett ytterligare systemkrav. Här är kommandot för att kontrollera om den aktuella processorn stödjer SSE 4.2:
grep -q sse4_2 /proc/cpuinfo && echo "SSE 4.2 stöds" || echo "SSE 4.2 stöds inte"Först måste du ansluta det officiella arkivet:
sudo yum install -y yum-utils
sudo rpm --import https://repo.clickhouse.tech/CLICKHOUSE-KEY.GPG
sudo yum-config-manager --add-repo https://repo.clickhouse.tech/rpm/stable/x86_64
För att installera paketen måste du köra följande kommandon:
sudo yum install -y clickhouse-server clickhouse-clientVi tillåter clickhouse-server att lyssna på nätverkskortet i filen /etc/clickhouse-server/config.xml
0.0.0.0Vi ändrar loggnivån från trace till debug
debug
Standardkomprimeringsinställningarna är:
min_compress_block_size  65536
max_compress_block_size  1048576
För att aktivera Zstd-komprimering rekommenderas det att inte röra konfigurationen, utan hellre använda DDL.
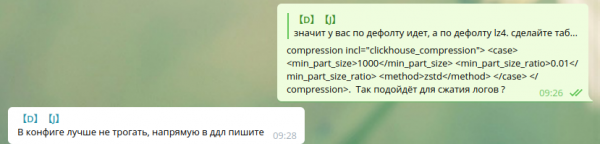
Hur man tillämpar zstd-komprimering via DDL kunde jag inte hitta på Google. Därför lämnade jag det som det är.
Kollegor, som använder zstd-komprimering i Clickhouse — kan ni dela med er av instruktionerna, tack.
För att köra servern som en demon, kör:
service clickhouse-server startNu går vi vidare till att konfigurera Clickhouse
Vi loggar in i Clickhouse
clickhouse-client -h 172.26.10.109 -m172.26.10.109 — IP-adressen för servern där Clickhouse är installerat.
Vi skapar databasen vector
CREATE DATABASE vector;Vi kontrollerar att databasen finns.
show databases;Vi skapar tabellen vector.logs.
/* Это таблица где хранятся логи как есть */

CREATE TABLE vector.logs
(
    `node_name` String,
    `timestamp` DateTime,
    `server_name` String,
    `user_id` String,
    `request_full` String,
    `request_user_agent` String,
    `request_http_host` String,
    `request_uri` String,
    `request_scheme` String,
    `request_method` String,
    `request_length` UInt64,
    `request_time` Float32,
    `request_referrer` String,
    `response_status` UInt16,
    `response_body_bytes_sent` UInt64,
    `response_content_type` String,
    `remote_addr` IPv4,
    `remote_port` UInt32,
    `remote_user` String,
    `upstream_addr` IPv4,
    `upstream_port` UInt32,
    `upstream_bytes_received` UInt64,
    `upstream_bytes_sent` UInt64,
    `upstream_cache_status` String,
    `upstream_connect_time` Float32,
    `upstream_header_time` Float32,
    `upstream_response_length` UInt64,
    `upstream_response_time` Float32,
    `upstream_status` UInt16,
    `upstream_content_type` String,
    INDEX idx_http_host request_http_host TYPE set(0) GRANULARITY 1
)
ENGINE = MergeTree()
PARTITION BY toYYYYMMDD(timestamp)
ORDER BY timestamp
TTL timestamp + toIntervalMonth(1)
SETTINGS index_granularity = 8192;
Vi kontrollerar att tabellerna skapades. Vi kör clickhouse-client och gör en förfrågan.
Vi går till databasen vector.
use vector;

Ok.

0 rows in set. Elapsed: 0.001 sec.
Vi tittar på tabellerna.
show tables;

┌─name────────────────┐
│ logs                │
└─────────────────────┘
Installation av Elasticsearch på den fjärde servern för att skicka samma data till Elasticsearch för jämförelse med Clickhouse
Vi lägger till den offentliga rpm-nyckeln
rpm --import https://artifacts.elastic.co/GPG-KEY-elasticsearchVi skapar 2 arkiv:
/etc/yum.repos.d/elasticsearch.repo
[elasticsearch]
name=Elasticsearch repository for 7.x packages
baseurl=https://artifacts.elastic.co/packages/7.x/yum
gpgcheck=1
gpgkey=https://artifacts.elastic.co/GPG-KEY-elasticsearch
enabled=0
autorefresh=1
type=rpm-md
/etc/yum.repos.d/kibana.repo
[kibana-7.x]
name=Kibana repository for 7.x packages
baseurl=https://artifacts.elastic.co/packages/7.x/yum
gpgcheck=1
gpgkey=https://artifacts.elastic.co/GPG-KEY-elasticsearch
enabled=1
autorefresh=1
type=rpm-md
Vi installerar Elasticsearch och Kibana
yum install -y kibana elasticsearchEftersom det kommer att vara i ett exemplar, måste vi lägga till följande i filen /etc/elasticsearch/elasticsearch.yml:
discovery.type: single-nodeFör att vektorn ska kunna skicka data till Elasticsearch från en annan server ändrar vi network.host.
network.host: 0.0.0.0För att ansluta till Kibana ändrar vi server.host-parametern i filen /etc/kibana/kibana.yml
server.host: "0.0.0.0"Vi startar och aktiverar Elasticsearch för autostart
systemctl enable elasticsearch
systemctl start elasticsearch
och Kibana
systemctl enable kibana
systemctl start kibana
Konfiguration av Elasticsearch för single-node-läge 1 shard, 0 replika. Troligtvis har ni ett kluster av en stor mängd servrar och ni behöver inte göra detta.
För framtida index uppdaterar vi standardmallen:
curl -X PUT http://localhost:9200/_template/default -H 'Content-Type: application/json' -d '{"index_patterns": ["*"],"order": -1,"settings": {"number_of_shards": "1","number_of_replicas": "0"}}' Installation som en ersättning för Logstash på server 2
yum install -y https://packages.timber.io/vector/0.9.X/vector-x86_64.rpm mc httpd-tools screenVi konfigurerar Vector som ersättning för Logstash. Redigera filen /etc/vector/vector.toml
# /etc/vector/vector.toml

data_dir = "/var/lib/vector"

[sources.nginx_input_vector]
  # General
  type                          = "vector"
  address                       = "0.0.0.0:9876"
  shutdown_timeout_secs         = 30

[transforms.nginx_parse_json]
  inputs                        = [ "nginx_input_vector" ]
  type                          = "json_parser"

[transforms.nginx_parse_add_defaults]
  inputs                        = [ "nginx_parse_json" ]
  type                          = "lua"
  version                       = "2"

  hooks.process = """
  function (event, emit)

    function split_first(s, delimiter)
      result = {};
      for match in (s..delimiter):gmatch("(.-)"..delimiter) do
          table.insert(result, match);
      end
      return result[1];
    end

    function split_last(s, delimiter)
      result = {};
      for match in (s..delimiter):gmatch("(.-)"..delimiter) do
          table.insert(result, match);
      end
      return result[#result];
    end

    event.log.upstream_addr             = split_first(split_last(event.log.upstream_addr, ', '), ':')
    event.log.upstream_bytes_received   = split_last(event.log.upstream_bytes_received, ', ')
    event.log.upstream_bytes_sent       = split_last(event.log.upstream_bytes_sent, ', ')
    event.log.upstream_connect_time     = split_last(event.log.upstream_connect_time, ', ')
    event.log.upstream_header_time      = split_last(event.log.upstream_header_time, ', ')
    event.log.upstream_response_length  = split_last(event.log.upstream_response_length, ', ')
    event.log.upstream_response_time    = split_last(event.log.upstream_response_time, ', ')
    event.log.upstream_status           = split_last(event.log.upstream_status, ', ')

    if event.log.upstream_addr == "" then
        event.log.upstream_addr = "127.0.0.1"
    end

    if (event.log.upstream_bytes_received == "-" or event.log.upstream_bytes_received == "") then
        event.log.upstream_bytes_received = "0"
    end

    if (event.log.upstream_bytes_sent == "-" or event.log.upstream_bytes_sent == "") then
        event.log.upstream_bytes_sent = "0"
    end

    if event.log.upstream_cache_status == "" then
        event.log.upstream_cache_status = "DISABLED"
    end

    if (event.log.upstream_connect_time == "-" or event.log.upstream_connect_time == "") then
        event.log.upstream_connect_time = "0"
    end

    if (event.log.upstream_header_time == "-" or event.log.upstream_header_time == "") then
        event.log.upstream_header_time = "0"
    end

    if (event.log.upstream_response_length == "-" or event.log.upstream_response_length == "") then
        event.log.upstream_response_length = "0"
    end

    if (event.log.upstream_response_time == "-" or event.log.upstream_response_time == "") then
        event.log.upstream_response_time = "0"
    end

    if (event.log.upstream_status == "-" or event.log.upstream_status == "") then
        event.log.upstream_status = "0"
    end

    emit(event)

  end
  """

[transforms.nginx_parse_remove_fields]
    inputs                              = [ "nginx_parse_add_defaults" ]
    type                                = "remove_fields"
    fields                              = ["data", "file", "host", "source_type"]

[transforms.nginx_parse_coercer]

    type                                = "coercer"
    inputs                              = ["nginx_parse_remove_fields"]

    types.request_length = "int"
    types.request_time = "float"

    types.response_status = "int"
    types.response_body_bytes_sent = "int"

    types.remote_port = "int"

    types.upstream_bytes_received = "int"
    types.upstream_bytes_send = "int"
    types.upstream_connect_time = "float"
    types.upstream_header_time = "float"
    types.upstream_response_length = "int"
    types.upstream_response_time = "float"
    types.upstream_status = "int"

    types.timestamp = "timestamp"

[sinks.nginx_output_clickhouse]
    inputs   = ["nginx_parse_coercer"]
    type     = "clickhouse"

    database = "vector"
    healthcheck = true
    host = "http://172.26.10.109:8123" #  Адрес Clickhouse
    table = "logs"

    encoding.timestamp_format = "unix"

    buffer.type = "disk"
    buffer.max_size = 104900000
    buffer.when_full = "block"

    request.in_flight_limit = 20

[sinks.elasticsearch]
    type = "elasticsearch"
    inputs   = ["nginx_parse_coercer"]
    compression = "none"
    healthcheck = true
    # 172.26.10.116 - сервер где установен elasticsearch
    host = "http://172.26.10.116:9200"
    index = "vector-%Y-%m-%d"
Du kan justera sektionen transforms.nginx_parse_add_defaults.
Eftersom använder dessa konfigurationer för en liten CDN och där i upstream_* kan flera värden komma.
Till exempel:
"upstream_addr": "128.66.0.10:443, 128.66.0.11:443, 128.66.0.12:443"
"upstream_bytes_received": "-, -, 123"
"upstream_status": "502, 502, 200"
Om detta inte är din situation kan den här sektionen förenklas.
Skapa serviceinställningar för systemd /etc/systemd/system/vector.service
# /etc/systemd/system/vector.service

[Unit]
Description=Vector
After=network-online.target
Requires=network-online.target

[Service]
User=vector
Group=vector
ExecStart=/usr/bin/vector
ExecReload=/bin/kill -HUP $MAINPID
Restart=no
StandardOutput=syslog
StandardError=syslog
SyslogIdentifier=vector

[Install]
WantedBy=multi-user.target
Efter att ha skapat tabellerna kan vi starta Vector.
systemctl enable vector
systemctl start vector
Loggar för vector kan ses så här
journalctl -f -u vectorLoggarna bör innehålla följande poster
INFO vector::topology::builder: Healthcheck: Passed.
INFO vector::topology::builder: Healthcheck: Passed.
På klienten (Web server) — server 1
På servern med nginx måste ipv6 stängas av, eftersom fältet i tabellen logs i clickhouse använder upstream_addr IPv4, eftersom jag inte använder ipv6 inuti nätverket. Om ipv6 inte stängs av, kommer det att uppstå fel:
DB::Exception: Invalid IPv4 value.: (while read the value of key upstream_addr)Möjligtvis läsarna, lägga till stöd för ipv6.
Skapa filen /etc/sysctl.d/98-disable-ipv6.conf
net.ipv6.conf.all.disable_ipv6 = 1
net.ipv6.conf.default.disable_ipv6 = 1
net.ipv6.conf.lo.disable_ipv6 = 1
Tillämpa inställningarna
sysctl --systemInstallera nginx.
Lägg till nginx-repo-filen /etc/yum.repos.d/nginx.repo
[nginx-stable]
name=nginx stable repo
baseurl=http://nginx.org/packages/centos/$releasever/$basearch/
gpgcheck=1
enabled=1
gpgkey=https://nginx.org/keys/nginx_signing.key
module_hotfixes=true
Installera nginx-paketet
yum install -y nginxFörst måste vi konfigurera loggformatet i Nginx i filen /etc/nginx/nginx.conf
user nginx;
# du måste ställa in arbetsprocesserna baserat på dina CPU-kärnor, nginx drar inte nytta av att ställa in fler än så
worker_processes auto; # vissa senaste versioner beräknar det automatiskt

# antal filbeskrivare som används för nginx
# gränsen för maximala FD:er på servern sätts vanligtvis av OS.
# om du inte ställer in FD:er används OS-inställningarna som som standard är 2000
worker_rlimit_nofile 100000;

error_log  /var/log/nginx/error.log warn;
pid        /var/run/nginx.pid;

# tillhandahåller konfigurationsfilens kontext där direktiven som påverkar anslutningsbehandling anges.
events {
    # avgör hur många kunder som serveras per arbetare
    # max kunder = worker_connections * worker_processes
    # max kunder begränsas också av antalet socketanslutningar som finns tillgängliga på systemet (~64k)
    worker_connections 4000;

    # optimerad för att servera många kunder med varje tråd, avgörande för linux -- för testmiljö
    use epoll;

    # acceptera så många anslutningar som möjligt, kan överbelasta arbetsanslutningar om det är inställt för lågt -- för testmiljö
    multi_accept on;
}

http {
    include       /etc/nginx/mime.types;
    default_type  application/octet-stream;

    log_format  main  '$remote_addr - $remote_user [$time_local] "$request" '
                      '$status $body_bytes_sent "$http_referer" '
                      '"$http_user_agent" "$http_x_forwarded_for"';

log_format vector escape=json
    '{'
        '"node_name":"nginx-vector",'
        '"timestamp":"$time_iso8601",'
        '"server_name":"$server_name",'
        '"request_full": "$request",'
        '"request_user_agent":"$http_user_agent",'
        '"request_http_host":"$http_host",'
        '"request_uri":"$request_uri",'
        '"request_scheme": "$scheme",'
        '"request_method":"$request_method",'
        '"request_length":"$request_length",'
        '"request_time": "$request_time",'
        '"request_referrer":"$http_referer",'
        '"response_status": "$status",'
        '"response_body_bytes_sent":"$body_bytes_sent",'
        '"response_content_type":"$sent_http_content_type",'
        '"remote_addr": "$remote_addr",'
        '"remote_port": "$remote_port",'
        '"remote_user": "$remote_user",'
        '"upstream_addr": "$upstream_addr",'
        '"upstream_bytes_received": "$upstream_bytes_received",'
        '"upstream_bytes_sent": "$upstream_bytes_sent",'
        '"upstream_cache_status":"$upstream_cache_status",'
        '"upstream_connect_time":"$upstream_connect_time",'
        '"upstream_header_time":"$upstream_header_time",'
        '"upstream_response_length":"$upstream_response_length",'
        '"upstream_response_time":"$upstream_response_time",'
        '"upstream_status": "$upstream_status",'
        '"upstream_content_type":"$upstream_http_content_type"'
    '}';

    access_log  /var/log/nginx/access.log  main;
    access_log  /var/log/nginx/access.json.log vector;      # Ny logg i json-format

    sendfile        on;
    #tcp_nopush     on;

    keepalive_timeout  65;

    #gzip  on;

    include /etc/nginx/conf.d/*.conf;
}
För att inte förstöra din nuvarande konfiguration tillåter Nginx flera direktiv för access_log
access_log  /var/log/nginx/access.log  main;            # Standardlogg
access_log  /var/log/nginx/access.json.log vector;      # Ny logg i json-format
Tveka inte att lägga till en regel i logrotate för de nya loggarna (om loggfilen inte slutar på .log)
Ta bort default.conf från /etc/nginx/conf.d/
rm -f /etc/nginx/conf.d/default.confLägg till en virtuell värd i /etc/nginx/conf.d/vhost1.conf
server {
    listen 80;
    server_name vhost1;
    location / {
        proxy_pass http://172.26.10.106:8080;
    }
}
Lägg till en virtuell värd /etc/nginx/conf.d/vhost2.conf
server {
    listen 80;
    server_name vhost2;
    location / {
        proxy_pass http://172.26.10.108:8080;
    }
}
Lägg till en virtuell värd /etc/nginx/conf.d/vhost3.conf
server {
    listen 80;
    server_name vhost3;
    location / {
        proxy_pass http://172.26.10.109:8080;
    }
}
Lägg till en virtuell värd /etc/nginx/conf.d/vhost4.conf
server {
    listen 80;
    server_name vhost4;
    location / {
        proxy_pass http://172.26.10.116:8080;
    }
}
Lägg till virtuella värdar i filen /etc/hosts (172.26.10.106 är IP-adressen för servern där nginx är installerad) på alla servrar:
172.26.10.106 vhost1
172.26.10.106 vhost2
172.26.10.106 vhost3
172.26.10.106 vhost4
Och om allt är klart,
nginx -t
systemctl restart nginx
Nu installerar vi själva
yum install -y https://packages.timber.io/vector/0.9.X/vector-x86_64.rpmSkapa en konfigurationsfil för systemd /etc/systemd/system/vector.service
[Unit]
Description=Vector
After=network-online.target
Requires=network-online.target

[Service]
User=vector
Group=vector
ExecStart=/usr/bin/vector
ExecReload=/bin/kill -HUP $MAINPID
Restart=no
StandardOutput=syslog
StandardError=syslog
SyslogIdentifier=vector

[Install]
WantedBy=multi-user.target
Och konfigurera ersättning av Filebeat i konfigurationsfilen /etc/vector/vector.toml. IP-adressen 172.26.10.108 är IP-adressen för loggservern (Vector-Server)
data_dir = "/var/lib/vector"

[sources.nginx_file]
  type                          = "file"
  include                       = [ "/var/log/nginx/access.json.log" ]
  start_at_beginning            = false
  fingerprinting.strategy       = "device_and_inode"

[sinks.nginx_output_vector]
  type                          = "vector"
  inputs                        = [ "nginx_file" ]

  address                       = "172.26.10.108:9876"
Glöm inte att lägga till användaren vector i rätt grupp så att den kan läsa loggfiler. Till exempel skapar nginx i centos loggar med behörigheten för gruppen adm.
usermod -a -G adm vectorStarta vector-tjänsten
systemctl enable vector
systemctl start vector
Loggar för vector kan ses så här
journalctl -f -u vectorDet ska finnas en sådan post i loggarna
INFO vector::topology::builder: Healthcheck: Passed.Belastningstestning
Testningen utförs med hjälp av Apache benchmark.
Paketet httpd-tools har installerats på alla servrar
Vi testar med Apache benchmark från 4 olika servrar i screen. Först startar vi terminalmultiplexern screen och sedan utför vi testning med Apache benchmark. Hur man arbetar med screen kan du hitta i .
Från den första servern
while true; do ab -H "User-Agent: 1server" -c 100 -n 10 -t 10 http://vhost1/; sleep 1; doneFrån den andra servern
while true; do ab -H "User-Agent: 2server" -c 100 -n 10 -t 10 http://vhost2/; sleep 1; doneFrån den tredje servern
while true; do ab -H "User-Agent: 3server" -c 100 -n 10 -t 10 http://vhost3/; sleep 1; doneFrån den fjärde servern
while true; do ab -H "User-Agent: 4server" -c 100 -n 10 -t 10 http://vhost4/; sleep 1; doneVi kontrollerar data i Clickhouse
Vi loggar in i Clickhouse
clickhouse-client -h 172.26.10.109 -mGör en SQL-fråga
VÄLJ * FRÅN vector.logs;

┌─node_name────┬───────────timestamp─┬─server_name─┬─user_id─┬─request_full───┬─request_user_agent─┬─request_http_host─┬─request_uri─┬─request_scheme─┬─request_method─┬─request_length─┬─request_time─┬─request_referrer─┬─response_status─┬─response_body_bytes_sent─┬─response_content_type─┬───remote_addr─┬─remote_port─┬─remote_user─┬─upstream_addr─┬─upstream_port─┬─upstream_bytes_received─┬─upstream_bytes_sent─┬─upstream_cache_status─┬─upstream_connect_time─┬─upstream_header_time─┬─upstream_response_length─┬─upstream_response_time─┬─upstream_status─┬─upstream_content_type─┐
│ nginx-vector │ 2020-08-07 04:32:42 │ vhost1      │         │ GET \/ HTTP\/1.0 │ 1server            │ vhost1            │ \/           │ http           │ GET            │             66 │        0.028 │                  │             404 │                       27 │                       │ 172.26.10.106 │       45886 │             │ 172.26.10.106 │             0 │                     109 │                  97 │ DISABLED              │                     0 │                0.025 │                       27 │                  0.029 │             404 │                       │
└──────────────┴─────────────────────┴─────────────┴─────────┴────────────────┴────────────────────┴───────────────────┴─────────────┴────────────────┴────────────────┴────────────────┴──────────────┴──────────────────┴─────────────────┴──────────────────────────┴───────────────────────┴───────────────┴─────────────┴─────────────┴───────────────┴───────────────┴─────────────────────────┴─────────────────────┴───────────────────────┴───────────────────────┴──────────────────────┴──────────────────────────┴────────────────────────┴─────────────────┴───────────────────────
Vi får reda på storleken på tabeller i Clickhouse
välj concat(database, '.', table)                         som table,
       formatReadableSize(sum(bytes))                       som size,
       sum(rows)                                            som rows,
       max(modification_time)                               som latest_modification,
       sum(bytes)                                           som bytes_size,
       any(engine)                                          som engine,
       formatReadableSize(sum(primary_key_bytes_in_memory)) som primary_keys_size
från system.parts
där aktiv
grupp efter database, table
ordna efter bytes_size desc;
Vi får reda på hur mycket loggarna har tagit i Clickhouse.
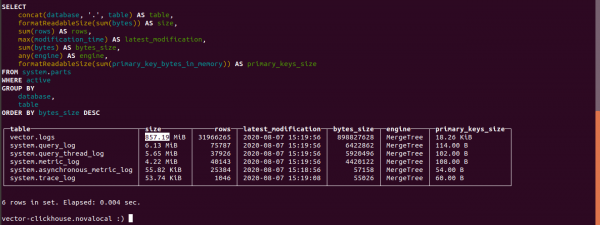
Storleken på tabellen logs är 857,19 MB.
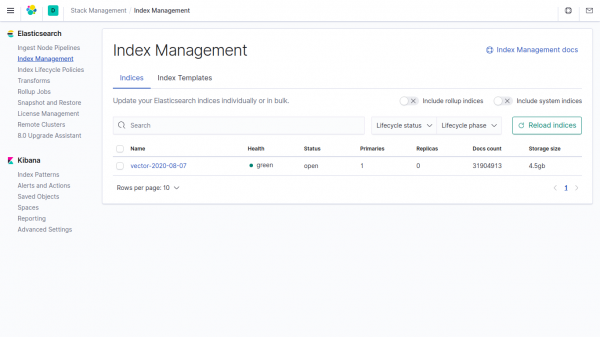
Storleken på samma data i indexet i Elasticsearch upptar 4,5 GB.
Om man inte anger vektorn i parametrarna i Clickhouse tar datan upp 4500/857,19 = 5,24 gånger mindre än i Elasticsearch.
I vektorfältet används komprimering som standard.
Telegram-grupp om
Telegram-grupp om
Telegram-grupp om ""
Källa: habr.com
