

Hur man läser den här artikeln: jag ber om ursäkt för att texten blev så lång och rörig. För att spara er tid inleder jag varje kapitel med en introduktion "Vad jag har lärt mig", där jag i en eller två meningar sammanfattar kapitlets kärna.
"Visa bara lösningen!" Om du bara vill se vad jag kom fram till, gå till kapitlet "Bli mer uppfinningsrik", men jag anser att det är mer intressant och nyttigt att läsa om misslyckanden.
Nyligen fick jag i uppdrag att ställa in en process för att hantera en stor volym av ursprungliga DNA-sekvenser (tekniskt sett är detta en SNP-chip). Jag behövde snabbt få data om en given genetisk position (som kallas SNP) för efterföljande modellering och andra uppgifter. Med hjälp av R och AWK lyckades jag rengöra och organisera data på ett naturligt sätt, vilket avsevärt ökade hastigheten på förfrågningarna. Det var inte lätt och krävde många iterationer. Den här artikeln kommer att hjälpa dig att undvika några av mina misstag och visa vad jag faktiskt åstadkom.
Först några inledande förklaringar.
Data
Vårt universitets centrum för bearbetning av genetisk information gav oss data i TSV-format på 25 TB. Jag fick dem uppdelade i 5 paket, komprimerade med Gzip, där varje paket innehöll cirka 240 fyragigabytesfiler. Varje rad innehöll data för en SNP för en person. Totalt överfördes data för ~2,5 miljoner SNP och ~60 000 personer. Utöver SNP-information fanns det många kolumner med siffror som återspeglade olika egenskaper, såsom läshastighet, frekvens av olika alleler, och så vidare. Totalt fanns det cirka 30 kolumner med unika värden.
Syftet
Som i alla datastyrningsprojekt var det viktigaste att bestämma hur data skulle användas. I det här fallet kommer vi huvudsakligen att anpassa modeller och arbetsflöden för SNP baserat på SNP. Så vi kommer samtidigt bara att behöva data för en enda SNP. Jag måste lära mig att så enkelt, snabbt och billigt som möjligt extrahera alla poster som rör en av 2,5 miljoner SNP.
Hur man inte gör detta
Jag citerar ett passande klyscha:
Jag har inte misslyckats tusen gånger, jag har bara upptäckt tusen sätt att inte parsa en mängd data i ett begärligt format.
Första försöket
Vad jag har lärt mig: det finns inget billigt sätt att parsa 25 TB på en gång.
När jag lyssnade på kursen 'Avancerade metoder för storskalig databehandling' vid Vanderbilt University, var jag säker på att det skulle ordna sig. Kanske tar det en till två timmar att ställa in Hive-servern för att bearbeta all data och rapportera resultatet. Eftersom våra data lagras i AWS S3 använde jag tjänsten , som gör att man kan köra Hive SQL-frågor på S3-data. Man behöver inte ställa in/starta ett Hive-kluster och betalar bara för den data man söker.
När jag visade Athena mina data och deras format körde jag några tester med liknande frågor:
select * from intensityData limit 10;Och fick snabbt välstrukturerade resultat. Klart.
Tills vi försökte använda data i arbetet…
Jag blev ombedd att hämta all information om SNP för att testa modellen. Jag körde frågan:
select * from intensityData
where snp = 'rs123456';
…och började vänta. Efter åtta minuter och mer än 4 TB begärd data fick jag resultatet. Athena debiterar för den mängd data som hittas, $5 per terabyte. Så denna enda fråga kostade $20 och åtta minuters väntan. För att köra modellen på all data skulle det ta 38 år och kosta $50 miljoner. Uppenbart var det inte optimalt för oss.
Vi behövde använda Parquet...
Vad jag har lärt mig: var försiktig med storleken på dina Parquet-filer och deras organisation.
Först försökte jag fixa situationen genom att konvertera alla TSV till De är praktiska för att arbeta med stora datamängder eftersom informationen lagras i kolumnformat: varje kolumn ligger i en egen segment av minnet/disken, till skillnad från textfiler där raderna innehåller element från varje kolumn. Och om man behöver hitta något, räcker det att läsa den nödvändiga kolumnen. Dessutom innehåller varje fil i kolumnen ett värdeområde, så om det sökta värdet inte finns inom kolumnens område, kommer Spark inte att slösa tid på att skanna hela filen.
Jag körde en enkel uppgift För att konvertera våra TSV-filer till Parquet och ladda upp nya filer till Athena tog det ungefär 5 timmar. Men när jag körde frågan tog det ungefär lika lång tid och kostade lite mindre. Problemet är att Spark, i syfte att optimera uppgiften, helt enkelt packade upp en TSV-chunk och placerade den i sin egen Parquet-chunk. Eftersom varje chunk var tillräckligt stor och innehöll kompletta poster för många personer, fanns alla SNP i varje fil, så Spark behövde öppna alla filer för att extrahera den nödvändiga informationen.
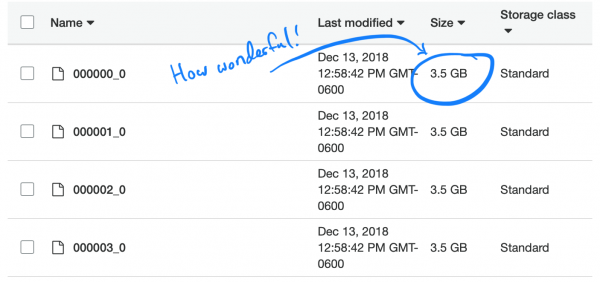
Det är intressant att den standard (och rekommenderade) komprimeringstypen i Parquet — snappy — inte är delbar (splitable). Därför fastnade varje executor i uppgiften att packa upp och ladda det kompletta datasetet på 3,5 GB.
Vi utreder problemet
Vad jag har lärt mig: att sortera är svårt, särskilt när datan är fördelad.
Jag trodde att jag nu förstod kärnan i problemet. Jag behövde bara sortera datan efter kolumnen SNP, inte efter personer. Då skulle flera SNP lagras i en separat chunk av data, och då skulle Parquets 'intelligenta' funktion att 'öppna endast om värdet finns inom intervallet' verkligen träda fram. Tyvärr visade det sig vara en svår uppgift att sortera miljarder rader spridda över klustret.
Jag som tar en algoritmklass på universitetet: «Usch, ingen bryr sig om den beräkningsmässiga komplexiteten av alla dessa sorteringsalgoritmer»
Jag försöker sortera en kolumn i en 20TB tabell: «Varför tar det här så lång tid?» kampen.
— Nick Strayer (@NicholasStrayer)
AWS vill definitivt inte återbetala pengarna med argumentet 'Jag är en disträ student'. Efter att jag körde sorteringen på Amazon Glue arbetade den i 2 dagar och avslutades med ett fel.
Vad sägs om partitionering?
Vad jag har lärt mig: partitioner i Spark måste vara balanserade.
Sedan kom jag på idén att partitionera datan i kromosomer. Det finns 23 stycken (plus några om man räknar med mitokondriell DNA och icke-kodade områden).
Detta skulle göra det möjligt att dela upp datan i mindre portioner. Om jag lägger till en rad i Spark-funktionen för export i Glue-skriptet partition_by = "chr", så bör datan delas upp i buckets.
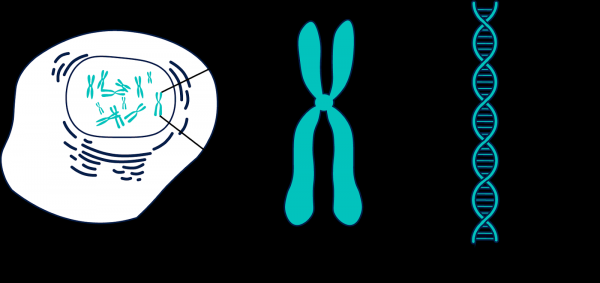
Genomet består av många fragment som kallas kromosomer.
Tyvärr fungerade det inte. Kromosomer har olika storlekar, vilket innebär att de också har olika mängder information. Det betyder att uppgifterna som Spark skickade till arbetarna inte var balanserade och utfördes långsamt, eftersom vissa noder avslutade tidigare och blev inaktiva. Men uppgifterna genomfördes. Men när jag begärde en SNP blev obalansen återigen ett problem. Kostnaden för att bearbeta SNP i större kromosomer (där vi vill hämta data) minskade bara med ungefär 10 gånger. Mycket, men inte tillräckligt.
Vad händer om vi delar upp i ännu mindre partitioner?
Vad jag har lärt mig: Försök aldrig göra 2,5 miljoner partitioner.
Jag bestämde mig för att överdriva och partitionerade varje SNP. Detta garanterade lika stora partitioner. DET VAR EN DÅLIG IDÉ. Jag använde Glue och la till en oskyldig rad partition_by = 'snp'. Uppgiften startade och började köras. En dag senare kontrollerade jag och såg att ingenting hade skrivits till S3, så jag dödade uppgiften. Det verkar som om Glue skrev mellanliggande filer på en dold plats i S3, och många filer, kanske flera miljoner. Som resultat kostade mitt misstag mer än tusen dollar och glädjde inte min handledare.
Partitionering + sortering
Vad jag har lärt mig: Att sortera är fortfarande svårt, liksom att konfigurera Spark.
Den sista partitioneringsförsöket innebar att jag partitionerade kromosomerna och sedan sorterade varje partition. I teorin skulle detta snabba upp varje begäran, eftersom de önskade data om SNP skulle befinna sig inom några Parquet-schunkar inom det angivna intervallet. Tyvärr visade det sig vara svårt att sortera även partitionerade data. Som ett resultat gick jag över till EMR för att skapa en anpassad kluster och använde åtta kraftfulla instanser (C5.4xl) och Sparklyr för att skapa ett mer flexibelt arbetsflöde…
# Sparklyr snippet to partition by chr and sort w/in partition
# Join the raw data with the snp bins
raw_data
  group_by(chr) %>%
  arrange(Position) %>%
  Spark_write_Parquet(
    path = DUMP_LOC,
    mode = 'overwrite',
    partition_by = c('chr')
  )
…men uppgiften blev ändå inte slutförd. Jag justerade på alla möjliga sätt: ökade minnesallokeringen för varje fråga-exekverare, använde noder med större minneskapacitet, applicerade sändningsvariabler, men varje gång var det halvmått, och så småningom började exekverare att krascha tills allt stannade.
Uppdatering: så börjar det.
— Nick Strayer (@NicholasStrayer)
Jag blir mer påhittig
Vad jag har lärt mig: ibland kräver särskilda data särskilda lösningar.
Varje SNP har ett positionsvärde. Det här talet motsvarar antalet baser som ligger längs dess kromosom. Det är ett bra och naturligt sätt att organisera våra data. Först ville jag partitionera efter områden på varje kromosom. Till exempel positioner 1 – 2000, 2001 – 4000 osv. Men problemet är att SNP är ojämt fördelade över kromosomerna, så gruppstorlekarna kommer att variera kraftigt.
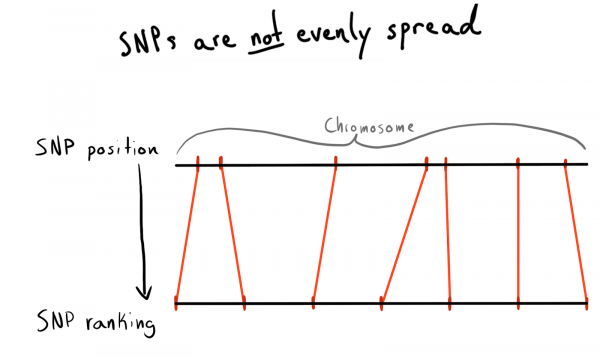
Som ett resultat kom jag fram till en uppdelning i kategori (rank) positioner. Med de redan inlästa uppgifterna körde jag en förfrågan för att få en lista över unika SNP, deras positioner och kromosomer. Jag sorterade sedan data inom varje kromosom och samlade SNP i grupper (bin) av en viss storlek. Låt oss säga, 1000 SNP. Detta gav mig en koppling mellan SNP och gruppen i kromosomen.
Till slut gjorde jag grupper (bin) av 75 SNP, vilket jag förklarar nedan.
snp_to_bin %
  group_by(chr) %>%
  arrange(position) %>%
  mutate(
    rank = 1:n()
    bin = floor(rank/snps_per_bin)
  ) %>%
  ungroup()
Första försöket med Spark
Vad jag har lärt mig: sammanslagning i Spark fungerar snabbt, men partitioneringen är fortfarande dyr.
Jag ville läsa in denna lilla (2,5 miljoner rader) dataram i Spark, slå ihop den med rådata och sedan partitionera den efter den nyligen tillagda kolumnen. bin.
# Join the raw data with the snp bins
data_w_bin <- raw_data %>%
  left_join(sdf_broadcast(snp_to_bin), by ='snp_name') %>%
  group_by(chr_bin) %>%
  arrange(Position) %>%
  Spark_write_Parquet(
    path = DUMP_LOC,
    mode = 'overwrite',
    partition_by = c('chr_bin')
  )
Jag använde sdf_broadcast(), så att Spark vet att han ska skicka dataramen till alla noder. Detta är användbart om data är av liten storlek och behövs för alla uppgifter. Annars försöker Spark vara smart och distribuerar data efter behov, vilket kan orsaka flaskhalsar.
Och återigen fungerade min plan inte: uppgifterna kördes ett tag, avslutade sammanslagningen, och sedan, precis som de partitionerade exekverarna, började de krascha.
Jag lägger till AWK
Vad jag har lärt mig: sov inte när du lär dig grunderna. Någon har säkert redan löst ditt problem på 1980-talet.
Fram till den här punkten har orsaken till alla mina misslyckanden med Spark varit oordning i klustret. Kanske kan situationen förbättras med hjälp av förbearbetning. Jag beslutade att försöka dela upp rådata i kromosomkolumner, så jag hoppades kunna ge Spark "förpartitionerade" data.
Jag sökte på StackOverflow hur man delar upp efter kolumnvärden och hittade Med AWK kan du dela en textfil baserat på kolumnvärden genom att göra en inskrivning i skriptet istället för att skicka resultaten till stdout.
För att testa skrev jag ett Bash-skript. Jag laddade ner en av de packade TSV-filerna och packade upp den med hjälp av gzip och skickade till awk.
gzip -dc path/to/chunk/file.gz |
awk -F 't'
'{print $1",..."$30" > "chunked/"$chr"_chr"$15".csv"}'
Det fungerade!
Kärnorna fylls
Vad jag har lärt mig: gnu parallel är en magisk grej, alla borde använda det.
Dela processen gick ganska långsamt, och när jag körde htop, för att kontrollera användningen av den kraftfulla (och dyra) EC2-instansen, visade det sig att jag använde endast en kärna och ungefär 200 Mb minne. För att lösa problemet och inte förlora en massa pengar behövde jag komma på hur man kan köra arbetet parallellt. Lyckligtvis i den helt fantastiska boken av Jeroen Janssens hittade jag ett kapitel som handlade om parallellisering. Där lärde jag mig om gnu parallel, en mycket flexibel metod för att implementera flertrådad bearbetning i Unix.
När jag körde delningen med hjälp av den nya processen var allt perfekt, men det fanns fortfarande en flaskhals – nedladdningen av S3-objekt till disken gick inte särskilt snabbt och var inte helt parallelliserad. För att åtgärda detta gjorde jag följande:
- Jag insåg att jag kan implementera S3-nedladdningssteget direkt i pipelinen, vilket helt utesluter mellanlagring på disken. Det betyder att jag kan undvika att skriva rådata till disken och använda en ännu mindre och därför billigare lagring på AWS.
- Kommandot
aws configure set default.s3.max_concurrent_requests 50ökade kraftigt antalet trådar som AWS CLI använder (som standard är det 10). - Gick över till en EC2-instans optimerad för nätverkshastighet, med bokstaven n i namnet. Jag upptäckte att beräkningskraftsförlusten när jag använde n-instanser kompenserades med råge av ökad nedladdningshastighet. För de flesta uppgifter använde jag c5n.4xl.
- Bytte ut
gziptill , ett gzip-verktyg som kan göra fantastiska saker för att parallellisera en ursprungligen icke-parallelliserad uppgift för att packa upp filer (detta hjälpte minst av allt).
# Let S3 use as many threads as it wants
aws configure set default.s3.max_concurrent_requests 50

for chunk_file in $(aws s3 ls $DATA_LOC | awk '{print $4}' | grep 'chr'$DESIRED_CHR'.csv') ; do

        aws s3 cp s3://$batch_loc$chunk_file - |
        pigz -dc |
        parallel --block 100M --pipe
        "awk -F 't' '{print $1",..."$30">"chunked/{#}_chr"$15".csv"}'"

       # Combine all the parallel process chunks to single files
        ls chunked/ |
        cut -d '_' -f 2 |
        sort -u |
        parallel 'cat chunked/*_{} | sort -k5 -n -S 80% -t, | aws s3 cp - '$s3_dest'/batch_'$batch_num'_{}'

         # Clean up intermediate data
       rm chunked/*
done
Dessa steg kombinerades med varandra så att allt fungerade väldigt snabbt. Tack vare den ökade nedladdningshastigheten och avskaffandet av skrivning på disken kunde jag nu bearbeta ett 5-terabyte paket på bara några timmar.
Det finns inget sötare än att se alla kärnor du betalar för på AWS användas. Tack vare gnu-parallel kan jag packa upp och dela en 19 gig CSV lika snabbt som jag kan ladda ner den. Jag kunde inte ens få spark att köras.
— Nick Strayer (@NicholasStrayer)
Den här tweeten skulle ha nämnt 'TSV'. Tyvärr.
Återanvändning av omparsat data
Vad jag har lärt mig: Spark älskar ocompressad data och ogillar att kombinera partitioner.
Nu låg datan i S3 i en icke-komprimerad (läs delad) och halvordnad format, och jag kunde återvända till Spark. Jag blev överraskad: jag kunde återigen inte få det att fungera som jag ville! Det var mycket svårt att berätta för Spark hur datan var partitionerad. Och även när jag gjorde det, visade det sig att det fanns för många partitioner (95 000), och när jag med hjälp av coalesce minskade antalet till rimliga gränser, förstörde det min partitionering. Jag är säker på att detta kan åtgärdas, men efter flera dagar av sökande kunde jag inte hitta en lösning. Till slut gjorde jag klart alla uppgifter i Spark, även om det tog lite tid, och mina delade Parquet-filer var inte så små (~200 kB). Men datan låg där den skulle.
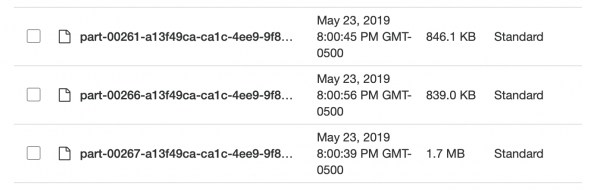
För små och olika, underbart!
Testa lokala Spark-förfrågningar
Vad jag har lärt mig: det är för mycket overhead i Spark för att lösa enkla uppgifter.
Efter att ha laddat upp data i ett genomtänkt format, kunde jag testa hastigheten. Jag ställde in ett skript i R för att köra en lokal Spark-server och laddade sedan in ett Spark-dataframe från det angivna Parquet-grupplagret (bin). Jag försökte ladda alla data, men kunde inte få Sparklyr att känna igen partitioneringen.
sc <- Spark_connect(master = "local")

desired_snp <- 'rs34771739'

# Starta en timer
start_time <- Sys.time()

# Ladda den önskade bin i Spark
intensity_data %
  Spark_read_Parquet(
    name = 'intensity_data',
    path = get_snp_location(desired_snp),
    memory = FALSE )

# Dela bin till snp och sedan samla in till lokalt
test_subset %
  filter(SNP_Name == desired_snp) %>%
  collect()

print(Sys.time() - start_time)
Exekveringen tog 29,415 sekunder. Mycket bättre, men inte tillräckligt bra för massatestning av något. Dessutom kunde jag inte snabba upp det med caching, för när jag försökte cacha dataframe i minnet, kraschade Spark alltid, även när jag tilldelade mer än 50 GB minne för en dataset som vägde mindre än 15.
Återvända till AWK
Vad jag har lärt mig: associativa arrayer i AWK är mycket effektiva.
Jag insåg att jag kunde uppnå högre hastighet. Jag kom ihåg att i den fantastiska Jag läste om en cool funktion som kallas «». I huvudsak är det nyckel-värde-par som av någon anledning kallas något annat i AWK, därför har jag inte riktigt tänkt på dem. påminde mig om att termen «associativa arrayer» är mycket äldre än termen «nyckel-värde-par». Även om du , kommer du inte att se den termen där, men du kommer att hitta associativa arrayer! Dessutom associeras «nyckel-värde-par» oftast med databaser, så det är mycket logiskt att jämföra med hashmap. Jag insåg att jag kan använda dessa associativa arrayer för att koppla mina SNP med bin-tabellen och rådata utan att använda Spark.
För detta använde jag blocket i AWK-skriptet BEGIN. Detta är en kodsnutt som körs innan den första dataraden överförs till huvuddelen av skriptet.
join_data.awk
BEGIN {
  FS=",";
  batch_num=substr(chunk,7,1);
  chunk_id=substr(chunk,15,2);
  while(getline  "chunked/chr_"chr"_bin_"bin[$1]"_"batch_num"_"chunk_id".csv"
}
Team while(getline...) laddade alla rader från gruppens CSV (bin), satte första kolumnen (namnet på SNP) som nyckel för den associativa arrayen bin och det andra värdet (gruppen) som värde. Sedan i blocket { }, som körs för varje rad i huvudfilen, skickas varje rad till utdatafilen, som får ett unikt namn beroende på dess grupp (bin): ..._bin_"bin[$1]"_....
Variabler batch_num och chunk_id svarade mot data som tillhandahölls av pipelinen, vilket gjorde att man kunde undvika race conditions, och varje exekveringstråd som startades parallel, skrev till sin egen unika fil.
Eftersom jag delade upp all rådata i mappar baserat på kromosomer från mitt tidigare experiment med AWK, kunde jag nu skriva ett annat Bash-skript för att bearbeta en kromosom åt gången och skicka mer djupt partitionerade data till S3.
DESIRED_CHR='13'

# Ladda ner kromosomdata från s3 och dela upp i bin
aws s3 ls $DATA_LOC |
awk '{print $4}' |
grep 'chr'$DESIRED_CHR'.csv' |
parallel "echo 'reading {}'; aws s3 cp "$DATA_LOC"{} - | awk -v chr=""$DESIRED_CHR"" -v chunk="{}" -f split_on_chr_bin.awk"

# Kombinera alla parallella processer till enskilda filer och ladda upp till rds med R
ls chunked/ |
cut -d '_' -f 4 |
sort -u |
parallel "echo 'zipping bin {}'; cat chunked/*_bin_{}_*.csv | ./upload_as_rds.R '$S3_DEST'/chr_'$DESIRED_CHR'_bin_{}.rds"
rm chunked/*
I skriptet finns två avsnitt parallel.
I det första avsnittet läses data från alla filer som innehåller information om den aktuella kromosomen, och dessa data fördelas över trådar som sprider filer i motsvarande grupper (bin). För att undvika tillstånd av tävling, där flera trådar skriver till en fil, skickar AWK filnamn för att skriva data på olika platser, till exempel, chr_10_bin_52_batch_2_aa.csv. Resultatet blir en mängd små filer på disken (för detta använde jag terabyte stora EBS-volymer).
Pipelinen från det andra avsnittet parallel går igenom grupperna (bin) och förenar deras separata filer till gemensamma CSV-filer med cat, och skickar dem sedan för export.
Överföring till R?
Vad jag har lärt mig: man kan hänvisa till stdin och stdout från R-skript, vilket gör att man kan använda det i pipelinen.
I Bash-skriptet kan du ha lagt märke till en sådan rad: ...cat chunked/*_bin_{}_*.csv | ./upload_as_rds.R.... Den överför alla sammanhängande filer från gruppen (bin) till det nedanstående R-skriptet. {} är en speciell metodik parallel, som direkt skickar all data som den sänder i den angivna strömmen till själva kommandot. Alternativet {#} tillhandahåller ett unikt ID för körströmmar, och {%} är nummer på uppdragets slot (upprepas men aldrig samtidigt). En lista över alla alternativ kan hittas i
#!/usr/bin/env Rscript
library(readr)
library(aws.s3)

# Read first command line argument
data_destination <- commandArgs(trailingOnly = TRUE)[1]

data_cols <- list(SNP_Name = 'c', ...)

s3saveRDS(
  read_csv(
        file("stdin"),
        col_names = names(data_cols),
        col_types = data_cols
    ),
  object = data_destination
)
När variabeln file("stdin") överlämnas till readr::read_csv, laddas data överfört till R-skriptet in i en dataram som sedan i form av .rds-fil skrivs direkt till S3 via aws.s3. RDS är något som en enklare version av Parquet, utan kolumnformatets finesser.
Efter att Bash-skriptet avslutades fick jag en uppsättning
-filer som låg i S3, vilket gav mig möjlighet att använda effektiv komprimering och inbyggda typer. .rdsTrots den tröga R, fungerade allt väldigt snabbt. Det är inte förvånande att de avsnitt på R som ansvarar för att läsa och skriva data är väl optimerade. Efter testning på en kromosom av medelstorlek, avslutades uppdraget på en C5n.4xl-instans på ungefär två timmar.
S3:s begränsningar
: tack vare smart implementering av S3-vägarna kan den hantera många filer.
Vad jag har lärt migJag var orolig för om S3 skulle kunna hantera många filer som skickats till den. Jag kunde ge filnamnen en meningsfull struktur, men hur skulle S3 söka igenom dem?
Mappar i S3 är bara för utseendet, systemet bryr sig faktiskt inte om tecknet
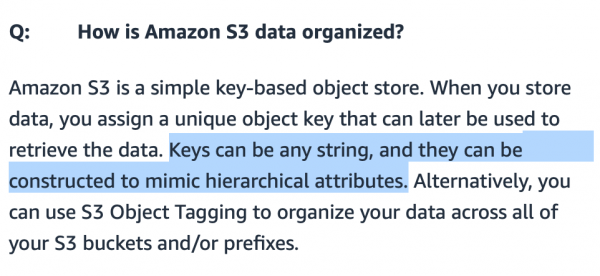
Från S3:s FAQ-sida. /.
Det verkar som att S3 representerar sökvägen till en specifik fil som en enkel nyckel i en slags hash-tabell eller dokumentbaserad databas. En bucket kan ses som en tabell, medan filer är poster i denna tabell.
Eftersom hastighet och effektivitet är viktiga för att generera vinst på Amazon, är det inte förvånande att detta "nyckel-till-sökväg-till-fil"-system är fantastiskt optimerat. Jag försökte hitta en balans: så att det inte behövdes göras många GET-förfrågningar, men ändå att förfrågningarna gick snabbt. Det visade sig att det var bäst att göra cirka 20 000 bin-filer. Jag tror att om man fortsätter att optimera så kan man öka hastigheten (till exempel göra en speciell bucket endast för data, vilket minskar storleken på sök-tabellen). Men det fanns inte tid eller pengar för fler experiment.
Vad gäller korskompatibilitet?
Vad jag har lärt mig: Huvudorsaken till tidsförlust är för tidig optimering av din lagringsmetod.
I det här ögonblicket är det viktigt att ställa sig själv frågan: "Varför använda ett proprietärt filformat?" Anledningen ligger i hastigheten vid inläsning (komprimerade gzip CSV-filer laddades 7 gånger långsammare) och kompatibiliteten med våra arbetsflöden. Jag kan ompröva mitt beslut om R enkelt kan ladda Parquet-filer (eller Arrow) utan belastning i form av Spark. I vårt labb använder alla R, och om jag behöver konvertera data till ett annat format har jag fortfarande de ursprungliga textdata, så jag kan enkelt köra pipelinen igen.
Arbetets uppdelning
Vad jag har lärt mig: Försök inte optimera uppgifter manuellt, låt datorn göra det.
Jag har finjusterat arbetsflödet på en kromosom, nu behöver jag bearbeta alla andra data.
Jag ville starta flera EC2-instanser för konverteringen, men jag var samtidigt orolig för att få en extremt obalanserad belastning på olika bearbetningsuppgifter (precis som Spark lidit av obalanserade partitioner). Dessutom ville jag inte starta en instans för varje kromosom, eftersom det finns en standardgräns på 10 instanser för AWS-konton.
Då bestämde jag mig för att skriva ett skript i R för att optimera bearbetningsuppgifterna.
Först bad jag S3 att beräkna hur mycket lagringsutrymme varje kromosom tar.
library(aws.s3)
library(tidyverse)

chr_sizes %
  mutate(Size = as.numeric(Size)) %>%
  filter(Size != 0) %>%
  mutate(
    # Extrahera kromosom från filnamnet
    chr = str_extract(Key, 'chr.{1,4}.csv') %>%
             str_remove_all('chr|.csv')
  ) %>%
  group_by(chr) %>%
  summarise(total_size = sum(Size)/1e+9) # Dela för att få värdet i GB


# En tibble: 27 x 2
   chr   total_size

 1 0           163.
 2 1           967.
 3 10          541.
 4 11          611.
 5 12          542.
 6 13          364.
 7 14          375.
 8 15          372.
 9 16          434.
10 17          443.
# … med 17 fler rader
Sedan skrev jag en funktion som tar totalstorleken, blandar kromosomordningen och delar dem i grupper. num_jobs och rapporterar hur mycket storleken på alla behandlingsjobb skiljer sig.
num_jobs <- 7
# Hur stor skulle varje jobb vara om det delades perfekt?
job_size <- sum(chr_sizes$total_size)/7

shuffle_job %
    sample_frac() %>%
    mutate(
      cum_size = cumsum(total_size),
      job_num = ceiling(cum_size/job_size)
    ) %>%
    group_by(job_num) %>%
    summarise(
      job_chrs = paste(chr, collapse = ','),
      total_job_size = sum(total_size)
    ) %>%
    mutate(sd = sd(total_job_size)) %>%
    nest(-sd)
}

shuffle_job(1)


# En tibble: 1 x 2
     sd data

1  153.
Sedan körde jag tusen blandningar med hjälp av purrr och valde den bästa.
1:1000 %>%
  map_df(shuffle_job) %>%
  filter(sd == min(sd)) %>%
  pull(data) %>%
  pluck(1)
Så jag fick ett set av jobb som var mycket lika i storlek. Då återstod det bara att omsluta mitt tidigare Bash-skript i en stor loop. for. Det tog mig cirka 10 minuter att skriva denna optimering. Och det är betydligt mindre än vad jag skulle ha spenderat på att manuellt skapa jobb i fall av obalans. Så jag tycker att denna preliminära optimering var en bra idé.
för DESIRED_CHR in "16" "9" "7" "21" "MT"
do
# Kod för att bearbeta en enskild kromosom
fi
I slutet lägger jag till en avstängningskommandon:
sudo shutdown -h now … och allt fungerade! Jag använde AWS CLI för att starta instanser och skickade dem Bash-skripten för deras bearbetningsjobb via optionen user_data de körde och stängdes av automatiskt, så jag betalade inte för överflödig beräkningskraft.
aws ec2 run-instances ...
--tag-specifications "ResourceType=instance,Tags=[{Key=Name,Value=<>}]"
--user-data file://<>
Nu paketerar vi!
Vad jag har lärt mig: API:et ska vara enkelt för enkelhetens och användbarhetens skull.
Äntligen fick jag data på rätt plats och i rätt format. Det återstod bara att förenkla användningen av data, så mina kollegor skulle ha det lättare. Jag ville skapa ett enkelt API för att göra förfrågningar. Om jag i framtiden bestämmer mig för att byta med .rds När det gäller Parquet-filer bör detta vara ett problem för mig och inte för kollegorna. Därför beslutade jag mig för att skapa ett internt R-paket.
Jag har samlat och dokumenterat ett mycket enkelt paket som innehåller bara några få funktioner för att få tillgång till data, centrerat kring funktionen get_snp. Jag har också skapat en webbplats för kollegorna , så att de enkelt kan se exempel och dokumentation.
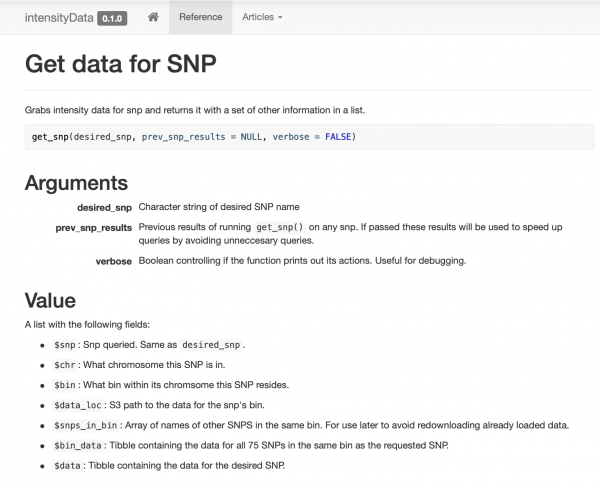
Intelligent caching
Vad jag har lärt mig: om dina data är väl förberedda blir det enkelt att cacha!
Eftersom en av de viktigaste arbetsflödena applicerade samma analysmodell på SNP-paketet, beslutade jag mig för att använda gruppindelning (binning) till min fördel. När data överförs via SNP bifogas all information från gruppen (bin) till det returnerade objektet. Det vill säga, gamla förfrågningar kan (i teorin) snabba upp behandlingen av nya förfrågningar.
# Part of get_snp()
...
  # Test if our current snp data has the desired snp.
  already_have_snp <- desired_snp %in% prev_snp_results$snps_in_bin

  if(!already_have_snp){
    # Grab info on the bin of the desired snp
    snp_results <- get_snp_bin(desired_snp)

    # Download the snp's bin data
    snp_results$bin_data <- aws.s3::s3readRDS(object = snp_results$data_loc)
  } else {
    # The previous snp data contained the right bin so just use it
    snp_results <- prev_snp_results
  }
...
Vid sammanställningen av paketet körde jag många benchmark-tester för att jämföra hastigheten med olika metoder. Jag rekommenderar att inte förbise detta, eftersom resultaten ibland kan vara oväntade. Till exempel, dplyr::filter visade sig vara mycket snabbare än att fånga rader med hjälp av indexeringsbaserad filtrering, och att få en kolumn från den filtrerade dataramverk fungerade mycket snabbare än att använda indexeringssyntax.
Observera att objektet prev_snp_results innehåller nyckeln snps_in_bin. Detta är en array av alla unika SNP i gruppen (bin), vilket möjliggör snabb kontroll av om data från en tidigare förfrågan redan finns. Det förenklar också den cykliska genomgången av alla SNP i gruppen (bin) med följande kod:
# Get bin-mates
snps_in_bin <- my_snp_results$snps_in_bin

for(current_snp in snps_in_bin){
  my_snp_results <- get_snp(current_snp, my_snp_results)
  # Do something with results
}
Resultat
Nu kan vi (och har verkligen börjat) köra modeller och scenarier som tidigare var otillgängliga för oss. Det bästa av allt är att mina kollegor i labbet inte behöver tänka på några svårigheter. De har bara en fungerande funktion.
Och även om paketet befriar dem från detaljerna, försökte jag göra dataformatet tillräckligt enkelt så att de kan förstå det om jag plötsligt skulle försvinna imorgon...
Hastigheten har ökat betydligt. Vanligtvis skannar vi funktionellt betydelsefulla fragment av genomet. Tidigare kunde vi inte göra detta (det var för dyrt), men nu, tack vare gruppstrukturen (bin) och caching, tar det i genomsnitt mindre än 0,1 sekund per förfrågan om en SNP, och användningen av data är så låg att kostnaderna för S3 blir därmed väldigt låga.
Nyligen blev jag ansvarig för att hantera över 25 TB av rå genotypdata för mitt laboratorium. När jag började tog det 8 minuter och kostade 20 dollar att fråga en SNP med Spark. Efter att ha använt AWK + för att bearbeta, tar det nu mindre än en tiondel av en sekund och kostar 0,00001 dollar. Min personliga seger.
— Nick Strayer (@NicholasStrayer)
Slutsats
Den här artikeln är inte alls en handledning. Lösningen blev individuell och är nästan säkert inte optimal. Snarare är det en berättelse om en resa. Jag vill att andra ska förstå att sådana lösningar inte dyker upp fullt formade i huvudet, utan är resultatet av försök och misstag. Dessutom, om du letar efter en specialist inom dataanalys, bör du tänka på att för att effektivt använda dessa verktyg krävs erfarenhet, och erfarenhet kostar pengar. Jag är glad att jag hade medel att betala, men många andra som kan göra samma jobb bättre än jag, kommer aldrig ha den möjligheten på grund av bristen på pengar för ens ett försök.
Verktyg för stora data är mångsidiga. Om du har tid kan du nästan säkert skriva en snabbare lösning genom att använda "smart" datarengöring, lagring och extraktionsmetoder. I slutändan handlar allt om kostnads- och nyttoanalys.
Vad jag lärde mig:
- det finns inget billigt sätt att parsa 25 TB på en gång;
- var försiktig med storleken på dina Parquet-filer och deras organisation;
- partitionerna i Spark bör vara balanserade;
- försök aldrig att göra 2,5 miljoner partitioner;
- att sortera är fortfarande svårt, precis som att ställa in Spark;
- ibland kräver speciella data speciella lösningar;
- sammanfogning i Spark fungerar snabbt, men partitionering är fortfarande kostsamt;
- sov inte när grunderna undervisas, någon har säkert redan löst ditt problem under 1980-talet;
gnu paralleldet är en magisk sak, alla borde använda den;- Spark älskar okomprimerade data och gillar inte att kombinera partitioner;
- det finns för mycket overhead i Spark när man löser enkla uppgifter;
- associativa arrayer i AWK är mycket effektiva;
- kan nås från R-skript, vilket betyder att det kan användas i en pipeline;
stdinochstdouttack vare smart implementation av S3-vägar kan många filer bearbetas; - den största anledningen till tidsförlust är för tidig optimering av din lagringsmetod;
- försök inte att optimera uppgifter manuellt, låt datorn göra det;
- API:t måste vara enkelt för enkelhetens och användarens flexibilitet;
- om dina data är väl förberedda, blir det enkelt att cacha!
- om dina data är väl förberedda blir det enkelt att cachera!
Källa: habr.com
