

Huvudsyftet med Patroni är att säkerställa hög tillgänglighet för PostgreSQL. Men Patroni är bara en mall, inte ett färdigt verktyg (vilket också anges i dokumentationen). Vid första anblicken, när man ställer in Patroni i en testmiljö, kan man se hur bra det är som verktyg och hur enkelt det hanterar våra försök att förstöra klustret. Men i praktiken, i produktionsmiljöer, går det inte alltid så vackert och elegant som i testmiljön.
Jag ska berätta lite om mig själv. Jag började som systemadministratör. Jag har arbetat med webbutveckling. Sedan 2014 arbetar jag på Data Egret. Företaget sysslar med konsultverksamhet inom Postgres. Vi underhåller just Postgres och arbetar med Postgres varje dag, så vi har olika expertiser relaterade till drift.
I slutet av 2018 började vi långsamt använda Patroni. Och vi har samlat på oss en viss erfarenhet. Vi har på något sätt diagnostiserat det, optimerat det, och kommit fram till våra bästa metoder. I den här presentationen kommer jag att berätta om dem.
Förutom Postgres älskar jag Linux. Jag gillar att gräva i det och utforska, älskar att kompilera kärnor. Jag gillar virtualisering, containrar, Docker, Kubernetes. Allt detta intresserar mig eftersom det påverkas av gamla administrativa vanor. Jag älskar att ägna mig åt övervakningar. Och jag älskar postgres-relaterade uppgifter som administration, det vill säga replikering, säkerhetskopiering. På min fritid skriver jag i Go. Jag är ingen mjukvaruingenjör, jag skriver bara för mig själv i Go. Och det ger mig glädje.
- Jag tror många av er vet att Postgres inte har HA (hög tillgänglighet) ur lådan. För att få HA måste man installera något, konfigurera det, lägga ner en viss ansträngning och få det.
- Det finns flera verktyg och Patroni är ett av dem, som löser HA ganska bra och effektivt. Men när vi sätter upp allt i testmiljön och kör det, kan vi se att allt fungerar, vi kan återskapa vissa problem och se hur Patroni hanterar dem. Och vi kommer att se att allt fungerar utmärkt.
- Men i praktiken har vi stött på olika problem. Och jag kommer att berätta om dessa problem.
- Jag ska berätta hur vi diagnostiserade detta, vad vi justerade – om det hjälpte oss eller inte.
- Jag kommer inte att berätta hur man installerar Patroni, för det kan man enkelt googla på nätet, eller titta på konfigurationsfilerna för att förstå hur allt startar och ställs in. Man kan även förstå scheman och arkitekturer genom att hitta information om detta online.
- Jag kommer inte att prata om andras erfarenheter. Jag kommer endast att berätta om de problem vi har stött på.
- Och jag kommer inte att prata om problem som ligger utanför Patroni och PostgreSQL. Om det till exempel rör sig om problem relaterade till belastningsutjämning, när vår kluster kollapsade, kommer jag inte att berätta om det.
Och en liten disclaimer innan vi börjar vår presentation.
Alla dessa problem som vi stötte på inträffade under de första 6-7-8 månaderna av driftsättning. Med tiden kom vi fram till våra interna bästa metoder. Och problemen försvann. Därför presenterades föredraget för ungefär ett halvår sedan, när detta fortfarande var färskt i minnet och jag kom ihåg allt klart.
Under förberedelserna av föredraget har jag redan gått igenom gamla postmortem-rapporter och tittat på loggar. Och vissa detaljer kan ha glömts bort, eller vissa detaljer kan ha varit otillräckligt undersökta under problemanalysen, så det kan verka som om vissa problem inte har behandlats helt eller att det finns brist på information. Så jag ber om ursäkt för det.
Vad är Patroni?
- Det är en mall för att skapa hög tillgänglighet (HA). Så står det i dokumentationen. Och från min synvinkel är det en mycket korrekt precisering. Patroni är inte en silverkula som löser alla dina problem, det vill säga att det krävs ansträngning för att få det att fungera och ge nytta.
- Det är en agenttjänst som installeras på varje tjänst med databasen, och som fungerar som en slags init-system för din Postgres. Den startar Postgres, stoppar den, startar om den, ändrar konfiguration och förändrar topologin av din kluster.
- För att lagra klusterstatus, dess nuvarande representation och hur det ser ut, behövs ett lagringsutrymme. Och i detta avseende har Patroni valt att lagra tillståndet i ett externt system. Det är ett system för distribuerad konfigurationlagring. Det kan vara Etcd, Consul, ZooKeeper eller Kubernetes' Etcd, det vill säga något av dessa alternativ.
- En av funktionerna i Patroni är att du får en auto-failover direkt ur lådan, bara genom att konfigurera det. Jämför man med Repmgr så ingår failover där som en del av paketet. Med Repmgr får vi en switchover, men om vi vill ha en auto-failover måste vi konfigurera det separat. I Patroni finns auto-failover redan inbyggt.
- Och det finns många andra saker. Till exempel, hantering av konfigurationer, installation av nya repliker, säkerhetskopiering, osv. Men det ligger utanför föredraget, så det kommer jag inte att täcka.
En liten sammanfattning är att den huvudsakliga uppgiften med Patroni är att på ett bra och pålitligt sätt genomföra auto-failover så att klustret förblir funktionellt och applikationen inte märker några förändringar i kluster-topologin.
Men när vi börjar använda Patroni blir vårt system lite mer komplext. Om vi tidigare hade Postgres så får vi nu Patroni, en DCS där status lagras. Allt detta måste fungera på något sätt. Så vad kan gå fel?
Det som kan gå fel:
- Postgres kan gå fel. Det kan vara master eller en replika, något av dem kan sluta fungera.
- Själva Patroni kan gå fel.
- DCS:en där statusen lagras kan gå fel.
- Och nätverket kan också gå fel.
Alla dessa punkter kommer jag att diskutera i föredraget.
Jag kommer att gå igenom fallen i takt med att de blir mer komplexa, inte utifrån perspektivet att fallet involverar många komponenter. Utan utifrån subjektiva känslor, där ett fall kändes svårt och det var utmanande att analysera... och omvänt, ett annat fall kändes enkelt och var lätt att analysera.
Det första fallet är det enklaste. Det är det fallet där vi har tagit en databas-kluster och på samma kluster har vi installerat vår DCS-lagring. Det här är det vanligaste misstaget. Det är ett arkitekturfel, dvs. att kombinera olika komponenter på ett och samma ställe.
Så, en failover inträffade, låt oss ta reda på vad som hände.
Här är vi intresserade av när failovern inträffade. Det vill säga, vi är intresserade av den tidpunkten när statusförändringen i klustret inträffade.
Men failovern är inte alltid ögonblicklig, dvs. den tar inte en enhet av tid, utan den kan dra ut på tiden. Den kan vara långvarig.
Därför har det både en starttid och en sluttid, det vill säga det är en långvarig händelse. Vi delar in alla händelser i tre intervall: vi har tiden före failover, under failover och efter failover. Det vill säga vi betraktar alla händelser på denna tidslinje.
Och det första vi gör när failovern inträffar är att söka orsaken till vad som hände, vad som ledde till failovern.
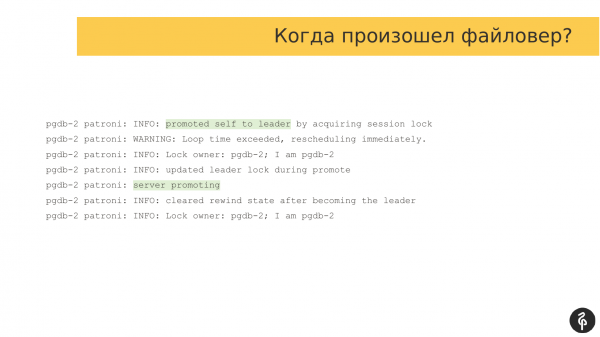
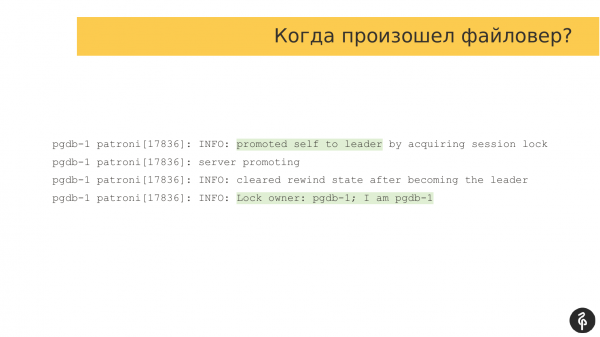
Om vi tittar på loggarna, så är det klassiska Patroni-loggar. Där informerar den oss om att servern har blivit master och rollen som master har övergått till denna nod. Här är det markerat.
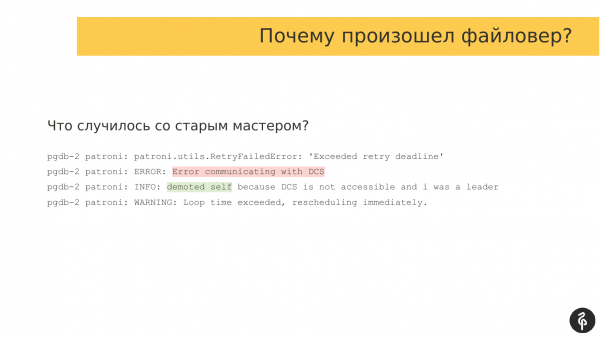
Vidare behöver vi förstå varför failovern inträffade, vilket vill säga vilka händelser som ledde till att rollen som master flyttades från en nod till en annan. Och i det här fallet är det väldigt enkelt. Vi har ett fel i kommunikationen med lagringssystemet. Mastern insåg att den inte kunde arbeta med DCS, det vill säga det uppstod något problem i kommunikationen. Och den säger att den inte kan vara master längre och avsäger sig sina befogenheter. Denna rad "demoted self" handlar just om det.
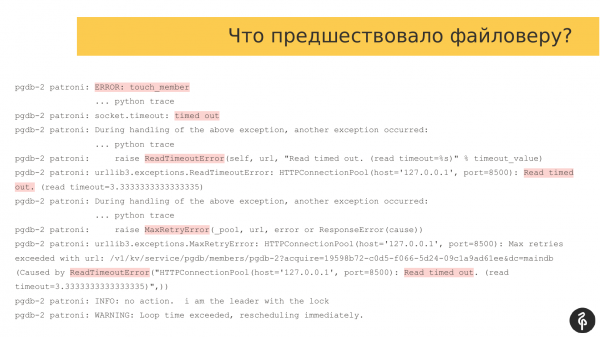
Om vi tittar på händelserna som föregick failovern, kan vi se just de orsaker som blev problematiska för att mastern skulle kunna fortsätta att arbeta.
Om vi tittar på Patroni-loggarna, ser vi att vi har massor av olika fel, timeoutar, det vill säga Patroni-agenten kan inte arbeta med DCS. I det här fallet är det Consul-agenten med vilken vi kommunicerar via port 8500.
Och problemet här är att Patroni och databasen körs på samma värd. Och på denna nod kördes också Consul-servrarna. Genom att belasta servern skapade vi problem även för servrar Consul. De kunde inte kommunicera normalt.
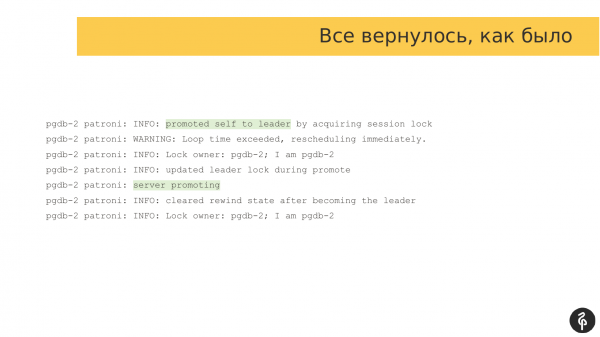
Efter en viss tid, när belastningen hade minskat, kunde vår Patroni återigen kommunicera med agenterna. Den normala driften återupptogs. Och samma server Pgdb-2 blev åter master. Det vill säga det blev en liten flip som gjorde att noden avsade sig sina befogenheter som master och sedan tog dem åter, det vill säga allt återgick till det normala.
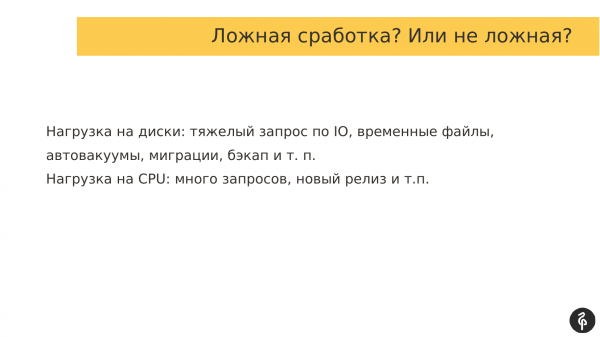
Och detta kan ses som en falsk aktivering, eller så kan det ses som att Patroni gjorde allt rätt. Det vill säga den insåg att den inte kunde upprätthålla klusterstatusen och avsade sig sina befogenheter.
Och här uppstod problemet eftersom Consul-servrarna finns på samma utrustning som databaserna. Därför påverkar all belastning, oavsett om det är belastning på diskar eller processorer, interaktionen med Consul-klustret.
Och vi beslutade att det inte borde leva tillsammans, vi avsatte ett separat kluster för Consul. Patroni fungerade redan med en separat Consul, det vill säga det fanns ett separat Postgres-kluster och ett separat Consul-kluster. Detta är en grundläggande instruktion om hur man ska dela upp dessa saker och hålla dem åtskilda så att de inte lever tillsammans.
Som ett alternativ kan man justera parametrarna ttl, loop_wait, retry_timeout, det vill säga försöka övervinna dessa kortvariga belastningsspikar genom att öka dessa parametrar. Men detta är inte det mest lämpliga alternativet, eftersom denna belastning kan vara långvarig. Och vi kommer helt enkelt att överskrida gränserna för dessa parametrar. Och detta kan kanske inte hjälpa helt.
Det första problemet, som ni förstår, är enkelt. Vi tog och lade DCS tillsammans med databasen, vilket ledde till ett problem.
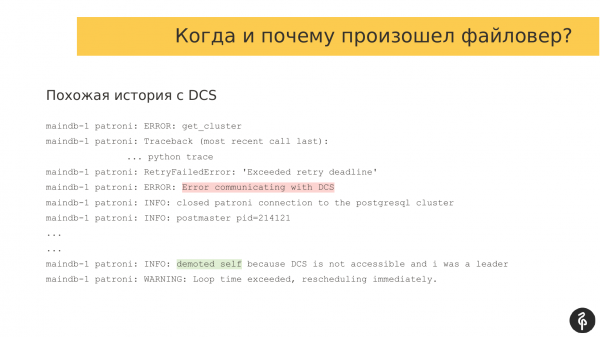
Det andra problemet liknar det första. Det liknar det genom att vi återigen har interaktionsproblem med DCS-systemet.
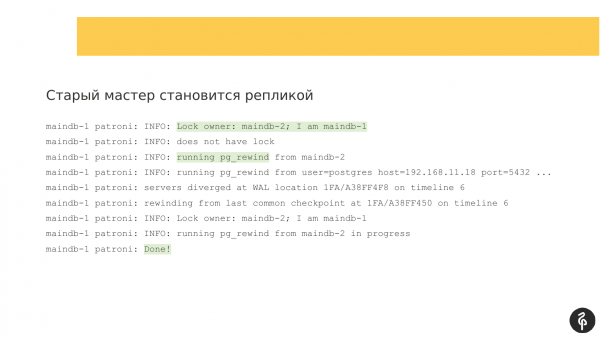
Om vi tittar på loggarna ser vi att vi återigen får kommunikationsfel. Och Patroni säger att jag inte kan interagera med DCS, därför går den aktuella masterinstansen in i replikeringsläge.
Den gamla mastern blir en replik, här fungerar Patroni som det ska. Den kör pg_rewind för att backa transaktionsloggen och sedan ansluta till den nya mastern för att hinna ikapp den nya mastern. Här fungerar Patroni som den ska.
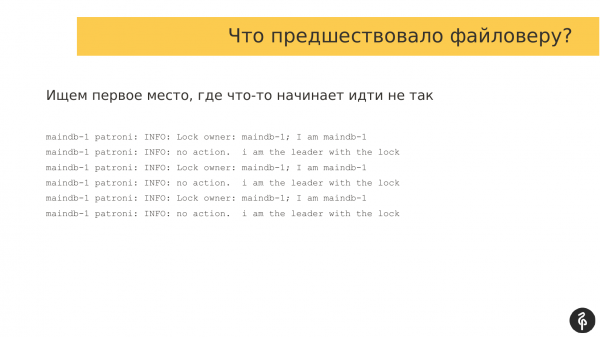
Här måste vi hitta den plats som föregick filsystemet, det vill säga de fel som orsakat problemet med filsystemet. I detta avseende är det ganska bekvämt att arbeta med loggarna i Patroni. Den skriver samma meddelanden med bestämda intervall. Och om vi börjar bläddra snabbt genom dessa loggar, ser vi att loggarna har ändrats, vilket betyder att några problem har börjat. Vi går snabbt tillbaka till den platsen och ser vad som händer.
Och i en normal situation ser loggarna ut ungefär så här. Ägaren av låset kontrolleras. Och om ägaren exempelvis har ändrats kan vissa händelser inträffa som Patroni måste reagera på. Men i detta fall har vi allt i ordning. Vi letar efter den punkt där felen började.
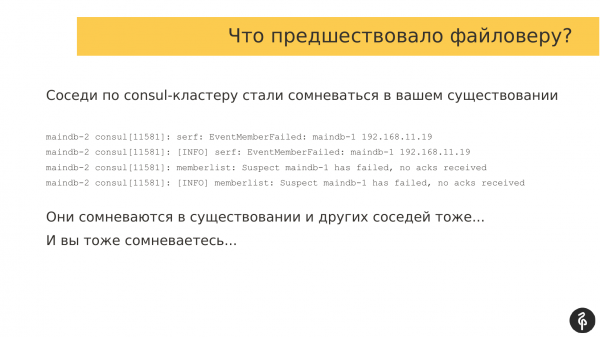
Och när vi bläddrar fram till den punkt där felen började dyka upp, ser vi att vi har haft en auto-failover. Eftersom våra fel var relaterade till interaktionen med DCS och i vårt fall använde vi Consul, kollar vi även loggarna i Consul för att se vad som hände där.
Genom att ungefär matcha tiden för failovern med tiden i Consuls loggar, ser vi att våra grannar i Consul-klustret började tvivla på existensen av andra deltagare i Consul-klustret.
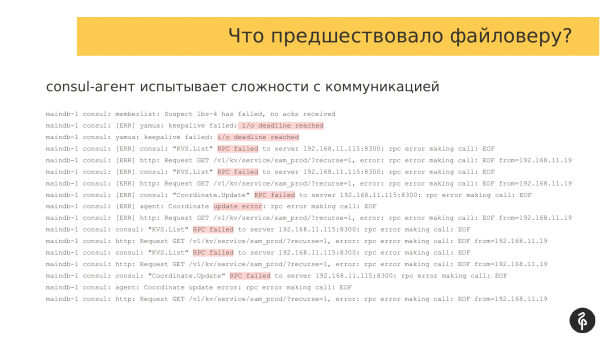
Och om vi dessutom tittar på loggarna från andra Consul-agenter, ser vi också att det verkar ske en viss nätverkssammanbrott. Och alla deltagare i Consul-klustret tvivlar på varandras existens. Detta ledde till failovern.
Om vi tittar på vad som hände före dessa fel, kan vi se att det finns olika typer av fel, till exempel deadline, RPC-fel, det vill säga tydligt ett problem med interaktionen mellan deltagarna i Consul-klustret.
Det enklaste svaret är att reparera nätverket. Men för mig, medan jag står på podiet, är det lätt att påstå detta. Men omständigheterna är sådana att beställaren inte alltid kan tillåta sig att reparera nätverket. Han kan bo i datacentret och kan sakna möjligheter att laga nätverket eller påverka utrustningen. Och därför behöver vi andra alternativ.
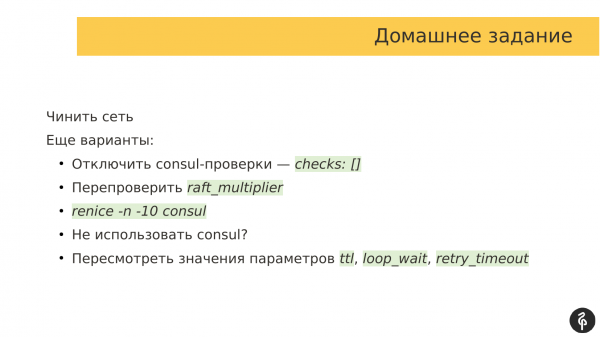
Alternativ finns:
- Det enklaste alternativet, som står skrivet, tror jag till och med i dokumentationen, är att stänga av Consul-kontroller, det vill säga att helt enkelt överföra en tom array. Och vi säger till Consul-agenten att inte använda några kontroller. Genom dessa kontroller kan vi ignorera dessa nätverksstormar och undvika att initiera failovern.
- Ett annat alternativ är att dubbelkolla raft_multiplier. Detta är en parameter för själva Consul-servern. Som standard är den inställd på värde 5. Detta värde rekommenderas enligt dokumentationen för staging-miljöer. I själva verket påverkar detta frekvensen av meddelandeutbyte mellan deltagarna i Consul-nätverket. I praktiken påverkar denna parameter hastigheten på kommunikationen mellan deltagarna i Consul-klustret. Och för produktion rekommenderas det att minska den så att noderna oftare utbyter meddelanden.
- Ett annat alternativ som vi har börjat använda är att öka prioriteten för Consul-processer bland andra processer för operativsystemets schemaläggare. Det finns en parameter som heter "nice", som definierar processen prioritet som tas i beaktande av OS-schemaläggaren vid schemaläggning. Vi justerade och sänkte värdet för nice för Consul-agenterna, det vill säga vi höjde prioriteten, så att operativsystemet ger Consul-processerna mer tid för att arbeta och köra sin kod. I vårt fall löste detta vårt problem.
- Ett annat alternativ är att inte använda Consul. Jag har en vän som är stor anhängare av Etcd. Och vi diskuterar regelbundet vilken som är bättre, Etcd eller Consul. Men när det kommer till vilket som är bättre, brukar vi vanligtvis vara överens om att Consul har en agent som måste köras på varje nod med databasen. Det vill säga, interaktionen mellan Patroni och Consul-klustret går genom denna agent. Och den här agenten blir en flaskhals. Om det händer något med agenten kan inte Patroni arbeta med Consul-klustret. Och detta är ett problem. När det gäller Etcd finns det ingen agent. Patroni kan arbeta direkt med listan över Etcd-servrar och kommunicera med dem. I det avseendet, om du använder Etcd i ditt företag, så är Etcd förmodligen det bästa valet jämfört med Consul. Men vi är alltid begränsade av vad kunden har valt och använder. Och hos våra kunder har vi mestadels Consul.
- Och den sista punkten är att se över värdena för parametrarna. Vi kan öka dessa parametrar större i hopp om att våra kortvariga nätverksproblem kommer att vara kortvariga och inte överstiga intervallen för dessa parametrar. På så sätt kan vi minska aggressiviteten hos Patroni vid genomförandet av autofailover om nätverksproblem uppstår.
Jag tror att många som använder Patroni är bekanta med detta kommando.
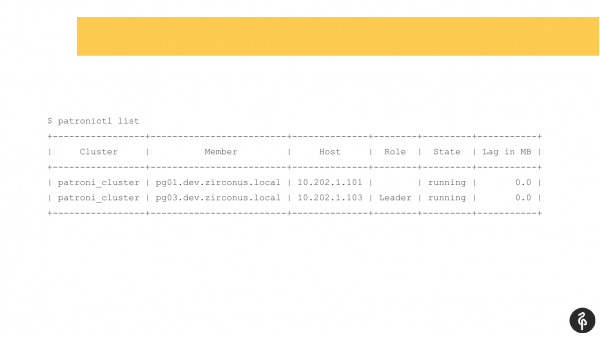
Detta kommando visar den aktuella statusen för klustret. Och vid första anblicken kan denna bild verka normal. Vi har en master, vi har en replik, och det finns ingen replikationsfördröjning. Men denna bild är normal endast så länge vi inte vet att det i detta kluster borde finnas tre noder, inte två.
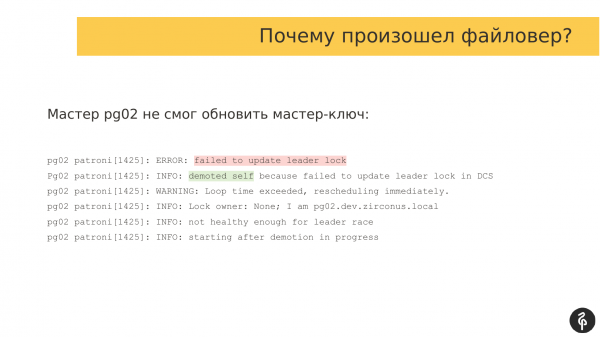
Därmed inträffade en auto failover. Efter denna auto failover försvann vår replik. Vi behöver ta reda på varför den försvann och få tillbaka den, återställa den. Och vi går återigen igenom loggarna och undersöker varför vi hade en auto failover.
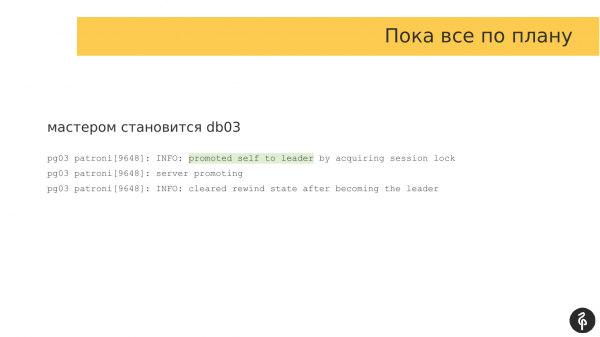
I det här fallet blev den andra repliken master. Allt är i ordning här.
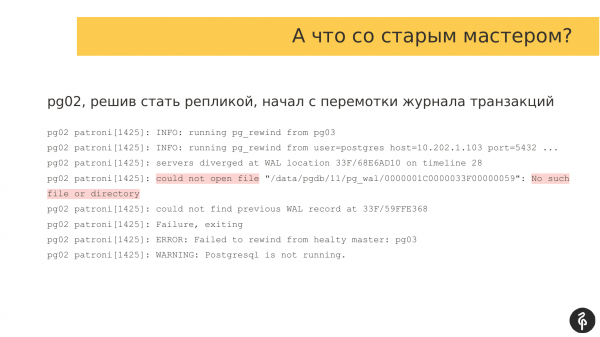
Vi behöver titta på repliken som kopplades bort och som inte är i klustret. Vi öppnar Patroni-loggarna och ser att vi hade ett problem vid anslutningen till klustret under pg_rewind-stadiet. För att ansluta till klustret måste man rulla tillbaka transaktionsloggen, begära den nödvändiga transaktionsloggen från mastern och därigenom hinna ikapp mastern.
I det här fallet har vi ingen transaktionslogg och repliken kan inte starta. Därmed stoppar vi Postgres med ett fel. Därför finns den inte i klustret.
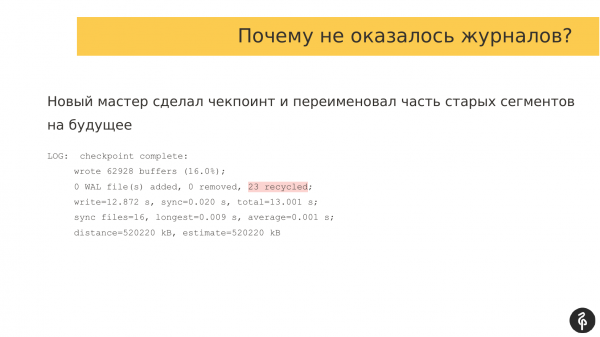
Vi måste förstå varför den inte finns i klustret och varför det inte fanns några loggar. Vi går till den nya mastern och ser vad som står i loggarna. Det visar sig att när pg_rewind utfördes inträffade en checkpoint. Och en del av de gamla transaktionsloggarna var helt enkelt omdöpta. När den gamla mastern försökte ansluta till den nya mastern och begärde dessa loggar, så var de redan omdöpta, de fanns helt enkelt inte.
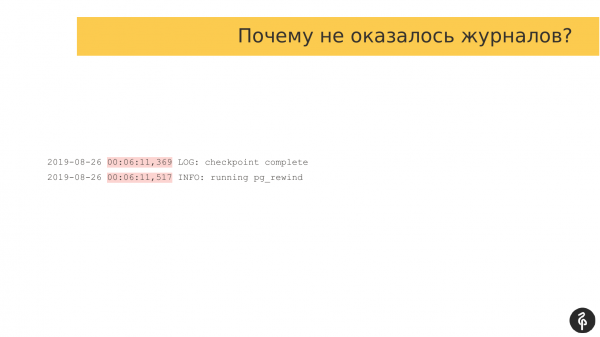
Jag jämförde tidsstämplarna för när dessa händelser inträffade. Och det var en skillnad på endast 150 millisekunder, dvs. checkpointen avslutades på 369 millisekunder, WAL-segmenten hade omdöpts. Och efter bara 517 millisekunder, 150 millisekunder senare, startade rewind på den gamla repliken. Det vill säga, vi hade precis 150 millisekunder som gjorde att repliken inte kunde ansluta och starta.
Vilka alternativ finns?
Vi använde ursprungligen reproduktionsplatser. Vi trodde att detta var bra. Även om vi vid det första användningssteget stängde av dessa platser. Vi trodde att om platserna samlade för många WAL-segment, skulle vi kunna krascha mastern. Den skulle falla. Vi kämpade ett tag utan platser. Och insåg att vi behövde platser, vi återvände till användningen av platser.
Men här finns ett problem, att när master går över till en replik så raderar den slots och tillsammans med slots raderas WAL-segment. För att undvika detta problem beslutade vi att öka parametern wal_keep_segments. Som standard är det 8 segment. Vi höjde det till 1 000 och kollade hur mycket ledigt utrymme vi har. Och vi gav 16 gigabyte till wal_keep_segments. D.v.s. vid omkopplingen har vi alltid 16 gigabyte transaktionsloggar tillgängligt på alla noder.
Och dessutom – det är fortfarande relevant för långvariga underhållsuppgifter. Låt oss säga att vi behöver uppdatera en av replikerna. Och vi vill stänga av den. Vi måste uppdatera mjukvaran, kanske operativsystemet, något annat. Och när vi stänger av repliken raderas också slotten för den repliken. Och om vi använder en liten wal_keep_segments, så när repliken är borta under en längre tid, kommer transaktionsloggarna att spelas upp. Vi startar upp repliken, den kommer att begära de transaktionsloggar där den slutade, men det kanske inte finns några kvar på master. Och repliken kan inte koppla upp sig. Därför har vi ett stort lager av loggar.
Vi har en produktionsdatabas. Där arbetar redan projekt.
Det inträffade en file failure. Vi gick in och kollade – allt var okej, replikerna var på plats, det fanns ingen replikationsförsening. Det fanns inga fel i loggarna, allt var i ordning.
Produktteamet säger att det som verkar som om det borde finnas några data, men vi ser dem i en källa, men vi ser dem inte i databasen. Och vi måste förstå vad som hände med dem.
Det är klart att pg_rewind raderade dem. Det förstod vi direkt, men vi gick för att se vad som hände.
I loggarna kan vi alltid hitta när file failuren inträffade, vem som blev master och vi kan identifiera vem som var den gamla master och när den ville bli replik. D.v.s. vi behöver dessa loggar för att ta reda på den mängd transaktionsloggar som gick förlorade.
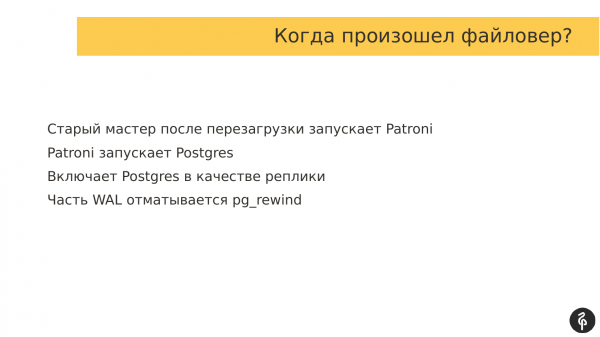
Vår gamla master startade om. Och i autostart var Patroni angivet. Patroni startades. Den följde upp med att starta Postgres. Snarare, innan Postgres startades och innan den gjordes till replik, startade Patroni processen pg_rewind. Följaktligen raderade den en del av transaktionsloggarna, laddade ner nya och kopplade upp sig. Här fungerade Patroni utmärkt, d.v.s. som vanligt. Klustret återställdes. Vi hade 3 noder, efter file failuren 3 noder – allt var toppen.
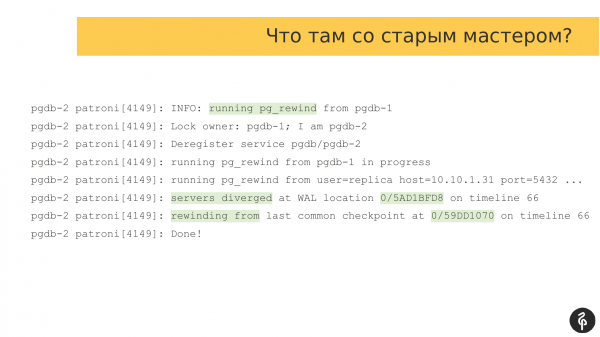
Vi har förlorat en del data. Och vi behöver förstå hur mycket vi har förlorat. Vi letar efter det ögonblick då vi hade en återställning. Vi kan hitta det genom sådana poster i loggen. Återställningen startade, gjorde något och avslutades.
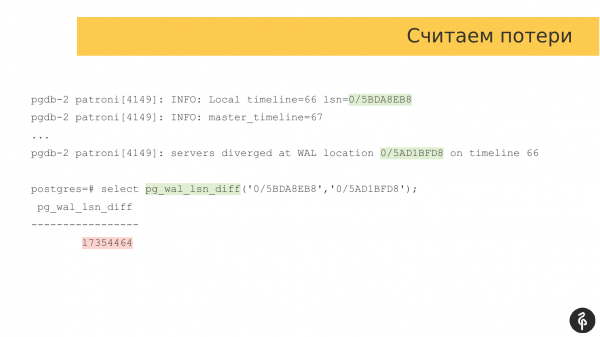
Vi behöver hitta den position i transaktionsloggen där den gamla masterservern stannade. I det här fallet är det den här punkten. Och vi behöver en andra punkt, det vill säga avståndet mellan den gamla masterservern och den nya.
Vi tar helt enkelt pg_wal_lsn_diff och jämför dessa två punkter. I det här fallet får vi 17 megabyte. Om det är mycket eller lite är upp till var och en att avgöra. För vissa är 17 megabyte lite, för andra mycket och oacceptabelt. Här får varje person individuellt avgöra i enlighet med affärens behov.
Men vad har vi kommit fram till?
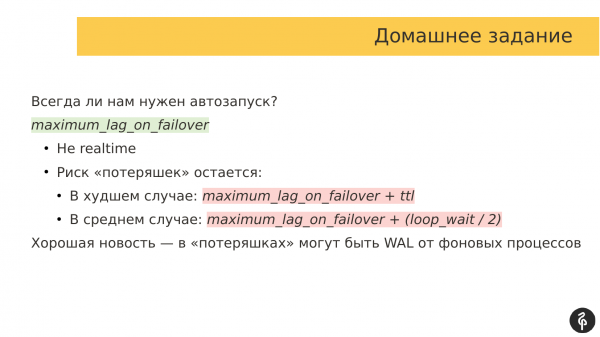
För det första måste vi avgöra om vi alltid behöver att Patroni startar automatiskt efter systemåterställning. Oftare är det så att vi måste gå in på den gamla masterservern, se hur långt den har kommit. Kanske inspektera segmenten av transaktionsloggen, se vad som finns där. Och förstå om vi kan förlora dessa data eller om vi behöver starta den gamla masterservern i standalone-läge för att få ut dessa data.
Och först efter det ska vi fatta beslut om vi kan avstå dessa data eller om vi kan återställa dem och koppla den här noden som en replik i vår kluster.
Dessutom finns det en parameter kallad "maximum_lag_on_failover". Om jag inte minns fel, så har den här parametern som standard värdet 1 megabyte.
Hur fungerar den? Om vår replik ligger efter med 1 megabyte i datalag från replikationen, då deltar inte denna replik i valet. Och om det händer en failover, ser Patroni vilka repliker som ligger efter. Om de ligger efter med ett stort antal transaktionsloggar, kan de inte bli master. Detta är en mycket bra skyddsfunktion som förhindrar att mycket data går förlorad.
Men det finns ett problem med att lagret för replikation i Patroni-klustret och DCS uppdateras med ett visst intervall. Enligt min mening är standardvärdet ttl 30 sekunder.
Det kan därför uppstå en situation där replikationsfördröjningen för repliker i DCS är en, medan den i verkligheten kan vara helt annan eller inte finnas alls, det vill säga denna sak är inte realtidsbaserad. Och den speglar inte alltid den verkliga situationen. Att bygga komplicerad logik på den är inte värt det.
Och risken för dataförlust finns alltid kvar. I värsta fall finns en formel, och i genomsnitt en annan. Det vill säga när vi planerar att implementera Patroni och bedömer hur mycket data vi kan förlora, måste vi räkna med dessa formler och ha en ungefärlig uppfattning om hur mycket data vi kan mista.
Och det finns goda nyheter. När den gamla mastern har gått framåt kan den ha gjort det på grund av vissa bakgrundsprocesser. Det vill säga, det kan ha funnits en autovakuum som skrev data och sparade dem i transaktionsloggen. Dessa data kan vi enkelt ignorera och förlora. Det är inte ett problem.
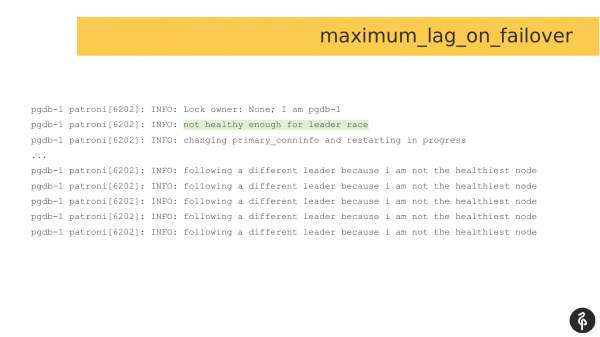
Och så ser loggarna ut om maximum_lag_on_failover är inställt och en failover har inträffat, och en ny master måste väljas. Repliken bedömer sig själv som oförmögen att delta i valet. Den avböjer att delta i kampen om ledarskapet. Och den väntar på att en ny master ska väljas för att sedan ansluta till den. Detta är en extra åtgärd för att förhindra datarförlust.
Här har vårt produktteam skrivit att deras produkt har problem när den arbetar med Postgres. Samtidigt kan man inte komma åt själva mastern eftersom den inte är tillgänglig via SSH. Och auto-failover sker inte heller.
Denna host skickades tvingat på omstart. På grund av omstarten inträffade en auto-failover, även om det hade varit möjligt att utföra en manuell auto-failover, som jag nu förstår. Och efter omstarten går vi redan för att se vad som hände med den nuvarande mastern.
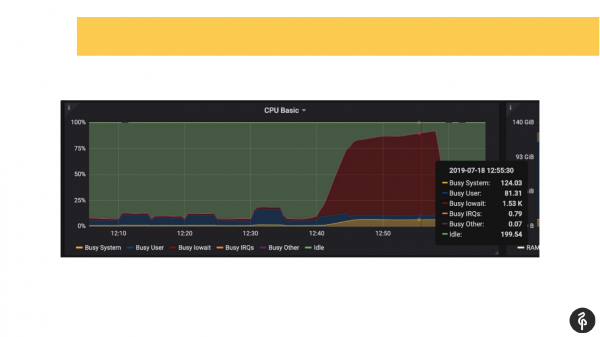
Vi visste på förhand att vi hade problem med diskarna, det vill säga vi visste redan via övervakningen var vi skulle gräva och vad vi skulle leta efter.
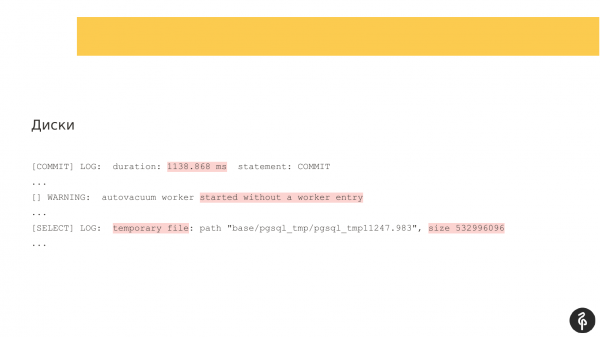
Vi gick in i postgres-loggen och började titta på vad som hände där. Vi såg commits som pågick i en, två eller tre sekunder, vilket är helt onormalt. Vi såg att vårt autovakuum startade väldigt långsamt och konstigt. Och vi såg temporära filer på disken. Det vill säga, allt detta är indikatorer på problem med diskarna.
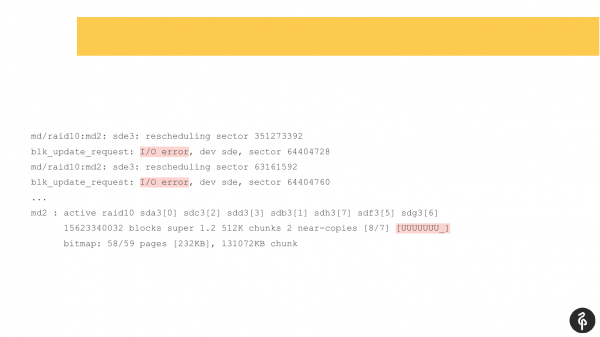
Vi tittade i systemets dmesg (i loggen för kärnmeddelanden). Och vi såg att vi hade problem med en av diskarna. Diskunderhållssystemet var en mjukvaru-Raid. Vi såg på /proc/mdstat och såg att vi saknade en disk. Det vill säga, här har vi ett Raid av 8 diskar, vi saknar en. Om man noggrant tittar på bilden kan man se att sde saknas. Vi kan säga att en disk tappades. Detta triggar diskproblem och applikationerna fick också problem med att arbeta med Postgres-klustret.
Och i det här fallet skulle Patroni inte ha hjälpt oss, eftersom Patroni inte har som uppgift att övervaka serverns tillstånd, diskens tillstånd. Vi måste övervaka sådana situationer med extern monitorering. Vi lade till diskövervakning i den externa monitoreringen snabbt.
Och det fanns en tanke – skulle fencing eller mjukvaru-watchdog kunna hjälpa oss? Vi trodde att det troligen inte skulle ha hjälpt oss i det här fallet, eftersom Patroni fortsatte att interagera med DCS-klustret under problemen och inte såg något problem. Det vill säga, från DCS:s och Patronis synpunkt var det inga problem med klustret, även om det i verkligheten fanns diskproblem och problem med tillgängligheten av databasen.
Enligt min åsikt är detta ett av de konstigaste problemen som jag undersökte mycket länge, läste igenom många loggar och jag kallade det kluster-simuleringen.
Problemet var att den gamla master-databasen inte kunde bli en normal replik, det vill säga Patroni startade den, Patroni visade att denna nod fanns som replik, men samtidigt var den inte en normal replik. Nu kommer du att se varför. Detta sparade jag från analysen av det problemet.
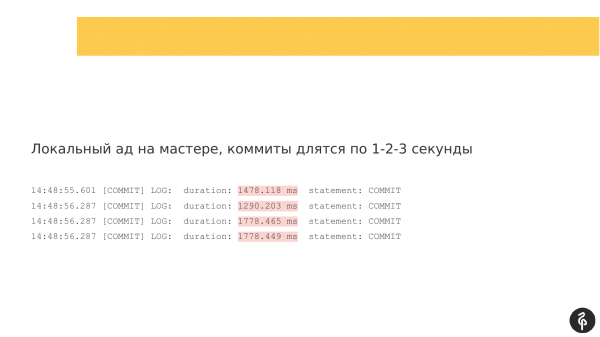
Och hur började allt? Det började, som i det föregående problemet, med diskproblem. Vi hade commits per sekund, en eller två.
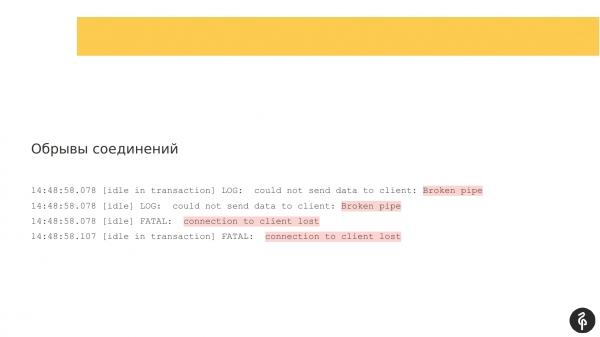
Det var avbrott i anslutningar, det vill säga kunderna blev diskontinuerliga.
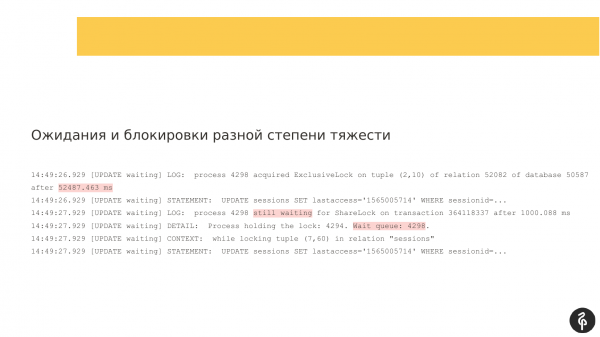
Det fanns blockeringar av olika svårighetsgrad.
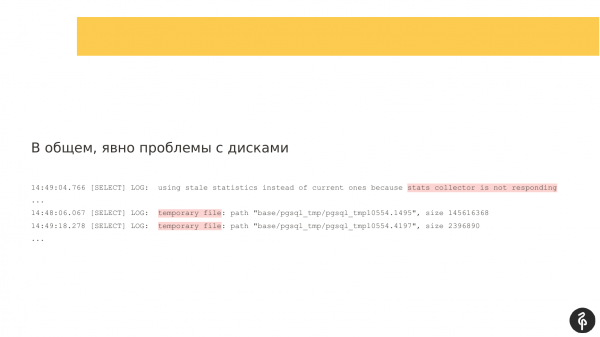
Och därmed var diskunderhållssystemet inte särskilt responsivt.
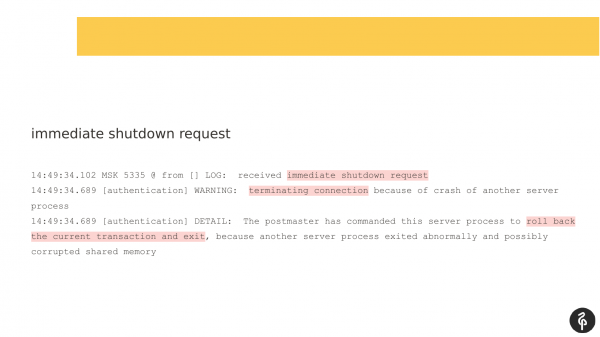
Och det mest mystiska för mig var den omedelbara avstängningsbegäran. Postgres har tre avstängningslägen:
- Detta är graceful, när vi väntar på att alla kunder ska stänga av sig själva.
- Det finns fast, när vi tvingar kunder att stänga av sig, eftersom vi går för att stänga av.
- Och immediate. I det här fallet meddelar inte ens immediate kunderna att de behöver stänga av sig, det stängs bara av utan förvarning. Och alla kunder får ett meddelande från operativsystemet RST (TCP-meddelande om att anslutningen har avbrutits och att kunden inte längre har något att hämta).
Vem skickade den här signalen? Bakgrundsprocesser i Postgres skickar inte sådana signaler till varandra, det vill säga, det är kill -9. De skickar inte sådana signaler till varandra, de reagerar bara på sådana, så det är en akut omstart av Postgres. Jag vet inte vem som skickade den.
Jag kollade kommandot "last" och såg en person som också loggade in på den här servern tillsammans med oss, men jag kände mig obekväm med att ställa frågan. Kanske var det kill -9. Jag skulle ha sett kill -9 i loggarna, eftersom Postgres skriver att den har tagit emot kill -9, men jag såg inte detta i loggarna.
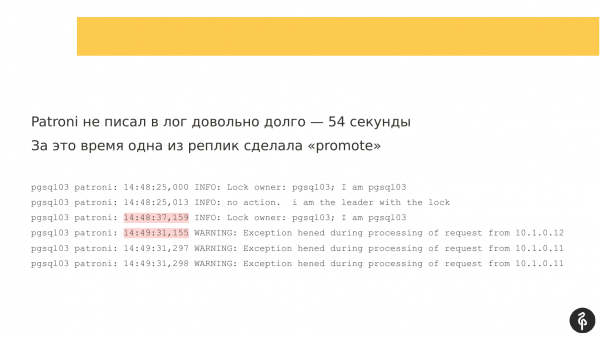
Vid vidare granskning såg jag att Patroni inte hade skrivit i loggen på ganska länge - 54 sekunder. Och om man jämför två tidsstämplar, här fanns det ungefär 54 sekunder utan meddelanden.
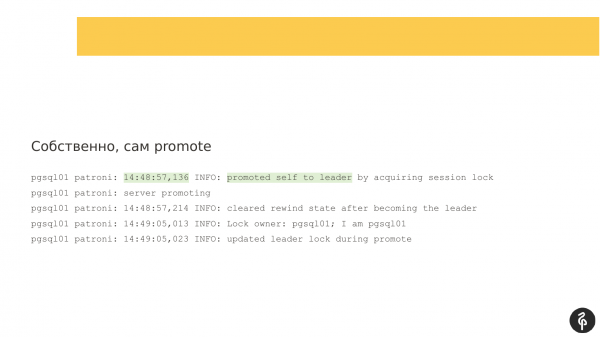
Och under den tiden inträffade en automatisk failover. Patroni fungerade återigen utmärkt. Vår gamla huvudserver var inte tillgänglig, det hände något med den. Och valet av en ny huvudserver inleddes. Här fungerade allt bra. Vår pgsql01 blev den nya ledaren.
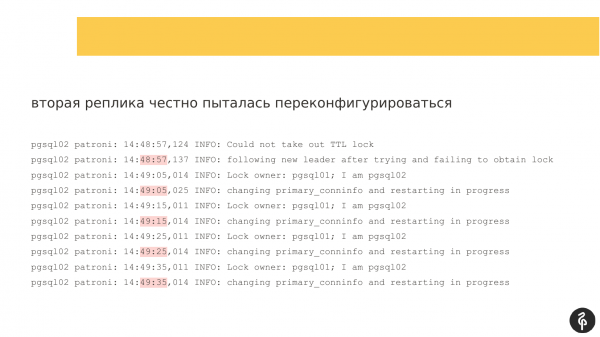
Vi har en replik som blivit huvudserver. Och det finns en andra replik. Och med den andra repliken fanns det just problem. Den försökte rekonfigurera sig. Som jag förstår det försökte den ändra recovery.conf, starta om Postgres och ansluta till den nya huvudservern. Den skriver meddelanden var 10:e sekund att den försöker, men det går inte.
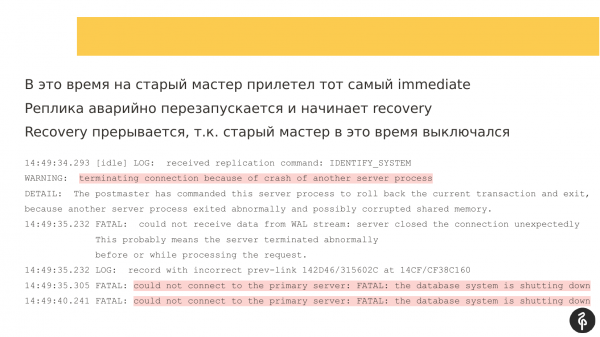
Och under dessa försök får den gamla huvudservern en immediate-shutdown signal. Huvudservern startar om. Och återhämtningsprocessen avbryts också, eftersom den gamla huvudservern går in i omstart. Det vill säga, repliken kan inte ansluta till den, eftersom den är i avstängningsläge.
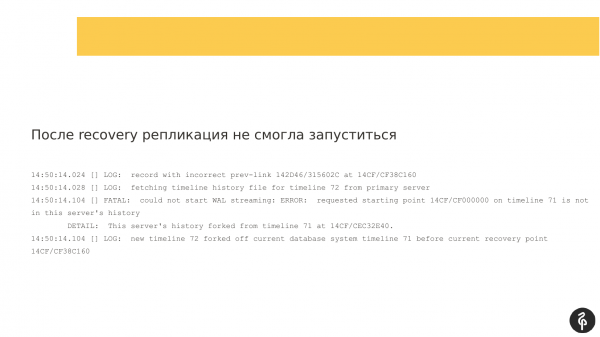
Vid ett tillfälle började den fungera, men replikationen startade inte.
Jag har en enda hypotes, att recovery.conf hade adressen till den gamla huvudservern. Och när den nya huvudservern dök upp, fortsatte den andra repliken att försöka ansluta till den gamla huvudservern.
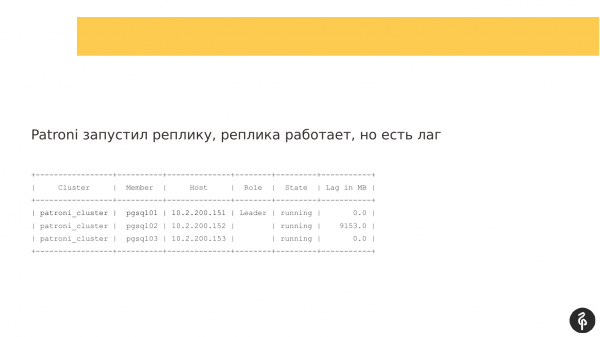
När Patroni startade på den andra repliken, startade noden, men kunde inte ansluta för replikation. Och en replikationsfördröjning uppstod som såg ut ungefär så här. Det vill säga, alla tre noder var på plats, men den andra noden var efter.
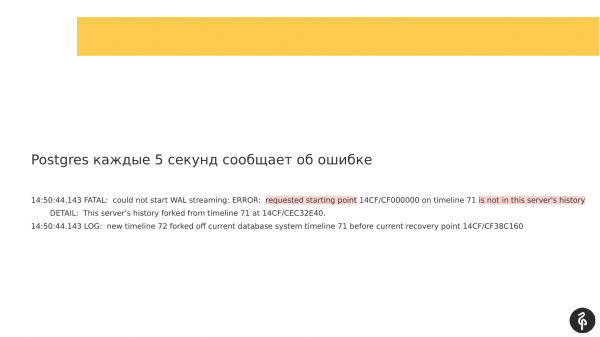
Om man tittar på loggarna som skrevs kan man se att replikeringen inte kan starta eftersom transaktionsloggarna skiljer sig åt. De transaktionsloggar som mästaren erbjuder, som anges i recovery.conf, passar helt enkelt inte vår nuvarande nod.
Här gjorde jag ett misstag. Jag borde ha gått och kikat på vad som fanns i recovery.conf för att kontrollera min hypotes om att vi ansluter oss till fel mästare. Men jag höll precis på att sätta mig in i det här och det slog mig inte, eller så såg jag att replikeringen låg efter och att den måste synkas om, det vill säga jag gjorde det lite slarvigt. Det var mitt misstag.
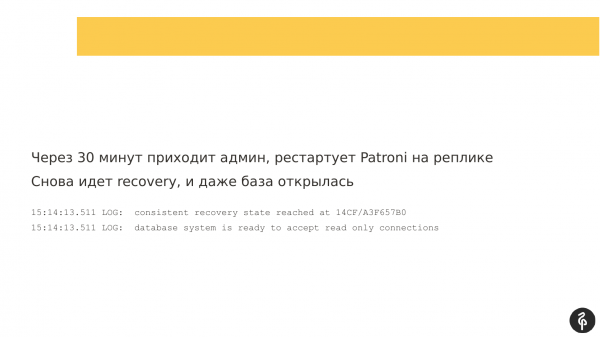
Tretti minuter senare kom administratören, det vill säga jag startade om Patroni på repliken. Jag hade redan gett upp om den, jag trodde att den skulle behöva synkas om. Och jag tänkte – jag startar om Patroni, kanske något bra kan hända. Återställningen startade. Och databasen öppnades till och med, den var redo att ta emot anslutningar.
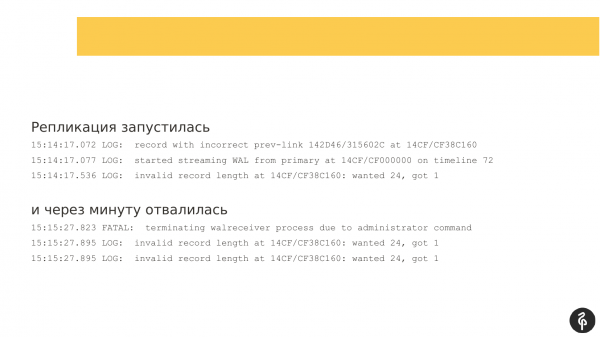
Replikeringen startade. Men efter en minut föll den och gav ett felmeddelande om att transaktionsloggarna inte passade.
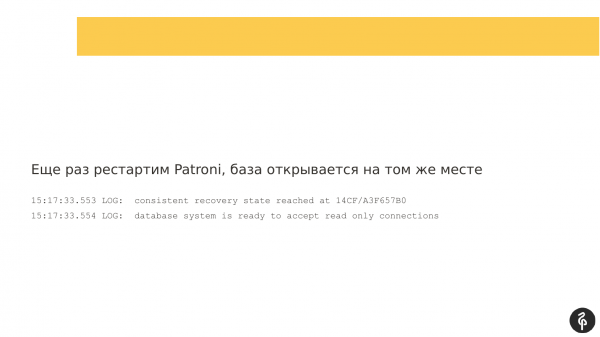
Jag tänkte att jag skulle starta om den en gång till. Jag startade om Patroni igen, och jag startade inte om Postgres, utan just Patroni, i hopp om att den på något magiskt sätt skulle starta databasen.
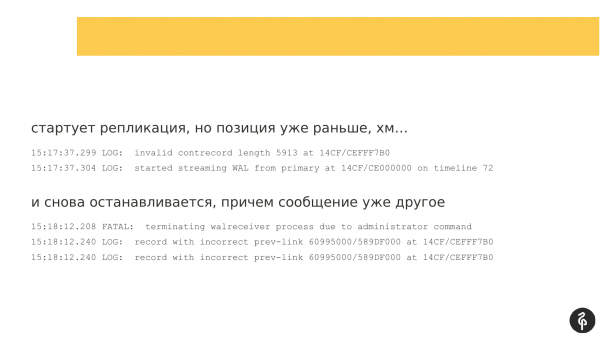
Replikeringen började igen, men märkena i transaktionsloggen skilde sig, de var inte de som fanns vid det tidigare försöket att starta. Replikeringen stoppades igen. Och meddelandet var nu lite annorlunda. Och det var inte särskilt informativt för mig.
Och plötsligt kom jag på – vad händer om jag startar om Postgres, och samtidigt gör jag en checkpoint på den aktuella mästaren för att flytta punkten i transaktionsloggen lite framåt, så att återställningen kan börja från ett annat ögonblick? Plus att vi hade lite WAL-filer sparade.
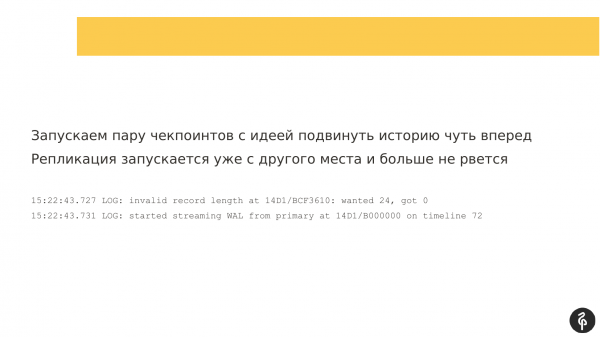
Jag startade om Patroni, gjorde ett par checkpoints på mästaren, ett par restart-punkter på repliken när den öppnades. Och det hjälpte. Jag tänkte länge på varför det hjälpte och hur det fungerade. Och repliken startade. Och replikeringen avbröts inte längre.
Ett sådant problem är en av de mer gåtfulla för mig som jag fortfarande funderar över, vad som egentligen hände.
Vilka slutsatser kan vi dra här? Patroni kan fungera som avsett utan några fel. Men detta är ingen 100% garanti för att allt fungerar bra. En replik kan starta, men den kan befinna sig i ett halvfärdigt tillstånd, och applikationen kan inte arbeta med en sådan replik eftersom där kommer att finnas gamla data.
Och efter varje failover måste vi alltid kontrollera att allt är i ordning med klustret, dvs att vi har det nödvändiga antalet repliker och att det inte finns någon replikationsfördröjning.
Under denna process av att granska dessa problem kommer jag att formulera rekommendationer. Jag försökte sammanfoga dem i två bilder. Antagligen skulle alla historier kunna sammanfattas i två bilder och bara berätta om dem.
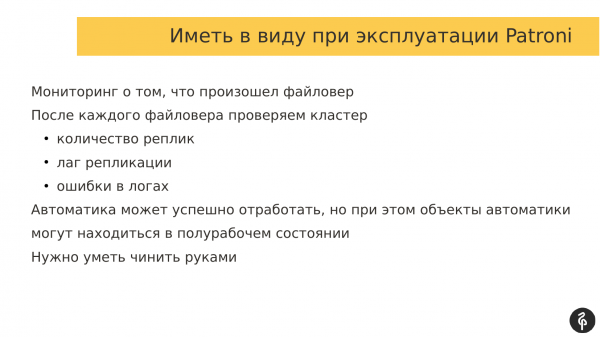
När du använder Patroni måste du ha övervakning. Du måste alltid veta när en auto-failover inträffade, för om du inte vet att du hade en auto-failover, så kontrollerar du inte klustret. Och det är dåligt.
Efter varje failover måste vi alltid manuellt kontrollera klustret. Vi måste försäkra oss om att vi alltid har det aktuella antalet repliker, att det inte finns någon replikationsfördröjning, och att det inte finns några fel i loggarna relaterade till streaming-replikation, Patroni eller DCS-systemet.
Automatiseringen kan fungera bra, Patroni är ett mycket bra verktyg. Den kan fungera, men det kommer inte att leda klustret till det önskade tillståndet. Och om vi inte får veta det kommer vi att ha problem.
Och Patroni är ingen silverkula. Vi måste fortfarande ha en förståelse för hur Postgres fungerar, hur replikation fungerar och hur Patroni interagerar med Postgres, samt hur kommunikationen mellan noder säkerställs. Detta behövs för att kunna lösa problem som uppstår manuellt.
Hur närmar jag mig frågan om diagnostik? Så har det blivit att vi arbetar med olika kunder och ingen har en ELK-stack, så vi måste gå igenom loggarna med sex konsoler och två flikar öppna. I en flik är det loggar för Patroni för varje nod, och i den andra fliken är det loggar från Consul eller Postgres vid behov. Det är mycket svårt att diagnostisera.
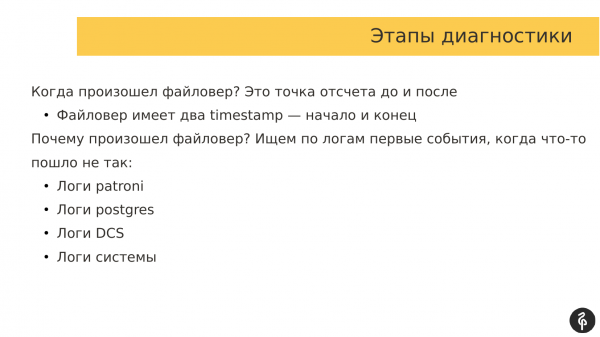
Vilka metoder har jag utvecklat? Först och främst tittar jag alltid på när failovern inträffade. Och för mig är det en slags delgräns. Jag tittar på vad som hände före, under och efter failovern. Failovern har två tidpunkter: en start- och en sluttid.
Därefter tittar jag i loggarna på händelserna före failover, det vill säga jag letar efter orsakerna till varför failover inträffade.
Och det ger en bild av förståelsen för vad som hände och vad som kan göras i framtiden för att undvika sådana omständigheter (och följaktligen för att undvika en failover).
Och vart ser vi vanligtvis? Jag kollar:
- Först i Patroni-loggarna.
- Därefter kollar jag Postgres-loggarna, eller DCS-loggarna beroende på vad som hittades i Patroni-loggarna.
- Och systemloggarna ger ibland också förståelse för vad som var orsaken till failovern.
Hur ser jag på Patroni? Jag anser att Patroni är mycket bra. Enligt min mening är det det bästa som finns idag. Jag känner till många andra produkter. Det finns Stolon, Repmgr, Pg_auto_failover, PAF. Fyra verktyg. Jag har provat dem alla. Patroni gillade jag mest.
Om jag blir frågad: "Rekommenderar jag Patroni?". Jag säger ja, för jag gillar Patroni. Och jag tror att jag har lärt mig att använda det.
Om du är intresserad av att se vilka andra problem som finns med Patroni förutom de problem jag nämnt, kan du alltid gå till sidan på GitHub. Där finns många olika historier och många intressanta problem diskuteras. Och i slutändan har vissa buggar registrerats och lösts, det är intressant läsning.
Där finns intressanta historier om hur folk skjuter sig själva i foten. Mycket lärorikt. Man läser och förstår att man inte ska göra så. Man sätter en bock.
Och jag vill gärna tacka företaget Zalando för att de utvecklar detta projekt, speciellt Alexander Kukushkin och Alexey Klukin. Alexey Klukin är en av medförfattarna, han jobbar inte längre på Zalando, men det är två personer som började arbeta med denna produkt.
Och jag tycker att Patroni är en mycket häftig grej. Jag är glad att den finns, den är intressant. Och stort tack till alla bidragsgivare som skriver patchar i Patroni. Jag hoppas att Patroni med tiden blir mer mogen, fantastisk och funktionell. Den är redan funktionell, men jag hoppas att den blir ännu bättre. Så om du planerar att använda Patroni, tveka inte. Det är en bra lösning, den kan implementeras och användas.
Det var allt. Om ni har några frågor, ställ dem gärna.
Frågor
Tack för presentationen! Om man fortfarande måste titta noga efter en failover, varför behöver vi då en automatisk failover?
För att detta är något nytt. Vi har bara arbetat med det i ett år. Bättre att vara försiktig. Vi vill gå in och se att allt verkligen har fungerat som det ska. Det är en nivå av vuxen misstro – bättre att dubbelkolla och titta.
Till exempel, vi gick in på morgonen och kollade, eller hur?
Inte på morgonen, vi får vanligtvis veta om auto-failover nästan omedelbart. Vi får notiser, vi ser att det har skett en auto-failover. Vi går nästan direkt in och kollar. Men alla dessa kontroller bör läggas på övervakningsnivå. Om vi ansluter till Patroni via REST API, finns det en historik. Genom historiken kan man se tidsstämplar för när failovern inträffade. Baserat på detta kan vi göra övervakning. Vi kan se historiken, hur många händelser det har varit. Om vi har fått fler händelser, betyder det att en auto-failover har inträffat. Man kan gå in och kolla. Antingen har vår automation i övervakningen kontrollerat att alla våra repliker är på plats, att det inte finns något lagg och att allt är bra.
Tack!
Stort tack för en fantastisk berättelse! Om vi har flyttat DCS-klustret långt bort från Postgres-klustret, måste det klustret också underhållas periodiskt? Vilka är bästa praxis när det gäller att stänga av vissa delar av DCS-klustret, göra något med dem osv.? Hur fungerar hela denna struktur under tiden? Och hur gör man dessa saker?
För ett företag behövde vi skapa en matriss över problem, vad som händer om någon av komponenterna eller flera komponenter slutar fungera. Genom denna matris går vi systematiskt igenom alla komponenter och bygger scenarier för vad som händer vid fel på dessa komponenter. Därför kan man för varje fel-scenario ha en handlingsplan för återställning. I fallet med DCS går detta som en del av den standardinfrastruktur. Och administratören hanterar det, och vi litar redan på administratörerna som hanterar det och på deras förmåga att fixa det vid incidenter. Om DCS inte finns, då distribuerar vi det, men vi håller inte särskilt koll på det eftersom vi inte ansvarar för infrastrukturen, men ger rekommendationer om hur och vad man ska övervaka.
Det vill säga, har jag förstått rätt att vi måste stänga av Patroni, stänga av failovern, stänga av allt innan vi gör något med värdarna?
Det beror på hur många noder vi har i DCS-klustret. Om det finns många noder och vi endast gör en nod (replica) otillgänglig, finns det fortfarande konsensus i klustret. Och Patroni förblir funktionellt. Och ingenting triggas. Om vi har några komplexa operationer som berör fler noder, vars frånvaro kan förstöra konsensus, så ja, kanske är det vettigt att pausa Patroni. Den har en motsvarande kommando – patronictl pause, patronictl resume. Vi sätter bara på paus och automatisk failover aktiveras inte under denna tid. Vi gör underhåll på DCS-klustret, sedan tar vi pausen bort och fortsätter som vanligt.
Stort tack!
Stort tack för presentationen! Hur ser produktteamet på risken för databasförlust?
Produktteam bryr sig inte, men teamledarna är oroliga.
Vilka garantier finns?
Det är väldigt svårt med garantier. Det finns en presentation av Alexander Kukushkin "Hur man beräknar RPO och RTO", dvs. tid för återställning och hur mycket data vi kan förlora. Jag tror att vi måste hitta dessa bilder och studera dem. Såvitt jag minns finns det specifika steg för hur man beräknar dessa saker. Hur många transaktioner vi kan förlora, hur mycket data vi kan förlora. Som alternativ kan vi använda synkron replikering på Patroni-nivå, men det är en dubbelteckning: vi antingen får datats pålitlighet eller förlorar hastighet. Det finns synkron replikering, men det garanterar inte 100% skydd mot databasförlust.
Alexei, tack för den utmärkta presentationen! Finns det erfarenhet av att använda Patroni för zero level protection? Dvs. tillsammans med synkron standby? Det är den första frågan. Och den andra frågan. Ni har använt olika lösningar. Vi använde Repmgr, men utan automatisk failover och planerar nu att koppla på automatisk failover. Vi överväger att använda Patroni som en alternativ lösning. Vad kan ni säga om fördelarna jämfört med Repmgr?
Den första frågan handlade om synkrona repliker. Ingen använder synkron replikering hos oss, för alla är rädda (Flera kunder använder redan den, och vi har inte märkt några prestandaproblem — Anmärkning från talaren). Men vi har utvecklat en regel för oss själva att det i en klynga med synkron replikering måste finnas minst tre noder, eftersom om vi har två noder och antingen master eller en replik går ner, så går Patroni över den noden till Standalone-läge för att applikationen ska fortsätta fungera. I det här fallet finns det risker för dataloss.
Angående den andra frågan har vi använt Repmgr och använder fortfarande det hos vissa kunder av historiska skäl. Vad kan man säga? I Patroni är auto-failover inbyggt, medan i Repmgr är auto-failover en extra funktion som måste aktiveras. Vi behöver starta Repmgr-daemonen på varje nod, så kan vi konfigurera auto-failover.
Repmgr kontrollerar om Postgres-noderna är aktiva. Repmgr-processerna kontrollerar varandras existens, vilket inte är en särskilt effektiv strategi då det kan förekomma komplexa fall av nätverksisolering där en stor Repmgr-klynga kan splittras i flera små och fortsätta fungera. Jag har inte följt Repmgr på länge, kanske har de fixat detta… eller kanske inte. Men att föra ut information om klyngans status till DCS, som görs av Stolon och Patroni, är den mest livskraftiga lösningen.
Alexey, jag har en fråga, kanske en lite okunnig. I ett av de tidigaste exemplen flyttade ni DCS från en lokal maskin till en fjärrnod. Vi förstår att nätverket har sina egna egenskaper, det lever sitt eget liv. Vad händer om DCS-klyngan blir otillgänglig av någon anledning? Jag tänker inte gå in på orsaker, det kan finnas många: allt från dåligt arbete av nätverksingenjörer till verkliga problem.
Jag har inte sagt detta högt, men DCS-klyngan måste också vara driftsäker, det vill säga ha ett udda antal noder så att kvorum kan samlas. Vad händer om DCS-klyngan blir otillgänglig, eller om kvorum inte kan samlas, till exempel vid en nätverksdelning eller nodfel? I det här fallet går Patroni-klyngan in i read only-läge. Patroni-klyngan kan inte avgöra klyngans tillstånd och vad den ska göra. Den kan inte kommunicera med DCS och spara det nya tillståndet för klyngan där, så hela klyngan går in i read only-läge. Den väntar antingen på manuell intervention från operatören eller på att DCS ska återställas.
I grova drag blir DCS för oss en tjänst som är lika viktig som databasen själv?
Ja, precis. I många moderna företag är Service Discovery en oumbärlig del av infrastrukturen. Det implementeras oftast ännu tidigare än databaserna i infrastrukturen. Man kan säga att man har startat infrastrukturen, rullat ut i datacentret, och man har redan Service Discovery på plats. Om det är Consul, kan DNS byggas på det. Om det är Etcd, kan det vara en del av en Kubernetes-kluster där all annan funktionalitet kommer att rullas ut. Jag tror att Service Discovery redan är en integrerad del av moderna infrastrukturer. Man börjar tänka på det mycket tidigare än på databaser.
Tack!
Källa: habr.com
