

Hej, Habr!
Vi påminner om att vi har släppt en ny, extremt intressant och användbar om mönster för Kubernetes. Allt började med "" av Brendan Burns, och för övrigt är vårt arbete inom detta område . Idag erbjuder vi dig att läsa ett inlägg från MinIO:s blogg som kortfattat redogör för trenderna och specifikationen av datalagringsmönster i Kubernetes.
Kubernetes har fundamentalt förändrat de traditionella mönstren för utveckling och distribution av applikationer. Teamet kan nu ta bara några dagar för att utveckla, testa och distribuera en applikation – i olika miljöer, allt inom Kubernetes-kluster. Ett sådant arbete med tidigare generationers teknik tog vanligtvis flera veckor, om inte månader.
Denna acceleration blev möjlig tack vare den abstraktion som Kubernetes erbjuder — det vill säga, tack vare att Kubernetes själv hanterar interaktionen med de lågnivådetaljer av fysiska eller virtuella maskiner, vilket gör att användarna kan specificera bland annat den önskade processorn, den önskade mängden minne och antalet instanser av containrar. Eftersom en enorm gemenskap är engagerad i att stödja Kubernetes och användningen av Kubernetes ständigt växer, leder den med stor marginal bland alla plattformar för orkestrering av containrar.
I takt med att användningen av Kubernetes ökar, växer också förvirringen kring de datalagringsmönster som används i den..
Vid den allmänna konkurrensen om en bit av kakan (dvs. datalagring), när det kommer till datalagring, drunknar signalen i ett starkt brus.
Kubernetes representerar den moderna modellen för utveckling och distribution av applikationer samt hanteringen av dem. Denna moderna modell frikopplar datalagring från beräkningar. För att helt förstå denna frikoppling i samband med Kubernetes är det också nödvändigt att förstå vad som menas med applikationer som arbetar med och utan tillstånd, samt hur datalagring passar in i detta. Här har REST API-ansatsen, som används av S3, tydliga fördelar jämfört med den POSIX/CSI-ansats som är typisk för andra lösningar.
I den här artikeln kommer vi att prata om mönster för datalagring i Kubernetes och vi kommer särskilt att beröra diskussionen om applikationer som arbetar med och utan bestående tillstånd, för att verkligen förstå vad som skiljer dem åt och varför det är viktigt. Härefter kommer applikationer och de mönster för datalagring som används i dem att diskuteras utifrån bästa praxis för arbete med containrar och Kubernetes.
Containrar utan bestående tillstånd
Containrar är per definition lätta och efemära. De kan lätt stoppas, tas bort eller distribueras på en annan nod – allt detta tar bara några sekunder. I stora system för orkestrering av containrar sker sådana operationer hela tiden, och användarna lägger knappt märke till dessa förändringar. Emellertid är flyttningar möjliga endast om containern inte har några beroenden från den nod där den är placerad. Sådana containrar sägs arbeta utan bestående tillstånd.
Containrar med bestående tillstånd
Om en container lagrar data på lokalt anslutna enheter (eller på blockenheter), måste datalagret som det ligger på flyttas till en ny nod tillsammans med själva containern – vid ett fel. Detta är viktigt, eftersom annars kan inte applikationen som körs i containern fungera korrekt, eftersom den måste komma åt data som lagras på lokala medium. Sådana containrar sägs arbeta med bestående tillstånd.
Ur en rent teknisk synvinkel kan containrar med bestående tillstånd också flyttas till andra noder. Detta uppnås vanligtvis genom distribuerade filsystem eller blocklagringssystem knutna till alla noder där containrarna körs. På så sätt får containrarna åtkomst till volymer för bestående datalagring, och informationen lagras på diskar som finns spridda över hela nätverket. Denna metod kommer jag att kalla "containeranslaget med bestående tillstånd", och i resten av artikeln kommer jag att referera till det på detta sätt för enhetlighet.
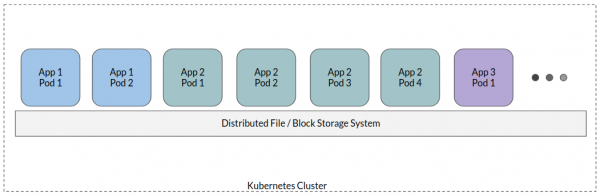
Vid en typisk containeransats med behållning av tillstånd binds alla applikationens pods till ett distribuerat filsystem – det blir en slags delad lagring där all applikationsdata finns. Även om det kan finnas vissa variationer, är detta en hög nivå av tillvägagångssätt.
Låt oss nu utforska varför behållande av tillstånd i en containeransats i en molncentrerad värld är ett antipattern.
Molncentrerad applikationsdesign
Traditionellt använde applikationer databaser för strukturerad informationslagring och lokala enheter eller distribuerade filsystem där all icke-strukturerad eller halvstrukturerad data sparades. I takt med att volymen av icke-strukturerad data ökade, insåg utvecklarna att POSIX var alltför "pratsam", med betydande kostnader och, i slutändan, hindrade applikationens funktionalitet när det kom till verkligt stora skalor.
Detta bidrog huvudsakligen till framväxten av en ny datalagringsstandard, det vill säga molncentrerade lagringssystem som främst fungerar via REST API och avlastar applikationen från bördan av att underhålla lokal datalagring. I det här fallet arbetar applikationen faktiskt i ett tillståndslöst läge (eftersom tillståndet finns i det fjärrlagrade systemet). Moderna applikationer byggs från grunden med hänsyn till denna faktor. Generellt sett är varje modern applikation som hanterar data av olika slag (loggar, metadata, blobs etc.) konstruerad utifrån en molncentrerad paradigm där tillståndet flyttas till ett specifikt programvarusystem avsett för dess lagring.
Den containerbaserade ansatsen med behållning av tillstånd tvingar hela denna paradigm att återvända till exakt det där det började!
När man använder POSIX-gränssnitt för lagring av data fungerar applikationerna på samma sätt som om de sparade tillstånd, och på grund av detta avviker de från de mest grundläggande postulaten för molnorienterad design, det vill säga möjligheten att variera storlekarna på applikationens arbetsflöden beroende på den inkommande belastningen, flytta till en ny nod så snart den aktuella noden misslyckas, och så vidare.
När vi granskar denna situation mer noggrant upptäcker vi att vi vid valet av datalagring gång på gång ställs inför dilemmat "POSIX kontra REST API", MEN med en ytterligare förvärring av POSIX-problemen, vilket beror på den distribuerade naturen hos Kubernetes-miljöer. Specifikt,
- POSIX pratsam: semantiken för POSIX kräver att associera metadata och filhandtag med varje operation, vilket hjälper till att upprätthålla operationens tillstånd. Detta leder till betydande kostnader utan något verkligt värde. API:er för objektlagring, särskilt S3 API, har tagit bort dessa krav, vilket gör att applikationen kan fungera och sedan "glömma" anropet. Svar från datalagringssystemet indikerar om denna åtgärd utfördes framgångsrikt eller inte. Vid misslyckande kan applikationen göra ett försök igen.
- Nätverksbegränsningar: I ett distribuerat system innebär det att det kan finnas många applikationer som försöker skriva data på samma bifogade lagringsmedium. Därför, inte bara kommer applikationer att konkurrera med varandra om bandbredd (för att skicka data till lagringsmediet), utan själva lagringssystemet kommer också att konkurrera om denna bandbredd, samtidigt som det distribuerar data över fysiska diskar. På grund av POSIX:s pratighet ökar antalet nätverksanrop flera gånger. Å andra sidan erbjuder S3 API en tydlig uppdelning av nätverksanrop mellan de som kommer från klienten till servern och de som förekommer inom servern.
- Säkerhet: POSIX-säkerhetsmodellen är utformad för aktivt människoinvolvering: administratörer konfigurerar specifika åtkomstnivåer för varje användare eller grupp. En sådan paradigm är svår att anpassa till en molnorienterad värld. Moderna applikationer är beroende av säkerhetsmodeller kopplade till API:er, där åtkomsträttigheter definieras som en uppsättning policyer, tjänstekonton, tillfälliga autentiseringar osv.
- Hantera: Tillståndshanterande containrar medför vissa kostnader i samband med hanteringen. Det handlar om att synkronisera parallell åtkomst till data, att säkerställa datakonsistens – allt detta kräver att noggrant överväga vilka datåtkomstmönster som används. Ytterligare program måste installeras, kontrolleras och konfigureras, för att inte nämna den extra arbetsinsats som krävs för utveckling.
Containernas datalagringsgränssnitt
Medan det containerbaserade datalagringsgränssnittet (CSI) har bidragit till spridningen av volymlagret i Kubernetes, delvis genom att överföra det till tredjeparts datalagringsleverantörer, har det också oavsiktligt bidragit till övertygelsen om att en containerbaserad tillståndshantering är den rekommenderade metoden för datalagring i Kubernetes.
CSI utvecklades som en standard för att tillhandahålla godtyckliga block- och filbaserade datalagringssystem till ärvda applikationer i samband med Kubernetes. Och som visats i denna artikel är den enda situation där en containerbaserad tillståndshantering (och CSI i dess nuvarande form) är rimlig när själva applikationen är en ärvd system där det är omöjligt att lägga till stöd för API:er för objektlagring.
Det är viktigt att förstå att när vi använder CSI i dess nuvarande form, det vill säga monterar volymer när vi arbetar med moderna applikationer, kommer vi att stöta på ungefär samma problem som uppstod i system där datalagringen organiserades i POSIX-stil.
En mer kvalitativ strategi
I det här fallet är det viktigt att förstå att de flesta applikationer i grunden inte är designade för att fungera med enhetligt tillstånd eller utan bevarande av tillstånd. Detta beteende beror på systemets övergripande arkitektur och de specifika val som gjorts vid designen. Låt oss prata lite om applikationer som bevarar tillstånd.
I princip kan alla applikationsdata delas in i flera breda typer:
- Loggdata
- Tidsstämpeldatan
- Transaktionsdata
- Metadat
- Containermallar
- Blobdata (stora binära objekt)
Alla dessa datatyper stöds mycket väl på moderna datalagringsplattformar, och det finns flera molnbaserade plattformar anpassade för att leverera data i vart och ett av dessa specifika format. Till exempel kan transaktionsdata och metadata finnas i en modern molnbaserad databas, såsom CockroachDB, YugaByte osv. Containermallar eller blobdata kan lagras i en docker-register baserat på MinIO. Tidsstämpeldatan kan lagras i en tidsseriedatabas, exempelvis InfluxDB osv. Vi kommer inte att gå in på detaljer om varje datatyp och motsvarande applikationer här, men den övergripande idén är att undvika persistent datalagring baserat på lokal montering av diskar.
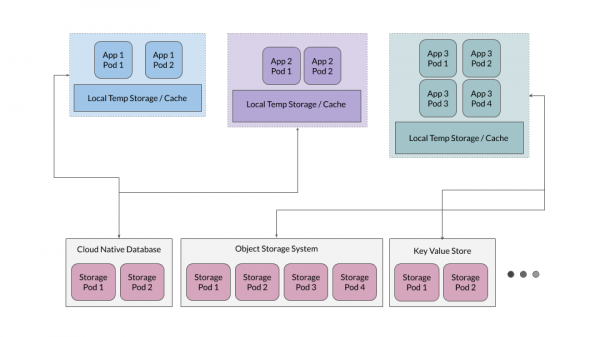
Dessutom visar det sig ofta vara effektivt att tillhandahålla en nivå av tillfällig caching, som fungerar som ett slags lagring för temporära filer för applikationer, men applikationerna bör inte vara beroende av denna nivå som en sanningens källa.
Lagring för applikationer med tillstånd
När det i de flesta fall är användbart att hålla applikationer utan tillstånd, bör de applikationer som är avsedda för datalagring – som databaser, objektlagringssystem, nyckel-värde-lagringssystem – bevara tillstånd. Låt oss förstå varför dessa applikationer deployeras på Kubernetes. Som exempel kan vi ta MinIO, men liknande principer gäller för alla andra stora molnbaserade datalagringssystem.
Molnbaserade applikationer designas för att maximalt utnyttja flexibiliteten hos containrar. Detta innebär att inga antaganden görs om den miljö där de kommer att distribueras. Till exempel använder MinIO en inbyggd mekanism för redundant kodning (erasure coding), vilket ger systemet tillräcklig motståndskraft för att förbli operativt även om hälften av diskarna går ner. Dessutom hanterar MinIO integriteten och säkerheten hos data genom att använda egen hashning och kryptering på serversidan.
För sådana molnbaserade applikationer är lokala persistenta volymer (PV) det mest praktiska valet som backup-lagringslösning. En lokal PV ger möjlighet att lagra rådata, medan applikationer som körs ovanpå dessa PV: er självständigt samlar information för att möjliggöra dataskalering och hantering av ökande datakrav.
Denna strategi är mycket enklare och skalar betydligt bättre jämfört med PV baserade på CSI, som introducerar sina egna datastyrnings- och redundansnivåer i systemet; problemet är att dessa nivåer vanligtvis krockar med applikationer designade för att vara stateful.
Säker rörelse mot avkopplade data från beräkningar
I denna artikel har vi diskuterat hur applikationer omformuleras för att arbeta utan att vara stateful, eller med andra ord, hur datalagring avskiljs från beräkningar. Avslutningsvis kommer vi att titta på några verkliga exempel på denna trend.
, den berömda plattformen för dataanalys, har traditionellt använts med stateful driftsättning i filsystemet HDFS. Men i takt med att Spark går mot en molnbaserad värld används denna plattform alltmer utan stateful hantering med hjälp av `s3a`. Spark använder s3a för att överföra tillstånd till andra system, medan själva Spark-containrarna arbetar helt utan att spara tillstånd. Andra stora aktörer inom analys av stora data, särskilt , , , övergår också till att arbeta med separation av datalagring och beräkningar.
Liknande mönster återfinns också på andra stora analytiska plattformar, såsom Presto, Tensorflow till R, Jupyter. Genom att exportera tillståndet till fjärrmolnlagringssystem blir det mycket enklare att hantera din applikation och skala den. Dessutom bidrar detta till applikationens portabilitet i olika miljöer.
Källa: habr.com
