

För tre år sedan på scenen presenterade Viktor Tarnavsky och Alexey Milovidov från Yandex HighLoad++ , hur bra ClickHouse är, och hur snabbt det är. På en intilliggande scen fanns Alexander Zaytsev med om flytten till ClickHouse från en annan analytisk databas med slutsatsen att ClickHouse, förstås, är bra, men inte särskilt bekväm. När företaget LifeStreet, där Alexander då arbetade, flyttade sin multipetabytes analytiska system till ClickHouse, var det en spännande "väg av gult tegel" full av okända faror — ClickHouse det kändes som ett minfält.
Tre år senare ClickHouse har blivit mycket bättre — under denna tid grundade Alexander företaget Altinity, som inte bara hjälper till med flytten till ClickHouse tio projekt, utan också förbättrar produkten tillsammans med sina kollegor på Yandex. Nu ClickHouse är det fortfarande ingen bekymmerslös promenad, men det är inte längre ett minfält.
Alexander har arbetat med distribuerade system sedan 2003 och har utvecklat stora projekt på MySQL, Oracle och Vertica. På den nyligen hållna HighLoad++ 2019 berättade Alexander, en av pionjärerna inom användningen av ClickHouse, hur denna databas ser ut idag. Vi får veta om de viktigaste funktionerna ClickHouse: hur den skiljer sig från andra system och i vilka fall den är mer effektiv att använda. Vi kommer att titta på färska och beprövade projekt för att bygga system på ClickHouse.
Retrospektiv: vad hände för 3 år sedan
För tre år sedan flyttade vi företaget LifeStreet till ClickHouse från en annan analytisk databas, och migreringen av reklamnätverkets analys såg ut så här:
- Juni 2016. I OpenSource uppträdde ClickHouse och vårt projekt startade;
- Augusti. Proof Of Concept: ett stort reklamnätverk, infrastruktur och 200-300 terabyte data;
- Oktober. De första produktionsdata;
- December. Fullständig produktbelastning — 10-50 miljarder händelser per dag.
- Juni 2017. Framgångsrik flytt av användare till ClickHouse, 2,5 petabyte data på en kluster av 60 servrar.
Under migreringen ökade förståelsen för att ClickHouse — det är ett bra system som är trevligt att arbeta med, men det är ett internt projekt av Yandex. Så det finns nyanser: Yandex kommer först att hantera sina egna interna beställare och först därefter — gemenskapen och behoven hos externa användare, och ClickHouse nådde då inte upp till enterprise-nivå inom många funktionella områden. Så i mars 2017 grundade vi företaget Altinity för att göra ClickHouse ännu snabbare och enklare för inte bara Yandex, utan också för andra användare. Och nu vi:
- Utbildar och hjälper till att bygga lösningar på ClickHouse så att kunderna inte gör misstag och så att lösningen faktiskt fungerar;
- Säkerställer 24/7 support ClickHouse-installationer;
- Utvecklar egna ekosystemprojekt;
- Aktivt åtar oss ClickHouse, som svarar på användarnas förfrågningar om att se vissa funktioner.
Och självklart hjälper vi till med övergången till ClickHouse med MySQL, Vertica, Oracle, Greenplum, Redshift och andra system. Vi har deltagit i olika övergångar, och alla har varit framgångsrika.
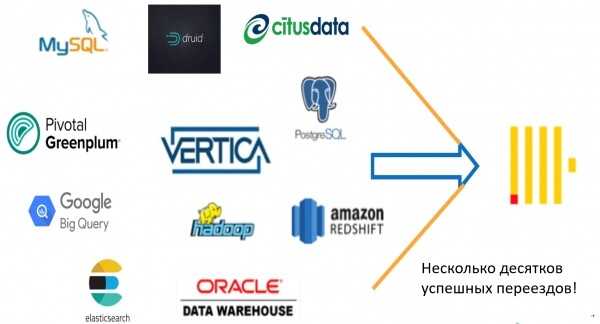
Varför ens övergå till ClickHouse
Det bromsar inte! Detta är den främsta anledningen. ClickHouse — en mycket snabb databas för olika scenarier:
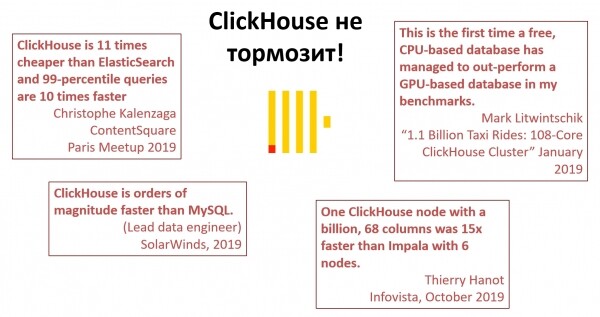
Slumptalscitat från personer som har arbetat länge med ClickHouse.
Skalbarhet. På en annan databas kan man uppnå bra prestanda på en enskild maskin, men ClickHouse kan skalas inte bara vertikalt, utan också horisontellt, helt enkelt genom att lägga till servrar. Allt fungerar inte alltid så smidigt som man skulle vilja, men det fungerar. Man kan växa systemet i takt med företagets tillväxt. Det är viktigt att vi inte är begränsade av lösningen just nu och alltid har potential för utveckling.
Portabilitet. Ingen bindning till något speciellt. Till exempel med Amazon Redshift är det svårt att flytta någonstans. Men ClickHouse kan installeras på sin bärbara dator, server, deployas i molnet, gå in i Kubernetes — det finns inga begränsningar på drift av infrastrukturen. Det är bekvämt för alla, och det är en stor fördel som många andra liknande databaser inte kan skryta med.
Flexibilitet. ClickHouse stannar inte vid något speciellt, som Yandex.Metrica, utan utvecklas och används i allt fler olika projekt och industrier. Det kan utvidgas genom att lägga till nya funktioner för att lösa nya uppgifter. Till exempel anses det att lagra loggar i databasen är en brist, så för detta uppfanns Elasticsearch. Men, tack vare flexibiliteten i ClickHouse, kan man också lagra loggar där, och ofta är det till och med bättre än i Elasticsearch — i ClickHouse för detta krävs 10 gånger mindre hårdvara.
Gratis Öppen källkod. Inga kostnader. Ingen överenskommelse behövs för att installera systemet på sin bärbara dator eller server. Inga dolda avgifter. Inga andra databasteknologier med öppen källkod kan konkurrera med hastigheten hos ClickHouse. MySQL, MariaDB, Greenplum — alla är mycket långsammare.
Gemenskap, driv och kul. Vi ClickHouse ett utmärkt samhälle: meetups, chattar och Alexey Milovidov, som ger oss all energi och optimism.
Flytt till ClickHouse
För att migrera till ClickHouse från något annat, behövs bara tre saker:
- Förstå begränsningarna ClickHouse och när det inte passar.
- Utnyttja fördelarna med teknologin och dess starkaste sidor.
- Experimentera. Även om man förstår hur ClickHousefungerar, är det inte alltid möjligt att förutse när det kommer att vara snabbare, när långsammare, när bättre och när sämre. Så försök.
Problemet med migrationen
Det finns bara ett "men": om du flyttar till ClickHouse från något annat, är det vanligtvis något som går fel. Vi är vana vid vissa praxis och saker som fungerar i vår favoritdatabas. Till exempel anser alla som arbetar med SQL-databaser att ett visst urval av funktioner är obligatoriska:transaktioner;
- constraints;
- consistency;
- index;
- UPDATE/DELETE
- NULLs;
- millisekunder;;
- automatiska typkonverteringar;
- flera joins;
- fria partitioner;
- klusterhanteringsverktyg.
- Settet är obligatoriskt, men för tre år sedan fanns det inga av dessa funktioner i
. Nu finns mindre än hälften av det som inte har genomförts kvar: transaktioner, constraints, consistency, millisekunder och typkonvertering. ClickHouse Och viktigast av allt— i
fungerar vissa standardpraxis och tillvägagångssätt inte eller fungerar inte på det sätt som vi är vana vid. Allt som dyker upp i ClickHouse följer " ClickHouseClickHouse way", dvs. funktioner skiljer sig från andra databaser. Till exempel:Index väljs inte, utan hoppar över.
- är inte synkrona, utan asynkrona.
- NULLs Flera joins finns, men det finns ingen frågeplanerare. Hur de då utförs är överhuvudtaget inte särskilt klart för personer från databasvärlden.
- ClickHouse-scenarier
År 1960 skrev den amerikanske matematikern med ungerskt ursprung
Wigner E. P. en artikel " The unreasonable effectiveness of mathematics in the natural sciences" om att den omgivande världen av någon anledning beskrivas väl av matematiska lagar. Matematiken är en abstrakt vetenskap, och de fysikaliska lagarna, som uttrycks i matematisk form, är inte triviala, ochbetonade att det är mycket konstigt. en artikel " Ur min synvinkel,
— är samma slags underlighet. Omskriver man Wigner kan man säga så här: den ofattbara effektiviteten är ClickHouse i de mest varierande analytiska tillämpningar! ClickHouse Till exempel, låt oss ta
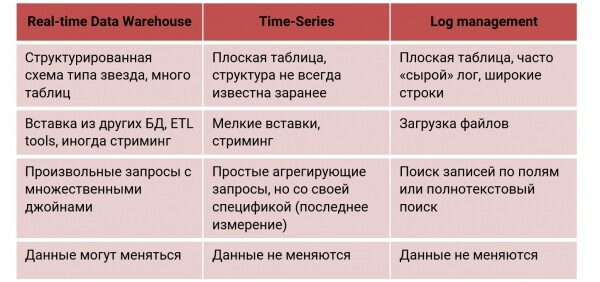
Real-Time Data Warehouse. Data Warehouse i Realtid, där data laddas nästan kontinuerligt. Vi vill ta emot förfrågningar från den med en sekunders försening. Vänligen - använd ClickHouse, eftersom det var just för detta scenario som det utvecklades. ClickHouse precis så används det inte bara inom webben, utan även inom marknadsföring och finansiell analys, AdTech, samt inom Bedrägeridetektion. I Real-time Data Warehouse används en komplex strukturerad schema av typ 'stjärna' eller 'snöflinga', många tabeller med JOIN (ibland flera), och data lagras och ändras vanligtvis i olika system.
Låt oss ta ett annat scenario - Tidsserie: övervakning av enheter, nätverk, användningsstatistik, internet of things. Här stöter vi på tidsordnade, ganska enkla händelser. ClickHouse för detta var inte ursprungligen utvecklat, men det har visat sig fungera bra, och därför använder stora företag ClickHouse som ett lagringsutrymme för övervakningsinformation. För att undersöka om ClickHouse är lämpligt för tidsserier, gjorde vi en benchmark baserat på metoden och resultaten InfluxDB och TimescaleDB — specialiserade tidsserie databaser. , att ClickHouse, även utan optimering för sådana uppgifter, vinner och på andras plan:
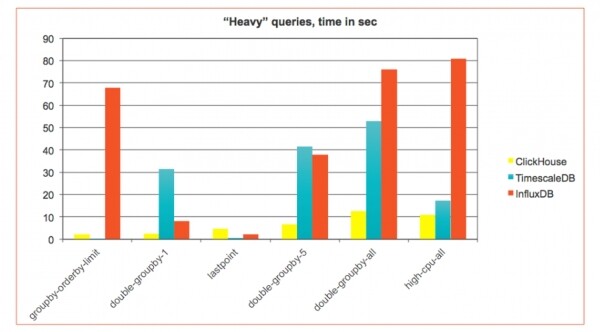
I tidsserie används vanligtvis en smal tabell - några små kolumner. Det kan komma en mycket stor mängd data från övervakningen - miljoner poster per sekund - och vanligtvis kommer de i små insättningar (real-time streaming). Därför behövs ett annat insättningsscenario, och själva förfrågningarna har sin egen specifika karaktär.
Loggförvaltning. Att samla loggar i databasen är vanligtvis dåligt, men i ClickHouse kan det göras med vissa förbehåll, som beskrivits ovan. Många företag använder ClickHouse just för detta. I detta fall används en platt, bred tabell, där vi lagrar loggar helt (till exempel i form av JSON), eller delar upp dem. Data laddas vanligtvis i stora batchar (filer), och vi söker efter ett visst fält.
För varje av dessa funktioner används vanligtvis specialiserade databaser. ClickHouse en kan göra allt detta så bra att den överträffar dem i prestanda. Låt oss nu titta noggrant på tidsserie scenariot, och hur man korrekt förbereder ClickHouse för detta scenario.
Tidsserie
I nuläget är detta huvudsakliga scenariot, för vilket ClickHouse betraktas som en standardlösning. Tidsserie – är en uppsättning tidsordnade händelser som representerar förändringar i en process över tid. Till exempel kan det vara pulsfrevens under en dag eller antalet processer i systemet. Allt som ger tidsstämplar med något mått – är detta tidsserie:
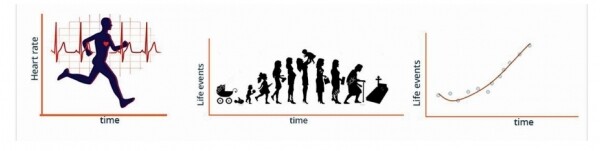
Den största mängden sådana händelser kommer från övervakning. Det kan vara inte bara övervakning av webben, utan även av verkliga enheter: bilar, industriella system, IoT, fabriker eller självkörande taxibilar, i vars bagageutrymme Yandex redan nu lägger ClickHouse-servrar.
Till exempel finns det företag som samlar in data från fartyg. Varje några sekunder skickar sensorer från ett containerfartyg hundratals olika mått. Ingenjörer studerar dem, bygger modeller och försöker förstå hur effektivt fartyget används, eftersom containerfartyget inte ska stå still en sekund. Allt stillestånd är en förlust av pengar, så det är viktigt att förutsäga rutten så att stoppen blir minimala.
Det finns en ökande mängd specialiserade databaser som mäter tidsserie. På webbplatsen DB-Engines rankas olika databaser på något sätt, och de kan ses efter typer:
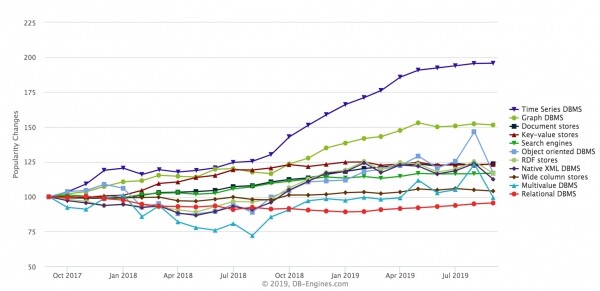
Den snabbast växande typen är tidsserier. Grafdatabaser växer också, men tidsserierväxer snabbare de senaste åren. Typiska representanter för denna databasfamilj är InfluxDB, Prometheus, KDB, TimescaleDB (byggd på PostgreSQL), lösningar från Amazon. ClickHouse kan också användas här, och det används. Jag kommer att ge några offentliga exempel.
En av pionjärerna är företaget CloudFlare (CDN-leverantör). De övervakar sina CDN via ClickHouse (DNS-förfrågningar, HTTP-förfrågningar) med enorm belastning – 6 miljoner händelser per sekund. Allt går genom Kafka, skickas till ClickHouse, vilket ger möjlighet att se händelsedashboards i systemet i realtid.
Comcast – en av ledarna inom telekommunikation i USA: internet, digital TV, telefoni. De har skapat ett liknande system för hantering av CDN inom Öppen källkod projektet Apache Traffic Control för att arbeta med sina enorma data. ClickHouse används som back-end för analys.
Percona har integrerat ClickHouse inuti sin PMM, för att lagra övervakning av olika MySQL.
Specifika krav
Tidsserie-databaser har sina specifika krav.
- Snabb insättning från många agenter.Vi måste mycket snabbt sätta in data från många flöden. ClickHouse gör det bra, eftersom den har alla insättningar icke-blockerande. Varje insättning — detta är en ny fil på disken, och små insatser kan buffras på ett eller annat sätt. I ClickHouse bästa fall bör data infogas i stora paket snarare än rad för rad.
- Flexibel struktur. I tidsserie vi vet vanligtvis inte datans struktur helt och hållet. Det går att bygga ett övervakningssystem för en specifik applikation, men då är det svårt att använda det för en annan applikation. För detta behövs en mer flexibel struktur. ClickHouse, tillåter detta, trots att det är en strikt typad databas.
- Effektiv lagring och "glömska" av data. Vanligtvis i tidsserie en enorm mängd data, vilket innebär att de måste lagras så effektivt som möjligt. Till exempel, en InfluxDB bra komprimering — det är dess huvudsakliga funktion. Men förutom lagring måste man också kunna "glömma" gammal data och göra någon form av nedskärning — automatisk beräkning av aggregat.
- Snabba förfrågningar av aggregerade data. Ibland vill man se de senaste 5 minuterna med millisekunders noggrannhet, men vid månatlig data kan minut- eller sekundgranularitet vara onödig — det räcker med övergripande statistik. Stöd för sådana typer är nödvändigt, annars kommer en förfrågan för 3 månader att ta mycket lång tid även i ClickHouse.
- Förfrågningar av typ "sista punkt, per». Detta är typiska för tidsserie förfrågningar: vi ser den senaste mätningen eller tillståndet i systemet vid en given tidpunkt t. För databaser är detta inte särskilt trevliga förfrågningar, men de måste också kunna utföras.
- "Sammanfogning" av tidsserier. Tidsserie — det är en tidsserie. Om det finns två tidsserier, måste de ofta sammanfogas och korreleras. Det är inte alltid enkelt att göra detta i databaser, särskilt med oregelbundna tidsserier: här — en tidsmarkering, där — en annan. Man kan räkna medelvärden, men om det fortfarande finns hål är det oklart.
Låt oss se hur dessa krav uppfylls i ClickHouse.
Diagram
I ClickHouse struktur för tidsserie kan göras på olika sätt, beroende på graden av datans regelbundenhet. Man kan bygga ett system på regelbundna data, när vi känner till alla mätvärden på förhand. Till exempel, så gjorde CloudFlare med övervakning CDN — det är ett väloptimerat system. Man kan bygga ett mer allmänt system som övervakar hela infrastrukturen, olika tjänster. I fallet med oregelbundna data vet vi inte i förväg vad som övervakas — och det är förmodligen det vanligaste fallet.
Regelbundna data. Kolumner. Strukturen är enkel – kolumner med de nödvändiga typerna:
SKAPA TABELL cpu (
  created_date Datum DEFAULT today(),
  created_at DatumTid DEFAULT now(),
  time Sträng,
  tags_id UInt32,
  /* anslutning till dim_tag */
  usage_user Float64,
  usage_system Float64,
  usage_idle Float64,
  usage_nice Float64,
  usage_iowait Float64,
  usage_irq Float64,
  usage_softirq Float64,
  usage_steal Float64,
  usage_guest Float64,
  usage_guest_nice Float64
) MOTOR = MergeTree(created_date, (tags_id, created_at), 8192);
Detta är en vanlig tabell som övervakar någon aktivitet relaterad till systembelastning (användare, system, inaktiv, trevlig). Enkelt och bekvämt, men inte flexibelt. Om vi vill ha en mer flexibel struktur kan vi använda matriser.
Oregelbundna data. Matriser:
SKAPA TABELL cpu_alc (
  created_date Datum,
  created_at DatumTid,
  time Sträng,
  tags_id UInt32,
  metrics Nestad(
    name LowCardinality(Sträng),
    value Float64
  )
) MOTOR = MergeTree(created_date, (tags_id, created_at), 8192);

VÄLJ max(metrics.value[indexOf(metrics.name,'usage_user')]) FRÅN ...
Struktur Nestad — det finns två matriser: metrics.name och metrics.value. Här kan vi lagra sådana godtyckliga övervakningsdata som en matris av namn och en matris av mått för varje händelse. För ytterligare optimering kan vi skapa flera sådana strukturer istället för en. Till exempel, en för float-värde, en annan för int-värde, eftersom int vi vill lagra det mer effektivt.
Men att använda en sådan struktur är mer komplicerat. Vi måste använda en speciell konstruktion, genom speciella funktioner för att först hämta värden från indexet och sedan från matrisen:
VÄLJ max(metrics.value[indexOf(metrics.name,'usage_user')]) FRÅN ...Men det fungerar ändå tillräckligt snabbt. Ett annat sätt att lagra oregelbundna data är i rader.
Oregelbundna data. Rader. I denna traditionella metod utan matriser lagras både namn och värden direkt. Om en enhet skickar 5 000 mätningar på en gång — genereras 5 000 rader i databasen:
SKAPA TABELL cpu_rlc (
  created_date Datum,
  created_at DatumTid,
  time Sträng,
  tags_id UInt32,
  metric_name LowCardinality(Sträng),
  metric_value Float64
) MOTOR = MergeTree(created_date, (metric_name, tags_id, created_at), 8192);


VÄLJ
    maxIf(metric_value, metric_name = 'usage_user'),
    ...
FRÅN cpu_r
DÄR metric_name I ('usage_user', ...)
ClickHouse detta klarar sig — det har speciella tillägg ClickHouse SQL. Till exempel, maxIf — en speciell funktion som beräknar maximum för en mätning under ett visst villkor. Man kan skriva flera sådana uttryck i en och samma fråga och räkna ut värdet för flera mätningar samtidigt.
Låt oss jämföra tre metoder:
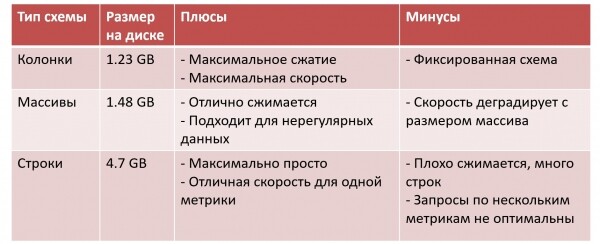
Här har jag lagt till "Datastorlek på disken" för en viss testdatasats. I fallet med kolumner har vi den minsta datastorleken: maximal komprimering, maximal förfrågningshastighet, men vi betalar för att allt måste fixeras direkt.
I fallet med arrayer är det lite sämre. Data komprimeras fortfarande bra, och det går att lagra oregelbundna scheman. Men ClickHouse – en kolumndatabas, och när vi börjar lagra allt i en array, förvandlas den till en strängdatabas, och vi betalar för flexibilitet med effektivitet. För varje operation måste hela arrayen läsas in i minnet, varefter vi hittar det nödvändiga elementet – och om arrayen växer försämras hastigheten.
I ett av företagen som använder ett sådant tillvägagångssätt (till exempel, ), delas arrayer upp i bitar om 128 element. Data från flera tusen metrik i storlek av 200 TB per dag lagras inte i en enda array, utan i 10 eller 30 arrayer med speciell logik för lagring.
Ett så enkelt tillvägagångssätt som möjligt – med strängar. Men data komprimeras dåligt, och storleken på tabellen blir stor, särskilt när förfrågningar görs om flera metrik, vilket gör att ClickHouse arbetar suboptimalt.
Hybrid schema
Anta att vi valt schema med array. Men om vi vet att de flesta av våra dashboards endast visar metrik som user och system, kan vi ytterligare materialisera dessa metrik från arrayen på tabellnivå på följande sätt:
CREATE TABLE cpu_alc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metrics Nested(
    name LowCardinality(String),
    value Float64
  ),
  usage_user Float64
             MATERIALIZED metrics.value[indexOf(metrics.name,'usage_user')],
  usage_system Float64
             MATERIALIZED metrics.value[indexOf(metrics.name,'usage_system')]
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Vid insättning ClickHouse beräknar den automatiskt. Så kan vi kombinera det trevliga med det nyttiga: schemat är flexibelt och allmänt, men de mest använda kolumnerna har vi hämtat. Jag påpekar att detta inte krävde att vi ändrade insättningen och ETL, som fortsätter att injicera arrayer i tabellen. Vi gjorde helt enkelt ALTER TABLE, lade till några kolumner, och vi fick ett hybrid- och snabbare schema som kan användas direkt.
Kodningar och kompression
För tidsserie är viktigt, eftersom hur bra du packar data är avgörande, eftersom informationen kan vara mycket stor. I ClickHouse det finns en uppsättning verktyg för att uppnå komprimeringseffekter på 1:10, 1:20, och ibland ännu mer. Det betyder att opackade data på 1 TB på disken tar upp 50-100 GB. En mindre storlek är bra, eftersom data kan läsas och bearbetas snabbare.
För att uppnå en hög nivå av komprimering, ClickHouse stöder följande codecs:
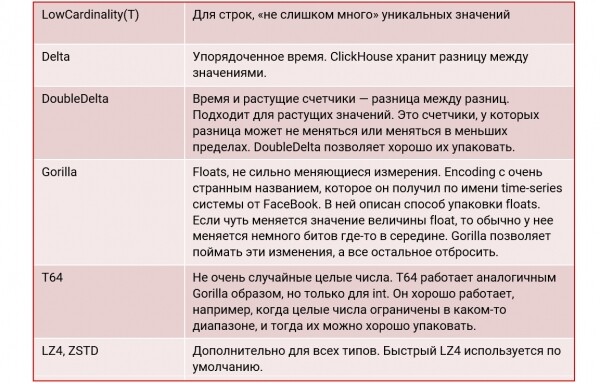
Exempel på tabell:
CREATE TABLE benchmark.cpu_codecs_lz4 (
    created_date Date DEFAULT today(),
    created_at DateTime DEFAULT now() Codec(DoubleDelta, LZ4),
    tags_id UInt32,
    usage_user Float64 Codec(Gorilla, LZ4),
    usage_system Float64 Codec(Gorilla, LZ4),
    usage_idle Float64 Codec(Gorilla, LZ4),
    usage_nice Float64 Codec(Gorilla, LZ4),
    usage_iowait Float64 Codec(Gorilla, LZ4),
    usage_irq Float64 Codec(Gorilla, LZ4),
    usage_softirq Float64 Codec(Gorilla, LZ4),
    usage_steal Float64 Codec(Gorilla, LZ4),
    usage_guest Float64 Codec(Gorilla, LZ4),
    usage_guest_nice Float64 Codec(Gorilla, LZ4),
    additional_tags String DEFAULT ''
)
ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Här definierar vi codec DoubleDelta i ett fall, och i det andra — Gorilla, och vi lägger dessutom till LZ4 komprimering. Som ett resultat minskar datastorleken på disken avsevärt:
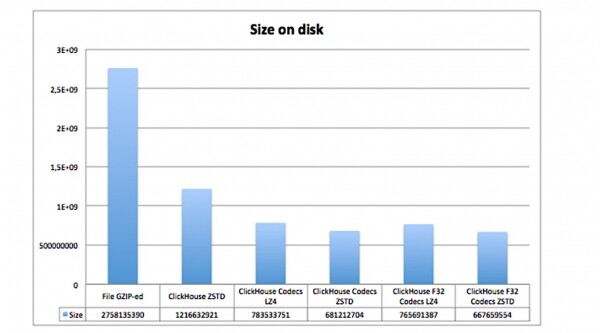
Här visas hur mycket plats samma data tar, men med olika codecs och komprimeringar:
- i GZIP-fil på disken;
- i ClickHouse utan codecs, men med ZSTD-kompression;
- i ClickHouse med codecs och LZ4 och ZSTD-komprimering.
Det är tydligt att tabeller med codecs tar upp mycket mindre plats.
Storleken spelar roll
Inte mindre viktigt rätt datatyp:
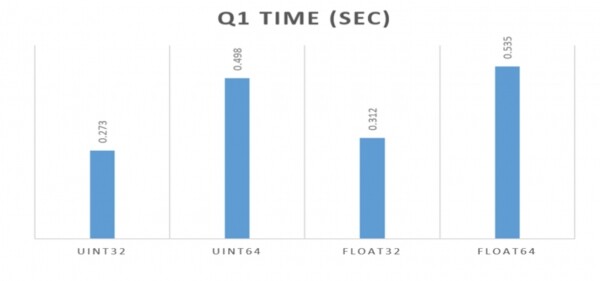
I alla exempel ovan har jag använt Float64. Men om vi hade valt Float32, skulle det vara ännu bättre. Detta visade killarna från Percona i artikeln i länken ovan. Det är viktigt att använda den mest kompakta typen som passar uppgiften: även i mindre grad för storlek på disken, än för hastigheten på förfrågningar. ClickHouse är mycket känslig för detta.
Om du kan använda int32 istället för int64, förvänta dig nästan en dubbel prestandaökning. Data tar upp mindre minne, och all "aritmetik" fungerar mycket snabbare. ClickHouse inuti sig — ett mycket strikt typat system, utnyttjar det alla möjligheter som moderna system erbjuder.
Aggregering och Materialiserade vyer
Aggregering och materialiserade vyer gör det möjligt att göra aggregat för olika situationer:
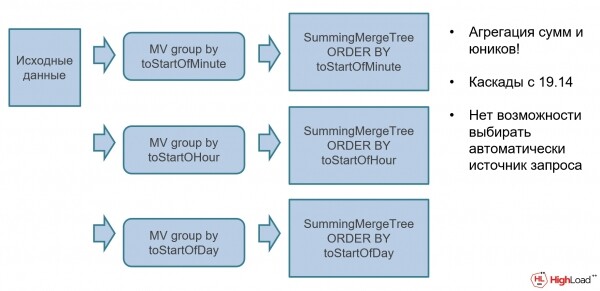
Till exempel kan du ha oaggregidata och du kan koppla olika materialiserade vyer med automatisk summering via en speciell motor. SummingMergeTree (SMT). SMT är en speciell aggregationsdatastruktur som automatiskt beräknar aggregat. Rådata sätts in i databasen, de aggregeras automatiskt och kan omedelbart användas i dashboards.
TTL glömmer bort gamla data
Hur "glömmer" man data som inte längre behövs? ClickHouse kan detta. Vid skapande av tabeller kan du ange TTL uttryck: till exempel att minuterna lagras i en dag, dagsdata i 30 dagar och veckodata eller månadsdata aldrig rörs:
CREATE TABLE aggr_by_minute
…
TTL time + interval 1 day

CREATE TABLE aggr_by_day
…
TTL time + interval 30 day

CREATE TABLE aggr_by_week
…
/* no TTL */
Multi-tier separerar data över diskar
Utvecklar detta koncept kan data lagras i ClickHouse olika platser. Anta att vi vill lagra heta data från den senaste veckan på en mycket snabb lokal SSD, medan mer historiska data lagras på en annan plats. I ClickHouse är detta nu möjligt:
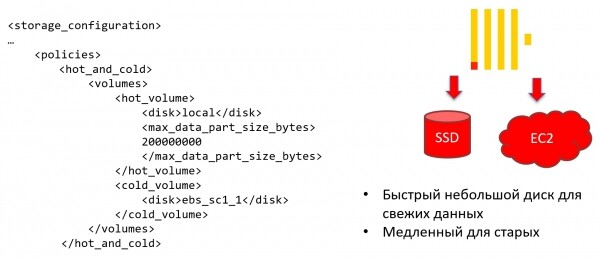
Det går att konfigurera lagringspolicy (storage policy) så att ClickHouse data automatiskt flyttas till ett annat lagringsutrymme när vissa villkor uppfylls.
Men det är fortfarande inte allt. På nivån av en specifik tabell kan du definiera regler för när data övergår till kall lagring baserat på tid. Till exempel, data lagras på en mycket snabb disk i 7 dagar och allt som är äldre flyttas till en långsammare disk. Detta är bra eftersom det gör att systemet kan hållas med maximal prestanda, samtidigt som kostnaderna kontrolleras utan att spendera pengar på kalla data:
CREATE TABLE
...
TTL date + INTERVAL 7 DAY TO VOLUME 'cold_volume',
    date + INTERVAL 180 DAY DELETE
Unika möjligheter ClickHouse
Det finns nästan alltid sådana "speciella drag" i ClickHouse men dessa neutraliseras av exklusivitet — av det som inte finns i andra databaser. Till exempel, här är några av de unika funktionerna ClickHouse:
- Arrayer. I ClickHouse mycket bra stöd för arrayer samt möjlighet att utföra komplexa beräkningar på dem.
- Aggregationsdatastrukturer. Detta är en av "killer-features" ClickHouse. Trots att grabbarna från Yandex säger att vi inte vill aggreggera data, så aggreggerar alla i ClickHouse, eftersom det är snabbt och bekvämt.
- Materialiserade vyer. Tillsammans med aggregerande datakonstruktioner möjliggör materialiserade vyer enklare real-time aggregering.
- ClickHouse SQL. Detta är en utvidgning av språket SQL med vissa ytterligare och exklusiva funktioner som endast finns i ClickHouse. Tidigare var det både en utvidgning och en nackdel. Nu har vi nästan raderat alla nackdelar jämfört med SQL 92 . nu är det bara en utvidgning.
- Lambda-uttryck.Finns de i någon annan databas?
- ML-stöd.Det finns i olika databaser, vissa är bättre än andra.
- Öppen kod. Vi kan expandera ClickHouse tillsammans. Nu är vi ClickHouse ungefär 500 bidragsgivare, och det antalet växer ständigt.
Smart frågor
I ClickHouse det finns många olika sätt att göra samma sak. Till exempel kan vi få det senaste värdet från tabellen på tre olika sätt för CPU (det finns även ett fjärde, men det är än mer exotiskt).
Det första visar hur enkelt det är att göra i ClickHouse frågor, när du vill verifiera att tuple finns i en underfråga. Det är något som jag personligen har saknat i andra databaser. Om jag vill jämföra något med en underfråga kan jag i andra databaser bara jämföra med en skalär, och för flera kolumner måste jag skriva JOIN. I ClickHouse vi kan använda tuple:
SELECT *
  FROM cpu
 WHERE (tags_id, created_at) IN
    (SELECT tags_id, max(created_at)
        FROM cpu
        GROUP BY tags_id)
Det andra sättet gör samma sak, men använder en aggregatfunktion argMax:
SELECT
    argMax(usage_user), created_at),
    argMax(usage_system), created_at),
...
 FROM cpu
I ClickHouse det finns flera dussin aggregatfunktioner, och om vi använder kombinatorer, enligt kombinatorikens lagar, finns det ungefär tusen. ArgMax är en av funktionerna som beräknar det maximala värdet: frågan returnerar värdet usage_user, vid vilket det maximala värdet uppnås created_at:
SELECT now() as created_at,
       cpu.*
  FROM (SELECT DISTINCT tags_id from cpu) base
  ASOF LEFT JOIN cpu USING (tags_id, created_at)
ASOF JOIN – ”sammanfogning” av rader med olika tidsstämplar. Detta är en unik funktion för databaser som också finns i kdb+. Om det finns två tidsserier med olika tidpunkter, ASOF JOIN möjliggör det att förskjuta och sammanfoga dem i en och samma fråga. För varje värde i en tidsserie hittas det närmaste värdet i den andra, och de returneras på en rad:
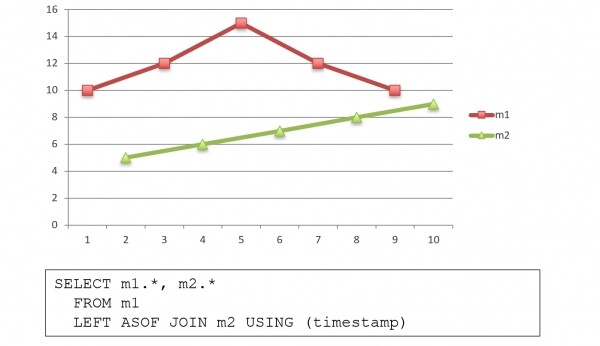
Analytiska funktioner
I standarden SQL-2003 kan man skriva så här:
Välj origin,
       tidsstämpel,
       tidsstämpel -LAG(tidsstämpel, 1) ÖVER (PARTITION BY origin ORDER BY tidsstämpel) AS varaktighet,
       tidsstämpel -MIN(tidsstämpel) ÖVER (PARTITION BY origin ORDER BY tidsstämpel) AS startseq_varaktighet,
       RAD_NUMMER() ÖVER (PARTITION BY origin ORDER BY tidsstämpel) AS sekvens,
       ANTAL() ÖVER (PARTITION BY origin ORDER BY tidsstämpel) AS nb
  FRÅN mytable
ORDER BY origin, tidsstämpel;
I ClickHouse det går inte — det stöder inte standarden SQL-2003 och troligen kommer det aldrig att göra det. Istället är det ClickHouse vanligt att skriva så här:
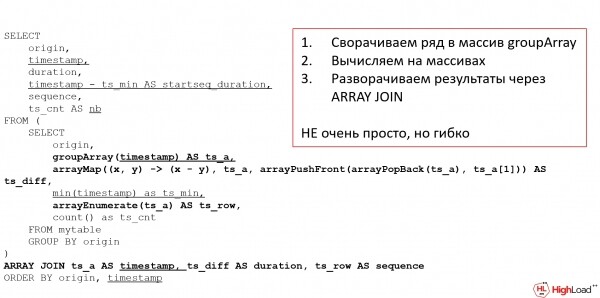
Jag lovade lambdas – här är de!
Detta är en motsvarighet till analytisk fråga i standarden SQL-2003: den beräknar skillnaden mellan två tidsstämplar, varaktighet, sekvensnummer — allt som vi vanligtvis räknar som analytiska funktioner. I ClickHouse beräknar vi dem via arrayer: först komprimerar vi data i en array, efter det gör vi allt vi vill med arrayen, och sedan utvecklar vi den igen. Det är inte särskilt bekvämt och kräver en viss förkärlek för funktionell programmering, minst sagt, men det är mycket flexibelt.
Särskilda funktioner
Dessutom har ClickHouse många specialiserade funktioner. Till exempel, hur kan man bestämma hur många sessioner som pågår samtidigt? En typisk uppgift för övervakning är att fastställa maximal belastning från en förfrågan. I ClickHouse finns det en speciell funktion för detta ändamål:
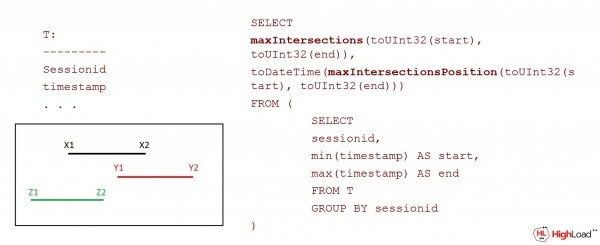
Överlag finns det många specialfunktioner i ClickHouse:
- runningDifference, runningAccumulate, neighbor;
- sumMap(key, value);
- timeSeriesGroupSum(uid, tidsstämpel, värde);
- timeSeriesGroupRateSum(uid, tidsstämpel, värde);
- skewPop, skewSamp, kurtPop, kurtSamp;
- WITH FILL / WITH TIES;
- simpleLinearRegression, stochasticLinearRegression.
Detta är inte en fullständig lista av funktioner, totalt finns det 500-600. En hint: alla funktioner i ClickHouse finns i systemtabellen (inte alla dokumenterade, men alla intressanta):
välj * från system.functions orderera efter namnClickHouse själv innehåller mycket information om sig själv, inklusive loggar, query_log, spårningslogg, logg för operationer med datablokkar (part_log), logg för metrik, och systemloggar som vanligtvis skrivs till disk. Metrikloggen är tidsserie på ClickHouse i själva verket: ClickHouseDB kan faktiskt fungera som tidsserie databaser, vilket på så sätt "äter" sig själv.
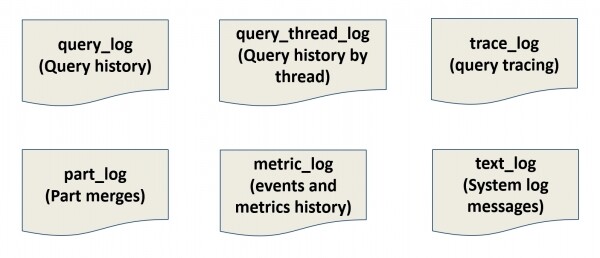
Detta är också en unik sak — eftersom vi gör ett bra jobb för tidsserie, varför kan vi inte lagra allt som behövs inom oss själva? Vi behöver inte Prometheus, vi lagrar allt i oss. Vi kopplade in Grafana och övervakar oss själva. Men om ClickHouse skulle falla, kan vi inte se varför — därför görs det vanligtvis inte så.
Stort kluster eller många små ClickHouse
Vad är bäst — ett stort kluster eller många små ClickHouse? Den traditionella ansatsen till DWH — är en stor kluster där scheman särskiljs för varje applikation. Vi gick till DB-administratören — ge oss schemat, och vi fick det:
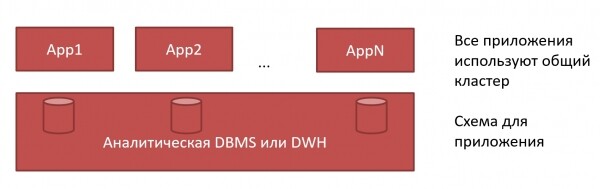
I ClickHouse detta kan göras på ett annat sätt. Man kan ge varje applikation sitt eget ClickHouse:
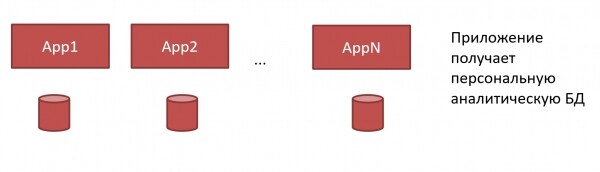
Vi behöver inte längre stora monster DWH och osamarbetsvilliga administratörer. Vi kan ge varje applikation sitt eget ClickHouse, och utvecklaren kan göra det själv, eftersom ClickHouse det installeras mycket enkelt och kräver ingen komplicerad administration:
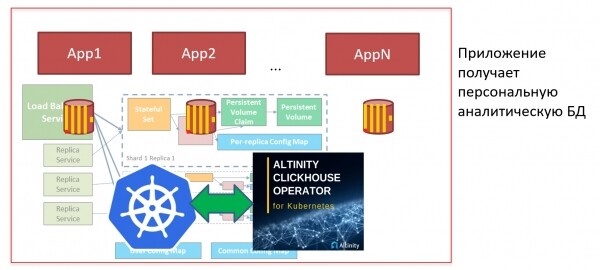
Men om vi har många ClickHouse, och måste ofta installera det, så vill man automatisera den processen. För detta kan vi till exempel använda Kubernetes och clickhouse-operatör. I Kubernetes ClickHouse kan man installera "med ett klick": Jag kan trycka på knappen, starta manifestet och databasen är klar. Man kan omedelbart skapa ett schema, börja ladda upp mätvärden, och efter 5 minuter har jag redan en färdig dashboard Grafana. Så enkelt är det!
Vad blir resultatet?
Så, ClickHouse — är:
- Snabbt. Det är allmänt känt.
- Enkelt. Lite kontroversiellt, men jag anser att det är svårt i studier, lätt i strid. Om man förstår hur ClickHouse det fungerar, är allt väldigt enkelt.
- Universellt. Det passar för olika scenarier: DWH, Tidsserier, Loggförvaring. Men det är ingen OLTP databas, så försök inte göra korta insättningar och läsningar där.
- Intressant. Troligen har den som arbetar med ClickHouse, upplevt många intressanta minuter i både gott och ont. Till exempel, en ny version släpptes, allt slutade fungera. Eller när du kämpat med en uppgift i två dagar, men efter frågan i Telegram-chatten löstes den på två minuter. Eller som vid konferensen när Alexey Milovidov höll ett föredrag och skärmdumpen från ClickHouse bröt sändningen HighLoad++. Den typen av saker händer hela tiden och gör vårt liv med ClickHouse ljus och intressant!
Presentation kan ses .
Den efterlängtade träffen för utvecklare av högbelastade system på kommer att äga rum den 9 och 10 november i Skolkovo. Äntligen blir detta en offline-konferens (även om med alla försiktighetsåtgärder), för energin från HighLoad++ kan inte packas in online.
För konferensen hittar vi och visar dig fallstudier om de maximala möjligheterna med teknologier: HighLoad++ har varit, är och kommer alltid att vara den enda platsen där man kan få veta hur Facebook, Yandex, VKontakte, Google och Amazon är organiserade på två dagar.
Sedan vi började våra möten utan avbrott 2007 kommer vi i år att träffas för 14:e gången. Under denna tid har konferensen växt tiofaldigt, och förra året samlade branschens huvudevenemang 3339 deltagare, 165 talare och 16 spår som pågick samtidigt.
Förra året hade vi 20 bussar, 5280 liter te och kaffe, 1650 liter bärdrycker och 10200 flaskor vatten. Dessutom 2640 kilogram mat, 16000 tallrikar och 25000 glas. Förresten, med de pengar som tjänats på återvunnet papper planterade vi 100 ekplantor 🙂Du kan köpa biljetter , få nyheter om konferensen — , och prata — på alla sociala medier: , , och .
Källa: habr.com
