

I den här artikeln kommer jag att berätta om hur projektet som jag arbetar med har förvandlats från en stor monolit till en uppsättning mikroservicer.
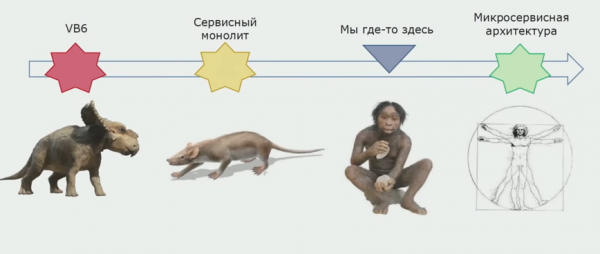
Projektet började sin historia för ganska länge sedan, i början av 2000-talet. De första versionerna skrevs i Visual Basic 6. Med tiden blev det tydligt att utvecklingen på detta språk skulle bli svår att underhålla i framtiden, eftersom både IDE och språket själv utvecklades långsamt. I slutet av 2000-talet beslutades det att gå över till det mer lovande C#. Den nya versionen skrevs parallellt med förbättringarna av den gamla, och gradvis blev allt mer kod skriven i .NET. Backend i C# var från början inriktad på en tjänsteorienterad arkitektur, men under utvecklingen användes gemensamma bibliotek med logik, och tjänsterna kördes i en och samma process. Resultatet blev en applikation som vi kallade "tjänstmonolit".
En av de få fördelarna med denna koppling var möjligheten för tjänster att anropa varandra via en extern API. Det fanns tydliga tecken på att det var dags att övergå till en mer korrekt tjänste- och så småningom mikroservicearkitektur.
Vi påbörjade vårt arbete med dekomponering omkring år 2015. Än så länge har vi inte nått ett perfekt tillstånd - det finns fortfarande delar av det stora projektet som är svåra att kalla monoliter, men de liknar inte heller mikroservicer. Trots detta har framstegen varit betydande.
Detta är vad jag ska berätta om i artikeln.
Innehåll
Arkitektur och problem med nuvarande lösning
Initialt såg arkitekturen ut som följer: UI - en separat applikation, den monolitiska delen var skriven i Visual Basic 6, och applikationen i .NET var en uppsättning relaterade tjänster som arbetade med en ganska stor databas.
Nackdelar med den tidigare lösningen
Ensam felpunkt
Vi hade en enda felpunkt: applikationen på .NET kördes i en process. Om det inträffade ett fel i något av modulerna, stod hela applikationen stilla och fick startas om. Eftersom vi automatiserar ett stort antal processer för olika användare, kunde alla inte arbeta under en tid på grund av ett fel i en av dem. Och inget hjälpte ens med redundans vid programmeringsfel.
Kö för förbättringar
Denna brist är snarare organisatorisk. I vår applikation har vi många beställare, och alla vill ha sina förbättringar så snabbt som möjligt. Tidigare var det omöjligt att göra detta parallellt, och alla beställare hamnade i kö. Denna process skapade negativitet för affärerna, eftersom de behövde bevisa att deras uppgift hade värde. Utvecklingsteamet spenderade tid på att organisera denna kö. Det tog mycket tid och kraft, och produkten kunde i slutändan inte förändras så snabbt som man hade velat.
Ineffektivt resursutnyttjande
Vid placering av tjänster i en enskild process kopierade vi alltid helt konfigurationen från server till server. Vi ville placera de mest belastade tjänsterna separat för att inte slösa resurser och få mer flexibel hantering av vår distributionsschema.
Svårt att implementera moderna teknologier
En bekant problem för alla utvecklare: det finns en vilja att införa moderna teknologier i projektet, men ingen möjlighet. Med en stor monolitisk lösning blir varje uppdatering av den nuvarande biblioteket, för att inte tala om övergången till en ny, en ganska intressant uppgift. Man måste länge övertyga teamledaren om att det kommer att ge fler fördelar än de nervfrustrationer som det kostar.
Komplexitet vid leverans av förändringar
Detta var det mest allvarliga problemet - vi gjorde släpp vartannat månad.
Varje släpp blev en riktig katastrof för banken, trots testning och utvecklarnas insatser. Affärerna förstod att en del av funktionaliteten inte skulle fungera i början av veckan. Utvecklarna insåg att de skulle möta en vecka av allvarliga incidenter.
Önskan att förändra situationen fanns hos alla.
Förväntningar på mikroservicer
Leverans av komponenter efter beredskap. Leverans av komponenter efter beredskap tack vare deskomposition av lösningen och separation av olika processer.
Små produktteam. Detta är viktigt eftersom det är svårt att hantera ett stort team som arbetar med en gammal monolit. Ett sådant team måste följa en strikt process, men det skulle vara bättre att få mer kreativitet och oberoende. Det är något som endast små team kan tillåta sig.
Isolering av tjänster i separata processer. Idealiskt skulle vi vilja isolera i containrar, men många tjänster skrivna på .NET Framework körs endast under Windows. Det kommer nu tjänster på .NET Core, men de är fortfarande få.
Flexibilitet i distribution. Vi skulle vilja kombinera tjänsterna som vi behöver, snarare än att göra det som koden tvingar oss till.
Användning av nya teknologier. Detta är intressant för varje programmerare.
Problem med övergången
Naturligtvis, om det vore enkelt att bryta ner en monolit i mikrotjänster, skulle vi inte behöva diskutera detta på konferenser eller skriva artiklar. Det finns många fallgropar i denna process, och jag kommer att beskriva de viktigaste som har hindrat oss.
Det första problemet är typiskt för de flesta monoliter: kopplingen av affärslogik. När vi skriver en monolit vill vi återanvända våra klasser för att inte skriva överflödig kod. Men när man går över till mikrotjänster blir det ett problem: all kod är ganska strikt kopplad, vilket gör det svårt att dela upp tjänster.
Vid början av arbetet fanns det mer än 500 projekt i förvaret och över 700 000 rader kod. Det är en ganska stor lösning och det andra problemet. Att bara ta och dela upp det i mikrotjänster var inte möjligt.
Det tredje problemet är avsaknaden av nödvändig infrastruktur. Faktum är att vi höll på med manuell kopiering av källkod till servrar.
Hur man går från monolit till mikroservicer
Utväljning av mikrotjänster
För det första definierade vi omgående att uppdelningen av mikrotjänster är en iterativ process. Vi behövde alltid parallellt arbeta med utvecklingen av affärsuppgifter. Hur vi skulle genomföra detta tekniskt var vår problematik. Därför var vi förberedda på en iterativ process. Det går inte på något annat sätt om du har en stor applikation, och den från början inte är redo att skrivas om.
Vilka metoder använder vi för att välja ut mikrotjänster?
Den första metoden — att extrahera befintliga moduler som tjänster. I det avseendet hade vi tur: det fanns redan etablerade tjänster som arbetade enligt WCF-protokollet. De var spridda över separata samlingar. Vi överförde dem separat, och lade till en liten startmodul till varje samling. Den var skriven med hjälp av det fantastiska biblioteket Topshelf, som gör det möjligt att köra applikationen både som en tjänst och som en konsol. Detta är praktiskt för felsökning, eftersom det inte kräver några extra projekt i lösningen.
Tjänsterna var kopplade av affärslogik, eftersom de använde gemensamma samlingar och arbetade med en gemensam databas. De var svåra att kalla mikrotjänster i strikt bemärkelse. Trots detta kunde vi leverera dessa tjänster separat, i olika processer. Detta minskade redan deras påverkan på varandra och reducerade problem med parallell utveckling och en enda punkt för fel.
Samlingen med värden är endast en rad kod i Program-klassen. Arbetet med Topshelf har vi gömt i en hjälptklass.
namespace RBA.Services.Accounts.Host
{
   internal class Program
   {
      private static void Main(string[] args)
      {
        HostRunner.Run("RBA.Services.Accounts.Host");

       }
    }
}
Den andra metoden för att isolera mikrotjänster: att skapa dem för att lösa nya problem. Om monoliten inte växer under tiden, är det redan utmärkt, vilket betyder att vi rör oss i rätt riktning. För att lösa nya problem strävar vi efter att göra separata tjänster. Om det finns en möjlighet skapar vi mer "kanoniska" tjänster som helt styr sin datamodell och har en separat databas.
Vi, precis som många andra, började med autentisering och auktoriseringstjänster. De passar perfekt för detta. De är oberoende och har i regel en avskild datamodell. De interagerar inte med monoliten, utan endast monoliten vänder sig till dem för att lösa vissa uppgifter. På dessa tjänster kan man börja övergången till en ny arkitektur, felsöka infrastrukturen och testa olika metoder relaterade till nätverksbibliotek, etc. I vår organisation finns det inga team som inte skulle kunna skapa en autentiseringstjänst.
Den tredje metoden för att isolera mikrotjänster, som vi använder, är något specifikt för oss. Det handlar om att separera affärslogik från UI-lagret. Vår huvudsakliga UI-applikation är desktop-baserad, och den, precis som backend, är skriven i C#. Utvecklarna gör ibland misstag och flyttar logik till UI som borde finnas i backend och återanvändas.
Om vi tittar på ett verkligt exempel från koden i UI-delen, så ser vi att en stor del av denna lösning innehåller verklig affärslogik som är användbar i andra processer, inte bara för att bygga UI-formulär.
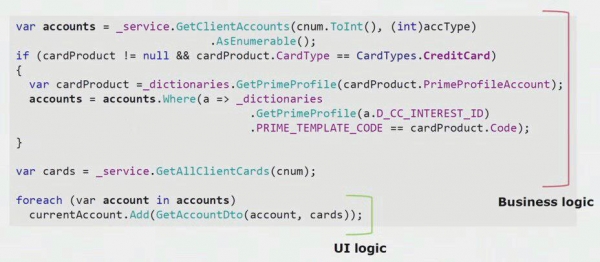
Den verkliga logiken i UI består bara av de senaste par raderna. Vi flyttade den till servern för att kunna återanvända den, vilket minskar UI och uppnår en korrekt arkitektur.
Det fjärde och viktigaste sättet att isolera mikrotjänster, vilket gör att man kan minska monoliten, är att flytta befintliga tjänster med omarbetning. När vi tar ut befintliga moduler som de är, är resultatet inte alltid tillfredsställande för utvecklarna, och affärsprocessen kan ha blivit föråldrad sedan funktionaliteten skapades. Genom refaktorering kan vi stödja den nya affärsprocessen, eftersom affärskraven ständigt förändras. Vi kan förbättra koden, ta bort kända defekter och skapa en mer kvalitativ datamodell. Många fördelar byggs upp.
Separeringen av tjänster med omarbetning är oåterkalleligt kopplad till begreppet begränsad kontext. Detta är ett begrepp inom domänorienterad design. Det innebär ett segment av domänmodellen där alla termer i ett gemensamt språk är entydigt definierade. Låt oss ta exempelvis kontexten av försäkringar och fakturor. Vi har en monolitisk applikation och behöver arbeta med fakturan i försäkringarna. Vi förväntar oss att utvecklaren hittar en redan existerande klass, 'Faktura', i en annan samling, gör en referens till den från klassen 'Försäkring', och vi får fungerande kod. DRY-principen kommer att följas, och uppgiften kan genom att använda befintlig kod utföras snabbare.
Det visar sig att kontexter för konton och försäkringar är sammankopplade. När nya krav dyker upp kommer denna koppling att försvåra utvecklingen och öka komplexiteten i den redan komplicerade affärslogiken. För att lösa detta problem måste man i koden identifiera gränserna mellan kontexterna och åtgärda deras överträdelser. Till exempel, för försäkringskontexten kan det mycket väl vara tillräckligt med ett 20-siffrigt konto-nummer från Centralbanken och kontots öppningsdatum.
För att separera dessa begränsade kontexter från varandra och inleda processen med att extrahera mikrotjänster från den monolitiska lösningen använde vi en metod som involverar att skapa externa API:er inom applikationen. Om vi visste att en viss modul skulle bli en mikrotjänst, eller förändras på något sätt i processen, gjorde vi omedelbart anrop till logik som tillhörde en annan begränsad kontext via externa anrop. Till exempel, via REST eller WCF.
Vi har beslutat att inte undvika kod som kräver distribuerade transaktioner. I vårt fall har det visat sig vara ganska enkelt att följa denna regel. Vi har fortfarande inte stött på situationer där strikta distribuerade transaktioner verkligen har behövts — det har varit tillräckligt med slutlig konsistens mellan modulerna.
Låt oss betrakta ett konkret exempel. Vi har begreppet orkestrator — en kedja som hanterar entiteten "ansökan". Den skapar successivt en kund, ett konto och ett bankkort. Om kunden och kontot skapas framgångsrikt men skapandet av kortet misslyckas, går ansökan inte till statusen "framgångsrik" och förblir i statusen "kortet skapades inte". I framtiden kommer bakgrundsaktiviteten att plocka upp den och avsluta den. Systemet förblir under en tid i ett tillstånd av inkonsistens, men det är vi i stort sett nöjda med.
I händelse av att en situation uppstår där det behövs en konsekvent bevarande av en del av data, kommer vi troligen att gå mot en sammanslagning av tjänsten för att behandla detta i en enda process.
Låt oss betrakta ett exempel på att extrahera en mikrotjänst. Hur kan vi relativt säkert föra den till produktion? I detta exempel har vi en separat del av systemet — modulen för lönebehandling, en del av koden som vi skulle vilja göra till en mikrotjänst.
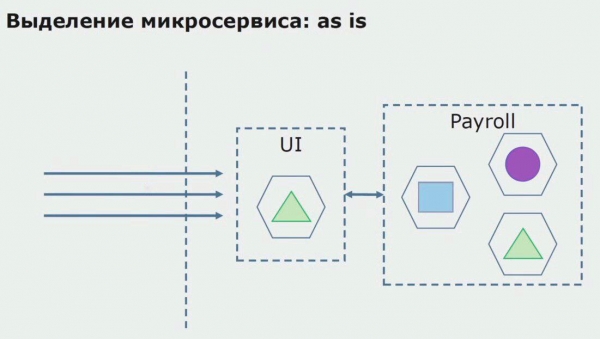
Först skapar vi en mikrotjänst genom att skriva om koden. Vi förbättrar några aspekter som vi inte var nöjda med. Vi implementerar nya affärskrav från kunden. Vi lägger till en API Gateway i kopplingen mellan UI och backend, som ska möjliggöra vidarebefordran av anrop.
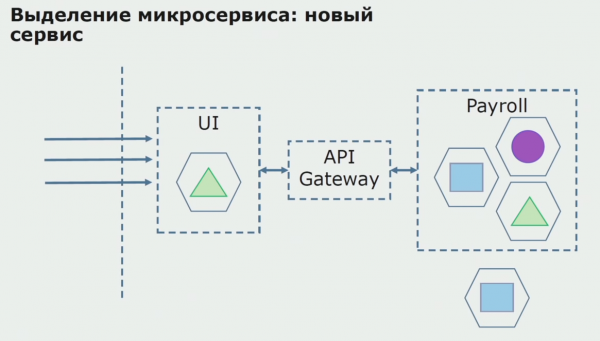
Därefter släpper vi denna konfiguration i produktion, men i pilotläge. De flesta av våra användare arbetar fortfarande med de gamla affärsprocesserna. För nya användare utvecklar vi en ny version av den monolitiska applikationen, som inte längre innehåller denna process. I princip fungerar vårt pilotprojekt som en koppling mellan monoliten och mikrotjänsten.
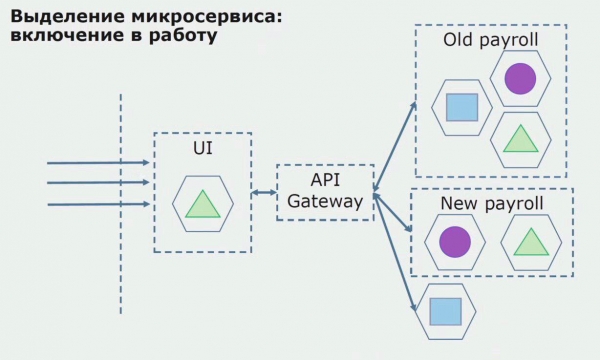
Vid en framgångsrik pilot förstår vi att den nya konfigurationen faktiskt fungerar, och vi kan ta bort den gamla monoliten och låta den nya konfigurationen ersätta den gamla lösningen.
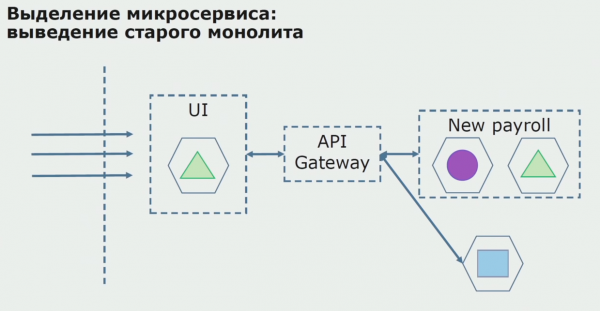
Summa summarum använder vi praktiskt taget alla befintliga metoder för att separera koden från monoliten. Alla dessa metoder gör att vi kan minska storleken på delar av applikationen och flytta dem till nya bibliotek, vilket ger en mer kvalitativ kod.
Arbete med databasen
Databasen är svårare att dela upp än koden, eftersom den innehåller inte bara den aktuella strukturen utan också insamlade historiska data.
Vår databas, precis som många andra, hade ytterligare en viktig nackdel - den enorma storleken. Denna databas designades enligt den komplicerade affärslogiken i monoliten, och mellan tabellerna av olika begränsade sammanhang har det uppstått kopplingar.
I vårt fall, för att lägga till allt detta (stor databas, många relationer, ibland oklara gränser mellan tabeller), uppstod ett problem som förekommer i många stora projekt: användningen av mönstret för delad databas. Data hämtades från tabeller via vyer, genom replikering och skickades till andra system där denna replikering behövdes. Som ett resultat kunde vi inte separera tabellerna i en egen struktur, eftersom de aktivt användes.
I separationen hjälper oss själva uppdelningen i begränsade sammanhang i koden. Detta ger i allmänhet en ganska bra bild av hur vi delar upp data på databasenivå. Vi förstår vilka tabeller som tillhör ett begränsat sammanhang och vilka som tillhör ett annat.
Vi har tillämpat två globala metoder för att separera databasen: separation av befintliga tabeller och separation med omarbetning.
Separation av befintliga tabeller är en metod som fungerar bra när datakonstruktionen är av hög kvalitet, uppfyller affärskrav och alla är nöjda. I detta fall kan vi särskilja befintliga tabeller till ett eget schema.
Separation med omarbetning behövs när affärsmodellen har förändrats kraftigt, och tabellerna längre inte tillfredsställer våra behov.
Separation av befintliga tabeller. Vi behöver definiera vad vi ska separera. Utan denna kunskap kan vi inte lyckas, och här kan separation av begränsade kontexter i koden hjälpa oss. Om man vanligtvis kan förstå gränserna för kontexterna i koden, blir det klart vilka tabeller som måste ingå i listan för separation.
Låt oss föreställa oss att vi har en lösning där två moduler i monoliten interagerar med en databas. Vi behöver se till att endast en modul interagerar med den del av tabellerna som ska separeras, medan den andra börjar interagera med den via API. Först är det tillräckligt att endast skrivning sker via API. Detta är en nödvändig förutsättning för att vi ska kunna tala om oberoende mikrotjänster. Läsning kan förbli kopplad så länge det inte orsakar några stora problem.
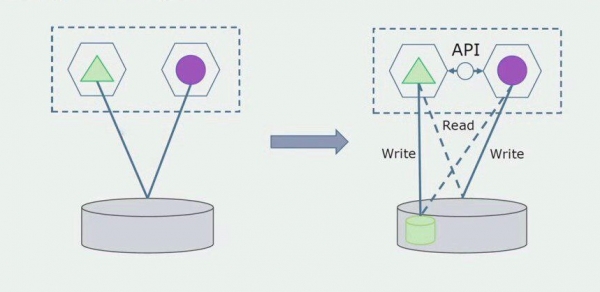
I nästa steg kan vi redan separera koden som arbetar med de separerade tabellerna, med eller utan omarbetning, till en egen mikrotjänst och köra den i en separat process eller container. Det kommer att bli en separat tjänst med koppling till monolitens databas och de tabeller som inte direkt tillhör den. Monoliten kan fortfarande läsa från den separerade delen.
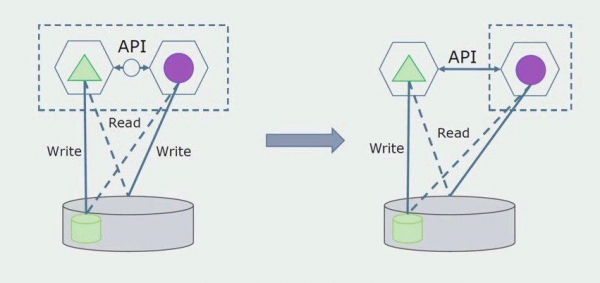
Senare kommer vi att ta bort denna koppling, vilket betyder att läsning av data från de separerade tabellerna i den monolitiska applikationen också kommer att övergå till API.
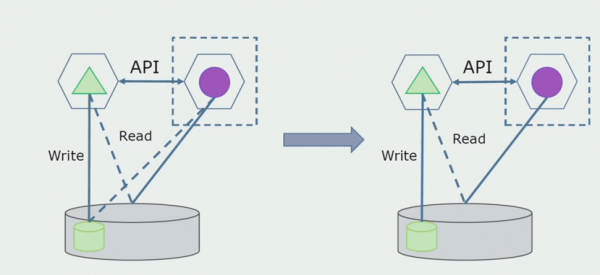
Därefter kommer vi att separera tabellerna från den gemensamma databasen som endast den nya mikrotjänsten arbetar med. Vi kan flytta tabellerna till ett eget schema eller till och med en egen fysisk databas. Det finns fortfarande en läsrelation mellan mikrotjänsten och monolitens databas, men det är inget stort problem; i en sådan konfiguration kan den leva ganska länge.
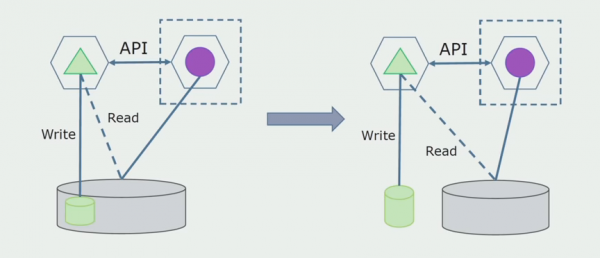
Det sista steget är att helt ta bort alla kopplingar. I det här fallet kan vi behöva migrera data från huvuddatabasen. Ibland vill vi återanvända vissa replikerade data eller register från externa system i flera databaser. Det här inträffar periodiskt hos oss.
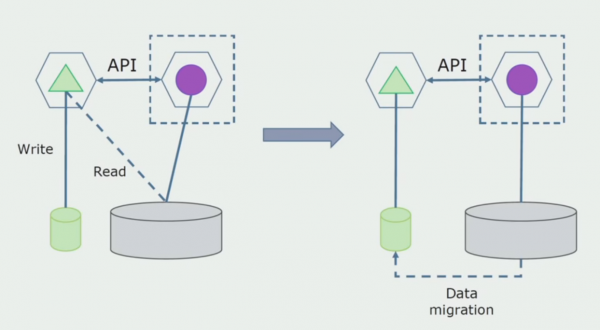
Avdelning för omarbetning. Denna metod liknar den första, men går i motsatt ordning. Vi sätter omedelbart upp en ny databas och en ny mikrotjänst som interagerar med monoliten via API. Men vi behåller en uppsättning databastabeller som vi vill ta bort i framtiden. Vi behöver dem inte längre, i den nya modellen har vi ersatt dem.
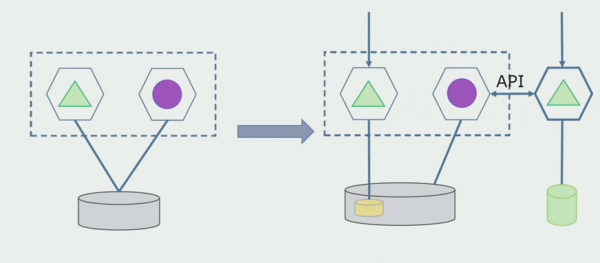
För att detta schema ska fungera kommer vi förmodligen att behöva en övergångsperiod.
Det finns två möjliga tillvägagångssätt härnäst.
Första: vi duplica all data i den nya och gamla databasen. I detta fall får vi dataduplicering och kan få problem med synkronisering. Men vi kan ha två olika kunder. En kommer att arbeta med den nya versionen, den andra med den gamla.
Den andra: vi delar upp data efter något affärskriterium. Till exempel hade vi 5 produkter i vårt system som lagrades i den gamla databasen. Den sjätte som en del av den nya affärsuppgiften placerar vi i den nya databasen. Men vi behöver en API-gateway som synkroniserar dessa data och visar för kunden varifrån och vad som ska tas.
Båda tillvägagångssätten fungerar, välj beroende på situationen.
Efter att vi har säkerställt att allt fungerar kan vi stänga av den del av monoliten som arbetar med de gamla databaskonstruktionerna.
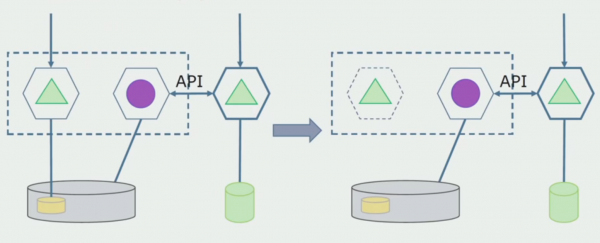
Det sista steget blir att ta bort de gamla datakonstruktionerna.
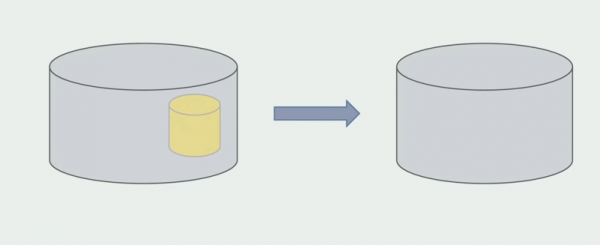
Sammanfattningsvis kan vi säga att vi har problem med databasen: det är svårare att arbeta med den jämfört med källkoden, det är svårare att dela upp, men det kan och måste göras. Vi har funnit några sätt som gör att vi kan göra det tillräckligt säkert, eftersom det är lägre sannolikhet att göra misstag med data än med källkoden.
Arbete med källkoden
Så här såg källkodsdiagrammet ut när vi började analysera det monolitiska projektet.
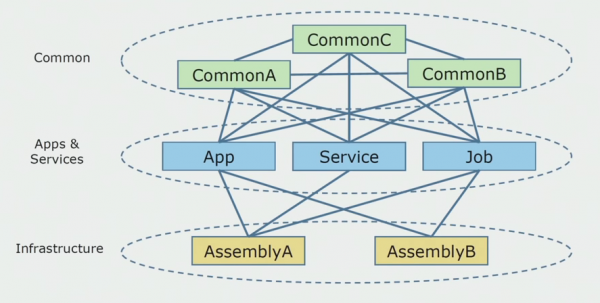
Den kan uppdelas i tre lager. Det är lagret för körbara moduler, plugins, tjänster och specifika aktiviteter. Faktiskt var dessa ingångspunkter inuti den monolitiska lösningen. Alla var fast förankrade i lagret Common. Här fanns den affärslogik som användes gemensamt av tjänsterna, och massor av kopplingar. Varje tjänst och plugin använde upp till 10 eller fler common-assemblies, beroende på deras storlek och utvecklarnas samvete.
Vi hade tur, vi hade infrastrukturbibliotek som kunde användas separat.
Ibland uppstod situationer där vissa Common-objekt faktiskt inte tillhörde detta lager, utan var infrastrukturbibliotek. Detta löstes genom att byta namn.
Det som störde mest var de begränsade kontexterna. Det hände att 3-4 kontexter blandades i en och samma Common-assembly och använde varandra inom samma affärsfunktioner. Det var nödvändigt att förstå var detta kunde delas och vid vilka gränser, samt vad som skulle göras med mappningen av denna delning på källkodens assemblies.
Vi formulerade flera regler för kodseparationsprocessen.
Första: vi ville inte längre dela affärslogik mellan tjänster, aktiviteter och plugins. Vi ville göra affärslogiken oberoende inom mikrotjänster. Å andra sidan uppfattas mikrotjänster, i en perfekt värld, som tjänster som finns helt oberoende. Jag anser att detta tillvägagångssätt är något slösaktigt, och att uppnå det är svårt, eftersom till exempel tjänster i C# alltid kommer att kopplas samman med standardbiblioteket. Vårt system är skrivet i C#, och vi har inte behövt använda andra teknologier hittills. Därför beslutade vi att vi kan tillåta oss att använda gemensamma tekniska assemblies. Det viktigaste är att de inte innehåller några fragment av affärslogik. Om du har en praktisk wrapper över ORM:en du använder, är det väldigt kostsamt att kopiera den från tjänst till tjänst.
Vårt team är fans av domänorienterad design, så "lökarkitektur" passade oss perfekt. Grunden i våra tjänster blev inte dataåtkomstskiktet, utan en samling med domänlogik, som innehåller enbart affärslogik och saknar kopplingar till infrastrukturen. På så sätt kan vi oberoende vidareutveckla domänsamlingen för att lösa problem relaterade till ramverk.
Vid detta stadium stötte vi på det första allvarliga problemet. Tjänsten skulle hänvisa till en domänsamling, vi ville göra logiken oberoende, och här försvårade principen DRY oss. Utvecklarna ville för att undvika duplicering återanvända klasser från angränsande samlingar, och som ett resultat började domänerna återigen att kopplas samman. Vi analyserade resultaten och beslutade att problemet även kunde ligga inom hur lagringen av källkoden var organiserad. Vi hade ett stort repository där all källkod låg. Lösningen för hela projektet var mycket svår att sätta ihop på en lokal maskin. Därför skapades separata små lösningar för projektets delar, och ingen hindrade oss från att lägga till en gemensam eller domänsamling och återanvända dem. Det enda verktyget som hindrade oss från att göra detta var kodgranskningen. Men ibland sviktade även det.
Då började vi övergå till en modell med separata repository. Affärslogiken slutade att läcka från tjänst till tjänst, domänerna blev verkligen oberoende. Begränsade kontexter stöds tydligare. Hur återanvänder vi infrastrukturområdets bibliotek? Vi isolerade dem i ett eget repository, sedan placerade vi dem i Nuget-paket som vi la i Artifactory. Vid varje ändring sker bygget och publiceringen automatiskt.
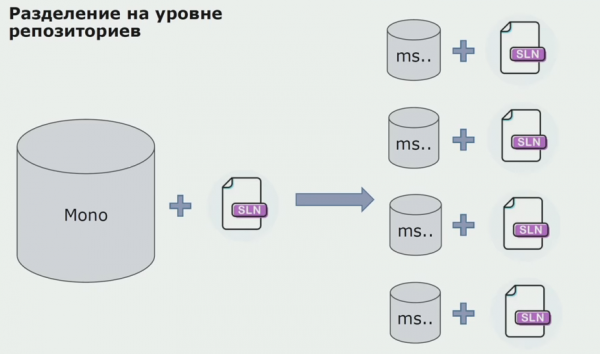
Våra tjänster började hänvisa till inre infrastrukturbibliotek på samma sätt som till externa. Vi laddar ner externa bibliotek från Nuget. För att arbeta med Artifactory, dit vi placerade dessa paket, använde vi två paketchefer. I små repository använde vi också Nuget. I repository med flera tjänster använde vi Paket, som ger mer överensstämmelse i versionerna mellan moduler.
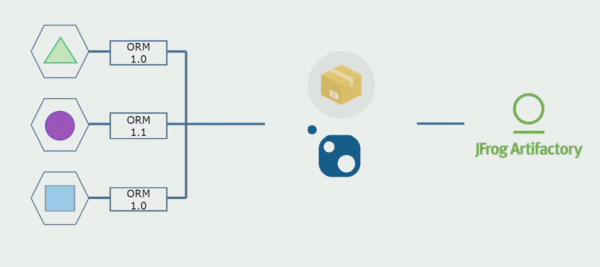
Genom att arbeta med källkoden, göra små ändringar i arkitekturen och separera repositorier, gör vi våra tjänster mer oberoende.
Infrastrukturproblem
De flesta nackdelar vid övergången till mikrotjänster är relaterade till infrastrukturen. Du kommer att behöva automatiserad distribuition och nya bibliotek för att hantera infrastrukturen.
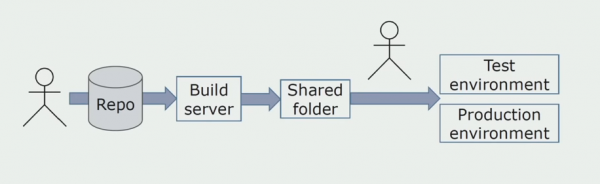
Manuell installation i miljöer
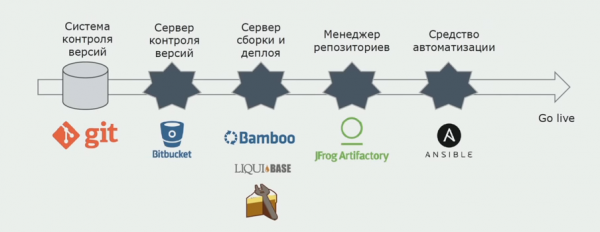
Från början installerade vi miljöerna manuellt. För att automatisera denna process skapade vi en CI/CD-pipeline. Vi valde processen continuous delivery eftersom continuous deployment fortfarande inte är acceptabelt för oss när det gäller affärsprocesser. Därför skickas distributionen i produktion med en knapptryckning, medan testningen sker automatiskt.
Vi använder Atlassian, Bitbucket för att lagra källkoder och Bamboo för byggning. Vi gillar att skriva byggskrift på Cake eftersom det är samma som C#. I Artifactory kommer redan färdiga paket, och Ansible skickas automatiskt till testservrar, därefter kan de testas direkt.
Separat loggning
Vid en tidpunkt var en av idéerna bakom monoliten att säkerställa gemensam loggning. Vi behövde också förstå vad vi skulle göra med separata loggar som ligger på diskar. Våra loggar skrivs till textfiler. Vi beslutade att använda den standardiserade ELK-stacken. Vi valde att inte skriva direkt till ELK genom leverantörer, utan bestämde oss för att förbättra textloggarna och registrera spår-ID:n som identifikatorer, plus att tillföra tjänstens namn så att dessa loggar senare kunde analyseras.
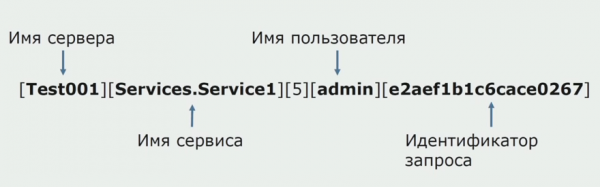
Med hjälp av Filebeat får vi möjlighet att samla våra loggar från servrar, och sedan bearbeta dem, använda Kibana för att bygga förfrågningar i UI och se hur anropet mellan tjänsterna har gått. Här hjälper spår-ID:n mycket.
Testning och felsökning av relaterade tjänster
Till en början förstod vi inte helt hur vi skulle debugga de utvecklade tjänsterna. Med monoliten var det enkelt, vi körde den på vår lokala maskin. Vi försökte först göra likadant med mikrotjänster, men ibland krävs det att man startar flera andra tjänster för att en enda mikrotjänst ska fungera, vilket är opraktiskt. Vi insåg att vi behövde övergå till en modell där vi bara lämnar tjänsten eller tjänsterna vi vill debugga på vår lokala maskin. De andra tjänsterna används från servrar som överensstämmer med konfigurationen på produktion. Efter debuggningsfasen, vid testning, levereras bara de ändrade tjänsterna till testservern för varje uppgift. På så sätt testas lösningen i den form den kommer att ha på produktion i framtiden.
Vi har servrar som endast har produktionsversioner av tjänsterna. Dessa servrar behövs för incidenthantering, för att kontrollera leveransen före distribution och för interna utbildningar.
Vi har lagt till en process för automatisk testning med hjälp av det populära biblioteket Specflow. Tester körs automatiskt med hjälp av NUnit direkt efter distribution från Ansible. Om testningen av en uppgift är helt automatisk, behövs ingen manuell testning. Även om manuell testning ibland fortfarande krävs. För att avgöra vilka tester som ska köras för en specifik uppgift använder vi taggar i Jira.
Behovet av belastningstestning har också ökat, tidigare genomfördes det endast i sällsynta fall. För att köra tester använder vi JMeter, för att lagra dem används InfluxDB, och för att skapa diagram över processen används Grafana.
Vad har vi uppnått?
För det första har vi avskaffat begreppet "release". De två månader långa monstruösa releaserna har försvunnit, då denna stora applikation distribuerades i produktionsmiljö och störde affärsprocesserna tillfälligt. Nu distribuerar vi tjänster i genomsnitt var 1,5 dag, grupperar dem eftersom de sätts i drift efter godkännande.
I vårt system finns det inga fatala fel. Om vi släpper en mikrotjänst med ett fel, kommer funktionaliteten kopplad till detta att vara trasig, men all annan funktionalitet påverkas inte. Detta förbättrar användarupplevelsen avsevärt.
Vi kan hantera distributionsschemat. Det går att separera grupper av tjänster från resten av lösningen om det behövs.
Dessutom har vi avsevärt minskat problemet med långa köer av arbetsuppgifter. Vi har fått separata produktteam som arbetar med en del av tjänsterna oberoende. Scrum-processen passar här ganska bra. Ett specifikt team kan ha en egen produktägare som sätter upp uppgifter för dem.
Sammanfattning
- Mikrotjänster passar bra för att dekomponera komplexa system. Under processen börjar vi förstå vad som finns i vårt system, vilka begränsade kontexter som finns, och var deras gränser går. Detta gör att vi kan fördela arbetsuppgifter på rätt sätt mellan modulerna och undvika koden från att bli förvirrad.
- Mikrotjänster erbjuder organisatoriska fördelar. Dessa talas ofta om som en arkitektur, men varje arkitektur behövs för att möta affärsbehov, och inte för sin egen skull. Därför kan vi säga att mikrotjänster passar bra för att lösa uppgifter med små team, med tanke på att Scrum just nu är mycket populärt.
- Delningen är en iterativ process. Man kan inte bara ta en applikation och dela upp den i mikrotjänster. Den resulterande produkten kommer sannolikt inte att vara fungerande. När man delar upp mikrotjänster är det fördelaktigt att skriva om den befintliga legacy-koden, det vill säga att omvandla den till kod som vi gillar och som bättre uppfyller affärens behov av funktionalitet och hastighet.
Ett litet varningstecken: kostnaderna för att övergå till mikrotjänster är ganska betydande. Det har tagit mycket tid bara att lösa infrastrukturområdet. Så om du har en liten applikation som inte kräver specifik skalning, och om det inte finns ett stort antal kunder som konkurrerar om din teams uppmärksamhet och tid, så är det möjligt att mikrotjänster inte är vad du behöver idag. Det är ganska dyrt. Om man börjar processen med mikrotjänster, så kommer kostnaderna i början att vara högre än om samma projekt började med utveckling av en monolit.
P.S. En mer emotionell berättelse (som om det var personligt till dig) – om .
Här är hela versionen av rapporten.
Källa: habr.com
