

Den första API:n av MojeSkklad lanserades för 10 år sedan. Under hela denna tid har vi arbetat med befintliga versioner av API:t och utvecklat nya. Och flera versioner av API:t har redan hunnit begravas.
I den här artikeln kommer det att finnas mycket: hur API:t skapades, varför det behövs för molntjänster, vad det ger användarna, vilka misstag vi har gjort och vad vi vill göra härnäst.
Jag heter Oleg Alekseev , jag är teknisk direktör och medgrundare av MojeSkklad.
Varför göra API för en tjänst
Våra kunder, som är tiotusentals företagare, använder aktivt molnbaserade lösningar: banktjänster, webbshoppar, lagerhantering, CRM. Man kopplar upp sig mot en, och det blir svårt att stoppa. Och nu har den femte, åttonde, tionde tjänsten gjort företagarens arbete lättare, men användarna får manuellt flytta data mellan dessa molntjänster. Arbetet blir en mardröm.
En uppenbar lösning är att ge användarna möjlighet att överföra data mellan molntjänster. Till exempel, importera och exportera data som filer som sedan kan laddas upp i den önskade tjänsten. Filer ändras vanligtvis för att passa varje tjänsts format. Det är mer eller mindre ett enkelt manuellt arbete, men med ökande antal tjänster blir det allt svårare att utföra.
Därför är nästa steg API. Med det kan molntjänsten dra nytta av att koppla ihop flera tjänster på en enda punkt. Framväxten av ett sådant ekosystem lockar nya kunder genom ytterligare möjligheter. En produkt med ny funktionalitet blir mer fördelaktig och användbar.
Genom att skapa egna programgränssnitt drar man till sig externa säljare i form av programmerare som känner till din produkt tack vare API:t. De börjar bygga lösningar baserat på det erbjudna API:t och tjänar pengar på automatisering av sina kunders uppgifter.
Redovisningssystemet MojeSkklad bygger på enkla processer. Huvudfokus är arbete med primärdokument, möjligheten att ta emot och leverera varor, samt att få rapporter för verksamheten baserat på primärdokument. Det finns också dataöverföring, till exempel till molnbokföring, och mottagning från banksystem eller detaljhandelsställen. Vi arbetar även med webbshoppar: får information om produkter och skickar data om lagersaldon.
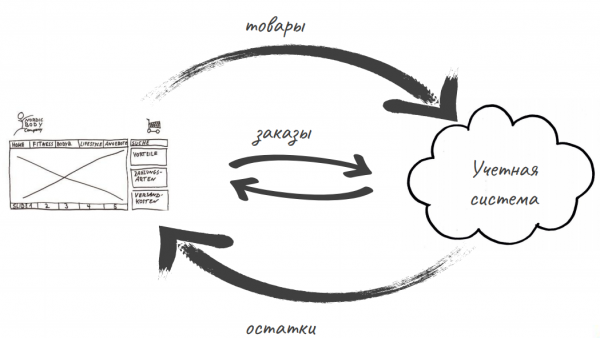
Första API:t för MojeSkalf
Under 10 års arbete med API:t för MojeSkalf har vi samlat på oss olika integrationer som möjliggör datadelning, samarbete med banker, betalningar och användning av extern telefoni.
Under det första året gjorde vi det möjligt att exportera vilken data som helst i XML-format. Då var det mycket tydligare och mer bekvämt för användare att hantera data offline snarare än i någon molnlösning, och vi gav dem den möjligheten. Exporten startades via manuell export från gränssnittet. Så API kunde man ännu inte kalla det.
Samtidigt började vi samarbeta med företaget Rusagro — de hade redan en 'vuxen' ERP för att planera produktion och försäljning, men de automatiserade lastning av vagnar på fabriker i MojeSkalf. Så vi fick våra första grunderar till ett riktigt API: utbytet mellan vår tjänst och ERP skedde genom att skicka en stor fil med data om alla typer av dokument.
Detta är ett bra alternativ för batchdatautbyte, men tillsammans med dokumenten var man tvungen att överföra deras beroenden: information om varor, motparter och lager. Sådan en samling är inte svår att generera vid export, men ganska svår att hantera vid import, eftersom all information kommer i ett paket: både om nya dokument och om redan existerande.
Det första XML API:t överlevde inte länge — efter två år började vi bygga om det. Redan vid starten av dess arbete gjorde vi flera misstag i uppbyggnaden av det programmerbara gränssnittet.
Så här gjordes XML API:t: en illustration från en av våra arkitekter. Förresten, håll utkik efter hans artiklar.
Här är våra största misstag:
- JAXB-märkningen gjordes direkt på entity beans. För kommunikation med databasen använder vi Hibernate, och JAXB-märkningen byggdes också på dessa bönor. Detta misstag visade sig nästan omedelbart: varje ändring av databasstrukturen krävde en snabb avisering till alla som använder API:t eller skapandet av nödlösningar för att säkerställa kompatibilitet med den tidigare databasstrukturen.
- API växte fram som en sorts tillägg, och i början definierade vi inte vilken del av produkten det utgjorde. Vi tänkte inte heller på huruvida API:et var något viktigt, om vi behövde upprätthålla bakåtkompatibilitet för de första användarna. Under en tid utgjorde API-användarna cirka 5% av det totala lilla antalet, och de fick ingen uppmärksamhet. Den universella filtrering som skapades vid den tiden ledde till att vi började användas som backend. Denna filtrering var inte riktigt GraphQL, men liknande — fungerade via en massa parametersträngar. Med ett så kraftfullt verktyg var det svårt för användarna att motstå, och förfrågningar skickades direkt från deras webbutikers användargränssnitt. Situationen blev en obehaglig överraskning, eftersom tillhandahållandet av en sådan tjänst borde kräva en annan prissättning och en helt annan förståelse för API:et som produkt.
- Eftersom API:et utvecklades inte som en huvudprodukt, producerades och publicerades API-dokumentationen som en biprodukt — genom omvänd ingenjörskonst. Denna väg verkar ganska enkel och bekväm, men strider mot avtalsarbete. Det handlar om att det finns en viss komponent med en förinställd arbetsmodell. Utvecklaren implementerar den enligt denna modell och uppgift, komponenten testas, kunden får en produkt som överensstämmer med analytikerns vision. Omvänd ingenjörskonst slänger dock ut en produkt på marknaden som bara finns där: med provisoriska lösningar, konstiga beslut och cyklar istället för den nödvändiga funktionaliteten.
- Hela strömmen av förfrågningar som kom genom API:et kunde analyseras högst som en Nginx-logg eller applikationsserver-logg. Detta gjorde det omöjligt att särskilja ämnesområden, annat än att dela upp dem efter användare och prenumeranter. Om det inte finns möjlighet att reglera registreringen av applikationer eller kunder blir det omöjligt att analysera situationen. Detta problem påverkade minst av allt API:s utveckling, det handlar mer om att förstå dess efterfrågan och funktionalitet.
Försök nummer två: REST API
År 2010 försökte vi bygga ett system för utbyte med online-bokföring — BuchSoft. Det lyfte inte. Men under integrationsprocessen skapades en fullt fungerande API: en REST-tjänst för utbyte, där det inte fanns några skönsmässiga tillvägagångssätt som att anropa operationer i form av RPC-anrop. All kommunikation med API:et var anpassad till standard läge för REST: i förfrågningssträngen finns namnet på entiteten, och operationen som utförs på den anges med hjälp av HTTP-metoden. Vi lade till filtrering baserat på uppdateringsögonblicket för entiteter, vilket gav användarna möjlighet att bygga replikering med sina system.
Samma år kom API:et för export av lager- och produktbeholdningar. Genom API:et blev de mest värdefulla delarna av systemet tillgängliga för användarna — utbyte av primära dokument och beräkningsdata om lager och kostnader för produkter.
I december 2015 publicerade RetailCRM det första tredjepartsbiblioteket för åtkomst till vårt API. Det började användas ganska aktivt, samtidigt växte populariteten för tjänsten som helhet, och belastningen på API:et ökade snabbare än belastningen på webgränssnittet. En dag förvandlades tillväxten till en belastningsspik.
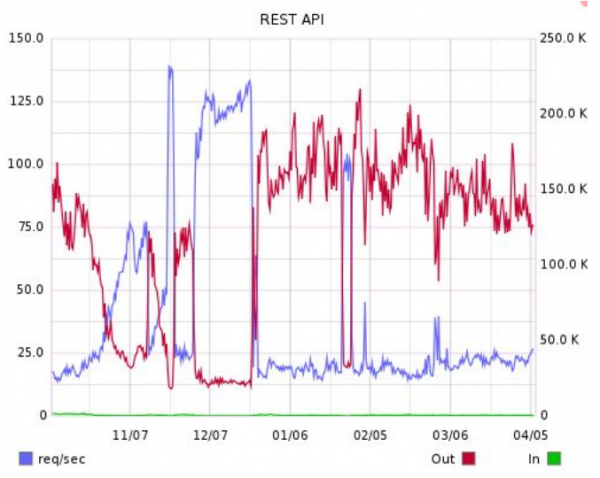
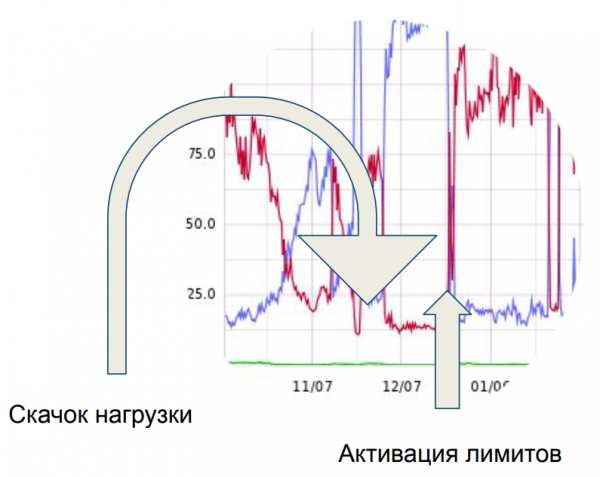
Och denna spik, som pekaren till vänster visar, orsakade fullständig häpnad hos servern som betjänade vårt API. En vecka ägnade vi åt att ta reda på vad som egentligen orsakade denna belastning. Det visade sig att det var just de förfrågningar som förmedlades till vårt API från kunder. Cirka 50 kunder stod för allt. Vid denna punkt insåg vi en av våra misstag — den fullständiga avsaknaden av gränser.
Som ett resultat införde vi en gräns för antalet samtidiga förfrågningar. Från ett konto blev det möjligt att ha högst två öppna förfrågningar samtidigt. Detta är tillräckligt för att arbeta i replikationsläge för utbyte av data i batchläge. Och de som ville använda oss som backend blev från detta ögonblick tvungna att bättre anpassa sig till prissättningarna, eftersom de införde arbete med flera konton i sina programvaror.
Vi ordnar upp
Redan från 2014 blev efterfrågan på det befintliga API:et en viktig del av verksamheten, och API:et genererade den största volymen data vid utbyte av information med kunder. År 2015 startade vi projektet för att ordna upp API:et. Vi valde JSON istället för XML som format och började bygga det baserat på de egenskaper som vi identifierade vid genomförandet av den tidigare versionen:
- Möjlighet att hantera versioner. Versionshantering gör det möjligt att utveckla en ny version utan att påverka den befintliga applikationen och utan att störa användarnas arbete.
- Möjlighet för användaren att se metadata i själva svaret de får.
- Möjlighet att dela stora dokument. Om vi hanterar dokument med fler än 4-5 tusen poster blir det ett problem för servern: lång transaktion, lång http-förfrågan. Vi har byggt en speciell mekanism som möjliggör att uppdatera dokumenten i delar och hantera individuella poster av dokumentet genom att skicka dem till servern.
- Verktyg för replikering – fanns också i den tidigare versionen.
- Belastningsgränser – som ett arv från de problem vi stötte på i den tidigare versionen. Vi införde gränser för antal förfrågningar under en tidsperiod, antal parallella förfrågningar och förfrågningar från en och samma ip-adress.
Sedan dess har vi släppt två mindre versioner av API:et och lanserat flera specialiserade API:er, men överlag har tillvägagångssättet förblivit oförändrat. Den uppdaterade dataformatet och den nya arkitekturen har gjort att vi kan åtgärda bristerna i API:et betydligt snabbare.
API för MoїgSklad idag
Idag löser API för MoїgSklad många uppgifter:
- datautbyte med nätbutiker, redovisningssystem, banker;
- hämtning av beräkningsdata, rapporter;
- användning som backend för klientapplikationer – våra mobilapplikationer och skrivbordskassa fungerar via API
- skicka meddelanden om dat förändringar i MoїgSklad – webhooks;
- telefoni;
- lojalitetssystem.
Baserat på API skrev vår VD Askar Rakhimberdiev på fyra timmar en telegram-bot som hämtar lagersaldon genom API:
Nu till torra siffror.
Här är vår statistik för det gamla REST API:et:
- 400 företag;
- 600 användare;
- 2 miljoner förfrågningar per dag;
- 200 GB/dag utgående trafik.
Och här är vad vi har kommit fram till med alla API:er för MoїgSklad:
- mer än 70 integrationer (en del av dem kan ses här );
- 8500 företag;
- 12 000 användare;
- 46 miljoner förfrågningar per dag;
- 2 TB/dag utgående trafik.
Vad händer härnäst
API-utvecklingsplaner är under aktiv diskussion. Vi försöker ta hänsyn till användarens erfarenheter. Det är inte alltid möjligt att göra allt på en gång, men en ny version av API:et med mer användarvänliga metadata och en mindre rörig struktur, samt OAuth för autentisering, är på väg, liksom API för inbäddade applikationsgränssnitt.
Du kan följa nyheterna på en särskild webbplats för utvecklare som integrerar med MittLager: .
Källa: habr.com
