

Nyligen berättade jag hur man med hjälp av standardrecept från PostgreSQL-databasen. Idag handlar det om hur man kan göra skrivning till databasen mer effektiv utan att använda några "justeringar" i konfigurationen – helt enkelt genom att organisera datastreams på rätt sätt.
#1. Секционирование
En artikel om hur och varför man bör organisera har redan funnits, här handlar det om praktisk tillämpning av vissa metoder inom ramen för vår .
"Det var länge sen…"
Till en början, precis som varje MVP, startade vårt projekt under en ganska låg belastning – övervakningen skedde endast för ett dussin av de mest kritiska servrarna, alla tabeller var relativt kompakta… Men tiden gick och antalet övervakade värdar ökade, och när vi försökte göra något med en av tabellerna som var 1,5 TB, insåg vi att det visserligen gick att leva så, men det var mycket obekvämt.
Tiderna var nästan legendariska och olika versioner av PostgreSQL 9.x var aktuella, så all separation fick göras "manuellt" – genom tabellärv och triggar routing med dynamiska KÖR.
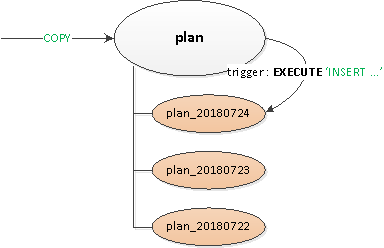
Den lösning som uppstod visade sig vara tillräckligt universell för att kunna överföras till alla tabeller:
- En tom "huvud"-föräldratabell deklarerades, där alla nödvändiga index och triggar beskrevs.
- Skrivning från klientens perspektiv gjordes i "rot"-tabellen, och inuti med hjälp av ruttrigger
BEFORE INSERTgjordes den "fysiskt" i rätt sektion. Om den inte redan fanns fångade vi upp ett undantag och … - … med hjälp av skapades en sektion med begränsning på rätt datum, så att när data hämtades gjordes läsningen endast i den.
PG10: första försöket
Men sektionering genom arv har historiskt sett inte varit särskilt anpassad för att hantera en aktiv skrivström eller ett stort antal underordnade sektioner. Till exempel kan man minnas att algoritmen för att välja rätt sektion hade kvadratisk komplexitet, vilket, med 100+ sektioner, fungerar, ja ni förstår ju hur…
I PG10 har denna situation optimerats kraftigt, med stöd för . Därför försökte vi direkt använda det efter migreringen av lagringen, men…
När vi grävde igenom manualen visade det sig att den nativt partitionerade tabellen i denna version:
- inte stödjer beskrivning av index
- inte stöder triggers på den
- kan inte vara ingen "avkomling"
- stödjer inte
INSERT ... ON CONFLICT - kan inte automatiskt generera partition
Efter att ha fått en smäll i pannan med en kratta insåg vi att vi inte skulle kunna klara oss utan att modifiera applikationen, och vi sköt upp vidare forskning i sex månader.
PG10: en andra chans
Så vi började lösa de uppkomna problemen ett i taget:
- Eftersom triggers och
ON CONFLICTvisade sig vara nödvändiga på vissa ställen, för att hantera dem skapade vi en mellan- proxy-tabell. - Vi blev av med "routing" i triggers — det vill säga av
KÖR. - Vi separerade ut en malltabell med alla index, så att de inte ens skulle finnas i proxy-tabellen.
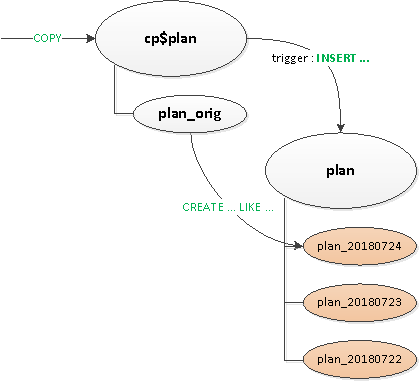
Till slut, efter allt detta, partitionerade vi den huvudsakliga tabellen nativt. Att skapa en ny partition blev kvar på applikationens samvete.
"Vi skapar" ordböcker
Precis som i varje analytiskt system hade vi också "fakta" och "dimensioner" (ordböcker). I vårt fall var detta till exempel av typiska långsamma förfrågningar eller själva texten av förfrågningen.
"Fakta" hade vi redan partitionerat efter dagar ganska länge, så vi tog lugnt bort föråldrade partitioner, och de störde oss inte (loggarna alltså!). Men med ordböckerna blev det problem…
Inte för att det fanns mycket av dem, men ungefär för 100TB "fakta" fick vi ett ordbok på 2,5TB.. Från en sådan tabell är det bekvämt att inte ta bort något, inte komprimera på rimlig tid, och skrivningen blev gradvis allt långsammare.
Särskilt ordboken… varje post bör representeras exakt en gång… och det är korrekt, men!.. Ingen hindrar oss från att ha en separat ordbok för varje dag! Ja, det ger viss överflöd, men det möjliggör:
- att skriva/läsa snabbare tack vare mindre storlek på partitionen
- att använda mindre minne tack vare arbete med mer kompakta index
- att lagra mindre data tack vare möjligheten till snabb radering av föråldrade
Som ett resultat av hela åtgärdskomplexet minskade CPU-belastningen med ~30%, diskbelastningen med ~50%:
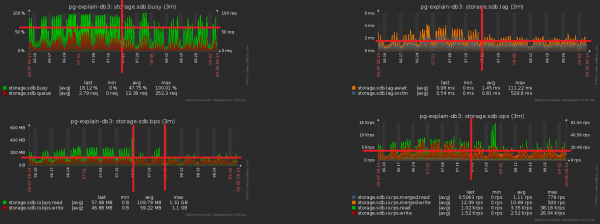
Under tiden fortsatte vi att skriva till databasen exakt detsamma, bara med mindre belastning.
#2. Эволюция и рефакторинг БД
Så vi stannade vid att vi har en sektion för varje dag med data. Faktiskt, CHECK (dt = '2018-10-12'::date) — är nyckeln för sektioneringen och villkoret för att en post ska hamna i en specifik sektion.
Eftersom alla rapporter i vår tjänst byggs upp i samband med ett specifikt datum, så hade också indexen från "icke-sektionerade tider" alltid varit av typen (Server, Datum, Planmall), (Server, Datum, Plannod), (Datum, Felklass, Server),…
Men nu finns det egna instanser av varje sådant index... Och inom varje sektion är datumet en konstant… Så nu skriver vi bokstavligen in konstanten som ett av fälten i varje sådant index, vilket gör både dess volym och söktiden större, men utan att ge något resultat. Vi har lämnat oss själva fällor, oops... Riktningen för optimeringen är uppenbar — helt enkelt
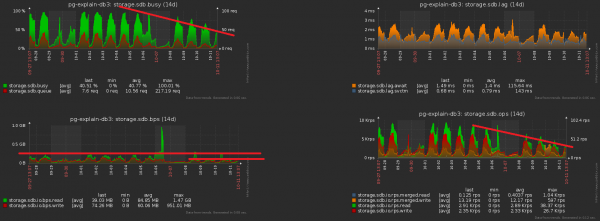
tar vi bort fältet med datum från alla index i sektionerade tabeller. Med våra volymer ger det en vinst på omkring 1TB/vecka Och nu låt oss notera att denna terabyte också måste registreras på något sätt. Det vill säga vi måste nu också!
belasta disken mindre ! Denna bild visar tydligt effekten av den städning vi ägnade en vecka åt:Ett av de stora problemen med belastade system är
#3. «Размазываем» пиковую нагрузку
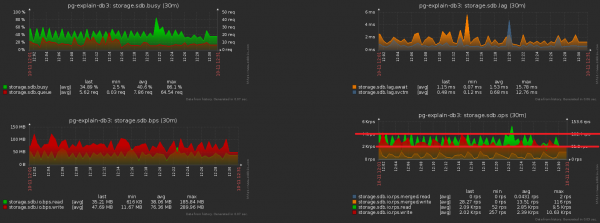
överskottssynkronisering av vissa operationer som inte kräver det. Ibland "för att man inte märkte", ibland "för att det var enklare", men förr eller senare måste man göra sig av med den. Vi zoomar in på den tidigare bilden — och ser att disken
"drar" i belastning med dubbla amplituden mellan närliggande mätningar, vilket uppenbarligen "statistiskt" inte borde hända med så mycket operationer: Det är ganska enkelt att uppnå. Vi hade redan
nästan 1000 servrar , var och en hanteras av en separat logisk ström, och varje ström skickar den insamlade informationen för att skickas till databasen med en viss periodicitet, ungefär så här:setInterval(sendToDB, interval)
Problemet här ligger precis i det attalla strömmar startar nästan samtidigt , så tidpunkterna för att skicka sammanfaller nästan alltid "till punkt". Oops nr 2...Lyckligtvis kan detta fixas ganska enkelt,
genom att lägga till en "slumptalsbaserad" förskjutning i tid: setInterval(sendToDB, interval * (1 + 0.1 * (Math.random() - 0.5)))
Det tredje traditionella highload-problemet —#4. Кэшируем, что нужно можно
är frånvaron av cache där den borde vara. skulle kunna быть.
Till exempel har vi möjliggjort analys på planens nodnivå (alla dessa Seq Scan på användare), men att direkt tänka att de, i huvudsak, är identiska — är glömt.
Nej, självklart skrivs inget upprepade gånger till databasen, det blockerar triggern med INSERT ... ON CONFLICT DO NOTHING. Men dessa data når fortfarande databasen, och dessutom krävs det onödig läsning för att kontrollera konflikten måste göras. Oops nr 3…
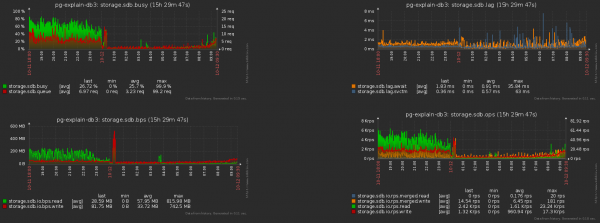
Skillnaden i mängden poster som skickas till databasen före/efter aktivering av cachning — är uppenbar:
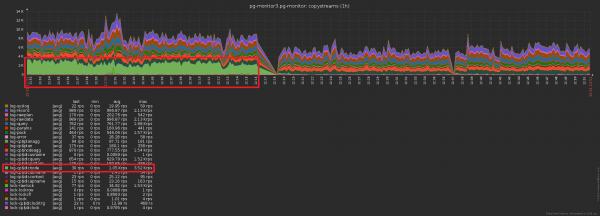
Och detta — är det tillhörande minskningen av belastningen på lagringen:
Sammanfattningsvis
«Terabyte-per-dag» låter bara skrämmande. Om du gör allt rätt, så handlar det bara om 2^40 byte / 86400 sekunder = ~12.5MB/s, vilket även konsumerades av stationära IDE-hårddiskar. 🙂
Och om vi ska vara seriösa, så kan du även med en tiodubblad belastning under ett dygn, lätt klara av kapaciteten hos moderna SSD:er.
Källa: habr.com
