

För sex månader sedan — en offentlig för PostgreSQL.
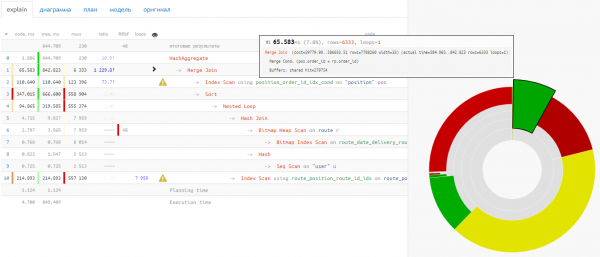
Under de senaste månaderna har vi gjort en rapport om den , förberett en sammanfattande baserat på rekommendationer som den ger... men viktigast av allt har vi samlat era feedback och observerat verkliga användningsfall.
Och nu är vi redo att berätta om de nya funktionerna som ni kan använda.
Stöd för olika planformat
Plan från loggen, tillsammans med frågan
Direkt från konsolen markerar vi hela blocket, som börjar från raden med Query Text, med alla ledande mellanslag:
        Query Text: INSERT INTO  dicquery_20200604  VALUES ($1.*) ON CONFLICT (query)
                           DO NOTHING;
        Insert on dicquery_20200604  (cost=0.00..0.05 rows=1 width=52) (actual time=40.376..40.376 rows=0 loops=1)
          Conflict Resolution: NOTHING
          Conflict Arbiter Indexes: dicquery_20200604_pkey
          Tuples Inserted: 1
          Conflicting Tuples: 0
          Buffers: shared hit=9 read=1 dirtied=1
          -<  Result  (cost=0.00..0.05 rows=1 width=52) (actual time=0.001..0.001 rows=1 loops=1)
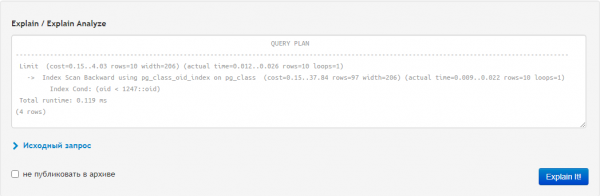
… och vi kastar allt kopierat direkt in i fältet för planen, utan att dela upp något:
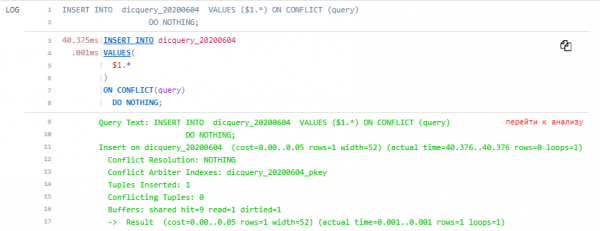
Resultatet ger oss ett bonus till den analyserade planen, plus fliken "kontext", där vår fråga presenteras i all sin prakt:
JSON och YAML
EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON)
SELECT * FROM pg_class;
"[
{
"Plan": {
"Node Type": "Seq Scan",
"Parallel Aware": false,
"Relation Name": "pg_class",
"Alias": "pg_class",
"Startup Cost": 0.00,
"Total Cost": 1336.20,
"Plan Rows": 13804,
"Plan Width": 539,
"Actual Startup Time": 0.006,
"Actual Total Time": 1.838,
"Actual Rows": 10266,
"Actual Loops": 1,
"Shared Hit Blocks": 646,
"Shared Read Blocks": 0,
"Shared Dirtied Blocks": 0,
"Shared Written Blocks": 0,
"Local Hit Blocks": 0,
"Local Read Blocks": 0,
"Local Dirtied Blocks": 0,
"Local Written Blocks": 0,
"Temp Read Blocks": 0,
"Temp Written Blocks": 0
},
"Planning Time": 5.135,
"Triggers": [
],
"Execution Time": 2.389
}
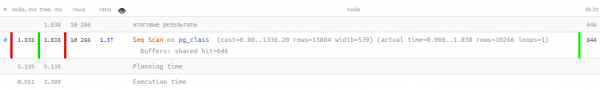
]"Oavsett om den har yttre citattecken, som pgAdmin kopierar, eller inte – vi kastar in det i samma fält, så får vi det ändå vackert:
Utökad visualisering
Planning Time / Execution Time
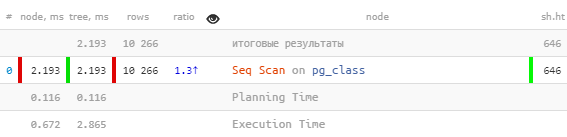
Nu är det tydligare var den extra tiden gick vid frågekörning:
I/O Timing
Ibland stöter man på en situation där det i planen verkar som att det inte lästs eller skrivits särskilt mycket resurser, men att körningstiden är orimligt lång.
Här måste man säga: "Oj, kanske var disken på servern för överbelastad vid det tillfället, så det tog så lång tid att läsa!" Men det är inte riktigt exakt...
Men man kan avgöra det helt pålitligt. Poängen är att bland PG-serverns konfigurationsalternativ finns det :
Inkluderar mätning av tid för in- och utdataoperationer. Denna parameter är som standard avstängd, eftersom det kräver att det aktuella tidpunkten kontinuerligt frågas från operativsystemet, vilket kan försena arbetet betydligt på vissa plattformar. För att bedöma mätningskostnaderna på din plattform kan du använda verktyget pg_test_timing. Statistik för in- och utdata kan erhållas genom vyerna pg_stat_database, i utdata från EXPLAIN (när parametern BUFFERS används) och genom vyerna pg_stat_statements.
Denna parameter kan också aktiveras inom en lokal session:
SET track_io_timing = TRUE;Nu kommer det trevligaste — vi har lärt oss att förstå och visa dessa data med hänsyn till alla transformationer av exekveringsträdet:
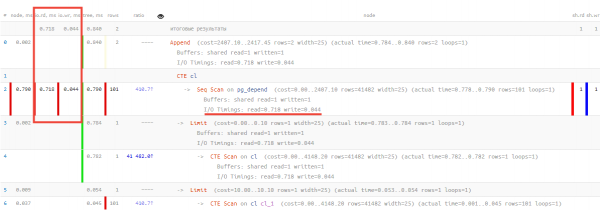
Här kan vi se att av 0.790 ms av den totala exekveringstiden tog läsningen av en databas sida 0.718 ms, skrivningen av densamma 0.044 ms, och hela den övriga nyttiga aktiviteten kostade endast 0.028 ms!
Framtiden med PostgreSQL 13
Du kan bekanta dig med den fullständiga översikten av nyheterna , men vi pratar specifikt om ändringarna i planerna.
Planeringsbuffertar
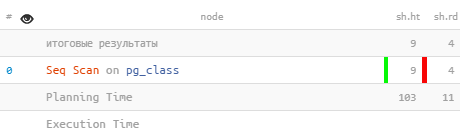
Redovisningen av resurser som tilldelas planeringsarenan har fått sitt uttryck även i en annan patch som inte är relaterad till pg_stat_statements. EXPLAIN med alternativet BUFFERS kommer att rapportera antalet buffertar som använts under planeringssteget:
 Seq Scan on pg_class (actual rows=386 loops=1)
 Buffers: shared hit=9 read=4
 Planning Time: 0.782 ms
 Buffers: shared hit=103 read=11
 Execution Time: 0.219 ms
Inkrementell sortering
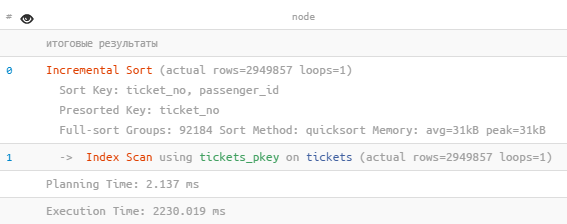
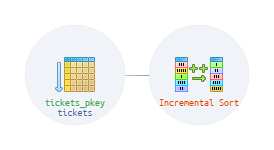
I de fall där sortering efter många nycklar (k1, k2, k3...) är nödvändig, kan planören nu utnyttja kunskapen om att data redan är sorterade efter flera av de första nycklarna (till exempel k1 och k2). I detta fall kan man undvika att om-sortera alla data igen, utan i stället dela upp dem i sekventiella grupper med samma värden för k1 och k2, och "delsortera" efter nyckeln k3.
På så sätt bryts hela sorteringen ner i flera sekventiella sorteringar av mindre storlek. Detta minskar den nödvändiga minnesmängden och gör det också möjligt att returnera de första data snabbare än när hela sorteringen är klar.
 Incremental Sort (actual rows=2949857 loops=1)
 Sort Key: ticket_no, passenger_id
 Presorted Key: ticket_no
 Full-sort Groups: 92184 Sort Method: quicksort Memory: avg=31kB peak=31kB
 ->  Index Scan using tickets_pkey on tickets (actual rows=2949857 loops=1)
 Planning Time: 2.137 ms
 Execution Time: 2230.019 ms
Förbättringar av UI/UX
Skärmdumpar, de finns överallt!
Nu finns det en möjligheten att snabbt ta en skärmdump av fliken till urklipp i full bredd och djup av fliken — "siktet" uppe till höger:
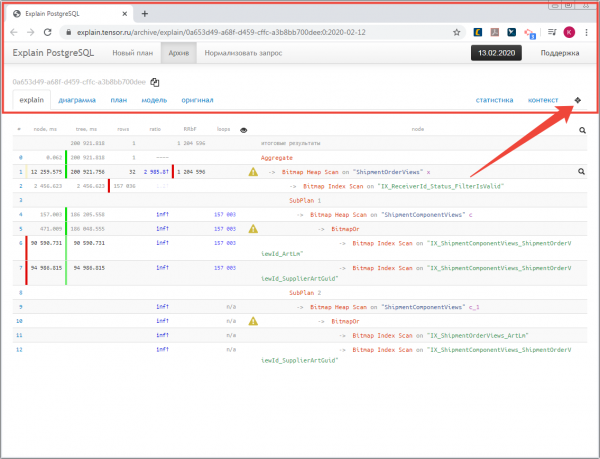
Faktiskt har de flesta bilderna för denna publikation erhållits just på det sättet.
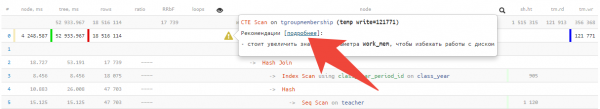
Rekommendationer på noder
Det har inte bara blivit fler, utan man kan också , genom att följa länken:
Borttagning från arkivet
Många har bett om att lägga till möjligheten att "ta bort helt" även de icke-publicerade planerna i arkivet — det räcker att trycka på den motsvarande ikonen:
Nåväl, och glöm inte att vi har en , dit ni kan skriva era kommentarer och förslag.
Källa: habr.com
