

— en mycket kraftfull och bekväm mekanism när samma åtgärder utförs 'djupt' på relaterade data. Men okontrollerad rekursion är en ondska som kan leda till antingen oändlig körning av processen, eller (vilket sker oftare) till att 'äta upp' all tillgänglig minne.
Databaser fungerar på samma sätt — "sa de att gräva, så gräver jag". Din fråga kan inte bara bromsa angränsande processer genom att ständigt ta CPU-resurser, utan också 'falla' hela databasen genom att 'äta' all tillgänglig minne. Därför skydd mot oändlig rekursion är utvecklarens ansvar.
I PostgreSQL fanns möjligheten att använda rekursiva frågor via sedan urminnes tider i version 8.4, men man kan fortfarande regelbundet stöta på potentiellt sårbara 'oskyddade' frågor. Hur undviker man sådana problem?
Att inte skriva rekursiva frågor
Utan att skriva icke-rekursiva. Med vänliga hälsningar, Er K.O.
I själva verket erbjuder PostgreSQL en tillräckligt stor mängd funktionalitet som man kan utnyttja för att inte använda rekursion.
Använda en principielt annan metod för uppgiften
Ibland kan man helt enkelt betrakta uppgiften 'från en annan sida'. Ett exempel på en sådan situation presenterade jag i artikeln — multiplikation av en uppsättning tal utan att använda användardefinierade aggregatfunktioner:
WITH RECURSIVE src AS (
  SELECT '{2,3,5,7,11,13,17,19}'::integer[] arr
)
, T(i, val) AS (
  SELECT
    1::bigint
  , 1
UNION ALL
  SELECT
    i + 1
  , val * arr[i]
  FROM
    T
  , src
  WHERE
    i <= array_length(arr, 1)
)
SELECT
  val
FROM
  T
ORDER BY -- val av det slutgiltiga resultatet
  i DESC
LIMIT 1;
En sådan fråga kan ersättas med en version av matematikexperter:
WITH src AS (
  SELECT unnest('{2,3,5,7,11,13,17,19}'::integer[]) prime
)
SELECT
  exp(sum(ln(prime)))::integer val
FROM
  src;
Använd generate_series istället för loopar
Anta att vi har uppgiften att generera alla möjliga prefix för strängen 'abcdefgh':
WITH RECURSIVE T AS (
  SELECT 'abcdefgh' str
UNION ALL
  SELECT
    substr(str, 1, length(str) - 1)
  FROM
    T
  WHERE
    length(str) > 1
)
TABLE T;
Behövs verkligen rekursion här?.. Om man utnyttjar LATERAL och generate_series, så behövs inte ens CTE:
SELECT
  substr(str, 1, ln) str
FROM
  (VALUES('abcdefgh')) T(str)
, LATERAL(
    SELECT generate_series(length(str), 1, -1) ln
  ) X;
Ändra databasstrukturen
Till exempel, om du har en forum meddelandetabell och kopplingar för vem som svarade på vem eller ett tråd i :
CREATE TABLE message(
  message_id
    uuid
      PRIMARY KEY
, reply_to
    uuid
      REFERENCES message
, body
    text
);
CREATE INDEX ON message(reply_to); 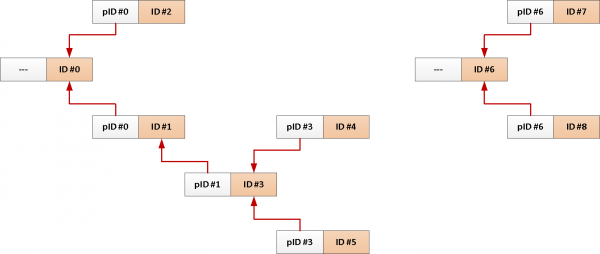
Typiskt sett ser en fråga för att hämta alla meddelanden i ett ämne ut ungefär så här:
WITH RECURSIVE T AS (
  SELECT
    *
  FROM
    message
  WHERE
    message_id = $1
UNION ALL
  SELECT
    m.*
  FROM
    T
  JOIN
    message m
      ON m.reply_to = T.message_id
)
TABLE T;
Men eftersom vi alltid behöver hela tråden från meddelandet, varför inte lägga till dess identifierare i varje post automatiskt?
-- låt oss lägga till ett fält med ett gemensamt ämnes-ID och en index för det
ALTER TABLE message
  ADD COLUMN theme_id uuid;
CREATE INDEX ON message(theme_id);

-- initialisera ämnes-ID i triggern vid insättning
CREATE OR REPLACE FUNCTION ins() RETURNS TRIGGER AS $$
BEGIN
  NEW.theme_id = CASE
    WHEN NEW.reply_to IS NULL THEN NEW.message_id -- ta från startmeddelandet
    ELSE ( -- eller från meddelandet som vi svarar på
      SELECT
        theme_id
      FROM
        message
      WHERE
        message_id = NEW.reply_to
    )
  END;
  RETURN NEW;
END;
$$ LANGUAGE plpgsql;

CREATE TRIGGER ins BEFORE INSERT
  ON message
    FOR EACH ROW
EXECUTE PROCEDURE ins(); 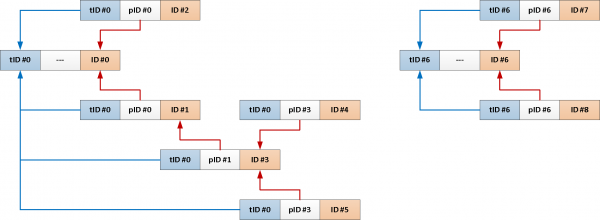
Nu kan hela vår rekursiva fråga reduceras till något så enkelt som följande:
SELECT
  *
FROM
  message
WHERE
  theme_id = $1;
Använda applikations "begränsningar"
Om vi av någon anledning inte kan ändra databasstrukturen, låt oss titta på vad vi kan luta oss mot så att även när det finns fel i data, inte leder till oändlig rekursion.
Räknare för "djupet" av rekursion
Vi ökar helt enkelt räknaren med ett på varje steg av rekursionen fram till den punkt vi anser vara uppenbart otillåten:
WITH RECURSIVE T AS (
  SELECT
    0 i
  ...
UNION ALL
  SELECT
    i + 1
  ...
  WHERE
    T.i < 64 -- gräns
)
Pro: Vid försök till oändlighet kommer vi ändå inte att göra mer än det angivna antalet iterationer "ner".
Contra: Det finns ingen garanti för att vi inte kommer att behandla samma post flera gånger - till exempel på djupet 15 och 25, och sedan vidare för varje +10. Ingen har lovat något "på bredden" heller.
Formellt sett kommer sådan rekursion inte att vara oändlig, men om antalet poster ökar exponentiellt vid varje steg, vet vi alla hur det slutar…
Väktare av "vägen"
Vi skriver sekventiellt in alla identifierare vi stöter på under rekursionsvägen i en array som är den unika "vägen" fram till den:
MED REKURSIV T SOM (
  VÄLJ
    ARRAY[id] väg
  ...
UNION ALL
  VÄLJ
    väg || id
  ...
  DÄR
    id  ALL(T.väg) -- matchar inte någon av
)
Pro: Vid förekomst av en cykel i datan kommer vi absolut inte att bearbeta samma post igen inom samma väg.
Contra: Men vi kan bokstavligen gå igenom alla poster utan att upprepa oss.
Begränsning av vägslängd
För att undvika situationen med "vilsen" rekursion på en otydlig djup kan vi kombinera de två föregående metoderna. Eller, om vi inte vill stödja onödiga fält, kan vi komplettera villkoret för fortsatt rekursion med en utvärdering av vägslängden:
MED REKURSIV T SOM (
  VÄLJ
    ARRAY[id] väg
  ...
UNION ALL
  VÄLJ
    väg || id
  ...
  DÄR
    id  ALL(T.väg) OCH
    array_length(T.väg, 1) < 10
)
Välj metod efter eget tycke!
Källa: habr.com
