

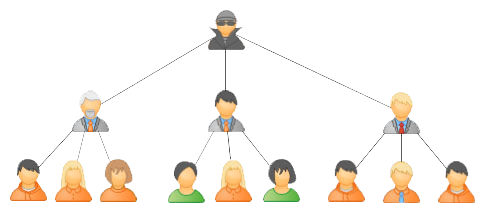
I komplexa ERP-system har många enheter en hierarkisk natur, där homogena objekt ordnas i ett träd av relationer "förälder - barn" — detta inkluderar både organisationsstrukturen av företaget (alla dessa filialer, avdelningar och arbetsgrupper), produktkatalogen, arbetsområdena och geografiska försäljningspunkter,…
Faktiskt finns det ingen , där det inte finns någon hierarki som uppstår. Men även om du inte arbetar "i affärsvärlden", kan du ändå stöta på hierarkiska relationer. Enkelt uttryckt, även ditt släktträd eller planen för våningsutrymmen i ett köpcentrum är en liknande struktur.
Det finns många sätt att lagra ett sådant träd i en databas, men idag kommer vi bara att fokusera på ett alternativ:
CREATE TABLE hier(
  id
    integer
      PRIMARY KEY
, pid
    integer
      REFERENCES hier
, data
    json
);

CREATE INDEX ON hier(pid); -- glöm inte att FK inte automatiskt skapar ett index, till skillnad från PK
Och medan du granskar djupet av hierarkin, väntar den tålmodigt på hur [o]effektiva dina "naiva" metoder att hantera en sådan struktur visar sig vara.
Låt oss gå igenom typiska uppkommande uppgifter, deras implementering i SQL och försöka förbättra deras prestanda.
#1. Насколько глубока кроличья нора?
Låt oss, för tydlighetens skull, anta att denna struktur ska återspegla avdelningarnas över- och underordning i organisationsstrukturen: avdelningar, divisioner, sektorer, filialer, arbetsgrupper,… — vad du än kallar dem.
Först ska vi generera vårt 'träd' med 10K element
INSERT INTO hier
WITH RECURSIVE T AS (
  SELECT
    1::integer id
  , '{1}'::integer[] pids
UNION ALL
  SELECT
    id + 1
  , pids[1:(random() * array_length(pids, 1))::integer] || (id + 1)
  FROM
    T
  WHERE
    id < 10000
)
SELECT
  pids[array_length(pids, 1)] id
, pids[array_length(pids, 1) - 1] pid
FROM
  T;
Låt oss börja med den enklaste uppgiften — att hitta alla anställda som arbetar inom en viss sektor, eller i termer av hierarkin — att hitta alla ättlingar till en nod. Dessutom kan det vara bra att få "djupet" av ättlingen... Allt detta kan vara nödvändigt, till exempel för att bygga ett .
Det skulle vara okej om det bara fanns ett par nivåer av dessa ättlingar och deras antal var i tiotal, men om det finns mer än 5 nivåer och ättlingarna redan är i tiotal - då kan det uppstå problem. Låt oss titta på hur traditionella metoder för att söka "ner i trädet" skrivs (och fungerar). Men först, låt oss definiera vilka av noderna som kommer att vara mest intressanta för vår forskning.
De mest "djupa" underträden:
WITH RECURSIVE T AS (
  SELECT
    id
  , pid
  , ARRAY[id] path
  FROM
    hier
  WHERE
    pid IS NULL
UNION ALL
  SELECT
    hier.id
  , hier.pid
  , T.path || hier.id
  FROM
    T
  JOIN
    hier
      ON hier.pid = T.id
)
TABLE T ORDER BY array_length(path, 1) DESC;
id | pid | path
---------------------------------------------
7624 | 7623 | {7615,7620,7621,7622,7623,7624}
4995 | 4994 | {4983,4985,4988,4993,4994,4995}
4991 | 4990 | {4983,4985,4988,4989,4990,4991}
...De mest "bredda" underträden:
...
SELECT
  path[1] id
, count(*)
FROM
  T
GROUP BY
  1
ORDER BY
  2 DESC;
id | count
------------
5300 | 30
450 | 28
1239 | 27
1573 | 25
För dessa förfrågningar använde vi en typisk rekursiv JOIN:
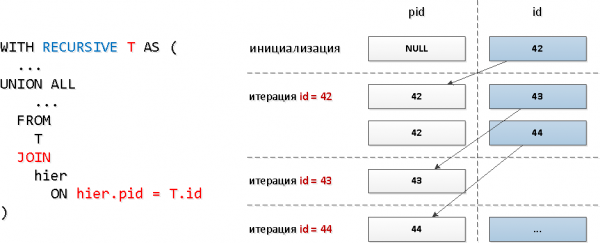
Uppenbarligen kommer antalet iterationer i denna frågemodell att motsvara det totala antalet ättlingar (och de är flera tiotal), och detta kan ta ganska betydande resurser, och därmed tid. Låt oss kontrollera på det "bredaste" underträdet:
WITH RECURSIVE T AS ( SELECT id FROM hier WHERE id = 5300 UNION ALL SELECT hier.id FROM T JOIN hier ON hier.pid = T.id ) TABLE T;
Som vi förväntade oss, hittade vi alla 30 poster. Men det tog 60 % av den totala tiden - för vi gjorde även 30 sökningar i indexet under denna tid. Finns det något sätt att göra det snabbare? 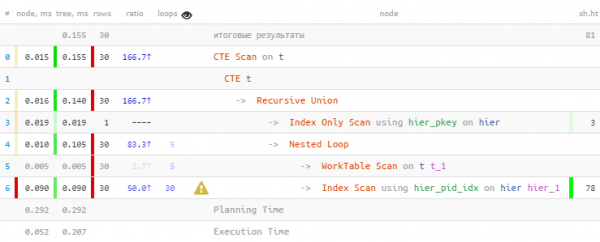
Massavläsning över indexet
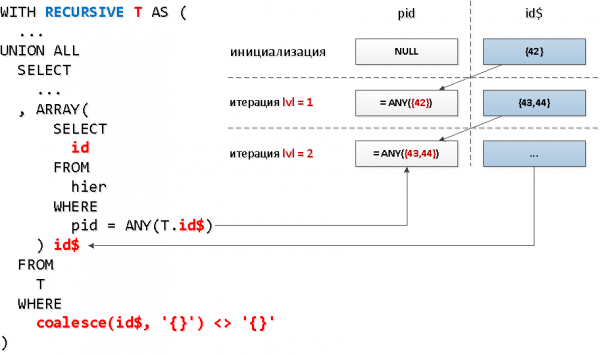
Är det verkligen nödvändigt att göra en separat förfrågan till indexet för varje nod? Det visar sig inte vara fallet - vi kan läsa från indexet
direkt med flera nycklar i ett enda anrop = ANY(array) med hjälp av Och för varje sådan grupp av identifierare kan vi ta alla ID som hittades i föregående steg för "noderna". Så på varje nästa steg kommer vi att.
söka efter alla ättlingar på en viss nivå direkt Men här är problemet,.
i den rekursiva urvalet kan vi inte referera till oss själva i den inre frågan , och vi måste på något sätt plocka ut endast det som hittades på föregående nivå ... Det visar sig att vi inte kan göra en inre fråga till hela urvalet - men vi kan till ett specifikt fält av det. Och det här fältet kan till och med vara en array - vilket är precis vad vi behöver för att användaANY Det låter lite galet, men i skissen - allt är enkelt..
Звучит несколько дико, но на схеме — все просто.
MED REKURSIV T SOM (
  VÄLJ
    ARRAY[id] id$
  FRÅN
    hier
  DÄR
    id = 5300
UNION ALL
  VÄLJ
    ARRAY(
      VÄLJ
        id
      FRÅN
        hier
      DÄR
        pid = ANY(T.id$)
    ) id$
  FRÅN
    T
  DÄR
    coalesce(id$, '{}') >> '{}' -- villkor för att avsluta loopen - tom array
)
VÄLJ
  unnest(id$) id
FRÅN
T; 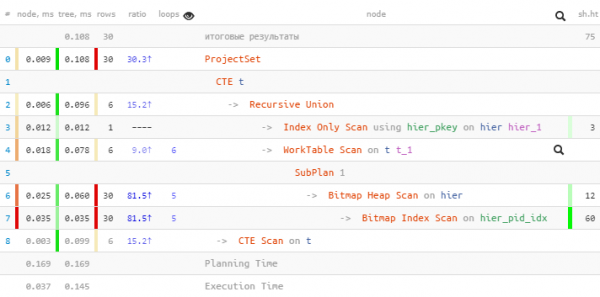
Och här är det viktigaste inte ens vinsten på 1,5 gånger i tid, utan att vi läste mindre buffers, eftersom vi har totalt 5 tillgångar till indexet istället för 30!
En ytterligare bonus är att efter den slutliga unnest kommer identifierarna att förbli sorterade efter "nivåer".
Indikator för nod
Nästa övervägande som kommer att bidra till att förbättra prestanda — bladen" kan inte ha barn, vilket betyder att det faktiskt inte behövs att söka "ner" för dem. I vår uppgift betyder detta att om vi har gått igenom en kedja av avdelningar och kommit till en anställd, så är det inte längre nödvändigt att söka längre ner i denna gren.
Låt oss lägga till en ytterligare boolean-fält, som omedelbart kommer att berätta för oss om denna specifika post i vårt träd är en "nod" — det vill säga, kan den överhuvudtaget ha efterkommande.
ALTER TABLE hier
  ADD COLUMN branch boolean;

UPPDATERA
  hier T
SET
  branch = TRUE
DÄR
  EXISTS(
    VÄLJ
      NULL
    FRÅN
      hier
    DÄR
      pid = T.id
    LIMIT 1
);
-- Frågan genomfördes framgångsrikt: 3033 rader ändrades på 42 ms.
Utmärkt! Det visar sig att endast lite mer än 30% av alla trädets element har efterkommande.
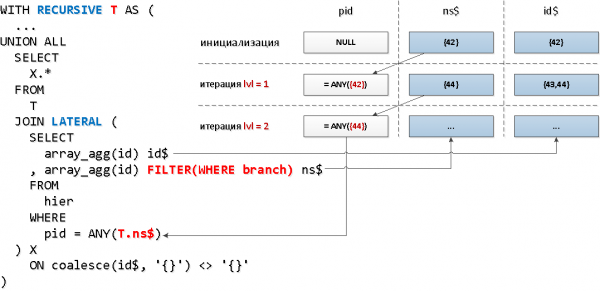
Nu ska vi använda en något annan mekanik — föreningar med den rekursiva delen via LATERAL, vilket gör att vi omedelbart kan nå fälten från den rekursiva "tabellen", och vi använder aggregatfunktionen med filtervillkoret för att minska uppsättningen av nycklar:
MED REKURSIV T SOM (
  VÄLJ
    array_agg(id) id$
  , array_agg(id) FILTER(WHERE branch) ns$
  FRÅN
    hier
  DÄR
    id = 5300
UNION ALL
  VÄLJ
    X.*
  FRÅN
    T
  GÅ MED LATERAL (
    VÄLJ
      array_agg(id) id$
    , array_agg(id) FILTER(WHERE branch) ns$
    FRÅN
      hier
    DÄR
      pid = ANY(T.ns$)
  ) X
    PÅ coalesce(T.ns$, '{}') >> '{}'
)
VÄLJ
  unnest(id$) id
FRÅN
T; 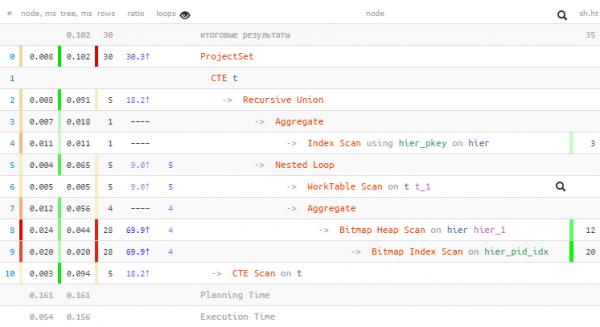
Vi lyckades minska ett tillgång till indexet och vann mer än 2 gånger vad som lästes. Detta algoritm kommer att vara användbar om du behöver samla register för alla element "uppåt i trädet", samtidigt som du bevarar information om vilken ursprunglig blad (och med vilka indikatorer) som orsakade dess inkludering i urvalet — till exempel för att skapa en sammanställning med aggregering på noder.
#2. Вернемся к корням
Этот алгоритм будет полезен, если вам необходимо собрать записи для всех элементов «вверх по дереву», сохранив при этом информацию, каким исходным листом (и с какими показателями) вызвано его попадание в выборку — например, для формирования сводного отчета с агрегацией на узлы.
Det fortsatta bör endast betraktas som ett proof-of-concept, eftersom förfrågan blir ganska klumpig. Men om den dominerar i din databas – bör du överväga att använda liknande metoder.
Låt oss börja med ett par enkla påståenden:
- Samma post i databasen är bättre att läsa bara en gång.
- Posterna från databasen är mer effektiva att läsa "i ett svep", än en och en.
Nu ska vi försöka konstruera den förfrågan vi behöver.
Steg 1
Det är uppenbart att vid initialisering av rekursionen (vad annars!) så måste vi läsa posten av bladen baserat på uppsättningen av ursprungliga identifierare:
WITH RECURSIVE tree AS (
  SELECT
    rec -- detta är den fullständiga posten av tabellen
  , id::text chld -- detta är "uppsättningen" av blad som ledde hit
  FROM
    hier rec
  WHERE
    id = ANY('{1,2,4,8,16,32,64,128,256,512,1024,2048,4096,8192}'::integer[])
UNION ALL
  ...
Om någon tyckte att det var konstigt att "uppsättningen" lagras som en sträng och inte som en array, så finns det en enkel förklaring till detta. För strängar finns det en inbyggd aggregerande "sammanslagnings"-funktion string_agg, men för arrays finns det inte. Även om det är .
Steg 2
Nu vill vi få en uppsättning ID:n för avsnitten som vi kommer att läsa vidare. De kommer nästan alltid att dupliceras i olika poster av den ursprungliga uppsättningen – därför vill vi gruppera dem, samtidigt som vi behåller informationen om källbladen.
Men här står vi inför tre problem:
- Den "Underrekursiva" delen av förfrågan kan inte innehålla aggregatfunktioner med
GROUP BY. - Åtkomst till den rekursiva "tabellen" kan inte göras i en inre underfråga.
- Förfrågan i den rekursiva delen kan inte innehålla CTE.
Lyckligtvis kan alla dessa problem lösas ganska enkelt. Låt oss börja från slutet.
CTE i den rekursiva delen
Så här inte fungerar:
WITH RECURSIVE tree AS (
  ...
UNION ALL
  WITH T (...)
  SELECT ...
)
Och så här – fungerar, parenteserna löser problemet!
WITH RECURSIVE tree AS (
  ...
UNION ALL
  (
    WITH T (...)
    SELECT ...
  )
)
Inre förfrågan till den rekursiva "tabellen"
Hm… Åtkomst till den rekursiva CTE kan inte vara i en inre förfrågan. Men den kan vara inuti CTE! Och den inre förfrågan kan redan referera till denna CTE!
GROUP BY inuti rekursionen
Obehagligt, men… Vi har ju ett enkelt sätt att simulera GROUP BY med hjälp av DISTINCT ON och fönsterfunktioner!
SELECT
  (rec).pid id
, string_agg(chld::text, ',') chld
FROM
  tree
WHERE
  (rec).pid IS NOT NULL
GROUP BY 1 -- fungerar inte!
Men så här – fungerar!
SELECT DISTINCT ON((rec).pid)
  (rec).pid id
, string_agg(chld::text, ',') OVER(PARTITION BY (rec).pid) chld
FROM
  tree
WHERE
  (rec).pid IS NOT NULL
Nu ser vi varför det numeriska ID:t omvandlades till text – för att de kan sammanfogas med kommatecken!
Steg 3
För finalen återstår bara en liten ansträngning:
- vi läser in posterna för "sektioner" baserat på uppsättningen av grupperade ID:n
- översätter de lästa sektionerna med "uppsättningar" av de ursprungliga bladen
- vi "utvecklar" raduppsättningen med hjälp av
unnest(string_to_array(chld, ',')::integer[])
WITH RECURSIVE tree AS (
  SELECT
    rec
  , id::text chld
  FROM
    hier rec
  WHERE
    id = ANY('{1,2,4,8,16,32,64,128,256,512,1024,2048,4096,8192}'::integer[])
UNION ALL
  (
    WITH prnt AS (
      SELECT DISTINCT ON((rec).pid)
        (rec).pid id
      , string_agg(chld::text, ',') OVER(PARTITION BY (rec).pid) chld
      FROM
        tree
      WHERE
        (rec).pid IS NOT NULL
    )
    , nodes AS (
      SELECT
        rec
      FROM
        hier rec
      WHERE
        id = ANY(ARRAY(
          SELECT
            id
          FROM
            prnt
        ))
    )
    SELECT
      nodes.rec
    , prnt.chld
    FROM
      prnt
    JOIN
      nodes
        ON (nodes.rec).id = prnt.id
  )
)
SELECT
  unnest(string_to_array(chld, ',')::integer[]) leaf
, (rec).*
FROM
tree; 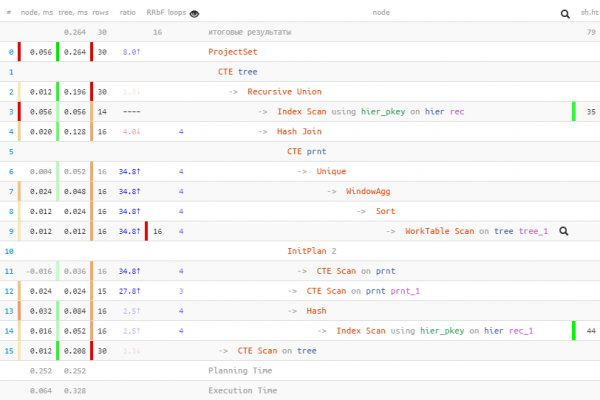
Källa: habr.com
