

Utvecklare har ibland behov av att överföra en uppsättning parametrar eller till och med en hel urval till "indatan". Ibland stöter man på mycket märkliga lösningar på detta problem.
Låt oss gå "bakifrån" och titta på hur man inte bör göra, varför, och hur man kan göra det bättre.
Direkt "injicering" av värden i begäran
Ser oftast ut ungefär så här:
query = "SELECT * FROM tbl WHERE id = " + value... eller så här:
query = "SELECT * FROM tbl WHERE id = :param".format(param=value)Det finns redan mycket skrivet, sagt och om detta:
Nästan alltid är detta en direkt väg till SQL-injektioner och onödig belastning på affärslogiken, som tvingas "klistra" ihop din begärans sträng.
En del av denna metod kan vara berättigad endast om det är nödvändigt att använda partitionering i versioner av PostgreSQL 10 och lägre för att få en mer effektiv plan. I dessa versioner bestäms listan över skannade avsnitt utan att ta hänsyn till de överförda parametrarna, endast baserat på begärans kropp.
$n-argument
Användning parametrar – det är bra, eftersom det tillåter användning av , vilket minskar belastningen både på affärslogiken (begärans sträng skapas och överförs endast en gång) och på databasservern (ingen behov av omparsing och planering för varje begärans instans).
Variabelt antal argument
Problem kommer att vänta på oss när vi vill överföra ett okänt antal argument:
... id IN ($1, $2, $3, ...) -- $1 : 2, $2 : 3, $3 : 5, ...Om vi lämnar begäran på detta sätt, kommer detta, även om det skyddar oss mot potentiella injektioner, ändå att leda till behovet av att klistra ihop/parse begäran för varje alternativ beroende på antalet argument.Det är redan bättre än att göra detta varje gång, men vi kan klara oss utan det.
Det räcker med att överföra en enda parameter som innehåller en serialiserad representation av en array:
... id = ANY($1::integer[]) -- $1 : '{2,3,5,8,13}'Den enda skillnaden är nödvändigheten att uttryckligen konvertera argumentet till den nödvändiga arraytypen. Men detta orsakar inga problem eftersom vi redan vet var vi riktar oss.
Överföring av urval (matris)
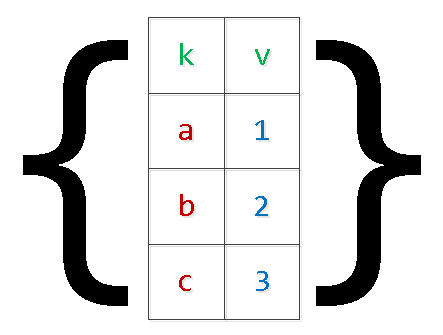
Detta är vanligtvis olika alternativ för att överföra datamängder för insättning i databasen "i ett enda anrop":
INSERT INTO tbl(k, v) VALUES($1,$2),($3,$4),...Förutom de problem som beskrivits ovan med "återklistring" av begäran kan detta dessutom leda till out of memory och serverfall. Anledningen är enkel – genom argumenten reserverar PG extra minne, och antalet poster i uppsättningen begränsas endast av de praktiska kraven i affärslogiken. I särskilt kliniska fall har man sett »numeriska» argument över $9000 – det behövs inte så.
Låt oss skriva om frågan och använda »två-nivå» serialisering:
INSERT INTO tbl
SELECT
  unnest[1]::text k
, unnest[2]::integer v
FROM (
  SELECT
    unnest($1::text[])::text[] -- $1 : '{"{a,1}","{b,2}","{c,3}","{d,4}"}'
) T;
Ja, i fallet med »komplexa» värden inuti arrayen, måste de omges av citattecken.
Det är tydligt att på detta sätt kan man »utveckla» urvalet med ett godtyckligt antal fält.
unnest, unnest, …
Ibland dyker det upp alternativ att istället för »array av arrays» använda flera »kolumn-arrays» som jag nämnde :
SELECT
  unnest($1::text[]) k
, unnest($2::integer[]) v;
Med denna metod, om man gör ett misstag vid generering av värdelistor för olika kolumner, är det väldigt enkelt att få helt oförutsedda resultat, som dessutom beror på serverversion:
-- $1 : '{a,b,c}', $2 : '{1,2}'
-- PostgreSQL 9.4
k | v
-----
a | 1
b | 2
c | 1
a | 2
b | 1
c | 2
-- PostgreSQL 11
k | v
-----
a | 1
b | 2
c |
JSON
Redan från version 9.3 introducerade PostgreSQL fullständiga funktioner för att arbeta med json-typ. Därför, om definieringen av inparametrarna sker i webbläsaren, kan du direkt där och då skapa json-objektet för SQL-frågan:
SELECT
  key k
, value v
FROM
  json_each($1::json); -- '{"a":1,"b":2,"c":3,"d":4}'
För tidigare versioner kan samma metod användas för each(hstore), men en korrekt »svängning» med inneslutning av komplexa objekt i hstore kan orsaka problem.
json_populate_recordset
Om du i förväg vet att data från »ingångs» json-arrayen ska fylla en viss tabell, kan du kraftigt spara på »avdereferering» av fält och konvertering till nödvändiga typer, genom att använda funktionen json_populate_recordset:
SELECT
  *
FROM
  json_populate_recordset(
    NULL::pg_class
  , $1::json -- $1 : '[{"relname":"pg_class","oid":1262},{"relname":"pg_namespace","oid":2615}]'
  );
json_to_recordset
Och denna funktion kommer helt enkelt att »utveckla» den överförda arrayen av objekt till urvalet, utan att förlita sig på tabellformatet:
SELECT
  *
FROM
  json_to_recordset($1::json) T(k text, v integer);
-- $1 : '[{"k":"a","v":1},{"k":"b","v":2}]'
k | v
-----
a | 1
b | 2
TEMPORARY TABLE
Men om datavolymen i den överförda uppsättningen är mycket stor, är det svårt, och ibland omöjligt, att skicka det som en enda serialiserad parameter, vilket kräver en engångs tilldelning av stora mängder minneTill exempel, om du behöver samla in en stor mängd data om händelser från ett externt system under en längre tid och sedan vill behandla den en gång på databassidan.
I det här fallet är den bästa lösningen att använda :
CREATE TEMPORARY TABLE tbl(k text, v integer);
...
INSERT INTO tbl(k, v) VALUES($1, $2); -- upprepa många gånger
...
-- här gör vi något användbart med hela den här tabellen
Denna metod är särskilt bra för sällan överföring av stora volymer av data.
Från perspektivet av att beskriva strukturen av dina data, skiljer sig en temporär tabell från en "vanlig" enbart genom ett enda kännetecken i systemtabellen pg_class, och i pg_type, pg_depend, pg_attribute, pg_attrdef, … — i själva verket inte alls.
Därför, i webbsystem med ett stort antal kortlivade anslutningar, kommer en sådan tabell att generera nya systeminlägg varje gång, vilka tas bort vid stängning av anslutningen till databasen. Som ett resultat, okontrollerad användning av TEMP TABLE leder till "uppsvällning" av tabeller i pg_catalog och sänker prestandan av många operationer som använder dem.
Självklart kan detta hanteras med hjälp av periodisk VACUUM FULL genom systemkatalogtabeller.
Sessionvariabler
Anta att databehandlingen från det föregående fallet är tillräckligt komplicerad för att rymmas inom en enda SQL-fråga, men att vi vill göra det ganska ofta. Det vill säga vi vill använda procedurbehandling i , men att använda datatransfer via temporära tabeller skulle bli för kostsamt.
Vi kan inte heller använda $n-parametrar för att överföra till det anonyma blocket. Lösningen ligger i sessionvariabler och funktionen current_setting.
Före version 9.2 var det nödvändigt att först konfiguera custom_variable_classes för "egna" sessionvariabler. I aktuella versioner kan man skriva ungefär så här:
SET my.val = '{1,2,3}';
DO $$
DECLARE
  id integer;
BEGIN
  FOR id IN (SELECT unnest(current_setting('my.val')::integer[])) LOOP
    RAISE NOTICE 'id : %', id;
  END LOOP;
END;
$$ LANGUAGE plpgsql;
-- NOTICE:  id : 1
-- NOTICE:  id : 2
-- NOTICE:  id : 3
I andra stödda procedurprogramspråk kan man hitta andra lösningar.
Känner du till några andra sätt? Dela med dig i kommentarerna!
Källa: habr.com
