

Tusentals chefer från försäljningskontor över hela landet registrerar i dagligen tiotusentals kontakter — kommunikationer med potentiella eller redan befintliga kunder. För att nå denna kund måste man först hitta den, och gärna väldigt snabbt. Och detta sker oftast genom namnet.
Därför är det inte förvånande att när jag på nytt analyserade "tunga" förfrågningar i en av de mest belastade databaserna — vårt eget , så upptäckte jag "i toppen" en förfrågan för "snabb" sökning efter namn för organisationskort.
Vidare undersökning avslöjade ett intressant exempel av först optimering och sedan nedgradering av prestandan förfrågan vid successiv utveckling av flera team, där var och en agerade utifrån de bästa intentionerna.
0: vad ville användaren
 [KDPV ]
Vad menar användaren vanligtvis när han pratar om "snabb" sökning efter namn? Det visar sig nästan aldrig vara "ärlig" sökning efter en del av en sträng såsom ... LIKE '%ros%' — för då får man inte bara 'Rosalia' och 'Butik Ros'och även 'Gros' och även 'Farbror Moros'.
Användaren menar på ett vardagligt plan att ni ska ge honom sökning efter början av ordet i namnet och visa mer relevanta resultat som börjar med det inmatade. Och göra detta praktiskt taget omedelbart — vid delvis inmatning.
1: avgränsa uppgiften
Och framför allt kommer ingen människa att särskilt skriva 'ros butik', för att ni ska behöva söka prefixbaserat på varje ord. Nej, det är mycket enklare för användaren att reagera på en snabb förslag för det sista ordet än att medvetet "inte slutföra" de föregående — se hur detta fungerar i vilket sökmotor som helst.
Överhuvudtaget, correctly att formulera kraven för uppgiften är mer än hälften av lösningen. Ibland kan noggrant analys av användningsfall .
Vad gör då en abstrakt utvecklare?
1.0: extern sökmotor
Oj, sökning är svårt, jag känner inte för att syssla med det alls — låt oss ge detta till devops! Låt dem installera en extern söksystem relativt databasen: Sphinx, ElasticSearch,…
Ett arbetskrävande, om än arbetsintensivt, alternativ för synkronisering och snabba ändringar. Men inte i vårt fall, eftersom sökningen görs för varje kund endast inom ramen för deras konto. Data har en ganska hög förändringshastighet – och om en manager just har lagt till ett kort 'Butik Rosa', kan han efter 5-10 sekunder redan komma ihåg att han glömde ange där e-postadressen och vilja hitta och rätta till det.
Så låt oss söka "direkt i databasen". Lyckligtvis tillåter PostgreSQL oss att göra detta, och inte på bara ett sätt — vi kommer att se på dem.
1.1: "ärlig" delsträng
Vi fäster oss vid ordet "delsträng". För exakt indexsökning av delsträngar (och till och med med reguljära uttryck!) finns det ett utmärkt ! Men först måste vi sortera rätt.
Låt oss pröva att använda en sådan tabell för enkelhetens skull:
CREATE TABLE firms(
  id
    serial
      PRIMARY KEY
, name
    text
);
Vi laddar upp 7,8 miljoner poster av verkliga organisationer och indexerar:
CREATE EXTENSION pg_trgm;
CREATE INDEX ON firms USING gin(lower(name) gin_trgm_ops);
Låt oss söka efter de första 10 posterna för delsträngssökning:
SELECT
  *
FROM
  firms
WHERE
  lower(name) ~ ('(^|s)' || 'rosa')
ORDER BY
  lower(name) ~ ('^' || 'rosa') DESC -- börjar med "
, lower(name) -- resten alfabetiskt
LIMIT 10;
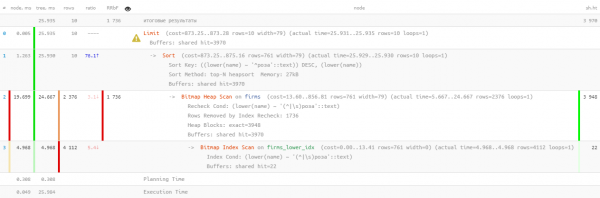
Nåväl, sådär.. 26ms, 31MB mängd lästa data och mer än 1,7K filtrerade poster — för 10 sökta. Överhettningar är alldeles för stora, finns det något mer effektivt sätt?
1.2: söka i text? Det är ju FTS!
Verkligen, PostgreSQL erbjuder en mycket kraftfull (Full Text Search), inklusive möjligheter för prefixsökning. Ett utmärkt alternativ, även utan att installera tillägg! Låt oss pröva:
CREATE INDEX ON firms USING gin(to_tsvector('simple'::regconfig, lower(name)));SELECT
*
FROM
firms
WHERE
to_tsvector('simple'::regconfig, lower(name)) @@ to_tsquery('simple', 'rosa:*')
ORDER BY
lower(name) ~ ('^' || 'rosa') DESC
, lower(name)
LIMIT 10; 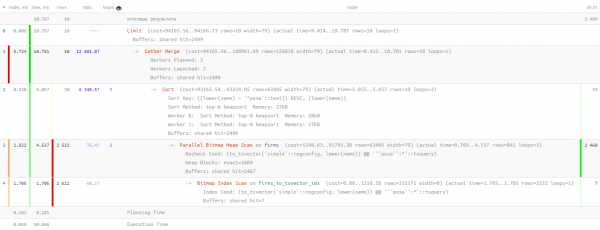
Här fick vi lite hjälp av parallellisering av frågeexekvering som halverade tiden till 11ms. Och vi behövde läsa 1,5 gånger mindre — bara 20MB. Här gäller det att ju mindre desto bättre, eftersom ju större volym vi läser, desto större blir chansen för cache miss, och varje överflödig läsning från disk är potentiella "trögheter" för förfrågan.
1.3: hur är det med LIKE?
Den föregående frågan är bra, men om vi kör den hundra tusen gånger på en dag, så samlas det upp 2TB data som har lästs. I bästa fall från minnet, men om vi har otur, även från disken. Så låt oss försöka göra det mindre.
Låt oss komma ihåg att användaren vill se först "som börjar med ...". Det är ju rent av med hjälp av text_pattern_ops! Och bara om vi "inte har tillräckligt" med 10 sökresultat, då måste vi läsa dem med hjälp av FTS-sökning:
CREATE INDEX ON firms(lower(name) text_pattern_ops);SELECT
*
FROM
firms
WHERE
lower(name) LIKE ('rosa' || '%')
LIMIT 10; 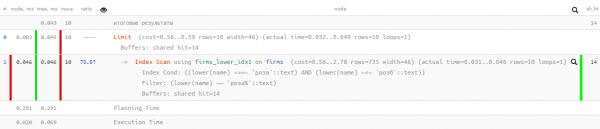
Utmärkta resultat — totalt 0.05 ms och strax över 100 KB lästa! Men vi glömde ju sorteringen efter namn, för att användaren inte ska gå vilse i resultaten:
SELECT
  *
FROM
  firms
WHERE
  lower(name) LIKE ('rosa' || '%')
ORDER BY
  lower(name)
LIMIT 10; 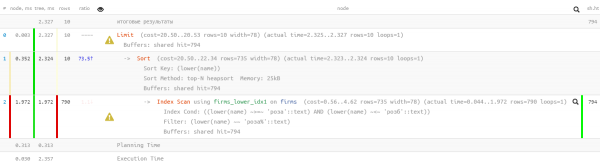
Oj, något ser redan inte så vackert ut — det verkar som att indexet finns, men sorteringen går förbi det… Visst är det betydligt effektivare än den tidigare versionen, men…
1.4: "finputsa med en fil"
Men det finns ett index som tillåter både sökning inom ett intervall och att sorteringen fungerar normalt — vanlig btree!
CREATE INDEX ON firms(lower(name));Men frågan för det måste "byggas manuellt":
SELECT
  *
FROM
  firms
WHERE
  lower(name) >= 'rosa' AND
  lower(name) <= ('rosa' || chr(65535)) -- för UTF8, för ensuratiga - chr(255)
ORDER BY
   lower(name)
LIMIT 10; 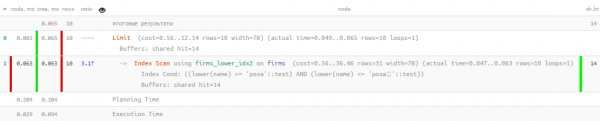
Utmärkt — både sorteringen fungerar, och resursanvändningen förblir "mikroskopisk", tusentals gånger effektivare än "ren" FTS! Kvar är att samla allt till en enda fråga:
(
  SELECT
    *
  FROM
    firms
  WHERE
    lower(name) >= 'rosa' AND
    lower(name) <= ('rosa' || chr(65535)) -- för UTF8, för ensuratiga kodningar - chr(255)
  ORDER BY
     lower(name)
  LIMIT 10
)
UNION ALL
(
  SELECT
    *
  FROM
    firms
  WHERE
    to_tsvector('simple'::regconfig, lower(name)) @@ to_tsquery('simple', 'rosa:*') AND
    lower(name) NOT LIKE ('rosa' || '%') -- "som börjar med" har vi redan funnit ovan
  ORDER BY
    lower(name) ~ ('^' || 'rosa') DESC -- vi använder samma sortering för att INTE gå via btree-indexet
  , lower(name)
  LIMIT 10
)
LIMIT 10;
Jag noterar att den andra underfrågan utförs bara om den första returnerade mindre än förväntat sista LIMIT antalet rader. Om denna typ av optimering för frågor har jag .
Så ja, vi har nu både btree och gin på tabellen, men statistiskt har det blivit så att mindre än 10% av förfrågningarna går till den andra blocket. Det innebär att med dessa kända typiska begränsningar för uppgiften har vi lyckats minska den totala resursanvändningen på servern praktiskt taget tusen gånger!
1.5*: vi klara oss utan filen
Ovanför LIKE Vi stötte på problem med att använda fel sortering. Men den kan "ledas på rätt väg" med hjälp av USING-operatören:
Som standard antas
ASC. Dessutom kan man ange namnet på en specifik sorteringsoperator i satsenUSING. Sorteringsoperatören måste vara en del av "mindre än" eller "större än" i ett visst familj av B-trädoperatörer.ASCvanligtvis motsvararUSING <ochDESCvanligtvis motsvararUSING >.
I vårt fall är "mindre än" det ~<~:
SELECT
  *
FROM
  firms
WHERE
  lower(name) LIKE ('ros' || '%')
ORDER BY
  lower(name) USING ~<~
LIMIT 10; 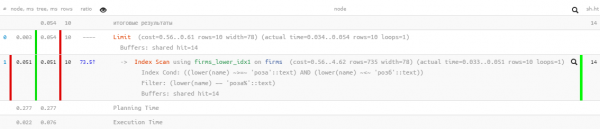
2: hur frågor "fermenterar"
Nu låter vi vår fråga "sätta sig" i ett halvt år till ett år, och med förvåning upptäcker vi den igen "i toppen" med siffror för det totala dagliga "minnespumpandet" (buffers shared hit) i 5.5TB — det vill säga ännu mer än vad som ursprungligen fanns.
Nej, naturligtvis, och vår verksamhet har vuxit och belastningen har ökat, men inte så mycket! Det betyder att det är något som inte stämmer — låt oss reda ut det.
2.1: födelse av paging
Vid en viss tidpunkt ville ett annat utvecklingsteam möjliggöra att från snabb undermeny-sökning "hoppa" till registret med samma, men utvidgade resultat. Och vilket register har ingen sidnavigation? Låt oss koppla på det!
( ... LIMIT  + 10)
UNION ALL
( ... LIMIT  + 10)
LIMIT 10 OFFSET ;
Nu kunde man utan ansträngning för utvecklaren visa resultatregistret med "typ-sidvis" inläsning.
Självklart, i verkligheten, för varje nästa datorsida läses allt mer och mer (allt från föregående gång, som vi slänger bort, plus den behövda "svansen") — det vill säga detta är ett tydligt antipattern. Det skulle vara bättre att starta sökningen på nästa iteration från den som kom ihåg i gränssnittet, men om det — en annan gång.
2.2: vill ha exotiska inslag
Vid ett visst tillfälle ville utvecklaren variera det resulterande urvalet med data från en annan tabell, för vilket hela den föregående frågan skickades till CTE:
WITH q AS (
  ...
  LIMIT  + 10
)
SELECT
  *
, (SELECT ...) sub_query -- någon fråga till den relaterade tabellen
FROM
  q
LIMIT 10 OFFSET ;
Och även så — inte dåligt, eftersom den inbäddade frågan beräknas endast för 10 returnerade poster, om det inte vore för...
2.3: DISTINCT meningslös och skoningslös
Någonstans i processen av sådan evolution förlorades NOT LIKE villkor . Det är tydligt att efter dettabörjade återvända UNION ALL vissa poster två gånger tillbaka. — först de som hittades i början av strängen, och sedan igen — vid början av det första ordet i denna sträng. I gränsen kan alla poster i den andra underfrågan matcha posterna i den första.
Vad gör utvecklaren istället för att hitta orsaken?.. Ingen fråga!
- vi dubblerar storleken ursprungliga urval
- vi använde DISTINCT, så att endast unika förekomster av varje rad skulle återges
WITH q AS (
  ( ... LIMIT  + 10)
  UNION ALL
  ( ... LIMIT  + 10)
  LIMIT  + 10
)
SELECT DISTINCT
  *
, (SELECT ...) sub_query
FROM
  q
LIMIT 10 OFFSET ;
Det är tydligt att resultatet i slutändan är detsamma, men risken att "misslyckas" i den andra underfrågan CTE har ökat betydligt, och utan detta, det läses uppenbarligen mer.
Men det är inte det största problemet. Eftersom utvecklaren bad om att välja DISTINCT inte efter specifika, utan genast efter alla fält poster, så kom fältet sub_query — resultatet av underfrågan automatiskt med. DISTINCTNu tvingades databasen att utföra inte 10 underfrågor, utan alla + 10!
2.4: samarbete är allt!
Så här levde utvecklarna — utan bekymmer, eftersom det uppenbarligen inte fanns tillräckligt med tålamod i registret för att "justera" till betydande värden N vid det kroniska fördröjningen av att få varje nästa "sida" för användaren.
Tills utvecklarna från en annan avdelning kom till dem och ville använda en så praktisk metod för iterativ sökning — det vill säga, vi tar en bit av ett urval, filtrerar efter ytterligare villkor, ritar resultatet, sedan nästa bit (vilket i vårt fall uppnås genom att öka N), och så fortsätter vi tills skärmen är full.
Sammanfattningsvis, i det fångade exemplet N nådde värden på nästan 17K, och totalt genomfördes minst 4K sådana förfrågningar "i kedja" under en dag. De senaste av dem skannades redan med 1GB minne vid varje iteration…
Sammanfattningsvis
Källa: habr.com
