

Vi fortsätter serien av artiklar som rör utforskning av mindre kända sätt att förbättra prestandan för "till synes enkla" förfrågningar i PostgreSQL:
Tro inte att jag avskyr JOIN så mycket... 🙂
Men ofta blir en förfrågan betydligt mer effektiv utan det. Därför ska vi idag försöka bli av med den resurskrävande JOIN — med hjälp av en ordbok.
Från och med PostgreSQL 12 kan vissa av de nedan beskrivna situationerna upprepas lite annorlunda på grund av . Detta beteende kan återställas till det tidigare genom att ange nyckeln
MATERIALIZED.
Många "fakta" om det begränsade lexikonet
Låt oss ta en helt verklig applikationsuppgift — vi behöver visa en lista över eller aktiva uppgifter med avsändare:
25.01 | Ivanov I.I. | Förbereda beskrivning av den nya algoritmen.
22.01 | Ivanov I.I. | Skriva en artikel på Habr: livet utan JOIN.
20.01 | Petrov P.P. | Hjälpa till att optimera förfrågan.
18.01 | Ivanov I.I. | Skriva en artikel på Habr: JOIN med hänsyn till datadistribution.
16.01 | Petrov P.P. | Hjälpa till att optimera förfrågan.
I en abstrakt värld skulle uppgiftsförfattarna spridas jämnt bland alla anställda i vår organisation, men i verkligheten kommer uppgifter oftast från ett ganska begränsat antal personer — "från ledningen" uppåt i hierarkin eller "från kollegor" från närliggande avdelningar (analytiker, designers, marknadsföring, …).
Låt oss anta att det i vår organisation finns 1000 personer och endast 20 författare (oftast ännu färre) ställer uppgifter till varje specifik utförare och , för att snabba upp den "traditionella" förfrågan.
Skapande av skript
-- anställda
CREATE TABLE person AS
SELECT
  id
, repeat(chr(ascii('a') + (id % 26)), (id % 32) + 1) "name"
, '2000-01-01'::date - (random() * 1e4)::integer birth_date
FROM
  generate_series(1, 1000) id;

ALTER TABLE person ADD PRIMARY KEY(id);

-- uppgifter med angiven distribution
CREATE TABLE task AS
WITH aid AS (
  SELECT
    id
  , array_agg((random() * 999)::integer + 1) aids
  FROM
    generate_series(1, 1000) id
  , generate_series(1, 20)
  GROUP BY
    1
)
SELECT
  *
FROM
  (
    SELECT
      id
    , '2020-01-01'::date - (random() * 1e3)::integer task_date
    , (random() * 999)::integer + 1 owner_id
    FROM
      generate_series(1, 100000) id
  ) T
, LATERAL(
    SELECT
      aids[(random() * (array_length(aids, 1) - 1))::integer + 1] author_id
    FROM
      aid
    WHERE
      id = T.owner_id
    LIMIT 1
  ) a;

ALTER TABLE task ADD PRIMARY KEY(id);
CREATE INDEX ON task(owner_id, task_date);
CREATE INDEX ON task(author_id);
Vi visar de senaste 100 uppgifterna för en viss påverkad person:
SELECT
  task.*
, person.name
FROM
  task
LEFT JOIN
  person
    ON person.id = task.author_id
WHERE
  owner_id = 777
ORDER BY
  task_date DESC
LIMIT 100; 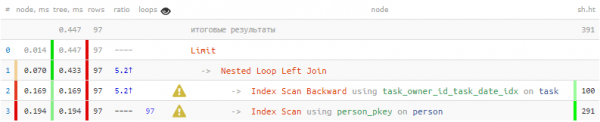
Det visar sig att 1/3 av den totala tiden och 3/4 av läsningarna datablad har gjorts enbart för att 100 gånger söka efter författaren — för varje utgiven uppgift. Men vi vet ju att det finns 20 olika det går att använda denna kunskap? hstore-ordbok
hstore typ
Låt oss använda CREATE EXTENSION hstore
I ordboken räcker det att inkludera författarens ID och namn, för att senare kunna hämta det med detta nyckel:-- skapar en målvärdesuppsättning WITH T AS ( SELECT * FROM task WHERE owner_id = 777 ORDER BY task_date DESC LIMIT 100 ) -- skapar en ordbok för unika värden , dict AS ( SELECT hstore( -- hstore(keys::text[], values::text[]) array_agg(id)::text[] , array_agg(name)::text[] ) FROM person WHERE id = ANY(ARRAY( SELECT DISTINCT author_id FROM T )) ) -- får relaterade värden från ordboken SELECT * , (TABLE dict) -> author_id::text -- hstore -> nyckel FROM T;
Information om personerna tog 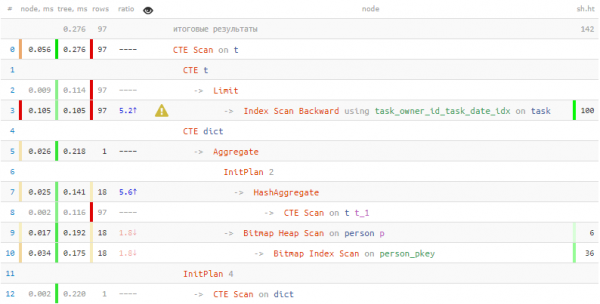
hälften så lång tid och 7 gånger mindre data lästes ! Förutom "ordboksgörande" har dessa resultat också uppnåtts genommassavhämtning av poster från tabellen med ett enda pass med hjälp av = ANY(ARRAY(...)) Tabellposter: serialisering och deserialisering.
Men vad gör vi om vi behöver spara mer än ett textfält i ordboken, utan hela posten? I detta fall kan PostgreSQL
arbeta med tabellposten som ett enda värde ... , dict AS ( SELECT hstore( array_agg(id)::text[] , array_agg(p)::text[] -- magi #1 ) FROM person p WHERE ... ) SELECT * , (((TABLE dict) -> author_id::text)::person).* -- magi #2 FROM T;:
Låt oss bryta ner vad som verkligen hände här:Vi tog
- p som en alias för hela posten i tabellen person och samlade dem i en array. и собрали из них массив.
- Denna datamängd har typats om till ett array av textsträngar (person[]::text[]), för att placera den i ett hstore-ordbok som ett värdearray.
- Vid hämtning av den relaterade posten hämtade vi den ur ordboken med hjälp av nyckeln som en textsträng.
- Texten måste vi konvertera till en tabelltyp person (för varje tabell skapas automatiskt en med samma namn typ).
- Vi "utvecklade" den typade posten till kolumner med hjälp av
(...).*.
json-ordbok
Men ett sådant trick som vi använde ovan fungerar inte, om det inte finns en motsvarande tabelltyp för att göra "typomvandlingen". Lika kommer det ske, om vi försöker använda CTE-strängen, snarare än en "real" tabell.
I detta fall hjälper oss :
...
, p AS ( -- detta är redan CTE
  SELECT
    *
  FROM
    person
  WHERE
    ...
)
, dict AS (
  SELECT
    json_object( -- nu är det redan json
      array_agg(id)::text[]
    , array_agg(row_to_json(p))::text[] -- och inuti json för varje rad
    )
  FROM
    p
)
SELECT
  *
FROM
  T
, LATERAL(
    SELECT
      *
    FROM
      json_to_record(
        ((TABLE dict) ->> author_id::text)::json -- hämtades från ordboken som json
      ) AS j(name text, birth_date date) -- fyllde i den struktur vi behövde
  ) j;
Det är värt att nämna att vid beskrivning av den målsatta strukturen kan vi lista inte alla fält i den ursprungliga strängen, utan endast de som vi verkligen behöver. Om vi har en "inhemsk" tabell, är det bättre att använda funktionen json_populate_record.
Åtkomsten till ordboken sker fortfarande på en gång, men kostnaderna för json-[de]serialisering är ganska höga, därför är det rimligt att använda detta sätt endast i vissa fall när en "ärlig" CTE Scan visar sig vara sämre.
Testar prestanda
Så, vi har fått två sätt att serialisera data till en ordbok — hstore / json_object. Utöver detta kan själva arrayer av nycklar och värden genereras på två sätt, med intern eller extern konvertering till text: array_agg(i::text) / array_agg(i)::text[].
Låt oss kontrollera effektiviteten av olika typer av serialisering på ett helt syntetiskt exempel — serialiserar olika antal nycklar:
WITH dict AS (
  SELECT
    hstore(
      array_agg(i::text)
    , array_agg(i::text)
    )
  FROM
    generate_series(1, ...) i
)
TABLE dict;
Utvärderingsskript: serialisering
MED T SOM (
  VÄLJ
    *
  , (
      VÄLJ
        regexp_replace(ea[array_length(ea, 1)], '^Execution Time: (d+.d+) ms$', '1')::real et
      FRÅN
        (
          VÄLJ
            array_agg(el) ea
          FRÅN
            dblink('port= ' || current_setting('port') || ' dbname=' || current_database(), $$
              explain analyze
              MED dict SOM (
                VÄLJ
                  hstore(
                    array_agg(i::text)
                  , array_agg(i::text)
                  )
                FRÅN
                  generate_series(1, $$ || (1 << v) || $$) i
              )
              TABELL dict
            $$) T(el text)
        ) T
    ) et
  FRÅN
    generate_series(0, 19) v
  ,   LATERAL generate_series(1, 7) i
  ORDER BY
    1, 2
)
VÄLJ
  v
, avg(et)::numeric(32,3)
FRÅN
  T
GRUPPERA EFTER
  1
ORDER BY
1; 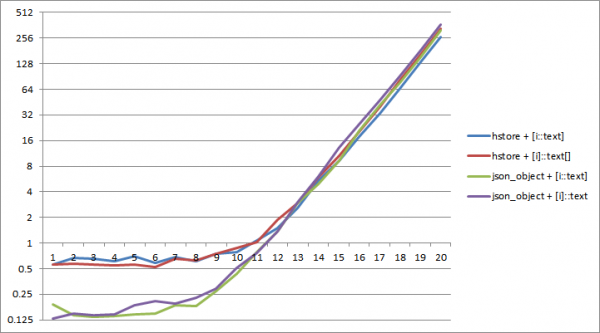
I PostgreSQL 11 ungefär upp till storleken av ordboken på 2^12 nycklar serialisering till json tar mindre tid. Den mest effektiva kombinationen är json_object och 'intern' typomvandling array_agg(i::text).
Nu ska vi försöka läsa värdet av varje nyckel 8 gånger — om vi inte interagerar med ordboken, vad är då dess syfte?
Utvärderingsskript: läsning från ordboken
MED T SOM (
  VÄLJ
    *
  , (
      VÄLJ
        regexp_replace(ea[array_length(ea, 1)], '^Execution Time: (d+.d+) ms$', '1')::real et
      FRÅN
        (
          VÄLJ
            array_agg(el) ea
          FRÅN
            dblink('port= ' || current_setting('port') || ' dbname=' || current_database(), $$
              explain analyze
              MED dict SOM (
                VÄLJ
                  json_object(
                    array_agg(i::text)
                  , array_agg(i::text)
                  )
                FRÅN
                  generate_series(1, $$ || (1 << v) || $$) i
              )
              VÄLJ
                (TABELL dict) -> (i % ($$ || (1 << v) || $$) + 1)::text
              FRÅN
                generate_series(1, $$ || (1 << (v + 3)) || $$) i
            $$) T(el text)
        ) T
    ) et
  FRÅN
    generate_series(0, 19) v
  , LATERAL generate_series(1, 7) i
  ORDER BY
    1, 2
)
VÄLJ
  v
, avg(et)::numeric(32,3)
FRÅN
  T
GRUPPERA EFTER
  1
ORDER BY
1; 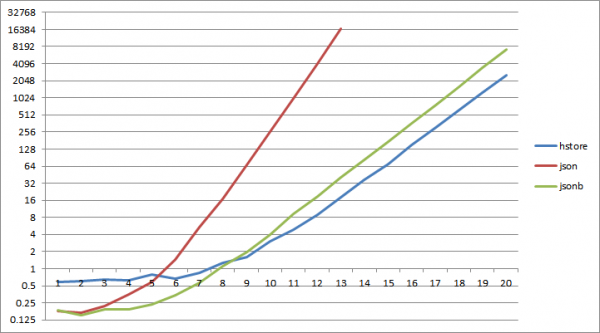
Och… ungefär vid 2^6 nycklar börjar läsning från json-ordboken att förlora kraftigt jämfört med hstore, för jsonb händer detsamma vid 2^9.
Slutliga slutsatser:
- om du behöver göra JOIN med upprepade poster — är det bättre att använda 'ordbok' för tabellen
- om din ordbok förväntas vara liten och du kommer att läsa lite från den — kan json[b] användas
- i alla andra fall hstore + array_agg(i::text) kommer att vara mer effektivt
Källa: habr.com
