

Var försiktig med operationer, buffers som ger...
Låt oss titta på ett litet exempel för att diskutera några universella metoder för att optimera frågor i PostgreSQL. Huruvida du vill använda dem eller inte är upp till dig, men det är viktigt att känna till dem.
I senare versioner av PG kan situationen med "intelligent" planeringsändringar se annorlunda ut, men för 9.4/9.6 ser den ungefär likadan ut som exemplen här.
Här är en helt verklig fråga:
SELECT
  TRUE
FROM
  "Dokument" d
INNER JOIN
  "DokumentUtvidgning" doc_ex
    USING("@Dokument")
INNER JOIN
  "TypDokument" t_doc ON
    t_doc."@TypDokument" = d."TypDokument"
WHERE
  (d."Person3" = 19091 or d."Anställd" = 19091) AND
  d."$Utkast" IS NULL AND
  d."Borttagen" IS NOT TRUE AND
  doc_ex."Tillstånd"[1] IS TRUE AND
  t_doc."TypDokument" = 'Arbetsplan'
LIMIT 1;
om tabell- och fältnamnMan kan ha olika åsikter om "ryska" namn på fält och tabeller, men det är en smakfråga. Eftersom inte har utländska utvecklare, och PostgreSQL tillåter oss att använda namn som kan vara hieroglyfer, om de är omgivna av citattecken, så föredrar vi att namnge objekt tydligt för att undvika missförstånd.
Låt oss titta på den resulterande planen:
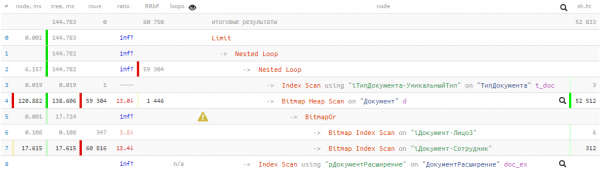
144ms och nästan 53K buffers — det vill säga mer än 400MB data! Och vi har tur om allt detta hamnar i cachen vid vår fråga, annars blir den betydligt långsammare när vi läser från disken.
Algoritmen är viktigast av allt!
För att på något sätt optimera en fråga måste vi först förstå vad den överhuvudtaget ska göra.
Vi lämnar utvecklingen av databasstrukturen utanför denna artikel för nu, och vi enas om att vi kan relativt "billigt" skriva om frågan och/eller applicera relevanta index på databasen.
Så, frågan:
— kontrollerar existensen av åtminstone ett dokument
— i det önskade tillståndet och av den specifika typen
— där författaren eller utföraren är den anställda vi behöver
JOIN + LIMIT 1
Det är ganska ofta lättare för utvecklaren att skriva en fråga där en stor mängd tabeller först kopplas ihop, och sedan får man bara kvar en enstaka post. Men det som är enklare för utvecklaren betyder inte nödvändigtvis att det är mer effektivt för databasen.
I vårt fall var det bara 3 tabeller — och vilket resultat…
Låt oss börja med att ta bort anslutningen till tabellen "TypDokument", och dessutom låta databasen veta att posttypen är unik (det vet vi, men planen har inte kommit på det än):
WITH T AS (
  SELECT
    "@TypDokument"
  FROM
    "TypDokument"
  WHERE
    "TypDokument" = 'Arbetsplan'
  LIMIT 1
)
...
WHERE
  d."TypDokument" = (TABLE T)
...
Ja, om tabellen/CTE består av ett enda fält med en enda post, kan vi i PG skriva även så här, istället för
d."TypDokument" = (SELECT "@TypDokument" FROM T LIMIT 1)«Lata» beräkningar i frågor i PostgreSQL
BitmapOr vs UNION
I vissa fall kan Bitmap Heap Scan bli mycket kostsamt för oss — till exempel i vår situation där ett betydande antal poster faller under det angivna villkoret. Vi fick det på grund av OR-villkoret som har blivit en BitmapOr-operation i planen.
Låt oss återgå till den ursprungliga uppgiften — vi måste hitta en post som uppfyller vilket som helst av villkoren — det vill säga det är onödigt att söka igenom alla 59K poster för båda villkoren. Det finns ett sätt att hantera ett villkor, och gå vidare till det andra endast om inget hittas på det första. Vi kommer att använda följande konstruktion:
(
  SELECT
    ...
  LIMIT 1
)
UNION ALL
(
  SELECT
    ...
  LIMIT 1
)
LIMIT 1
Den "yttre" LIMIT 1 garanterar att sökningen avslutas så snart den första posten hittas. Och om den finns i den första blocket, kommer den andra delen inte att köras (never executed i planen).
"Döljer under CASE" komplexa villkor
I den ursprungliga frågan finns det en extremt obekväm punkt — kontrollen av tillståndet via den relaterade tabellen "DokumentUtvidgning". Oavsett sanning av övriga villkor i uttrycket (till exempel, d."Borttagen" IS NOT TRUE), utförs denna koppling alltid och "kostar resurser". Mer eller mindre resurser kommer att användas — beroende på storleken av denna tabell.
Men vi kan modifiera frågan så att sökningen av den relaterade posten bara sker när det verkligen är nödvändigt:
SELECT
  ...
FROM
  "Dokument" d
WHERE
  ...
/*index cond*/ AND
  CASE
    WHEN "$Utkast" IS NULL AND "Borttagen" IS NOT TRUE THEN (
      SELECT
        "Tillstånd"[1] IS TRUE
      FROM
        "DokumentUtvidgning"
      WHERE
        "@Dokument" = d."@Dokument"
    )
  END
Eftersom vi inte behöver något av fälten från den relaterade tabellen , har vi möjlighet att omvandla JOIN till ett villkor i en underfråga.Vi lämnar de indexerbara fälten "utanför" CASE, och de enklare villkoren placeras i WHEN-blocket — och nu utförs den "tunga" frågan endast vid ett övergång till THEN.
Mitt efternamn är "Totalt"
Vi samlar den resulterande frågan med alla de ovan beskrivna mekanismerna:
Vi samlar in den resulterande förfrågan med alla ovan beskrivna mekanismer:
MED T SOM (
  VÄLJ
    "@Dokumenttyp"
  FRÅN
    "Dokumenttyp"
  DÄR
    "Dokumenttyp" = 'Arbetsplan'
)
  (
    VÄLJ
      SANT
    FRÅN
      "Dokument" d
    DÄR
      ("Person3", "Dokumenttyp") = (19091, (TABELL T)) OCH
      FALL
        NÄR "$Utkast" ÄR NULL OCH "Borttagen" ÄR INTE SANT DÅ (
          VÄLJ
            "Status"[1] ÄR SANT
          FRÅN
            "Dokumentutvidgning"
          DÄR
            "@Dokument" = d."@Dokument"
        )
      SLUT
    BEGRÄNSA 1
  )
UNION ALL
  (
    VÄLJ
      SANT
    FRÅN
      "Dokument" d
    DÄR
      ("Dokumenttyp", "Anställd") = ((TABELL T), 19091) OCH
      FALL
        NÄR "$Utkast" ÄR NULL OCH "Borttagen" ÄR INTE SANT DÅ (
          VÄLJ
            "Status"[1] ÄR SANT
          FRÅN
            "Dokumentutvidgning"
          DÄR
            "@Dokument" = d."@Dokument"
        )
      SLUT
    BEGRÄNSA 1
  )
BEGRÄNSA 1;
Justera [för] index
Ett tränat öga har märkt att de indexerade villkoren i UNION-delarna skiljer sig något — detta beror på att vi redan har lämpliga index på tabellen. Om de inte fanns — skulle det vara bra att skapa dem: Dokument(Person3, Dokumenttyp) och Dokument(Dokumenttyp, Anställd).
om ordningen på fälten i ROW-villkorUr planerarens synvinkel kan man förstås också skriva (A, B) = (constA, constB), och (B, A) = (constB, constA). Men vid skrivningen i ordningen på fälten i indexet, är en sådan fråga bara enklare att felsöka senare.
Vad i planen?
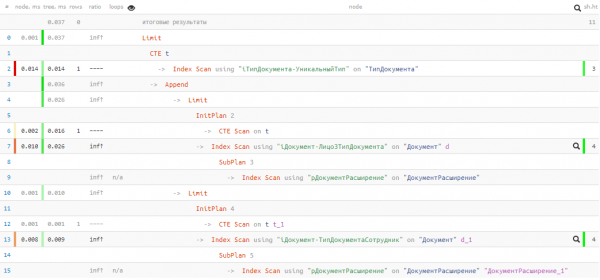
Tyvärr hade vi otur, och i den första UNION-delen hittades ingenting, så den andra blev faktiskt utförd. Men även i detta fall — totalt 0.037ms och 11 buffertar!
Vi snabbade upp frågan och minskade "pumpningen" av data i minnet tusentals gånger, genom att använda ganska enkla metoder — ett bra resultat för liten kopierings- och klistring.
Källa: habr.com
