

Jag föreslår att ni bekantar er med transkriptet av Vladimir Sitnikovs presentation från början av 2016, "PostgreSQL och JDBC: Utnyttja all potential"
God dag! Jag heter Vladimir Sitnikov. Jag har arbetat i 10 år på NetCracker. Jag fokuserar främst på prestanda. Allt som har att göra med Java och SQL är det jag brinner för.
Idag kommer jag att berätta om de utmaningar vi stött på när vi började använda PostgreSQL som databasserver. Vi arbetar främst med Java, men det jag kommer att tala om idag gäller inte bara Java. Som erfarenhet visat sig, uppstår detta även i andra språk.
Vi kommer att tala om:
- dataval.
- databevarande.
- och även prestanda.
- Och om de fallgropar som finns där.
Låt oss börja med en simpel fråga. Vi hämtar en rad från tabellen med hjälp av det primära nyckeln.
Datan finns på samma värd. Och allt detta tar 20 millisekunder.
De 20 millisekunderna är mycket. Om ni har 100 sådana förfrågningar, slösar ni tid i en sekund för att bearbeta dessa, det vill säga ni slösar tid.
Vi gillar inte att göra det och kollar vad databasen erbjuder för det. Den erbjuder oss två alternativ för att köra förfrågningar.
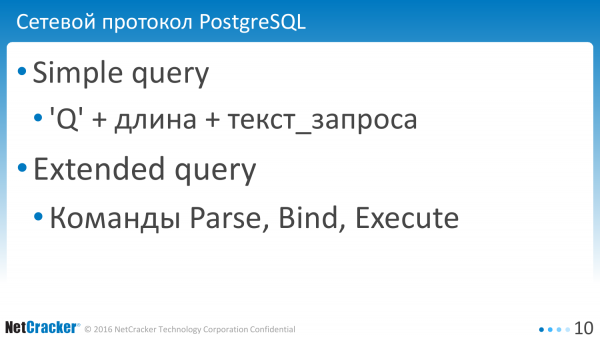
Det första alternativet är en enkel förfrågan. Vad är bra med den? Jo, vi tar bara den och skickar den, och inget mer.
Databasen har också en utökad förfrågan, som är mer komplicerad men också mer funktionell. Man kan skicka förfrågningar för parsing, exekvering, bindning av variabler etc. separat.
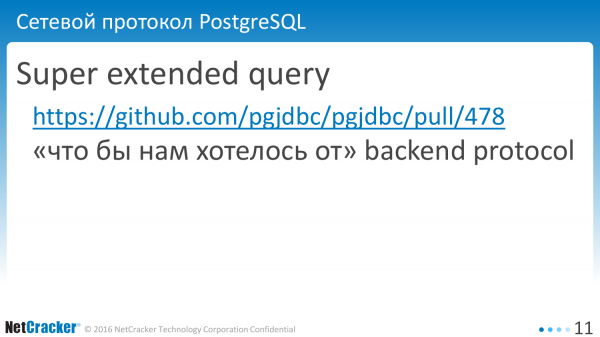
Superutökad förfrågan – detta är något vi inte kommer att täcka i den aktuella presentationen. Kanske har vi några önskemål från databasen, och det finns en lista av önskemål som är på något sätt formulerad, alltså det vi vill ha, men som för närvarande och under det närmaste året är omöjligt. Så vi har helt enkelt bara skrivit ner det och kommer att gå och be grundläggande personer att ta en titt.
Så vad vi kan göra är enkel förfrågan och utökad förfrågan.
Vad är kännetecknet för varje metod?
En enkel förfrågan är bra att använda för engångsupplägg. Man utför den och glömmer den. Problemet är att den inte stöder binärt dataformat, vilket innebär att den inte passar för vissa högpresterande system.
Utvidet spørring – lar deg spare tid på parsing. Dette er hva vi har gjort og begynt å bruke. Det har vært ekstremt til stor hjelp for oss. Det er ikke bare besparelse på parsing. Det er også besparelser på dataoverføring. Å overføre data i binært format er mye mer effektivt.
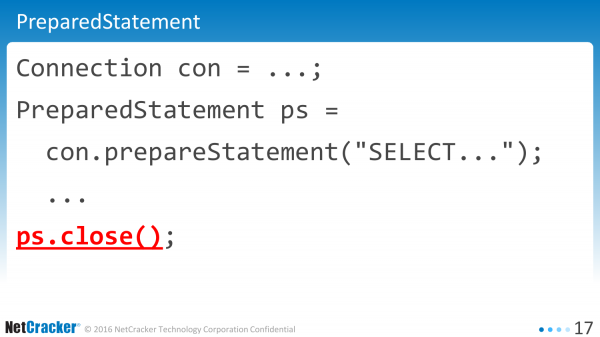
La oss gå over til praksis. Slik ser en typisk applikasjon ut. Dette kan være Java osv.
Vi opprettet en statement. Utførte kommandoen. Opprettet close. Hvor ligger feilen her? Hva er problemet? Det er ingen problemer. Sånn står det skrevet i alle bøker. Det må skrives slik. Hvis du vil ha maksimal ytelse, skriv sånn.
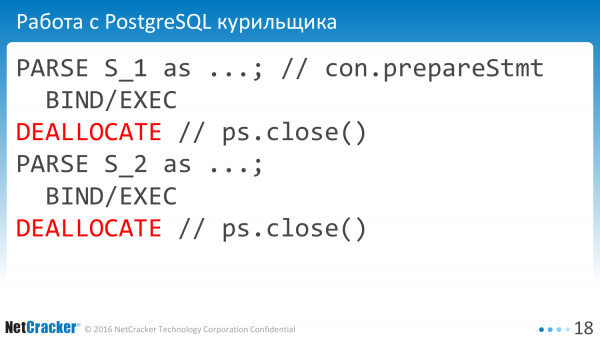
Men praksis har vist at dette ikke fungerer. Hvorfor? Fordi vi har metoden «close». Og når vi gjør det på denne måten, blir det, sett fra databasen, som en røyker som jobber med databasen. Vi sa «PARSE EXECUTE DEALLOCATE».
Hvorfor disse unødvendige opprettelsene og lasting av statements? De er ingen til hjelp. Men vanligvis skjer det sånn med PreparedStatement, når vi lukker dem, stenger de alt i databasen. Dette er ikke det vi vil.
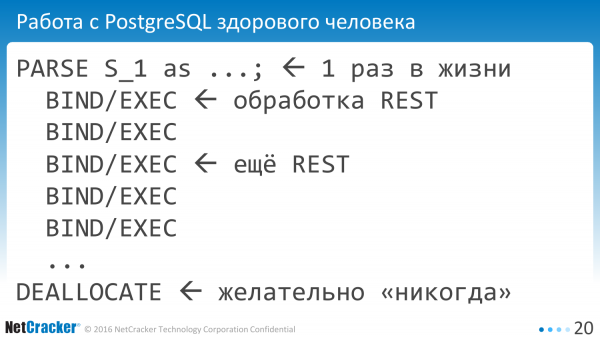
Vi vil, som friske mennesker, jobbe med databasen. Først forbereder vi statement vårt once, deretter utfører vi det mange ganger. Egentlig mange ganger betyr én gang i løpet av applikasjonens liv. Og ved ulike REST bruker vi den samme statement ID-en. Dette er vårt mål.
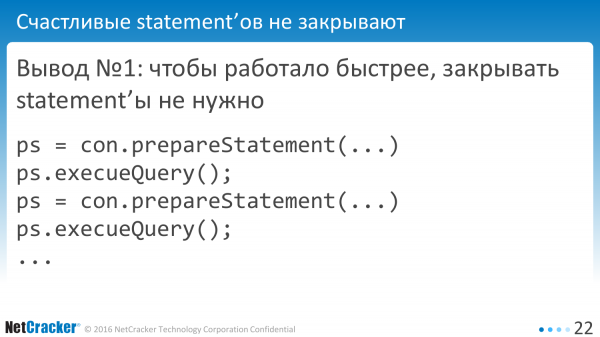
Hvordan kan vi oppnå dette?
Det er veldig enkelt – ikke lukk statements. Skriv slik: «prepare» «execute».
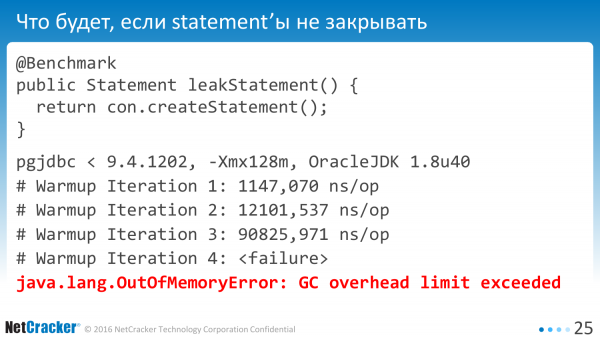
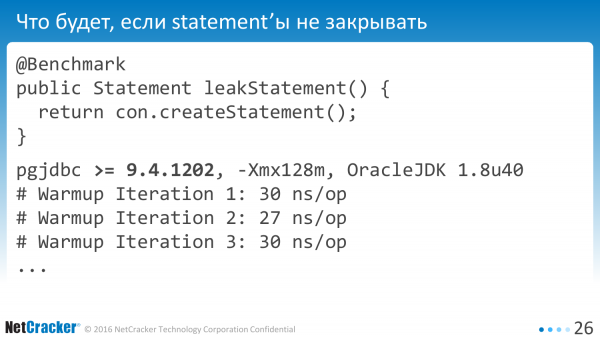
Hvis vi kjører noe sånt, vil det være klart at et eller annet vil gå over styr et sted. Hvis det ikke er klart, kan vi måle. La oss lage et benchmark hvor denne enkle metoden blir testet. Vi oppretter en statement. Kjører med en bestemt versjon av driveren og får vite at den faller ganske raskt med tap av all minnet som vi hadde.
Det er klart at slike feil lett kan rettes. Jeg skal ikke snakke om dem. Men jeg vil si at i den nye versjonen fungerer det mye raskere. Metoden er tåpelig, men likevel.
Hvordan jobbe riktig? Hva må vi gjøre for dette?
I virkeligheten lukker applikasjoner alltid statements. I alle bøker står det at de må lukkes, ellers vil minnet lekke.
Og PostgreSQL kan ikke cache forespørslene. Hver sesjon må opprette denne cachen for seg selv.
Og vi vil heller ikke bruke tid på parsing.
Og som vanlig har vi to alternativer.
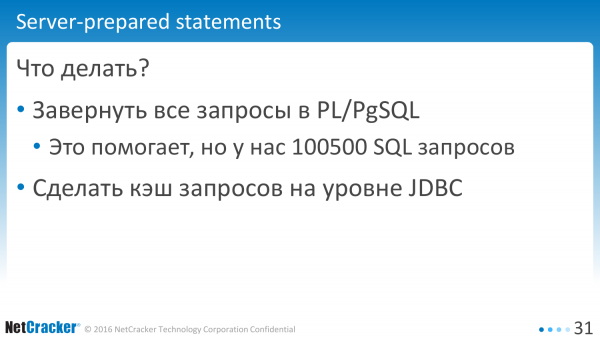
Det första alternativet är att vi säger att låt oss slå in allt i PgSQL. Där finns det cache. Den cachar allt. Det kommer att bli bra. Vi har sett på det. Vi har 100500 förfrågningar. Det fungerar inte. Vi är inte överens – vi vill inte omvandla förfrågningar till procedurer manuellt. Nej-nej.
Vi har ett andra alternativ – att själva bygga det. Vi öppnar källkoden, börjar bygga. Bygger och bygger. Det visade sig inte vara så svårt.
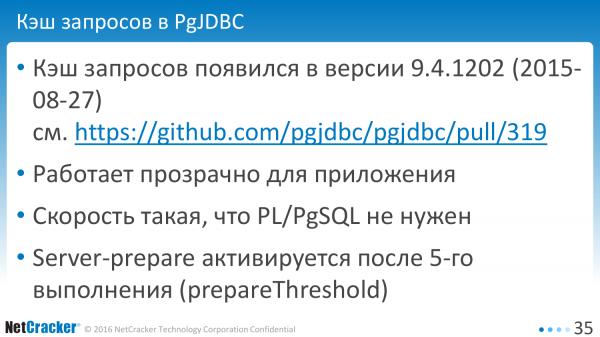
Detta dök upp i augusti 2015. Nu finns det en mer modern version. Och allt är bra. Det fungerar så bra att vi inte ändrar något i applikationen. Och vi har till och med slutat tänka i termer av PgSQL, det vill säga, detta var tillräckligt för att vi skulle kunna minska alla kostnader praktiskt taget till noll.
Därför aktiveras Server-prepared statements vid den femte körningen för att inte slösa minne i databasen på varje engångsförfrågan.
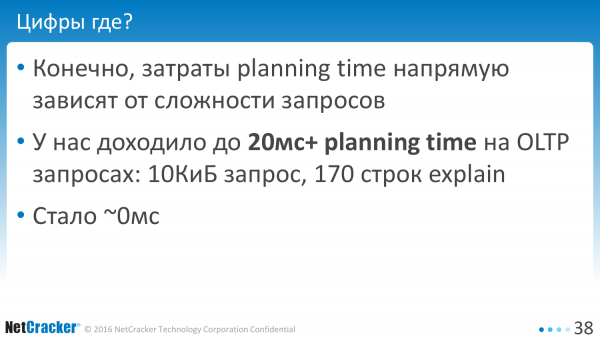
Man kan fråga – var är siffrorna? Vad får ni? Och här ger jag inga siffror, eftersom de varierar för varje förfrågan.
Vi hade förfrågningar där vi på OLTP-förfrågningar spenderade cirka 20 millisekunder på parsing. Det var 0,5 millisekunder för körning, 20 millisekunder för parsing. Förfrågan – 10 KiB text, 170 rader av planen. Det är en OLTP-förfrågan. Den frågar 1, 5, 10 rader, ibland fler.
Men vi ville absolut inte spendera 20 millisekunder. Vi fick det till 0. Allt är bra.
Vad kan ni ta med er härifrån? Om ni har Java, så tar ni den moderna versionen av drivrutinen och är glada.
Om ni har något annat språk, så överväg – kanske detta också är något ni behöver? För ur slutkundens synvinkel, till exempel, om ni har PL 8 eller LibPQ, så är det inte uppenbart att ni slösar tid inte på körning, utan på parsing, och detta är värt att kontrollera. Hur? Allt är gratis.
Med undantag för att det finns fel, vissa egenskaper. Och om dem ska vi just nu prata. Största delen kommer att handla om industriell arkeologi, om vad vi har funnit, vad vi har stött på.
Om förfrågan genereras dynamiskt. Sånt händer. Någon klipper ihop strängar, vilket ger en SQL-förfrågan.
Vad är då dåligt med det? Det är dåligt på så sätt att vi varje gång får en annan sträng.
Och denna olika rad behöver räkna hashCode igen. Det är verkligen en CPU-uppgift – att hitta en lång förfrågan i en redan befintlig hash är inte så enkelt. Så slutsatsen är enkel – generera inte förfrågningar. Lagra dem i en och samma variabel. Och var glad.
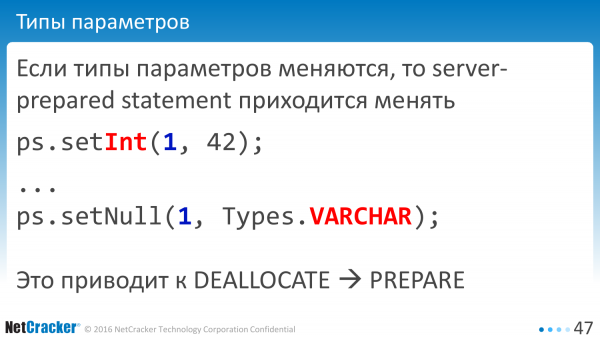
Nästa problem. Datatyper är viktiga. Det finns ORM:er som säger att det inte spelar någon roll vilken NULL det är, det kan vara vilken slags som helst. Om det är Int, så säger vi setInt. Och om det är NULL, låt det alltid vara VARCHAR. Vad spelar det egentligen för roll vilken NULL som är där? Databasen kommer att förstå allt själv. Och den bilden fungerar inte.
I praktiken bryr sig inte databasen det minsta. Om du första gången sa att det här är ett nummer, och andra gången sa att det är VARCHAR, då går det inte att återanvända Server-prepared statements. I så fall måste vi återskapa vår statement.
Om du kör samma förfrågan, se till att datatyperna i kolumnen inte blandas ihop. Det är viktigt att hålla koll på NULL. Det är ett vanligt fel som vi hade efter att vi började använda PreparedStatements.
Bra, vi slog på. Vi tog kanske en drivrutin. Och prestandan sjönk. Allt blev dåligt.
Hur kan det hända? Är det en bugg eller en funktion? Tyvärr lyckades vi inte förstå – är det en bugg eller en funktion? Men det finns ett ganska enkelt sätt att reproducera detta problem. Det överraskade oss helt. Det handlar om att hämta data från bokstavligen en tabell. Vi hade förstås fler sådana förfrågningar. De inkluderade vanligtvis två-tre tabeller, men det finns ett sådant reproduktionsscenario. Ta vilken version som helst av din databas och upprepa.
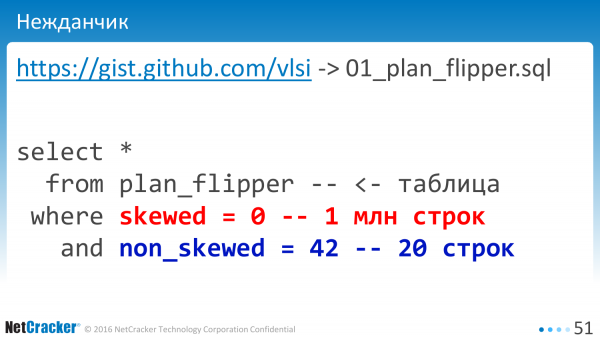
Poängen är att vi har två kolumner, varav varje är indexerad. I den ena kolumnen ligger en miljon rader med värdet NULL. I den andra kolumnen finns bara 20 rader. När vi kör utan kopplade variabler fungerar allt bra.
Om vi börjar köra med kopplade variabler, det vill säga att vi använder tecknet „?” eller „$1” för vår förfrågan, vad får vi då?
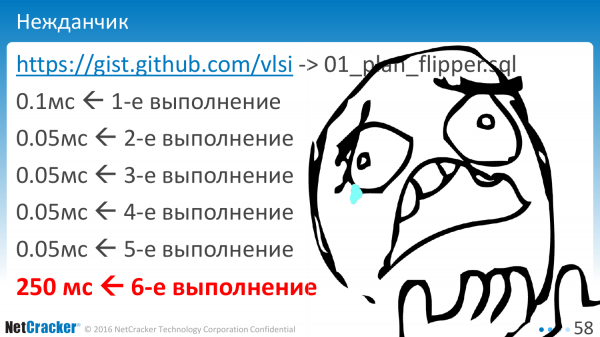
Första körningen – som vanligt. Andra – lite snabbare. Något har cachats. Tredje-fjärde-femte. Sedan plötsligt – och så här. Och det värsta är att det händer vid sjätte körningen. Vem visste att man behövde göra just sex körningar för att förstå vilken plan som verkligen gäller?
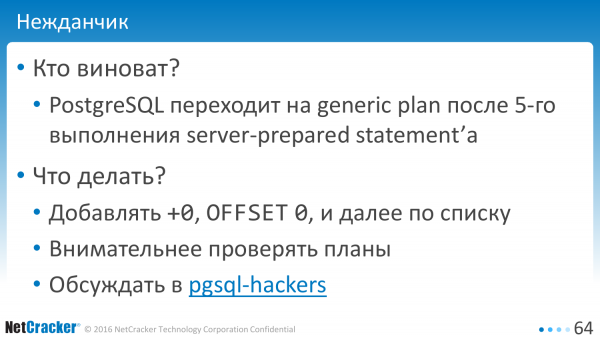
Vem bär ansvaret? Vad hände? Databasen innehåller optimering. Och den är slags optimerad för det generiska fallet. Och därför, från ett visst tillfälle, övergår den till den generiska planen som tyvärr kan vara en annan. Den kan vara densamma, men den kan också vara en annan. Och det finns ett tröskelvärde som leder till ett sådant beteende.
Vad kan vi göra åt detta? Här är det något mer komplicerat att spekulera. Det finns en enkel lösning som vi använder. Det är +0, OFFSET 0. Ni känner säkert till sådana lösningar. Vi lägger helt enkelt till «+0» i förfrågan och allt är bra. Jag visar det senare.
Och det finns också ett alternativ - att titta noggrannare på planerna. Utvecklaren måste inte bara skriva förfrågan utan också säga «explain analyze» sex gånger. Om det är fem gånger, så passar det inte.
Och det finns också det tredje alternativet - att skriva ett brev till pgsql-hackers. Jag har skrivit, men det är fortfarande oklart - är det en bugg eller en funktion?
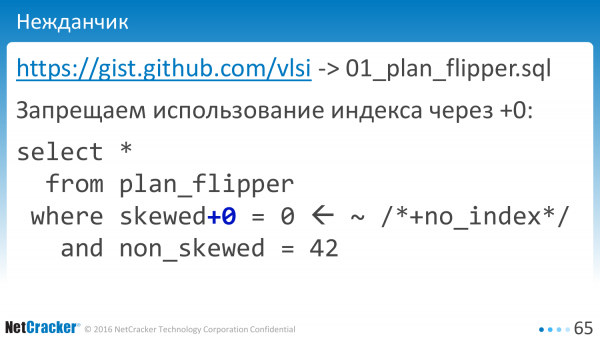
Medan vi tänker - är det en bugg eller en funktion, låt oss fixa det. Vi tar vår förfrågan och lägger till «+0». Allt är bra. Två tecken och man behöver inte ens tänka på hur det går till. Väldigt enkelt. Vi har helt enkelt förbjudit databasen från att använda indexet för den här kolumnen. Vi har inget index för kolumnen «+0» och allt, databasen använder inte indexet, allt är bra.
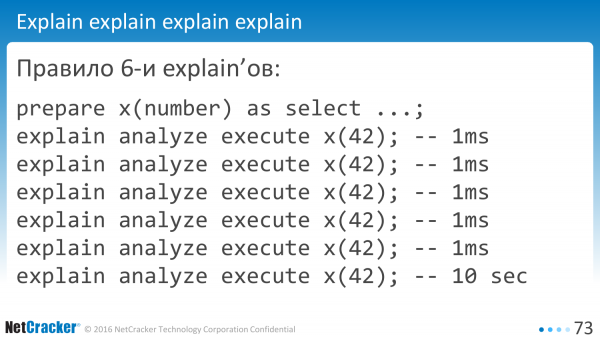
Det här är regeln för sex «explain». Just nu i de aktuella versionerna måste man göra det sex gånger om man har relaterade variabler. Om man inte har relaterade variabler gör vi så här. Och vi får i slutändan just den här förfrågan att falla. Det är inte komplicerat.
Det verkar som om hur mycket kan man? Här är en bugg, där är en bugg. Verkligen buggar överallt.
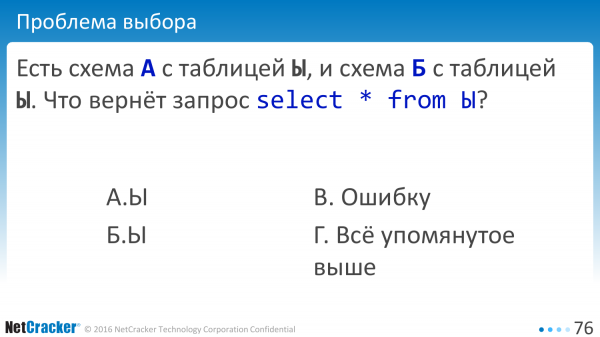
Låt oss titta på en gång till. Till exempel, vi har två scheman. Schema A med tabellen Ы och schema B med tabellen Ы. Förfrågan - att hämta data från tabellen. Vad kommer vi att få? Vi kommer att få ett fel. Vi kommer att ha allt ovanstående. Regeln är så här - bugg överallt, vi kommer att ha allt ovanstående.
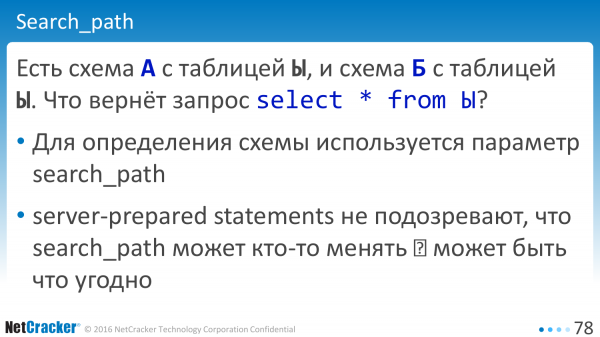
Nu frågan: «Varför?». Det verkar som om det finns dokumentation, att om vi har ett schema, så finns det variabeln «search_path» som säger var man ska leta efter tabellen. Det verkar som om variabeln finns.
Vad är problemet? Problemet är att serverberedda uttalanden inte misstänker att någon kan ändra «search_path». Det här värdet förblir som en konstant för databasen. Och vissa delar kanske inte fånga de nya värdena.
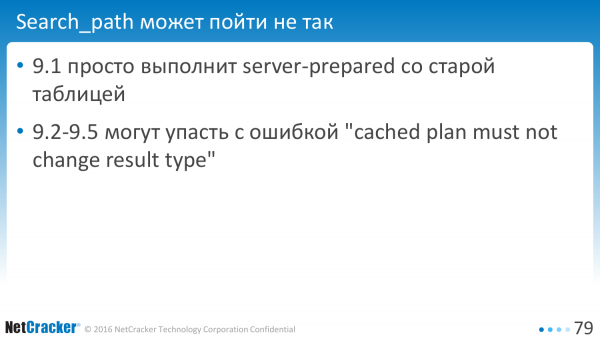
Självklart beror det på vilken version du testar. Det beror på hur mycket dina tabeller skiljer sig åt. Version 9.1 kommer helt enkelt att köra de gamla frågorna. Nyare versioner kan upptäcka misstaget och säga att du har ett fel.
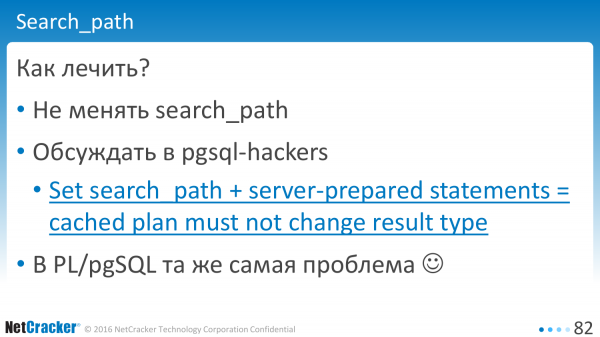
Hur åtgärdar man detta? Det finns ett enkelt recept – gör inte så. Ändra inte search_path i applikationens arbete. Om du ändrar det är det bättre att skapa en ny anslutning.
Vi kan diskutera det, det vill säga öppna upp, diskutera, fylla på. Kanske kan vi övertyga databasutvecklarna om att när någon förändrar ett värde, bör databasen informera klienten: 'Titta, det finns ett nytt värde här. Kanske behöver du återställa statements, återskapa dem?'. Just nu beter sig databasen på ett dolt sätt och meddelar ingenting om att statements har förändrats någonstans inuti.
Och jag ska återigen betona – detta är inte typiskt för Java. Vi kommer att se samma sak i PL/pgSQL direkt ett till ett. Men där kommer det att reproduceras.
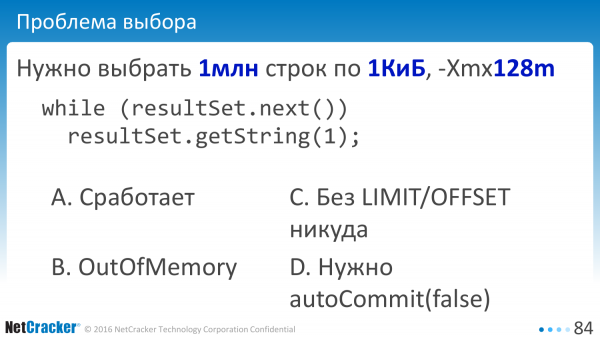
Låt oss försöka hämta data igen. Vi hämtar och hämtar. Vi har en tabell med en miljon rader. Varje rad är ett kilobyte. Ungefär en gigabyte data. Och vi har en arbetsminne i Java-maskinen på 128 megabyte.
Vi, som rekommenderas i alla böcker, använder strömmande behandling. Det vill säga, vi öppnar resultSet och läser data därifrån lite i taget. Kommer detta att fungera? Kommer det att krascha av minnesbrist? Kommer det att läsa lite i taget? Låt oss ha tro på databasen, på Postgres. Vi tror inte. Ska vi få OutOfMemory? Vem har fått OutOfMemory? Och vem lyckades fixa det? Någon lyckades reda ut det.
Om du har en miljon rader, kan du inte bara hämta dem. Du måste definitivt använda OFFSET/LIMIT. Vem är för det alternativet? Och vem tycker att man ska leka med autoCommit?
Här visar det sig som vanligt att det oväntade alternativet är det rätta. Och om du plötsligt stänger av autoCommit så hjälper det. Varför är det så? Vetenskapen vet inte.
Men som standard hämtar alla klienter som ansluter till databasen Postgres all data. PgJDBC är inget undantag, det hämtar alla rader.
Det finns en variation på temat FetchSize, det vill säga man kan på nivå med ett enskilt statement ange att här, snälla hämta data i omgångar om 10, 50. Men det fungerar inte förrän du stänger av autoCommit. Har du stängt av autoCommit – börjar det fungera.
Men att gå igenom koden och sätta setFetchSize överallt är obekvämt. Därför har vi gjort en inställning som anger standardvärdet för hela anslutningen.
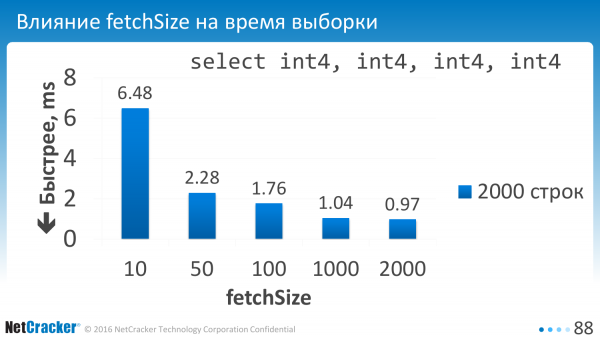
Så, vi har sagt detta. Vi har ställt in parametern. Och vad har vi fått? Om vi väljer på låga nivåer, till exempel, om vi väljer 10 rader, har vi ganska stora overhead-kostnader. Därför bör detta värde sättas till cirka hundra.
Idealiskt sett, förstås, kan vi även lära oss att begränsa i byte, men receptet är följande: sätt defaultRowFetchSize över hundra och var glad.
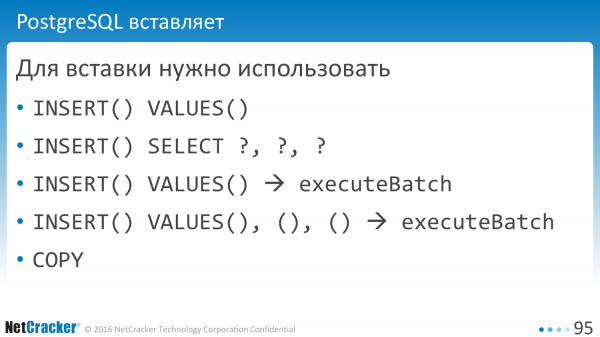
Låt oss gå vidare till datainsättning. Insättning är enklare, det finns olika alternativ. Till exempel, INSERT, VALUES. Det är ett bra alternativ. Man kan säga "INSERT SELECT". I praktiken är det samma sak. Det finns ingen skillnad i prestanda.
Böcker säger att man måste utföra Batch-statements, böcker säger att man kan utföra mer komplexa kommandon med flera parenteser. Och i Postgres finns det en fantastisk funktion – man kan göra COPY, dvs. göra detta snabbare.

Om vi mäter, kan vi återigen göra flera intressanta upptäckter. Hur vill vi att detta ska fungera? Vi vill inte parsa och inte utföra onödiga kommandon.
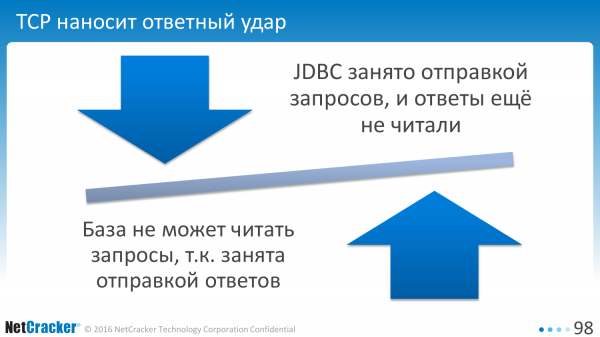
I praktiken tillåter TCP oss inte att göra så. Om klienten är upptagen med att skicka en förfrågan, läser inte databasen förfrågningarna när den försöker skicka tillbaka svaren. I slutändan väntar klienten på databasen medan den läser förfrågan, och databasen väntar på klienten medan den läser svaret.
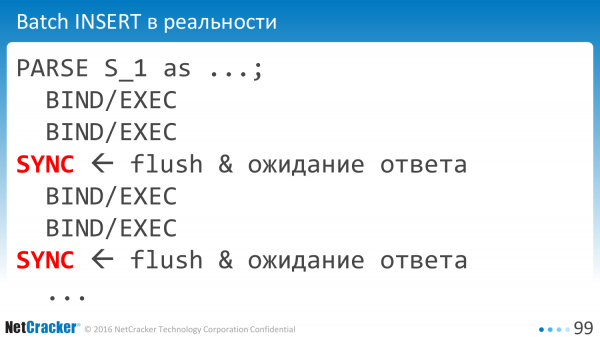
Och därför tvingas klienten periodiskt skicka en synkroniseringspaket. Onödig nätverksinteraktion, onödig tidsförlust.
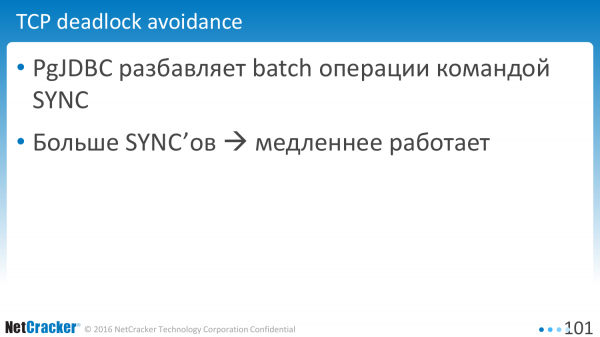 Och ju fler vi lägger till, desto sämre blir det. Drivern är ganska pessimistisk och lägger till dem ganska ofta, ungefär var 200:e rad, beroende på radens storlek osv.
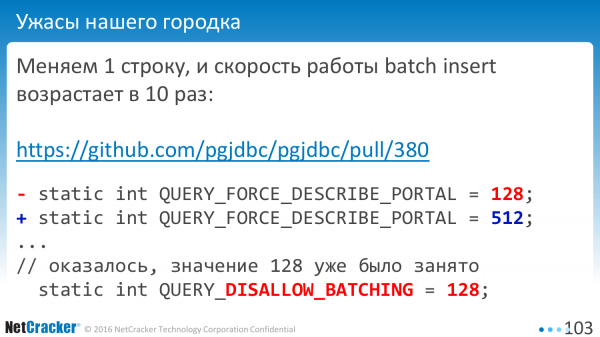
Det händer att om du bara ändrar en rad så ökar allt med tio gånger. Sådana saker händer. Varför? Som vanligt var en konstant någonstans redan använd. Och värdet "128" innebar – att inte använda batching.
Det är bra att detta inte kom med i den officiella versionen. Vi upptäckte det innan vi började släppa en version. Alla värden jag nämner baseras på moderna versioner.
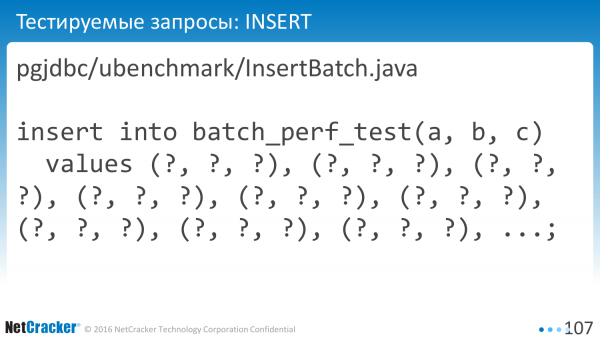
Låt oss mäta. Vi mäter enkel InsertBatch. Vi mäter multipel InsertBatch, dvs. samma sak, men med många values. En smart strategi. Inte alla kan göra det, men det är en enkel strategi, mycket enklare än COPY.
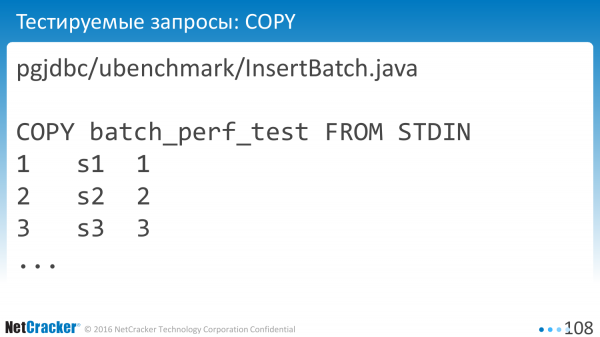
Man kan göra COPY.
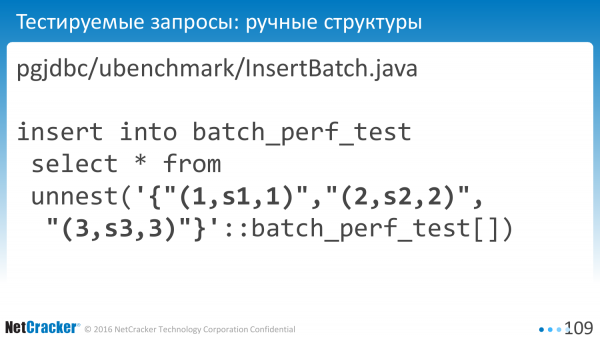
Och detta kan göras med strukturer. Deklarera User standardtyp, överför en array och sätt in direkt i tabellen.
Om du öppnar länken: pgjdbc/ubenchmsrk/InsertBatch.java, så finns denna kod på GitHub. Du kan se specifikt vilka frågor som genereras där. Det är inte det viktiga.
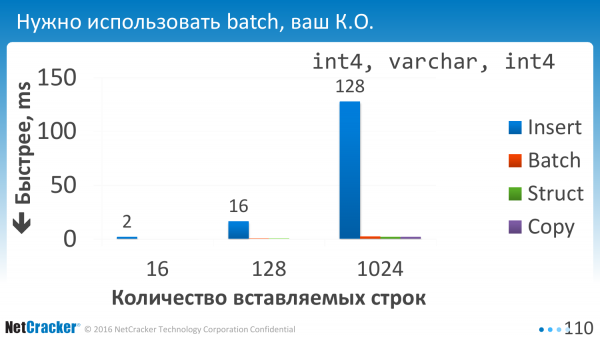
Vi har startat. Och det första vi insåg är att det är helt omöjligt att inte använda batch – alla alternativ till batching är likvärdiga med noll, det vill säga körningstiden är praktiskt taget noll jämfört med att köra en gång.
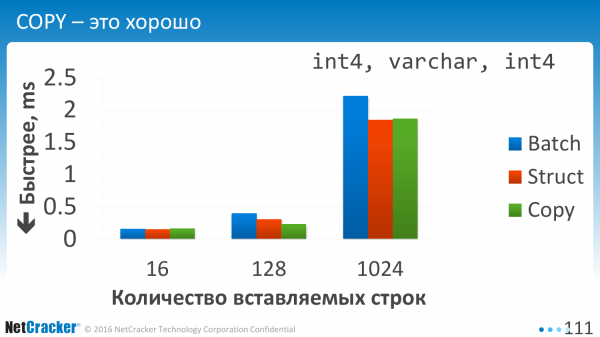
Vi sätter in data. Det är en ganska enkel tabell. Tre kolumner. Och vad ser vi här? Vi ser att alla dessa tre alternativ är ungefär jämförbara. Och COPY är självklart bättre.
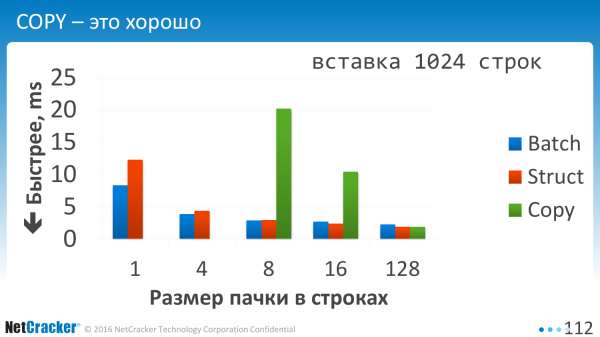
Det är när vi sätter in bit för bit. När vi sa att ett värde VALUES, två värden VALUES, tre värden VALUES eller vi angav dem där 10 med kommatecken. Det är just nu åt sidan. 1, 2, 4, 128. Det är tydligt att Batch Insert, som är ritat i blått, lättas av detta. Det vill säga, när du sätter in en och en, eller till och med när du sätter in fyra, så blir det i två gånger bättre, bara för att vi tryckte lite mer i VALUES. Färre EXECUTE-operationer.
Att använda COPY för små volymer är extremt orealistiskt. Jag ritade inte ens på de två första. De går till himlen, det vill säga dessa gröna siffror för COPY.
COPY bör användas när du har åtminstone mer än hundra rader. Överheaden för att öppna denna anslutning är stor. Och, ärligt talat, har jag inte grävt i den riktningen. Jag har optimerat batch, COPY – nej.
Vad gör vi härnäst? Vi har mätt. Vi förstår att vi bör använda antingen strukturer eller en smart batch som kombinerar flera värden.
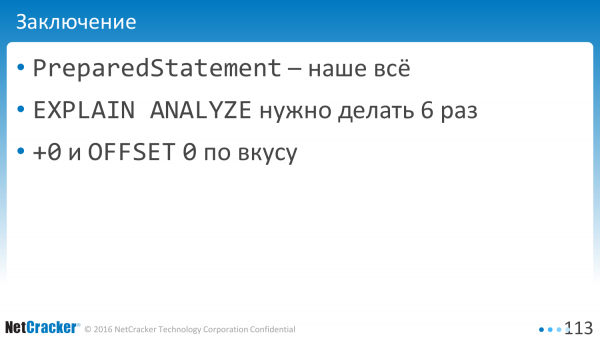
Vad måste vi ta med oss från dagens föreläsning?
- PreparedStatement – detta är allt för oss. Det ger mycket för prestanda. Det ger en stor spann med tjära.
- Och vi måste göra EXPLAIN ANALYZE 6 gånger.
- Och vi måste späda ut OFFSET 0, och trick som +0 för att rätta till den kvarvarande procenten av våra problematiska frågor.
Källa: habr.com
