

På senare tid har mina kollegor i branschen oberoende av varandra börjat fråga mig: hur får man en SDR-mottagare att fånga alla Bluetooth-kanaler samtidigt? Bandbredden tillåter det, det finns SDR med en utgångsbredband på 80 MHz eller mer. Det går naturligtvis att göra detta på en FPGA, men utvecklingstiden skulle bli ganska lång. Jag har länge vetat att det är ganska enkelt att göra detta på en GPU, men att det skulle vara så här!
Bluetooth-standarden definierar det fysiska lagret i två versioner: Classic och Low Energy. Specifikationen finns . Dokumentet är fruktansvärt stort, att läsa det i sin helhet är farligt för hjärnan. Lyckligtvis har stora företag som tillverkar mätutrustning resurser för att skapa överskådliga dokument om ämnet. och , till exempel. Jag har överhuvudtaget inte en chans i konkurrensen med dem när det gäller kvaliteten på materialpresentationen. Jag ber de intresserade att studera via länkarna.
Allt jag behöver veta om det fysiska lagret för att skapa ett flerkanalsfilter är nätsteg och moduleringstakt. Dessa uppgifter sammanställs i en tabell i ett av de angivna dokumenten:
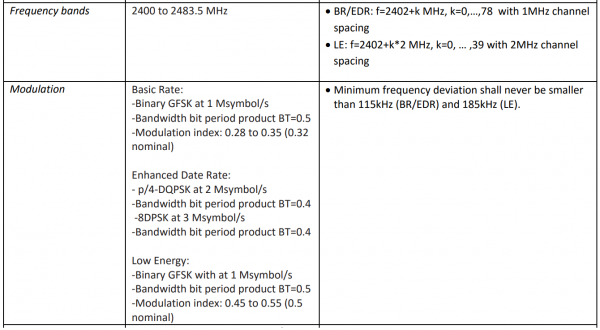
Således behöver vi dela upp 80 MHz-bandbredden i 79 filter med ett justeringssteg på 1 MHz och samtidigt i 40 filter med ett justeringssteg på 2 MHz. Avstämningarna från filterutgångarna måste vara 1 MHz och 2 MHz, respektive.
Därför behöver vi två filterkombinationer.
Till att börja med ska vi välja parametrar för dessa filter baserat på signalbanden för Bluetooth Classic och Bluetooth Low Energy. Vi behöver deras impulsrespons för att beräkna belastningen på filternas beräkningsenheter. Det bör genast noteras att vi har valt längder på impulsresponsen utifrån kraven för den "snabba" filtreringsalgoritmen. Substansen förändras inte av detta. Antalet koefficienter för impulsresponsen får inte vara för stort, så att filtret kan implementeras på rimlig beräkningshårdvara.
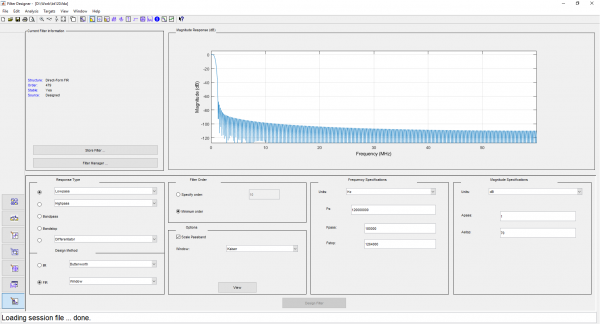
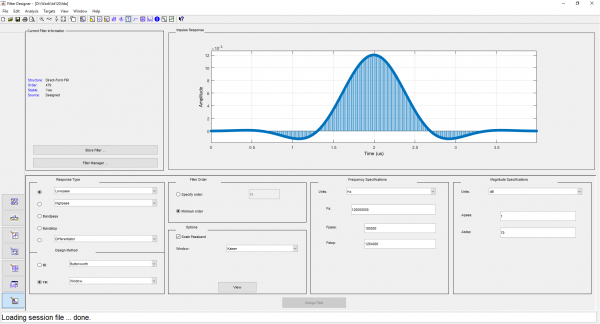
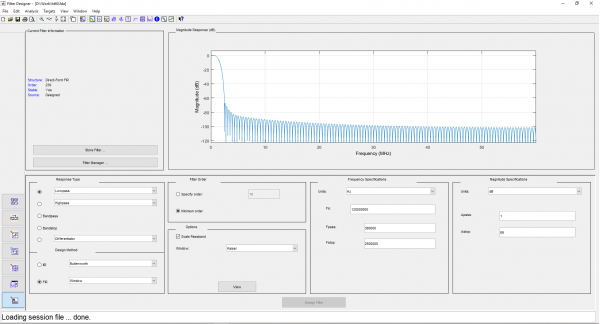
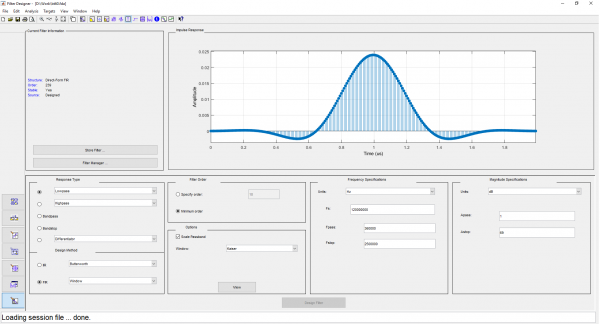
För filter med ett justeringssteg på 1 MHz väljer vi passbandet för lågpassfiltret (halva passbandet för bandpassfiltret) till 500 kHz, och längden på impulsresponsen justerar vi till 480 avledningar. För filter med ett justeringssteg på 2 MHz väljer vi dessa parametrar till 1 MHz och 240 avledningar, respektive. Välj fönstertypen till Kaiser. Vi beräknar impulsresponsen i filterDesigner och laddar ner dem i C-header-format:
Skärmdumpar från filterDesigner
Man kan lösa problemet direkt genom att konstruera en motsvarande DDC-array baserad på antalet filter (). Denna metod är bra för FPGA:er, där det är möjligt att spara resurser genom att minska bitdjupet på de första beräkningsstegen. Dessutom är FPGA det mest energieffektiva sättet att implementera det. Men arbetsinsatsen för denna metod är den högsta.
Vid utförandet av filterkombinationer på dagens populära GPU:er öppnas möjligheten att implementera en mer sofistikerad algoritm: polyfaserad filterkombination baserad på FFT, som finns tillgänglig på CUDA från biblioteket. I utländsk litteratur kallas algoritmen Polyphase eller WOLA (Weight, Overlap and Add) FFT Filterbank. Min ovilja att rita hindrar mig från att ge en visuell förklaring själv. Det finns många material på nätet om ämnet, särskilt en tydlig grafik som är gjord på sida 11 (ett stort tack till de respekterade författarna), här är den:
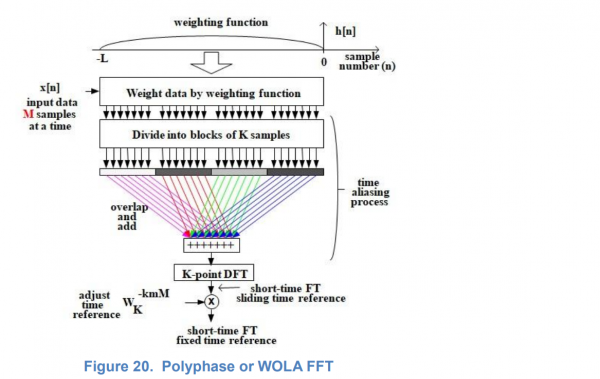
Jag ska försöka förklara bearbetningsschemat med mina egna ord. De som är känsliga ombeds att inte läsa.
Jag ska försöka förklara bearbetningsschemat med mina egna ord inom ramen för mina metodiska möjligheter. FFT är konvolutionen av den ingående signalen med hela spektrumet av komplexa ortogonala harmoniker som faller inom intervallet av impulsresponsen. Impulsresponsen för filtret, som signalen multipliceras med innan den går in i FFT, moduleras av detta spektrum av harmoniker. Med andra ord, den övergripande impulsresponsen för de resulterande filtret i kombinationen bringas utanför parentesen. Därefter filtreras spektrumet av harmoniker ned till ett visst antal gånger, på grund av att bandbredden för filtret utvidgas jämfört med filtret med rektangulärt fönster. På bilden ser vi en nedskärning med fyra. Med andra ord, efter att bandbredden har utvidgats med ett Kaiser-fönster (med en samtidig ökning av dämpningen i stopbandet) behöver vi inte alla filter utan endast en fjärdedel av dem. De övriga är överflödiga, deras frekvensegenskaper överlappar. Från fyra på varandra följande punkter i FFT väljer vi bara den första, vars beräkning är summan av de fyra
ingångspunkterna, tagna över en tid som är en fjärdedel av varaktigheten av den ursprungliga FFT.
Vi väljer den hårdvara som finns tillgänglig. Det är kortet från företaget "Instrument Systems" FMC126P. Jag har redan skrivit om det i en tidigare artikel. . I slot FMC on the board is inserted a submodule from the same company with an AD9371 transceiver with a bandwidth of 100 MHz. The entire stream from the transceiver can be continuously transferred to the computer for processing.
Let’s choose a video card with a GTX 1050 GPU. (Just kidding, it chose us: it was all that was at hand, snatched from the calculator for antenna calculations, but it was all the more surprising to see a working comb.) Let's move on to the software part.
Unfortunately, due to licensing issues, we cannot publish the full code. We can only show the GPU kernels. However, the rest of the code is not particularly interesting.
Here is the kernel that performs the multiplication of the signal by the window and adding, along with the wrapper for its call:
__global__ void cuComplexMultiplyWindowKernel(const cuComplex *data, const float *window, size_t windowSize, cuComplex *result) {
    __shared__ cuComplex multiplicationResult[480];
    multiplicationResult[threadIdx.x] = cuComplexMultiplyFloat(data[threadIdx.x + windowSize / 4 * blockIdx.x], window[threadIdx.x]);
    __syncthreads();
    cuComplex sum;
    sum.x = sum.y = 0;
    if (threadIdx.x < windowSize / 4) {
        for(int i = 0; i < 4; i++) {
            sum = cuComplexAdd(sum, multiplicationResult[threadIdx.x + i * windowSize / 4]);
        }
        result[threadIdx.x + windowSize / 4 * blockIdx.x] = sum;
    }
}

cudaError_t cuComplexMultiplyWindow(const cuComplex *data, const float *window, size_t windowSize, cuComplex *result, size_t dataSize, cudaStream_t stream) {
    size_t windowStep = windowSize / 4;
    cuComplexMultiplyWindowKernel<<>>(data, window, windowSize, result);
    return cudaGetLastError();
}
The signal processing code that calls this kernel precisely follows the algorithm scheme shown in the figure above, so I see no reason to present it here.
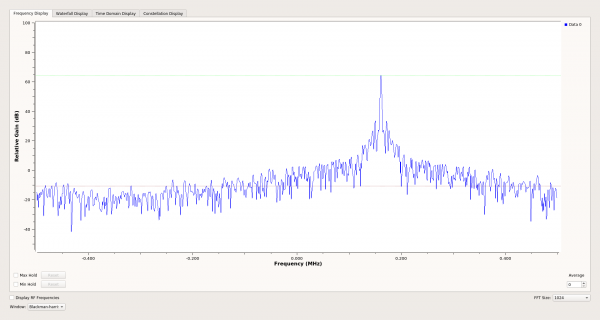
The combs were verified on the output spectrum of the channels in real-time. A signal from a 2450 MHz signal generator was input to the AD9371, and the filter selectivity corresponded to the calculated value.
Plans include adapting the software for the XRTX board and implementing packet searching if anyone finds it necessary or if there is free time.
All the software work was done by , glory to him!
Källa: habr.com
