

Obs. övers.: detta är en översättning av en offentlig postmortem från ingenjörsbloggen för företaget . Den beskriver problemet med conntrack i Kubernetes-klustret som ledde till delvis stillestånd av vissa produktionsservrar.
Den här artikeln kan vara användbar för dem som vill veta lite mer om postmortems eller förhindra vissa potentiella DNS-problem i framtiden.
Detta är inte DNS
Det kan inte vara att det är DNS
Det var DNS
Lite om postmortems och processerna på Preply
I postmortemet beskrivs ett driftstopp eller något annat evenemang i produktionen. Postmortemet innehåller en tidslinje med händelser, beskrivning av påverkan på användaren, grundorsaken, åtgärder och lärdomar.
Vid våra veckovisa möten med pizza, i den tekniska teamets krets, delar vi med oss av olika information. En av de viktigaste delarna av sådana möten är postmortems, som ofta åtföljs av en presentation med bilder och en djupare analys av den inträffade incidenten. Trots att vi inte "applåderar" efter postmortems strävar vi efter att främja en "blame-free"-kultur (). Vi tror att skrivandet och presentationen av postmortems kan hjälpa oss (och inte bara oss) att förhindra liknande incidenter i framtiden, därför delar vi med oss av dem.
Personer som varit involverade i incidenten måste känna att de kan berätta om den i detalj utan att frukta bestraffning eller hämnd. Ingen bestraffning! Att skriva ett postmortem är inte ett straff utan en möjlighet till lärande för hela företaget.
DNS-problem i Kubernetes. Postmortem
Datum: 28.02.2020
Författare: Amet U., Andrey S., Igor K., Alexey P.
Status: Avslutat
Kort sagt: Delvis otillgänglighet av DNS (26 min) för vissa tjänster i Kubernetes-klustret
Påverkan: 15000 händelser förlorade för tjänsterna A, B och C
Grundorsak: Kube-proxy kunde inte korrekt ta bort den gamla posten från conntrack-tabellen, därför fortsatte vissa tjänster att försöka ansluta till icke-existerande pods
E0228 20:13:53.795782 1 proxier.go:610] Misslyckades med att ta bort kube-system/kube-dns:dns slutpunktsanslutningar, fel: fel vid borttagning av conntrack-poster för UDP-peer {100.64.0.10, 100.110.33.231}, fel: conntrack-kommandot returnerade: ...Trigger: På grund av låg belastning inom Kubernetes-klustret minskade CoreDNS-autoskalan antalet pods i distributionen från tre till två
Lösningen: En ny deployment av applikationen initierade skapandet av nya noder, CoreDNS-autoscaler lade till fler pods för att betjäna klustret, vilket ledde till en överskrivning av conntrack-tabellen.
Upptäckte: Prometheus-monitorering upptäckte ett stort antal 5xx-fel för tjänsterna A, B och C och initierade ett samtal till jouringenjörerna.
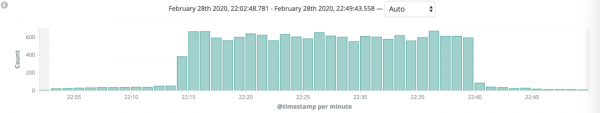
5xx-fel i Kibana
Åtgärder
för konsolen nu:
Typ
Ansvarig
Uppgift
Inaktivera autoskaleren för CoreDNS
förhindra.
Amet U.
DEVOPS-695
Installera en cachande DNS-server
minska.
Max V.
DEVOPS-665
Konfigurera conntrack-monitorering
förhindra.
Amet U.
DEVOPS-674
Lärdomar
Vad gick bra:
- Övervakningen fungerade effektivt. Reaktionen var snabb och organiserad.
- Vi nådde inte några gränser på noderna.
Vad som var fel:
- Den verkliga grundorsaken är fortfarande okänd, verkar vara i conntrack.
- Alla åtgärder åtgärdar endast konsekvenserna, inte grundorsaken (felet).
- Vi visste att vi förr eller senare skulle få problem med DNS, men prioriterade inte uppgifterna.
Där vi hade tur:
- En ny deployment triggade CoreDNS-autoscaler, som överskrev conntrack-tabellen.
- Detta fel påverkade bara en del av tjänsterna.
Tidslinje (EET)
Tid
för konsolen nu:
22:13
CoreDNS-autoscaler minskade antalet pods från tre till två.
22:18
Jouringenjörerna började få samtal från övervakningssystemet.
22:21
Jouringenjörerna började undersöka orsaken till felen.
22:39
Jouringenjörerna började rulla tillbaka en av de senaste tjänsterna till en tidigare version.
22:40
5xx-fel slutade dyka upp, situationen stabiliserades.
- Tid till upptäckten: 4 min
- Tid till åtgärdande: 21 min
- Tid till rättelse: 1 min
Ytterligare information
- CoreDNS-loggar:
I0228 20:13:53.507780 1 event.go:221] Event(v1.ObjectReference{Kind:"Deployment", Namespace:"kube-system", Name:"coredns", UID:"2493eb55-3dc0-11ea-b3a2-02bb48f8c230", APIVersion:"apps/v1", ResourceVersion:"132690686", FieldPath:""}): type: 'Normal' reason: 'ScalingReplicaSet' Skalad ner replika-setet coredns-6cbb6646c9 till 2. - Länkar till Kibana (utklippt), Grafana (utklippt)
För att minimera CPU-användningen använder Linux-kärnan något som kallas conntrack. Kort sagt är det en tjänst som innehåller en lista över NAT-poster som lagras i en specialtabell. När nästa paket kommer från samma pod till samma pod som tidigare, beräknas inte den slutliga IP-adressen på nytt utan tas från conntrack-tabellen.
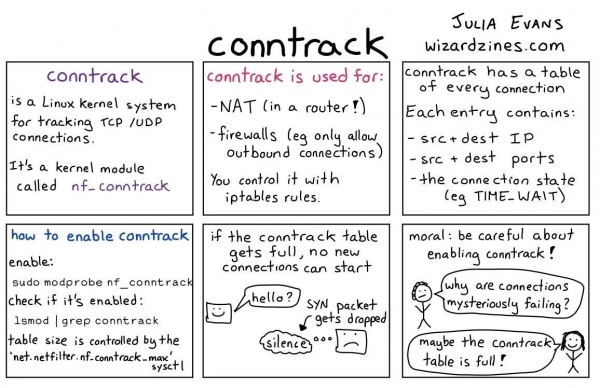
Hur conntrack fungerar.
Sammanfattning
Detta var ett exempel på en av våra postmortems med några användbara länkar. Specifikt i den här artikeln delar vi information som kan vara användbar för andra företag. Därför är vi inte rädda för att göra misstag och därför har vi gjort en av våra postmortems offentliga. Här är några fler intressanta offentliga postmortems:
- GitLab:
- Dropbox:
- Spotify:
- Många andra från och repository
- Även offentligt postmortem med SRE Book
Källa: habr.com
